语音小管家
AAAI 2026(AAAI Conference on Artificial Intelligence)将于2026年1月20-27日在新加坡举行,会议重点聚焦人工智能领域的前沿进展与跨学科应用,旨在为全球学术界与产业界的研究者提供一个深度交流的平台。议题涵盖机器学习、自然语言与语音处理、计算机视觉、多模态智能、人机交互、伦理与可信AI等多个方向。
会议官网:https://aaai.org/conference/aaai/aaai-26/
西工大音频语音与语言处理研究组(ASLP@NPU)三篇论文被本届AAAI会议录用,内容涉及语音生成、语音识别数据集等多个方向。以下是本届会议发表论文的相关信息,附带论文原文链接,与大家分享。
NO.1KALL-E:Autoregressive Speech Synthesis with Next-Distribution Prediction
作者列表:夏康翔*、朱新发*、姚继珣、田文杰、李文豪、谢磊*Equal Contribution
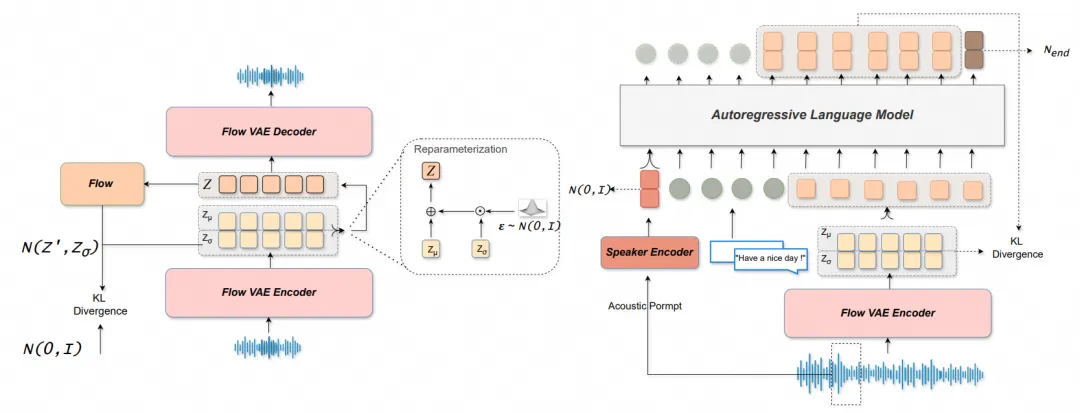
论文摘要:本文推出 KALL-E,一种用于文本到语音(TTS)合成的新型自回归(AR)语言模型,它通过预测下一连续语音帧的分布来工作。与现有方法不同,KALL-E 直接对以文本为条件的连续语音分布进行建模,无需任何基于扩散的组件。具体来说,我们利用 Flow-VAE 从波形中提取连续的潜在语音表示,而不是依赖离散的语音标记。接着,我们训练一个单一的自回归 Transformer 模型,使其能够根据文本预测这些连续的语音分布,并以优化 Kullback–Leibler 散度损失为目标。实验结果表明,KALL-E 实现了卓越的语音合成质量,甚至仅凭单个样本即可适应目标说话人。重要的是,KALL-E 为在文本到语音合成中利用连续语音表示提供了一种更直接、更有效的方法。
论文地址:https://arxiv.org/abs/2412.16846
Demo page:https://github.com/xkx-hub/KALL-E
NO.2WenetSpeech-Yue: A Large-scale Cantonese Speech Corpus with Multi-dimensional Annotation
作者列表:李龙豪*、郭钊*、陈虹洁、戴宇航、张子萸、薛鸿飞、左天伦、王成有、王水源、徐昕、卜辉、李杰、康健、张彬彬、袁锐斌、周子雅、雪巍、谢磊 *Equal Contribution
合作单位:中国电信人工智能研究院、 希尔贝壳、WeNet开源社区、香港科技大学
论文摘要:语音理解与生成的发展在很大程度上得益于大规模、高质量语音数据集的可用性。其中,ASR 和 TTS 被认为是最成熟且最基础的任务。然而,对于粤语(Yue Chinese)而言,尽管其在全球拥有约 8490 、、万名母语使用者,但受限的标注资源阻碍了相关研究的进展,导致 ASR 和 TTS 性能表现不理想。为了解决这一问题,我们提出了 WenetSpeech-Pipe,这是一个用于构建多维标注大规模语音语料库的集成管线,专为语音理解与生成任务设计。该管线包括六个模块:音频采集、说话人属性标注、语音质量标注、自动语音识别、文本后处理与识别结果投票,从而实现丰富且高质量的标注。基于该管线,我们发布了 WenetSpeech-Yue,这是首个面向 ASR 与 TTS 的具有多维标注的大规模粤语语音语料库,涵盖 10 个领域、总计 21,800 小时的语音数据,包含 ASR 转录文本、文本置信度、说话人身份、年龄、性别、语音质量评分等多种标注信息。我们还发布了 WSYue-eval,一个全面的粤语评测基准,包含两个部分:WSYue-ASR-eval,这是一个手动标注的评测集,用于评估 ASR 在短语音、长语音、代码混合及多样声学条件下的性能;以及 WSYue-TTS-eval,包含基础集和覆盖集,分别用于标准测试和泛化测试。实验结果表明,基于 WenetSpeech-Yue 训练的模型在性能上可与最先进的粤语 ASR 和 TTS 系统(包括商业系统和基于大语言模型的系统)相媲美,突显了我们数据集与管线的价值。论文地址:https://arxiv.org/abs/2509.03959
开源地址:https://github.com/ASLP-lab/WenetSpeech-Yue
NO.3Hearing More with Less: Multi-Modal Retrieval-and-Selection Augmented Conversational LLM-Based ASR
作者列表:穆秉甡、刘和鑫、薛鸿飞、魏坤、谢磊
合作单位:南洋理工大学
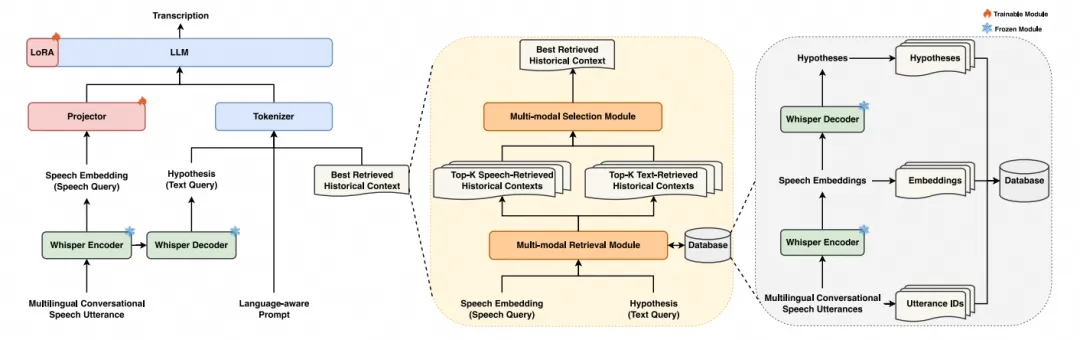
论文摘要:自动语音识别(ASR)旨在将人类语音内容转录为对应的文字。在对话场景中,有效利用上下文可以增强其准确性。大语言模型(LLM)杰出的长上下文理解和推理能力使得基于LLM的ASR(LLM-ASR)可以利用历史上下文来识别具有高度上下文相关性的对话语音。然而,现有的对话LLM-ASR方法使用固定长度的先前话语或者整个对话历史作为上下文,大量的不相关和冗余信息会导致严重的ASR混乱和巨大的计算代价。这篇论文提出了一种名为MARS的多模态检索-选择方法以增强对话LLM-ASR,该方法可以为对话中的当前话语从声学和文本两个模态检索和选择最相关的上下文。具体来说,多模态检索获取一个历史上下文的候选集合,每个候选都与当前话语有较高的声学或者文本相似度。多模态选择计算每个候选历史上下文与当前话语的声学和文本相似度,然后通过我们提出的逼近理想排序方法同时考虑两种模态的相似度最终选择最佳历史上下文。我们在Interspeech 2025多语种对话语音语言模型(MLC-SLM)竞赛数据集上验证了MARS的有效性,实验结果表明,在仅使用1.5K小时数据训练的情况下,MARS的性能超过使用了179K小时数据训练的竞赛最优系统。