
 语音小管家
“本系列的十篇文章,是对之前文章
原文链接
AI语音AI思考,公众号:AI语音AI思考 关于未来语音技术和应用趋势的10点看法
提到的十个趋势进行详细的剖析。在这个系列文章中,会穿插科普、技术综述、技术发展路线,以及一些个人和其他行业专家的思考。希望通过这一系列文章,无论读者之前对语音技术和应用了解多少,都能获得一些有价值的观点。”
本篇将围绕“架构逐渐简化,模型统一”这一趋势,回顾十几年间模型、算法、工具和数据的变迁,并尝试从中探寻一些有关未来的规律。
架构和建模方式的演变
技术的演变大多数时候都是一个缓慢的过程,很难清晰定义一项技术从何时开始完全替代另一项技术。虽然通常会有里程碑式的工作开创一个新时代,但新老交替总是一个渐进的过程。
我主要的研究和工作经历集中在语音理解方面,包括识别、增强等方向,虽然后来也做了一些语音合成的工作,但在本文中,我将以语音识别为切入点,阐述技术路线的发展历程。语音合成乃至其他领域的研究,也基本呈现出相似的规律。
我认为技术发展的规律,用一句话就可以概括,当然不一定完全准确:算法的复杂度和计算能力、数据规模成反比。 这句话大致意思是:当我们的算力越弱、数据越少时,越需要算法上的复杂设计。
系统架构的发展史
其实整个架构的发展趋势只有一个,就是越来越简单。
近十几年来,语音识别领域在如何刻画语音数据分布(声学模型)到如何刻画语言分布(语言模型)方面,大致经历了4次较大的技术路线变革:
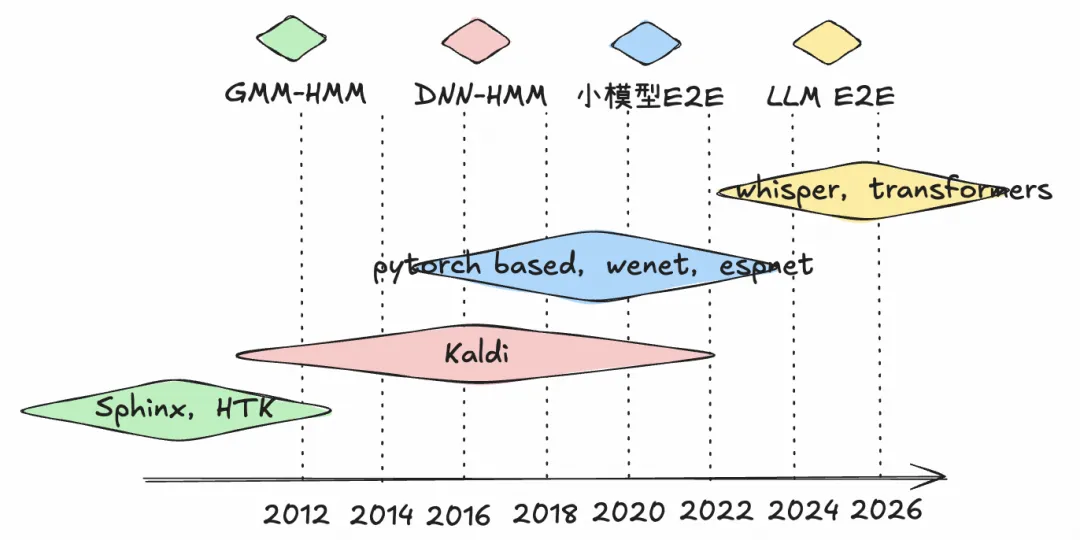
这4次架构的变革,我们又可以用下面一张图来统一表示:
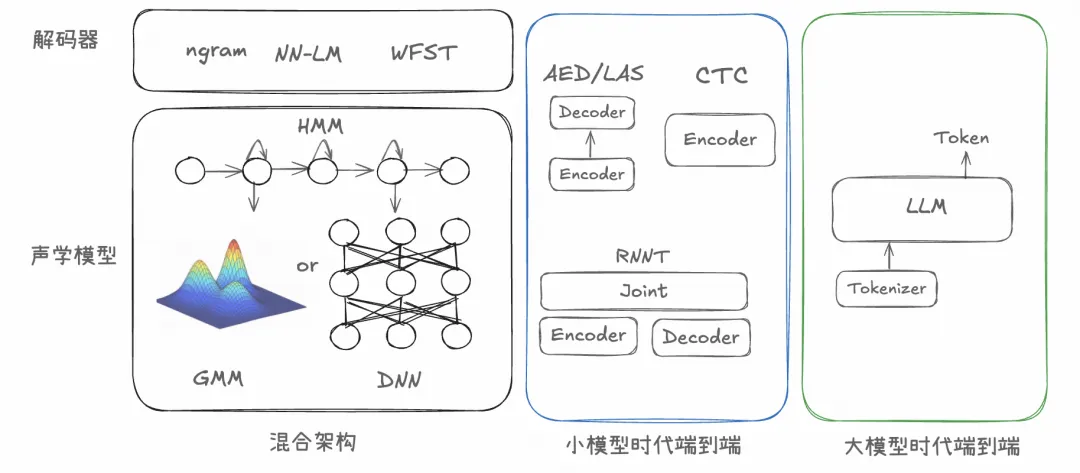
GMM-HMM+维特比解码器时代
这也是我入门语音时接触的第一个系统,可以说是赶上了GMM-HMM主导技术时代的尾声。GMM-HMM时代,工具包上,有Sphinx[11](现在还在维护)和HTK,HTK book[1]可以说是语音识别领域入门的最佳教材。
由于建模单元是HMM状态,若要将解码结果转换为文字,还需要一个解码器。解码器由词图或语言模型经过复杂操作构建而成,其核心作用是通过维特比算法,将似然最大的HMM状态序列解码为最终的字或词。此时,还有孤立词识别和连续大词汇语音识别之分。
这个时代,训练一个模型的上手难度相当高,原因如下:
代码虽开源,但是纯C代码,阅读和修改难度很高; 建模方式复杂,训练流程繁琐,容易出错; 解码图的实现需要较强的工程能力; 数据量小,几十小时的数据已算大数据,少的甚至只有几十分钟。
具体每一步流程本文不再详细解释,这里给出一张流程图,大家可以与今天的模型训练流程对比(这只是大致步骤,详情可参考HTK Book)。
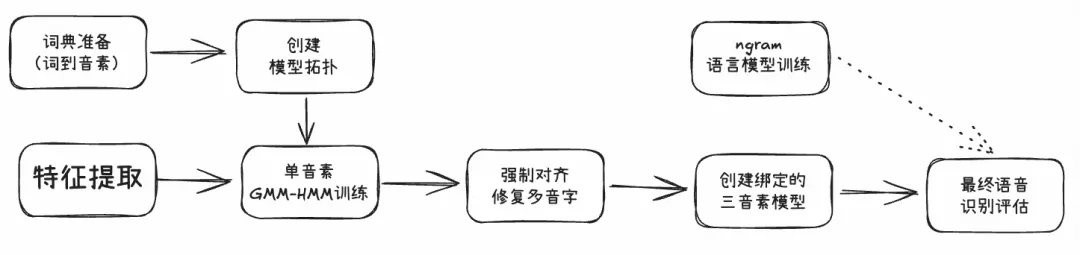
在学习过程中,我清楚记得一个场景。当时在学校二楼的会议室,看着这复杂的流程,我就在想:“我们真的需要这么复杂的结构吗?人类不是听到声音就能直接说出文字吗?”现在想来,只是当时自己没有能力设计端到端系统罢了。越是认为自己拥有专业知识,越容易被自己的思维定式所束缚。
在这个时代,我认为对语音领域后续十几年发展最重要的人物之一——Daniel Povey博士,参与了HTK的开发,并即将开启语音识别(甚至可以说是多个领域)的新时代。
DNN-HMM时代+WFST解码器
可以说,语音技术真正达到可商用水平是从这个时代开始的,也不过是短短十几年。Hinton老先生与微软的邓力博士、俞栋博士等大佬,率先将深度学习成功应用于语音识别[2],将大词汇量连续语音识别的准确率推向了全新高度。此时,也是各种深度神经网络快速发展的时期,CNN、RNN、LSTM、TDNN等网络结构都成为构建声学模型的重要模块。
这一时期,从原理上讲,语音识别的建模流程反而更复杂了,因为DNN-HMM的训练是在GMM-HMM训练之后进行的,相当于又多了一步。然而,由于Daniel Povey博士开源的Kaldi[3]框架的出现,模型训练流程变得非常顺畅。可以说,大部分公司在这个时代都是基于Kaldi实现商业化的。如果没有Kaldi,语音行业的商业化进程可能会延迟多年。这个时代的特征是:
几乎由Kaldi主导,大家基于Kaldi进行训练、部署和二次开发; 采用C++代码,且代码风格非常规范,模块化设计使可读性大大提高; GPU开始流行,模型参数在几十兆到百兆左右,比GMM时代大很多; 数据量开始增加,开源数据出现上千小时规模,工业界则从几万小时发展到十几万、几十万小时量级。
其实直到现在,Kaldi可能仍在以某种形式发挥作用。也许只有少数系统还在维护基于Kaldi的方案,但在某些数据清洗流程中,应该仍有人在使用。
但无论如何,尽管C++语言有很多优势,但在Python日益完善和普及的背景下,C++代码对很多人来说还是太复杂了。随着基于计算图的PyTorch和TensorFlow等训练工具的出现和统一,定义模型变得非常简单,这也为端到端时代的开启奠定了重要的外部环境。
小模型端到端时代
实际上,小模型的端到端与DNN-HMM时代并存了很长时间,业界曾争论端到端是否具备落地能力,因为端到端模型没有了显式语言模型的约束,大家的“不安全感”明显增加。
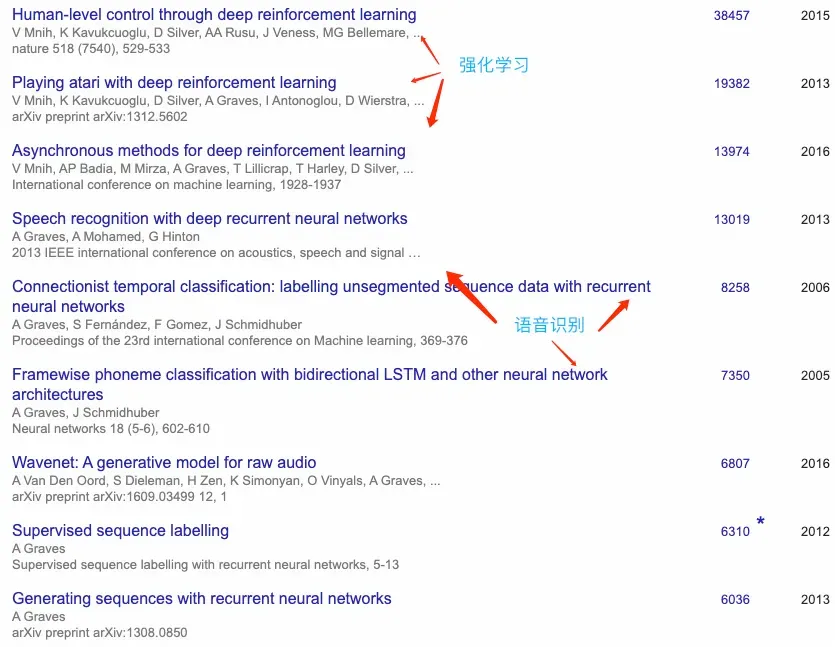
虽然Alex Graves的CTC、RNN-Transducer(此处不再详述)等工作在2012年左右就已出现,但真正流行起来是在稍后几年,特别是谷歌开始大规模尝试Transducer之后。说到这里,不得不提Alex Graves,他参与的许多语音识别工作,在之后多年直至现在仍被广泛使用。强化学习是这几年开始流行后,引用量才明显增加。
从2015年左右的LAS(Listen, Attend and Spell)[4]、基于注意力的语音识别模型[5]等工作开始,各种端到端模型逐渐进入学术界和工业界的视野。基本流派包括CTC、RNNT、LAS或CTC-Attention的混合架构。此时,Attention机制尚未形成固定形式,直到2017年《Attention is All You Need》问世。
在语音识别领域,较早应用Transformer架构的可能是自动化所的文章[6]。之后,基于Transformer的模型结构开始主导语音识别的端到端框架,直到谷歌提出改进版的Conformer结构[7]。Conformer至今仍作为优秀的Speech Encoder被使用。这一时期,大规模语音无监督预训练也成为热门方向。
同时,随着基于Python的训练框架流行(期间出现了Keras、Theano等众多训练框架),最终收敛到PyTorch和TensorFlow。基于PyTorch实现神经网络变得非常简单,加之损失函数通常采用PyTorch自带的CTC、RNNT或CE,自行训练语音识别模型的门槛大大降低。
这一时期,像Espnet[8]、Wenet[9],以及Daniel Povey在小米主持开发的新一代Kaldi[10]等,都是优秀的开源项目,并贡献了许多开箱即用的模型和服务。许多公司开始将服务从Kaldi迁移到端到端模型。不过,为了系统更稳定,有些方案仍采用相对保守的框架,例如使用音素建模而非字级建模,最后通过外接语言模型以便修复常见问题。但随着数据量增大,这一框架也逐渐被放弃。因此,这一时期的典型特征是:
训练框架灵活性提高,代码难度大幅下降; 模型结构进一步简化,并统一到基于Transformer及其变体Conformer上; 开源项目大量增加,越来越多人参与到语音相关工作中; 训练数据进一步增加,算力增强; 端到端模型效果超过混合结构,并落地工业界;
大模型端到端时代
时间过得很快,小模型端到端刚刚确立统治地位,大模型时代便已来临。
实际上,基于大模型的端到端与小模型的端到端在本质上没有太大区别。例如出圈的Whisper模型,只是数据量更大、模型参数更多,本质上仍是encoder-decoder结构。
然而,在大模型时代,我们并不满足于用如此大的模型仅解决语音识别任务,而是倾向于将多个任务合并,统称为“语音理解”。关于大模型端到端结构,我们将单独介绍。
建模单元的演变:从抽象统一到多元再到具体统一
下图展示了不同架构下建模单元的变化趋势。
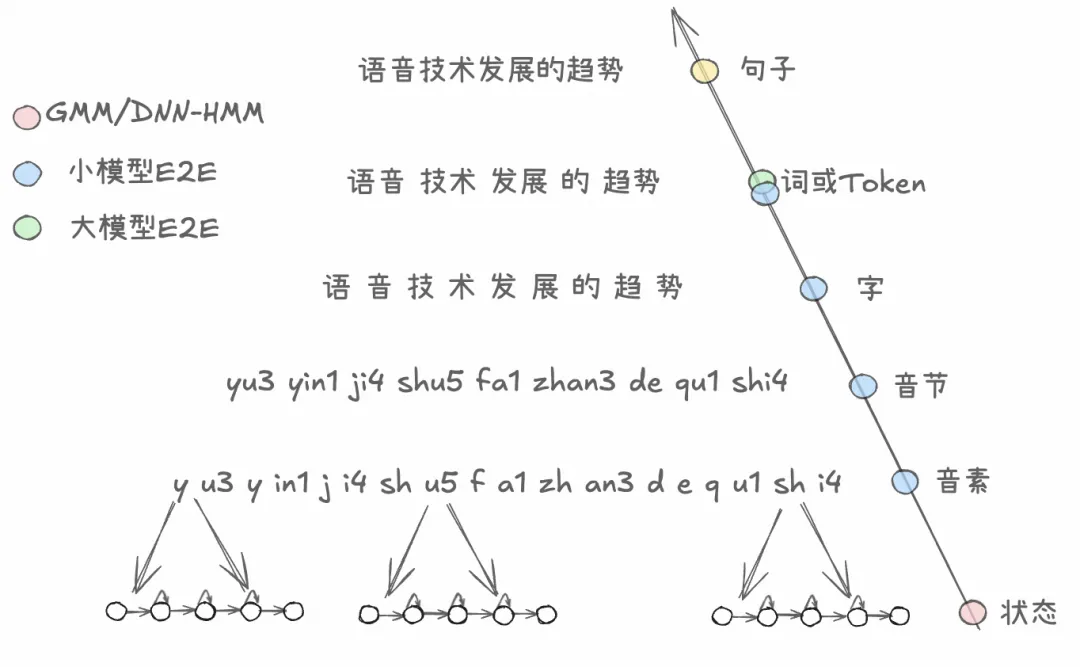
早期大家采用相同的建模单元,因为专家们就是这样定义的!由于没有其他开源框架和选择,且大多数人缺乏开发能力,因此只能采用这种方式。 进入小模型端到端时期,人们可以灵活定义自己的建模方式,存在不同颗粒度的选择,小到音素,大到BPE,并对比不同方式的优劣; 最后,在大模型时代,统一采用Token进行建模。
在GMM/DNN-HMM时代,普遍采用最小的HMM状态进行建模,即一个最小发音单元(音素)会被拆分成3个更小单元。这些更小的发音单元还需考虑其上下文位置。例如,同样是音素a,如果左边是l、右边是p,它就表示为l-a+p,这与p-a+p不是同一个音素,这就是“三音素”。因为上下文不同,可能会影响a的发音!此外,由于整体训练数据不足,这样组合后会产生许多稀疏数据,还需要进行决策树聚类等一系列操作!
在小模型端到端时代,由于训练框架更加灵活、训练数据充足,无需过多考虑语言学和专家知识,建模单元也更加多元化。既然已是端到端框架,自然是建模颗粒度越具体越方便。
而到了大模型时代,为了复用文本大模型的能力,大家直接放弃了关于建模单元的争论,统一采用大模型的Token。
大模型端到端时代
大模型时代的特点
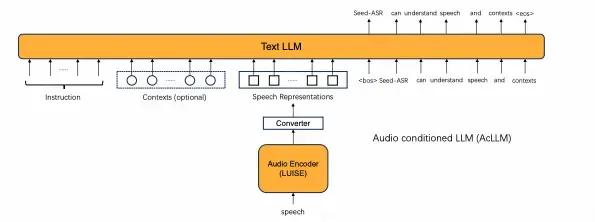
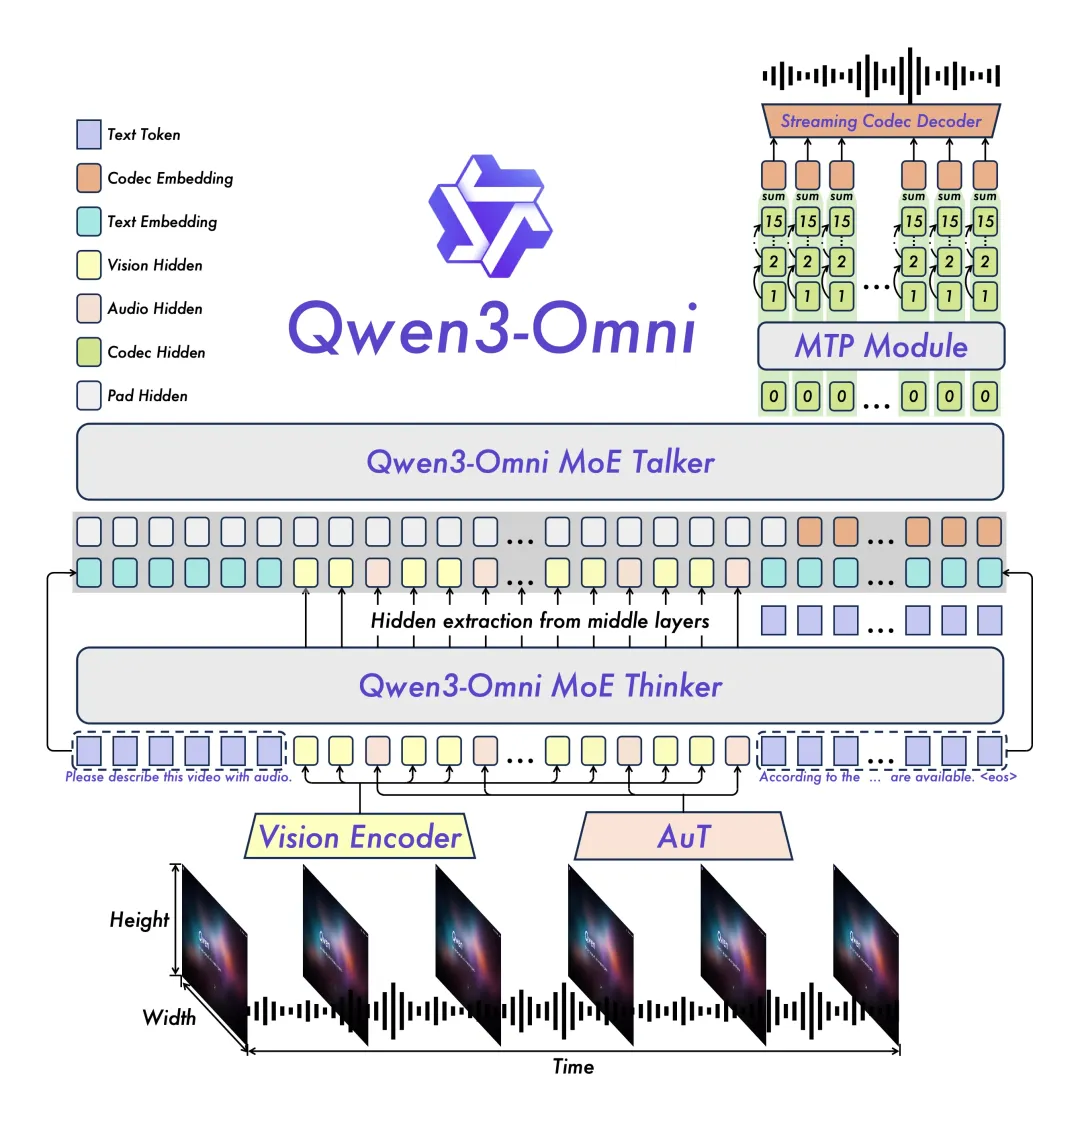
首先,任务之间的边界逐渐模糊,理解和生成都可以在一个模型中完成,即所谓的Omni(全能)。Omni不仅限于语义模态,还包括多模态的Omni。下面两张图展示了两种典型架构:一个是Seed-ASR的单模态识别与理解,
另一个是代表Omni的qwen3-omni示意图。
其次,大模型本身对文本能力的理解,为其他语音任务提供了强大的泛化性。甚至无需额外操作,只需将一个为语音识别训练的Encoder通过一层适配器(adaptor)与LLM连接并微调,就能取得良好效果。
最后,大模型时代的语音处理范式与文本大模型几乎无异,上手难度和门槛大大降低。即使之前未接触过任何语音相关任务,在当前环境下上手语音大模型的难度也已不大。
加速融入LLM的范式
在LLM兴起之前,一个明显现象是:
语音技术相比自然语言处理和计算机视觉显得较为小众且自成一派。
这主要是由语音数据独特的任务属性决定的。语音是序列数据,兼具时频特征,因此出现了许多专为语音设计的模型结构和损失函数。不像CV领域有各种统一框架,如VGG19、ResNet-50等。例如CTC损失函数,通常仅在OCR和语音识别任务中使用;模型结构上,各种类型的网络(如CNN、RNN、LSTM)常同时出现在同一模型中,且各家使用的模型结构各不相同。
大模型时代,这种情况基本结束,原因如下:
大模型开源社区最为活跃,可直接利用开源文本大模型微调其他模态; 大模型推理架构最为成熟,可直接利用现有推理架构进行加速; 参数和数据量越来越大是不可阻挡的趋势; 传统架构在大数据、充足资源的场景下优势明显不再。
数据量跃升至千万甚至上亿小时
大模型自然离不开大数据。在语音大模型时代的前半程,底座模型的预训练数据量直接提升了数个量级,从原来的几万小时发展到现在的千万乃至上亿小时。如此大规模的数据训练,目前也只有头部玩家才有资源进行底座模型的训练。从数据角度看,我们仍可发现一些趋势和问题:
海量低质量数据“大水漫灌”的时代应该结束了,底座能力基本达到上限; 大模型时代没有垃圾数据,只有未被充分利用的数据。未来需要更加充分地挖掘数据价值。
首先,千万小时的数据靠人工标注是不可能的。因此,基本采用自动化流水线打标方式,通过多个语音识别模型进行文本标注,并对比不同模型的效果。但这样做的一个弊端是数据存在“幸存者偏差”。也就是说,有难度的数据(如方言、口音、声音事件等),所有打标模型都可能失败,导致有价值的数据被过滤,而仅保留符合现有模型标准的数据。
其次,数据过滤是否合理,如何充分利用所有数据,可能是未来提升模型基础能力更重要的方向。所谓“没有垃圾数据”,是指每条数据都有其存在价值。如何发挥每条数据的价值,未来是否可行,可能是每位数据科学家和算法专家的重要课题之一。
站在巨人的肩膀上
得益于近20年的发展,语音技术积累了丰富的经验。这些积累为大模型时代的数据清洗和生产做出了至关重要的贡献。
这并不意味着旧技术过时了。一个共识是:谁的数据处理得好,谁的模型效果就会更好。因此,如果对历史技术有深刻理解,就能更好地把控数据生产过程中的关键问题。从这方面讲,历史上的技术并非无用,而是以另一种形式继续发挥重要作用。(如果大家有兴趣,我们可以专门梳理数据清洗的流程。)
总结
回顾近20年语音识别的发展历史,从系统架构、建模方式到训练数据,我们发现:
追求极致的简单,努力使算法和系统符合直觉,或许是指导技术创新的重要方向; 很多时候,突破往往来自行业外部,因为他们没有历史包袱和思维定式的束缚,反而更容易创新。
下一期,我们将继续分享趋势二,关于语音端到端系统的一些看法。如果你有想了解的内容,欢迎留下你的想法。
部分参考文献和来源
[1] Young S, Evermann G, Gales M, et al. The HTK book[J]. Cambridge university engineering department, 2002, 3(175): 12.
[2] G. Hinton et al., "Deep Neural Networks for Acoustic Modeling in Speech Recognition: The Shared Views of Four Research Groups," in IEEE Signal Processing Magazine, vol. 29, no. 6, pp. 82-97, Nov. 2012, doi: 10.1109/MSP.2012.2205597.
[3] Povey D, Ghoshal A, Boulianne G, et al. The Kaldi speech recognition toolkit[C]//IEEE 2011 workshop on automatic speech recognition and understanding. 2011, 1: 5.1.
[4] Chan W, Jaitly N, Le Q V, et al. Listen, attend and spell[J]. arXiv preprint arXiv:1508.01211, 2015.
[5] Chorowski J K, Bahdanau D, Serdyuk D, et al. Attention-based models for speech recognition[J]. Advances in neural information processing systems, 2015, 28.
[6] Dong L, Xu S, Xu B. Speech-transformer: a no-recurrence sequence-to-sequence model for speech recognition[C]//2018 IEEE international conference on acoustics, speech and signal processing (ICASSP). IEEE, 2018: 5884-5888.
[7] Gulati A, Qin J, Chiu C C, et al. Conformer: Convolution-augmented transformer for speech recognition[J]. arXiv preprint arXiv:2005.08100, 2020.
[8] https://github.com/espnet/espnet
[9] https://wenet.org.cn/
[10] https://github.com/k2-fsa/icefall
[11] https://github.com/cmusphinx/pocketsphinx
