
 语音小管家
本文将介绍南开大学人类语言技术实验室(NKU-HLT)与中国电信(TeleAI)的研究团队在 AAAI 2026 发表的工作—— DIFFA(DIFFA: large language diffusion models can listen and understand)
DIFFA 是首个基于扩散语言模型(Diffusion LLMs, dLLMs)
的音频理解大模型,它为音频理解领域带来了全新的非自回归范式,让模型能“听懂”世界。
⏩一、研究背景:
大语言模型(LLM)已在文本、图像等模态上取得了突破性进展。与此同时,大音频语言模型(LALM)将语音与语言结合,用于语音理解、问答和多轮交互。然而,主流 LALM 几乎都采用自回归解码(AR),存在生成速度慢、上下文建模受限、易受累积误差影响等问题。与之相对,扩散语言模型(Diffusion LLM)以“去噪”为核心,通过并行预测实现非自回归生成(NAR),在文本任务中展现出更强的可控性与上下文建模能力。但在音频理解领域,这类模型尚属空白。
因此,我们提出了DIFFA —— 首个将扩散语言模型应用于语音理解的大模型,探索扩散范式在语音领域的潜力与上限。
⏩二、方法与技术方案
1. 模型架构
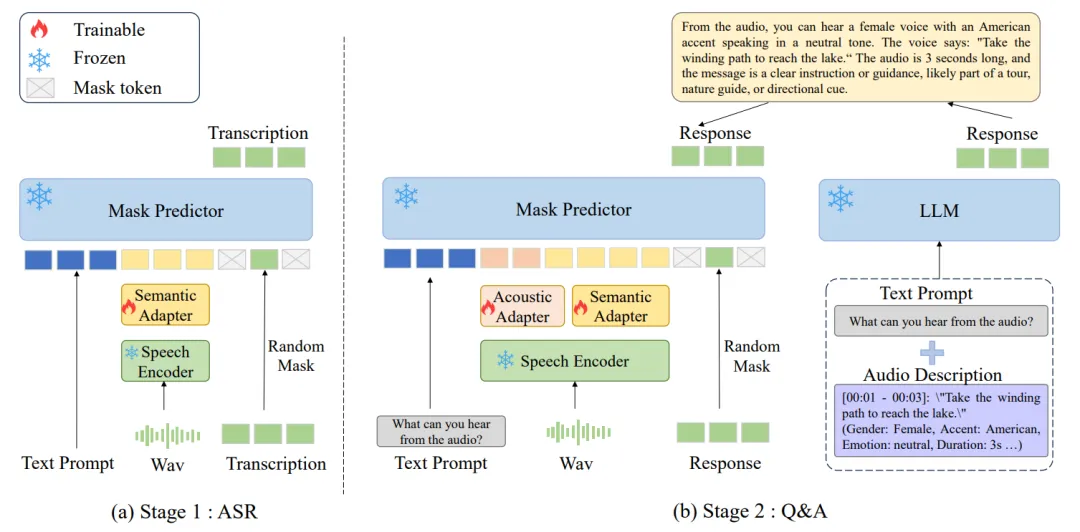
DIFFA 采用模块化设计,由三部分组成:
Speech Encoder:基于 Whisper-Small,用于提取音频帧级特征;
Dual Adapters:包括语义适配器(Semantic Adapter)与声学适配器(Acoutic Adapter),分别对语义与声学特征进行映射与融合;
Diffusion LLMs backbone(LLaDA-8B-Instruct, 图中为Mask Predictor):负责推理与生成。
在训练中,LLaDA 与 Whisper 参数全部冻结,仅训练dual adapters,确保知识迁移稳定且避免灾难性遗忘。
2. 两阶段训练流程
阶段一:语义对齐(Semantic Alignment)
在 LibriSpeech(960 小时)上进行语音识别训练,使语音与语言语义空间对齐。
阶段二:问答指令微调(Q&A Instruction Tuning)
利用自动生成的 127 小时音频-文本指令对(提示词为 “What can you hear from the audio?”),让模型学习听觉描述与音频理解任务。
训练数据覆盖多维属性(情感、口音、语速、音高、性别、年龄、语义意图等),为模型构建了丰富的声学上下文。
3. 推理方式
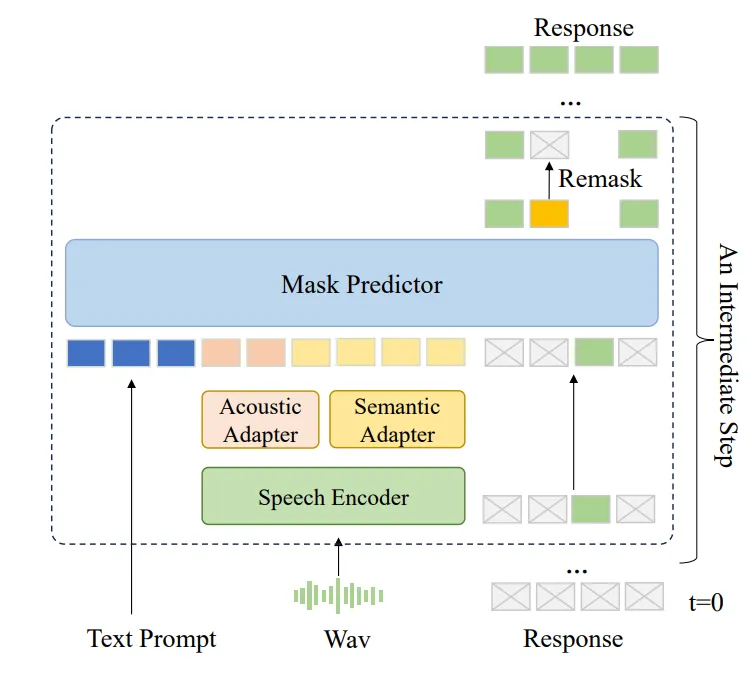
DIFFA 基于discrete diffusion的扩散采样机制,从全掩码序列出发,逐步填充、再掩码低置信度 token,多次迭代得到最终输出,实现双向上下文建模与高质量生成。
⏩三、实验与评测
1. 多维评测基准
MMSU:评估语音语义、音系及超语段信息理解,共 47 类任务;
MMAU:覆盖语音、音乐、环境音的多模态推理;
VoiceBench:模拟语音助手场景,考查知识问答、指令执行与安全性。
2. 主要结果
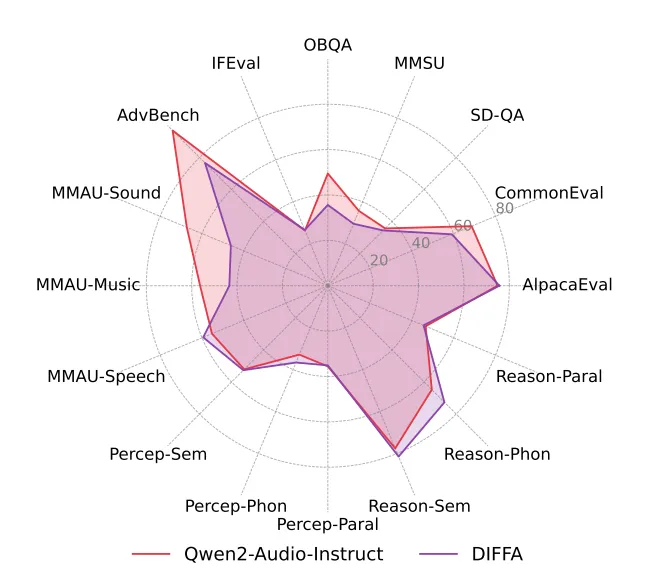
DIFFA 在MMAU, MMSU, Voicebench三个评测基准上,以极少的训练数据(960h ASR data +127h SFT data)取得了可与Qwen2-Audio-Instuct相接近的水平。
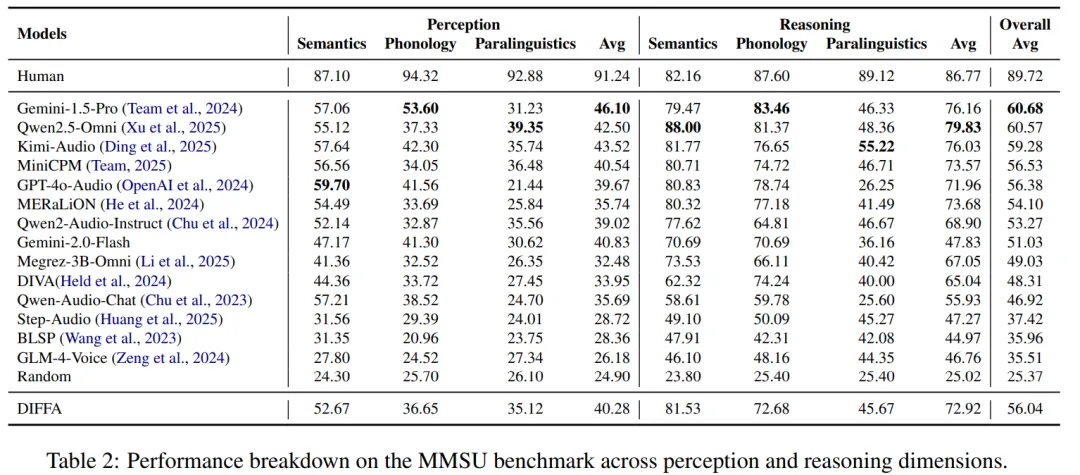
在MMSU benchmark上DIFFA表最为突出,超越了多个自回归模型,并和MiniCPM, GPT-4o-Audio性能接近。展示了扩散模型的泛化潜力。
3. 消融实验
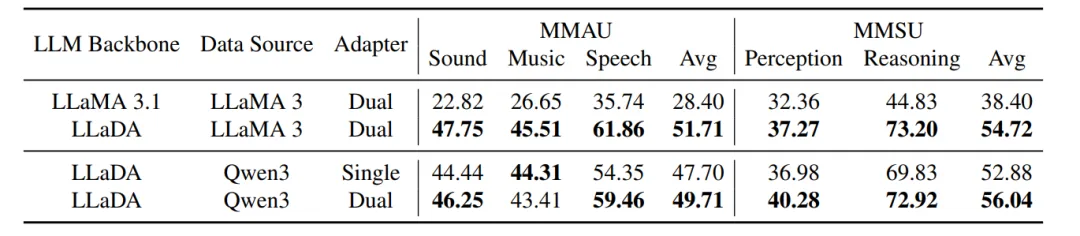
使用扩散式 LLaDA 替代自回归 LLaMA 后,整体性能显著提升;
双适配器显著优于单适配器结构,有效增强声学特征建模;
使用Qwen3合成的指令数据带来更好的语义对齐效果。
⏩四、创新与贡献
1. 首个基于扩散语言模型的音频理解系统,打破自回归范式,在低成本下实现高效音频-语言建模。
2. 提出双适配器 + 两阶段训练框架,在冻结主干模型的前提下实现语义与声学深度融合。
3. 极低资源下的领先性能——仅用 960 小时 ASR + 127 小时合成数据,性能超越多款自回归 LALM。
4. 开源完整训练与推理流程,为扩散语言模型在语音领域的研究提供基础框架:
Arxiv: https://arxiv.org/abs/2507.18452
Github: https://github.com/NKU-HLT/DIFFA
Huggingface: https://huggingface.co/zhoujiaming777/DIFFA
⏩五、结语
DIFFA 首次验证了扩散语言模型在语音理解任务中的可行性与潜力,为构建更高效、可控、通用的语音驱动智能系统开辟了新路径。“让扩散语言模型“听懂”世界” 。
