
 语音小管家
语音,不仅是人类沟通的载体,更是健康状态的“声纹”。随着人工智能与计算机听觉技术的飞速发展,语音信号正在成为一种新的医学信息源,为疾病筛查、心理评估与神经障碍检测提供全新的非侵入式途径。近期,北京理工大学钱昆教授、胡斌教授团队联合日本东京大学、英国帝国理工学院、德国慕尼黑工业大学的多位学者,在AI Open(Elsevier,2025)发表长篇综述论文《Computer Audition for Healthcare: A Survey on Speech Analysis》,系统梳理了语音分析在医疗健康领域的研究进展与未来趋势。
该论文从智能语音分析(Intelligent Speech Analysis, ISA)的角度出发,回顾了语音信号在疾病诊断中的方法体系、典型应用和关键技术,包括数据采集、信号预处理、特征提取、机器学习与深度学习模型等全过程。研究指出,语音不仅可辅助检测身体疾病、心理障碍与神经系统疾病,还具备高可及性、低成本与用户友好等优势,为实现全民健康监测与数字医疗提供了新思路。
这篇综述不仅总结了过去十年语音健康分析的技术脉络,也揭示了其面临的挑战——数据稀缺、模型泛化性不足、临床验证有限与伦理安全问题。作者进一步展望了“语音+医疗+人工智能”的融合前景,认为计算机听觉将成为未来智能医疗的重要支撑,推动医疗诊断从“可见”走向“可听”。以下为全文简版介绍。
自世界卫生组织提出“健康不仅是没有疾病,而是身体、心理与社会的全面福祉”以来,全球对心理与神经健康的关注显著提升。随着现代社会压力增加和人口老龄化加剧,抑郁症、焦虑症、帕金森病以及阿尔茨海默症等疾病的发病率持续上升,而新冠疫情更使心理健康问题成为全球性挑战。这些趋势推动着医疗系统向更普惠、智能与非侵入的健康监测方式转型。
在众多生理信号中,语音被认为是一种独特且极具潜力的健康指标。语音不仅传递语言信息,还携带丰富的副语言特征(paralinguistic features),包括语速、音高、节奏、音质与情感表达,这些特征与个体的生理状态和心理活动密切相关。研究表明,抑郁患者通常语调单一、语速缓慢;帕金森病患者的发音则表现为共振峰漂移、声带振动不稳定;而呼吸系统疾病(如哮喘、COVID-19)会导致呼吸噪声与语音断续等特征变化 。
与传统的健康监测技术(如EEG、ECG、MRI)相比,语音分析具有非侵入性,低成本,可普及性,实时性强的明显优点。
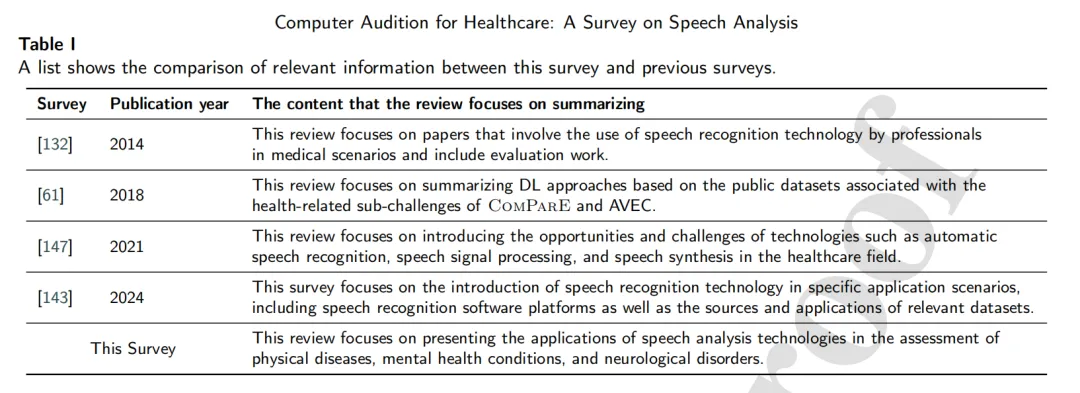
因此,语音被视为未来数字健康系统中的关键数据通道,能够以最自然的方式反映人体的生理、心理与神经状态。这一思路催生了“计算机听觉(Computer Audition, CA)”与“智能语音分析(Intelligent Speech Analysis, ISA)”的研究方向——即通过计算模型模拟人类听觉认知,对语音信号进行多层次解析,从中提取与疾病相关的可量化特征。
论文《Computer Audition for Healthcare: A Survey on Speech Analysis》正是在这一科学背景下展开。作者指出,语音分析不仅能成为心理与神经疾病早筛的辅助工具,更有望发展为一种新型数字生物标志物(Digital Biomarker)。通过语音这一“可听的健康信号”,医学诊断正在从以往的“可视化影像”时代,迈向更加自然与普惠的“可听化医疗(Audio-based Healthcare)”。
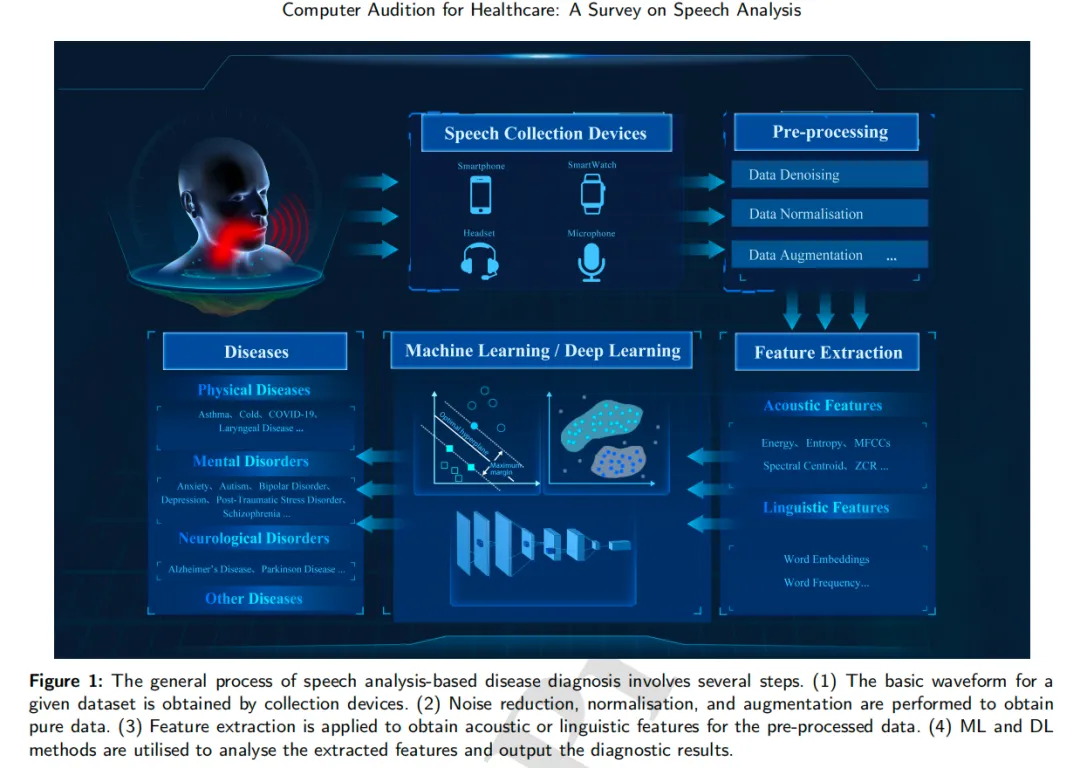
语音健康分析(Speech-based Health Analysis)是一个跨学科领域,融合了声学工程、计算机科学、生理医学与心理学等多学科知识。论文指出,一个完整的语音健康分析体系,通常包括四个核心环节:语音采集、信号预处理、特征提取与智能建模。这一流程构成了从声音到健康推理的“计算链路”。
一、语音采集
语音数据是语音健康分析系统的基础。研究者会根据不同的疾病类型和研究目标,采用多种语音采集方式。例如,控制任务(如朗读固定文本、图片描述、数数或故事复述)常用于评估发音的稳定性和认知能力;自发语音则通过自由交谈或访谈获取更自然的语音样本,更能反映情绪和心理状态;而声学生理语音(如咳嗽声、呼吸声、叹息声)则在呼吸系统或感染类疾病研究中应用广泛。论文通过系统梳理发现,目前大部分健康语音数据来自公开数据库,如EATD-Corpus、DEPAC、ADReSS、PD Dataset、DAIC-WOZ 等,涵盖心理、神经及生理三大类疾病。这些数据集不仅为算法研究提供了坚实基础,也有助于实现跨语言、跨人群的结果对比和模型泛化。
二、语音预处理
在语音采集过程中,录音往往会受到环境噪声、麦克风差异以及个体语音特征的影响,因此预处理环节对于保证数据质量至关重要。论文总结了几种常用的语音预处理方法:首先是降噪,通过谱减法、小波变换或基于深度学习的去噪模型(如DNN 去噪器)来减少背景干扰;其次是归一化,利用 Z-score 或 Min–Max 等方法消除不同录音设备和说话者之间的差异;最后是数据增强,通过添加噪声、调整语速或改变音高等方式扩充数据集,从而提高模型在不同场景下的稳定性。这些处理步骤共同作用,能够有效提升信号的信噪比,减少设备或个体差异带来的模型性能波动。
三、特征提取
论文指出,语音信号中蕴含的健康信息主要体现在声学层、语言层与情感层。因此,特征提取是将原始波形转化为可分析数据的关键环节。
在语音健康分析中,特征提取是关键环节,其中声学特征最为基础。韵律特征(如音高、能量、语速和节奏)常被用来分析心理状态与情绪变化;音质特征(如抖动、闪变、谐噪比)能够反映声带振动和共鸣腔的异常情况;而频谱特征(如MFCC、共振峰和 CQCC)则在神经疾病和呼吸系统疾病的检测中尤为重要。除了声学特征,语言特征同样具有诊断价值。研究者通常先将语音转写为文本,再利用自然语言处理模型(如 Word2Vec、BERT)分析语义与句法结构,从中识别出与心理状态相关的语言信号。例如,抑郁患者的语言中往往包含更多负面情绪词汇和自我指代。进一步地,融合特征的研究也在不断发展,将声学与语言信息结合的多模态方法在复杂疾病识别中表现突出。据报道,采用双模特征的模型在阿尔茨海默症检测中,识别准确率已能超过 95%。
四、AI建模与健康预测
在完成特征提取后,人工智能模型就承担起了识别和预测健康状态的核心任务。论文将现有的建模方法分为三类:一是传统机器学习模型,如支持向量机(SVM)、随机森林(RF)和高斯混合模型(GMM),这类方法多用于样本量较小、特征较为结构化的场景,例如抑郁症识别或哮喘分类;二是深度学习模型,包括卷积神经网络(CNN)、循环神经网络(RNN)以及双向长短期记忆网络(Bi-LSTM)等,它们能够实现端到端的特征学习,在帕金森病、阿尔茨海默症等神经系统疾病检测中表现优于传统算法;三是可解释与持续学习模型,强调模型透明度和泛化能力。可解释AI(XAI)有助于揭示语音特征与临床症状之间的关系,而持续学习框架(Continual Learning)则能让模型在不同任务间保持灵活适应。模型的性能通常通过准确率、召回率、特异度、F1分数和加权平均召回率等指标来评估。总体而言,语音分析的理论与方法体系正逐渐形成一条从声学信号到健康推理的技术闭环。它不仅是一种人工智能应用,更是一种新型的健康通信方式——让“声音”成为连接人类身体与机器智能的桥梁。
⏩基于语音分析的疾病诊断
语音是人类健康的“听觉名片”。论文指出,疾病不仅改变我们的身体状态,也会在发声、语调、节奏和呼吸方式中留下可识别的“声学印记”。通过计算机听觉(Computer Audition, CA)技术与人工智能建模,语音正成为一种全新的、非侵入式的疾病诊断工具。
一、身体疾病
语音能够反映呼吸和发声系统的生理变化,因此在呼吸道和喉部疾病的检测中发挥着重要作用。研究发现,哮喘等呼吸系统疾病由于气道收缩、气流受限,往往会在语音中留下喘息声或频谱不连续等特征。通过提取MFCC、CQCC 等声学特征,并结合 SVM 或 CNN 模型进行分析,疾病识别的准确率可达到 90%–98%。对于咽喉及声带疾病,声带炎症或损伤会导致音质变得粗糙、共振异常,利用抖动(Jitter)、闪变(Shimmer)和谐噪比(HNR)等指标可以实现早期检测。此外,在 COVID-19疫情期间,语音AI技术被广泛用于分析咳嗽声和呼吸模式,开展远程、无接触式的初筛工作,为公共卫生监测提供了新的思路。总体来看,这些研究表明,语音正在成为一种“数字听诊器”,帮助医生以更快捷、低成本的方式识别潜在的身体异常。
二、心理健康障碍
语音与情绪息息相关,是心理状态最自然的外在信号。心理健康障碍者的语音通常表现出能量不足、节奏迟缓或情绪表达单一。其中抑郁症患者表现出语音常呈现低音调、语速缓慢、停顿延长。基于Bi-LSTM、Transformer的深度学习模型,能捕捉这些微妙变化,实现自动检测。焦虑与压力同样可识别:高频颤动、呼吸急促、语音抖动等特征可反映心理紧张。通过多模态分析(语音+情感),可实时监测心理健康。而双相障碍与精神分裂症可以借助语义特征(词汇重复、句式紊乱)结合声学特征,通过AI模型实现自动区分不同心理状态。语音分析让心理健康评估从“主观问卷”转向“客观量化”,实现了被动式、连续性、无接触的心理监测。
三、神经系统疾病
神经系统疾病往往会影响语言控制和发音协调,因此语音成为了早期筛查的重要信号之一。以帕金森病(PD)为例,患者通常语调单一、语速不均、停顿增多,这些变化在共振峰漂移和频谱能量分布中都有明显体现。研究通过结合 CNN、RNN 等模型分析这些声学特征,能够实现较高的识别精度。对于阿尔茨海默症(AD)和轻度认知障碍(MCI),患者不仅在语言内容上出现词汇贫乏、语义重复、停顿延长等现象,语音特征也会发生细微变化。利用声学与语言特征融合的多模态模型,识别准确率可超过 95%。此外,在中风或脑损伤康复中,语音分析还能用于评估言语恢复的过程,帮助制定更精准的康复计划。总体来看,语音分析在神经系统疾病研究中的意义不止于辅助诊断,它更为早期干预和个体化康复提供了新的技术途径。
四、研究趋势与发展方向
论文指出,语音在医疗诊断中的研究正从“单一任务”走向“综合分析”,研究范式从实验室语音向自然场景语音转变,模型从手工特征分析迈向端到端深度学习,目标从疾病识别拓展到病程追踪与康复评估。
未来,语音AI有望与生理信号、面部表情、文本语义等多模态信息融合,形成完整的数字健康监测生态系统。
从“咳嗽声检测肺炎”到“语速识别抑郁”,再到“语义分析诊断阿尔茨海默症”,语音正在成为连接人类生理与心理的桥梁。语音将不再只是沟通的工具,而将成为医疗诊断的前线感知器,让机器真正“听懂”人类的健康。
尽管语音分析在医疗健康领域展现出巨大的潜力,但要真正进入临床应用,还面临一系列亟待解决的挑战。论文在最后一部分对这些问题进行了深入讨论,并指出了未来研究的主要方向。
一、关键挑战
在语音医疗研究中,数据和模型仍面临多重挑战。首先,数据稀缺与样本偏差问题突出。由于语音数据涉及隐私和伦理限制,加上采集需要专业设备,目前公开的医疗语音数据集数量有限,且样本分布常不均衡。例如,抑郁症或帕金森病的数据集中往往存在性别、年龄或语言比例失衡,导致模型的泛化能力受限。其次,跨语言与跨人群的适应性仍是难题。不同语言、方言和文化背景下的语音差异显著,同一种疾病在不同语言中的声学特征也可能不同,使得模型难以在全球范围推广。第三,临床验证不足。尽管已有研究在实验中取得较高准确率,但多数仍停留在实验室阶段,缺乏与临床金标准(如神经影像、生化检测)的对照验证,临床落地仍需多中心合作与长期试验。此外,模型的可解释性与信任问题也备受关注。深度学习模型常被视为“黑箱”,难以明确说明其决策依据,这对医生和患者来说都是信任障碍。最后,隐私与伦理风险同样不容忽视。语音数据包含个人身份、情绪甚至健康信息,如何在保护隐私的前提下实现数据共享与算法训练,已成为推动该领域发展的核心挑战之一。
二、未来研究方向
未来,语音分析将在人工智能医疗中扮演更加重要的角色。研究者提出,多模态融合将成为关键方向——语音数据可与面部表情、生理信号(如心率、脑电图)以及文本语义相结合,构建更全面的健康画像,从而提升诊断的准确性与疾病区分能力。与此同时,联邦学习与隐私保护技术的发展,使得“数据不出医院”成为可能,医院之间能够在不共享原始数据的前提下共同训练模型,为隐私安全提供保障。未来的模型还需要具备更高的可解释性,通过可视化声学特征和引入注意力机制,帮助医生理解AI的决策依据,增强临床信任。另一方面,构建跨语言与跨文化模型也至关重要,以实现语音AI在多语言环境下的普适应用。为推动落地,研究者还呼吁建立统一的标准化与临床验证体系,制定数据采集规范、评价指标,并与医疗机构合作开展大规模实验。最终,语音分析将融入智能医疗生态,与可穿戴设备、手机应用和云端健康平台协同工作,形成真正意义上的“可听化医疗系统”。正如论文所强调的那样,语音分析正让医疗从“看病”走向“听病”,它的意义不仅在于辅助诊断,更在于实现持续、个性化的健康管理。
语音,是人类最自然的表达方式,也正在成为医学最具潜力的“新型传感器”。从呼吸声到语速变化,从抑郁的语调到帕金森的发音抖动,每一次发声都携带着身体与心理的微妙信号。
而随着计算机听觉(Computer Audition)与人工智能技术的融合,机器终于具备了“倾听健康”的能力。
论文《Computer Audition for Healthcare: A Survey on Speech Analysis》为这一领域勾勒出系统的蓝图:
它不仅总结了语音健康分析的理论框架、算法体系与应用前景,更揭示了语音作为数字生物标志物(Digital Biomarker)的科学意义。
语音分析正让医学诊断从“可视化影像”迈向“可听化智能”,让健康监测从“检测时刻”延伸为“实时陪伴”。
当然,前路仍有挑战:数据不足、模型可解释性、跨语言适应与隐私保护,都是语音AI走向临床的必经考验。
但正如作者所言——“Speech is a reflection of the human condition — by learning to listen, machines can begin to heal.”
在未来的智能医疗体系中,“听诊”不再只是医生的专属动作,而将成为AI的第二感官。
也许有一天,当你对着手机说出一句“我有点累”,算法已经能听出你身体的异常、心理的压力,甚至给出健康建议。
那时,语音将真正成为医疗世界的一种新语言,一种能被AI听懂的生命信号。
