
 语音小管家
这篇论文主要想解决全双工口语对话系统(SDS)的核心难题——怎么让系统同时“听、说、思考”还不混乱,重点提出了一个“语义 VAD”当对话管理器(DM),用轻量级 LLM 搞定轮次切换,平衡了交互流畅度和计算效率。
原文链接:https://arxiv.org/pdf/2502.14145
知乎:蘑菇炖提莫
背景干扰:旁边有人说话会搞乱语音识别(ASR)和对话管理,比如系统误启动或乱回复; 用户停顿犹豫:不能光靠“没声音”就判断用户说完了——可能人家只是卡壳,早回复或等太久都尴尬; 无意打断:用户随口说句“哦对”(搭话)或跟别人聊天,系统要是误以为是打断自己,就会停掉回复,打乱节奏。
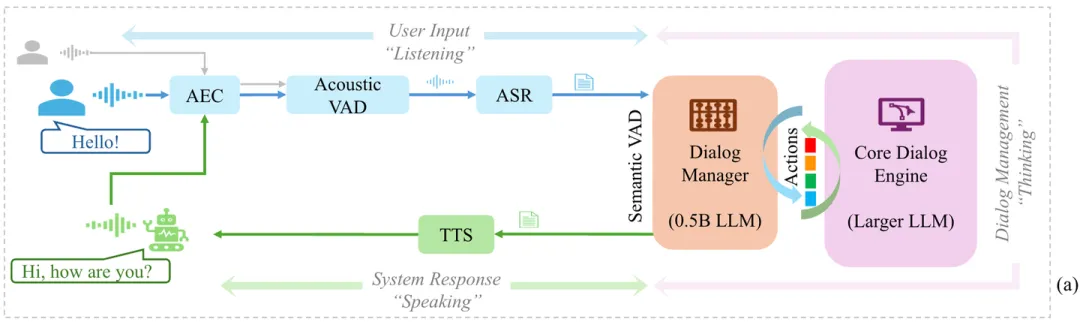
声学回声消除(AEC):先干掉环境杂音; 声学 VAD:靠声音特征隔离“目标用户”,过滤背景说话人; 语音识别(ASR):把用户语音转成文字; 语义 VAD(重点!也就是对话管理器 DM):用轻量 LLM 判断用户状态,输出控制指令; 核心对话引擎(CDE):大 LLM,只在需要生成回复时启动(省算力); 语音合成(TTS):把 CDE 的文字回复转成声音。
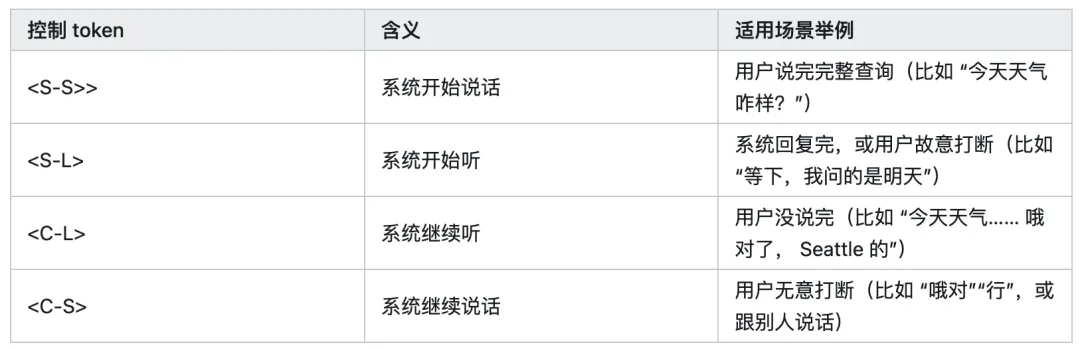
用户没说完→系统继续听; 用户故意打断→系统停说开始听; 用户随口搭话→系统接着说。
只有当 DM 输出<|S-S|>时,才激活 CDE 生成回复; - 其他时候(比如<|C-L|> <|C-S|> <|S-L|>),CDE 都歇着——既保证实时性,又省算力。
数据来源:用 Yuanbao 生成,prompt 里明确要求“带控制 token、用户可打断系统”; 控制变量:话题池(200 个常见主题,比如天气、旅行)、说话风格池(10 种人设,比如 casual、正式)、QA 轮次(2-12 轮,随机); 场景覆盖:按概率生成四种场景——正常对话(没打断)、真打断(用户故意改话题)、假打断(用户随口搭话)、未完成查询(用户卡壳); 数据处理:生成后清洗(只留 60% 符合格式的)、增强(调整标点匹配 ASR 输出),最后得到 11990 个对话、80338 轮,还特意平衡场景比例(避免模型学偏,比如别全是正常对话)。
训练设置:加四个控制 token 当特殊词,训 1500 步,batch size=128,学习率从 0.001 慢慢降到 0.0001(保证稳定); 防退化:训练时混着“普通无打断对话”,避免模型忘了基础对话能力。
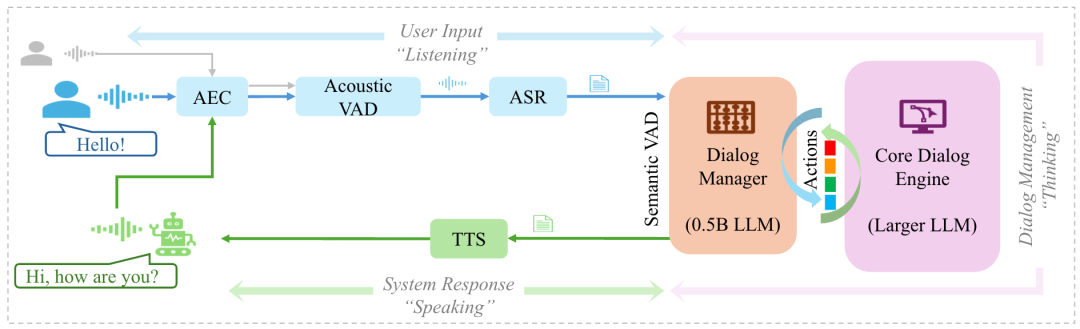
流程:用户语音→AEC(去杂音)→声学 VAD(滤背景人)→ASR(转文字)→语义 VAD(DM 做决策)→按需激活 CDE(生成回复)→TTS(转声音输出); 重点:CDE 不一直工作,靠 DM“按需调用”,省算力。
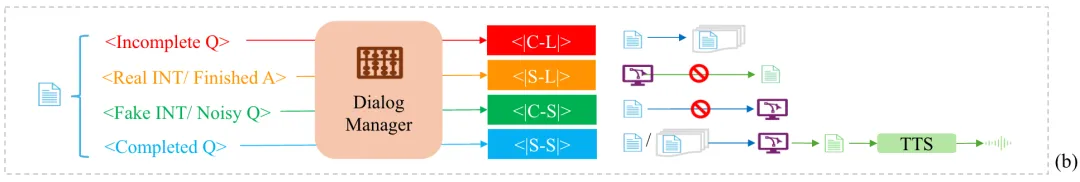
DM 的输入:ASR 的用户文字 + CDE 的历史回复(图里没画全,但逻辑里有);
DM 的输出:控制 token 决定 CDE 是否启动——只有<|S-S|>时 CDE 才工作,其他时候 CDE 歇着;
作用:讲清“谁指挥谁”,突出“按需激活”的效率优势。
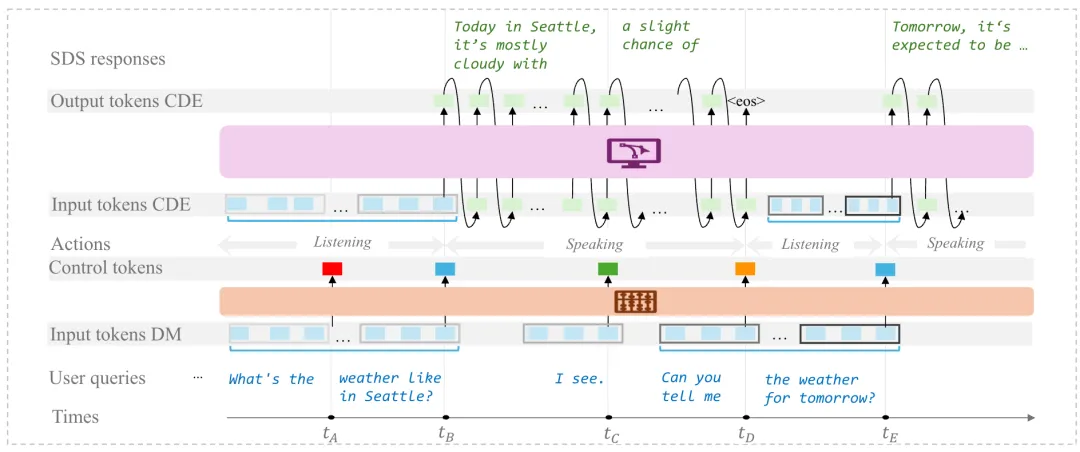
场景:用户问 Seattle 天气,系统回复到一半,用户打断“Pass me the salt, please.”(跟别人说话,假打断)→系统继续说;用户又问“明天呢?”(真打断)→系统停说,回复明天天气; 作用:展示完整的全双工聊天流程,能看到 token 怎么实时调整系统动作。
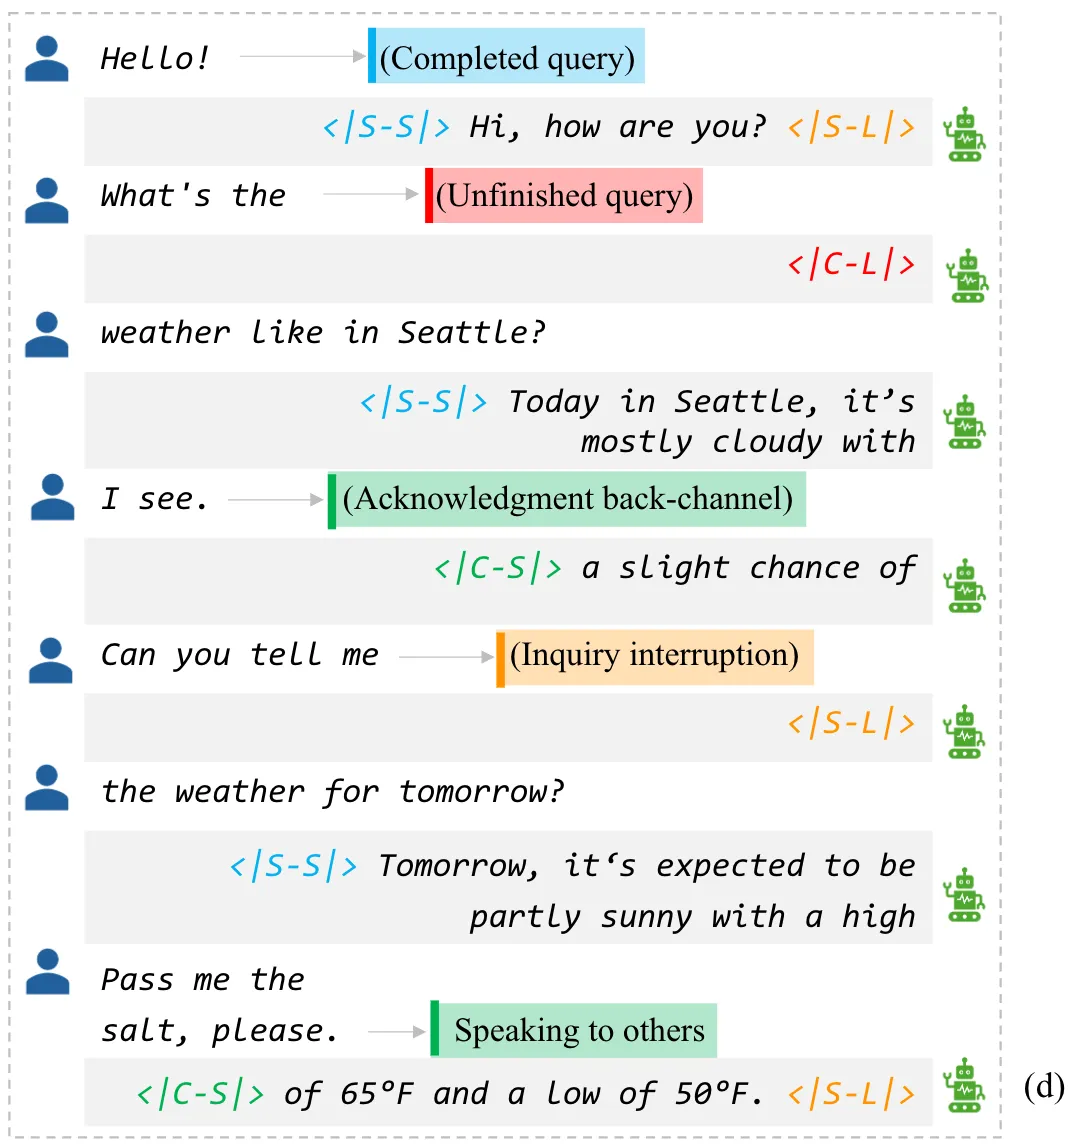
左边是用户输入:“Hello!”(完整查询)→DM 输出<|S-S|>(系统开始说),说完后<|S-L|>(系统开始听);“What’s the”(没说完)→DM 输出<|C-L|>(系统继续听); 右边是用户打断:“I see.”(无意搭话,假打断)→DM 输出<|C-S|>(系统继续说);“Can you tell me the weather for tomorrow?”(故意打断,真打断)→DM 输出<|S-L|>(系统停说开始听); 作用:直观展示四个 token 怎么用在实际场景里。
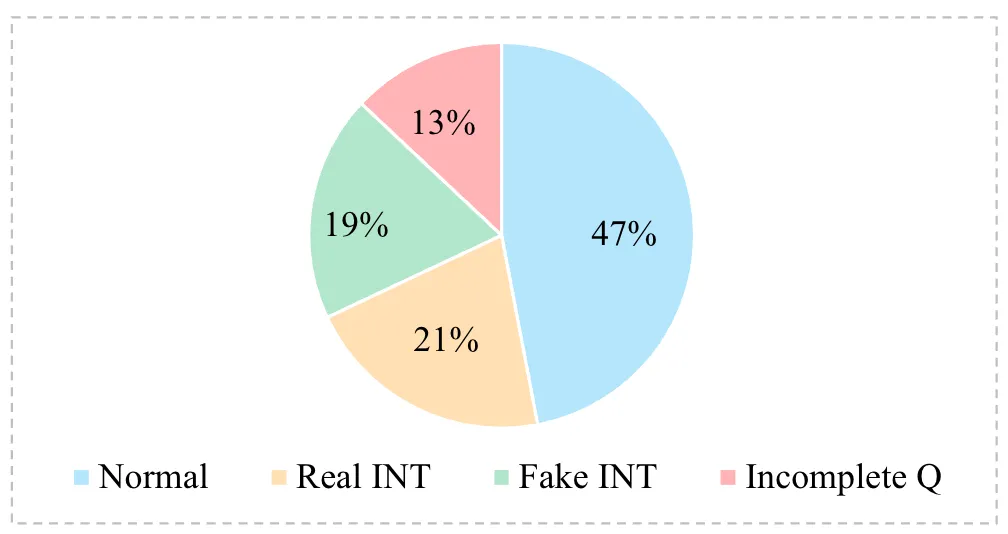
比例:正常对话 47%、真打断 21%、假打断 19%、不完整 13%; 作用:说明数据集场景平衡,不会让模型只擅长某一种情况(比如只懂正常对话,不懂打断)。
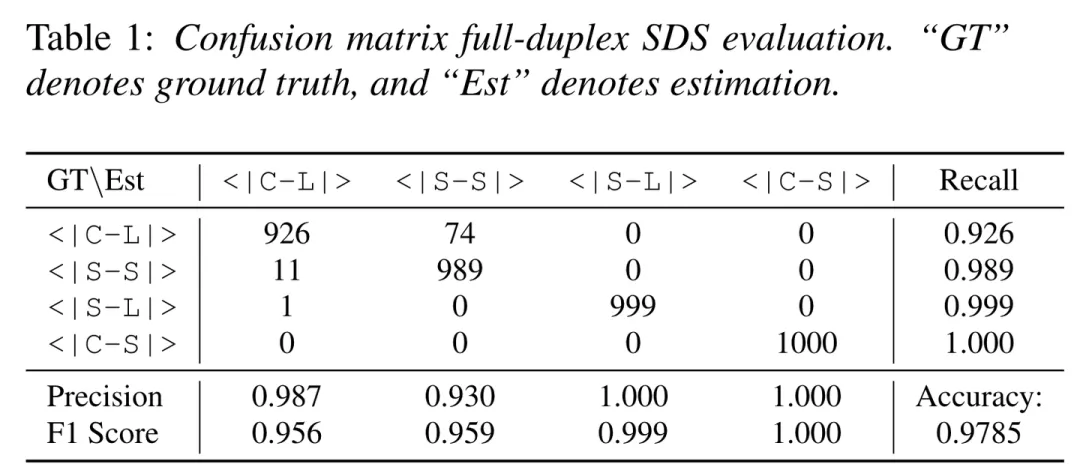
召回率(模型漏判多不多):<|C-S|>100%(用户真说完了,模型全猜对)、<|S-L|>99.9%(用户真要打断,模型几乎全猜对)、<|S-S|>98.9%(用户假打断,模型很少漏判)、<|C-L|>92.6%(用户没说完,稍微差点,但也不错); 精确率(模型误判多不多):除了<|S-S|>93%,其他三个都是 98.7% 以上,甚至 100%; 整体准确率:97.85%; 结论:语义 VAD 预测 token 非常准,尤其是判断“用户说完没”和“是不是故意打断”,几乎不会出错。
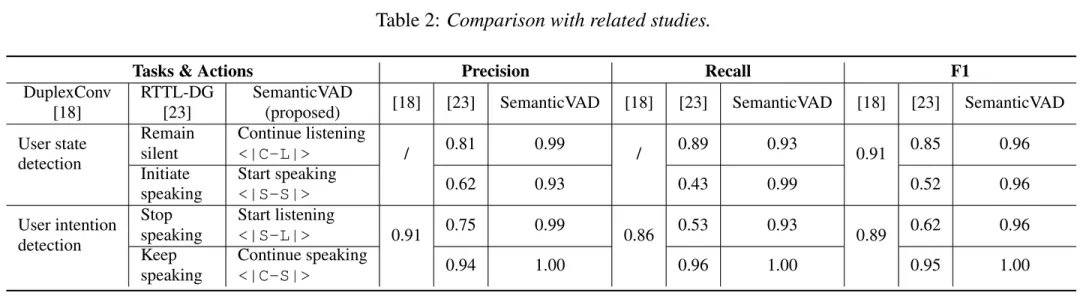
结论:因为用了 LLM 的语义理解,我们的方法比之前只靠“声音+简单语言模式”的方法好太多,尤其是判断“用户是不是故意打断”和“是不是没说完”。
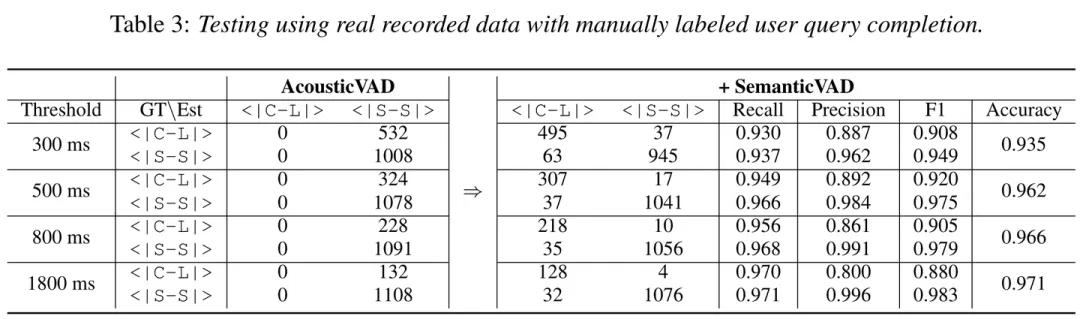
声学 VAD 的问题:只能靠“沉默时间”判断,比如 300ms 没声音就瞎猜“用户说完了”,完全不管语义; 加语义 VAD 后的提升: 300ms 阈值:准确率从声学 VAD 的瞎猜→93.5%,F1 值 0.908; 1800ms 阈值(沉默很久):准确率 97.1%,F1 值 0.983; 错误原因:大部分错是因为 ASR 把用户话译错了,不是语义 VAD 本身不行; 结论:在真实场景里,语义 VAD 能大幅提升判断准确率,解决声学 VAD“只看声音不看意思”的坑。
用语义 VAD 当 DM:靠 0.5B 轻量 LLM,既保留了 LLM 懂语义的优势(比传统 VAD 准),又不会像大 LLM 那样费算力; 四个控制 token 精准控轮次:能分清“有意/无意打断”“查询完没完成”,聊天更流畅; DM 与 CDE 独立优化:调 DM 不用重训大 CDE,后续改逻辑更灵活,还能按需激活 CDE 省算力; 自己造高质量数据:用 Yuanbao 生成带控制 token 的全双工数据,解决了没公开数据的问题,还平衡了场景比例。
