
 语音小管家
语音转换(Voice Conversion, VC)旨在在不改变语言内容的情况下,将源说话人的语音转换为目标说话人的语音,广泛应用于电影配音、虚拟人、语音聊天等场景。然而在真实应用场景中,VC 系统面临两大挑战。
环境噪声:用户录音往往嘈杂,模型需具备强鲁棒性。
表现力不足:传统方法过度依赖 ASR 特征保证稳定的语音转换效果,难以保留韵律和情感,生成语音单调僵硬。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)的论文“REF-VC: Robust, Expressive and Fast Zero-Shot Voice Conversion with Diffusion Transformers”被语音研究领域重要会议 IEEE Workshop on Automatic Speech Recognition and Understanding(ASRU) 接收。该论文提出了REF-VC,通过随机擦除策略和隐式对齐策略,兼顾零样本语音转换的鲁棒性与表现力。现对该论文进行简要的解读。
论文题目:REF-VC: Robust, Expressive and Fast Zero-Shot Voice Conversion with Diffusion Transformers
合作单位:南京大学、网易、吉利
作者列表:姜月鹏,宁子谦,王帅,汪承佳,毕梦霄,朱鹏程,付中华,谢磊
论文链接:https://arxiv.org/html/2508.04996v2
样例展示:https://rxy-j.github.io/asru2025/
语音转换(Voice Conversion, VC)是一项将源说话人声音转换为目标说话人音色,同时保持语义信息不变的技术,被广泛应用于影视配音、语音聊天、虚拟人以及游戏角色塑造等场景。然而,实际应用中仍存在两大关键挑战:
噪声鲁棒性不足
在真实场景中,用户语音往往包含环境噪声。
传统基于自动语音识别(ASR)的模型在噪声处理上具有一定优势,能较好地区分语音与噪声,但由于其训练目标过度强调语义信息,会显著压制韵律、情感等副语言信息,使得生成语音听起来“平淡无感”。
表现力保留不足
近年来基于自监督学习(SSL)的模型(如WavLM[1])被引入 VC,可更好地保留音高、情感和非语言特征(如笑声、叹息),生成的语音更自然、富有表现力。
SSL特征容易导致音色泄露,并且对噪声极为敏感。需要通过聚类等操作来添加信息瓶颈。
如何同时兼顾鲁棒性 + 表现力,成为当前VC研究的关键问题。此外,在实际应用场景下,推理速度也是重点。
针对上述挑战,本文提出REF-VC—— 一个兼具Robustness(鲁棒性)、Expressiveness(表现力)、Fast(快速)的零样本语音转换系统,基于扩散 Transformer(Diffusion Transformer, DiT)框架,融合 ASR 与 SSL 特征的互补优势。
随机擦除策略(Random Erasing Strategy)
训练中随机将部分 SSL 特征替换为噪声,以强制模型主要依赖ASR模型的瓶颈特征(Bottleneck Feature)进行语音建模。有效避免模型过度依赖SSL特征重建音频,不仅保留了瓶颈特征提供的鲁棒性和稳定性,还显著提高了转换结果的表现力,同时明显缓解了SSL表征带来的潜在的音色泄露问题。
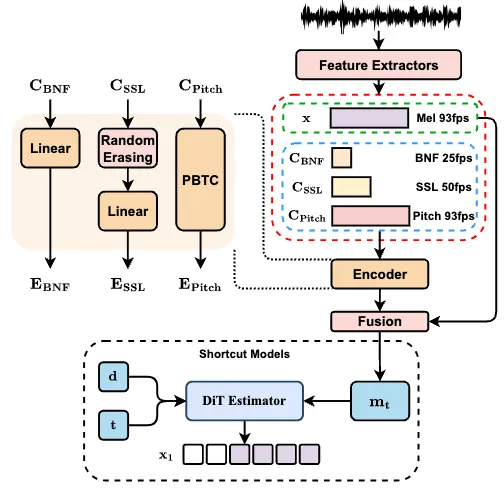
图1 模型主体结构以及随机擦除策略
隐式对齐机制(Implicit Alignment)
传统 VC 模型的输入特征与目标特征帧率往往不同,多采用插值方式或扩帧的方式将两者对齐。这使得模型在重建时容易保留输入中各种细节,同时也包含了噪声。
REF-VC 借鉴 E2TTS[2] 的思路,利用隐式对齐解决输入输出特征帧率不同的问题。利用TTS对齐学习的特征显著减少模型对于无规律细节的重建,更好地抑制背景噪声干扰,提升语音清晰度与自然度。
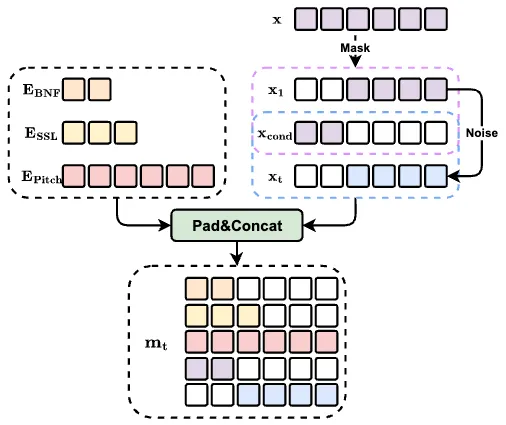
图2 隐式对齐机制的实现细节
Shortcut Models 加速推理
流匹配模型通常需要几十步迭代采样,推理成本高。REF-VC 引入Shortcut Models[3],在流匹配(Flow Matching)的基础上引入捷径机制,使模型能“跨步前进”,将推理步骤从32 步缩减至 4 步。音质几乎不下降,但推理效率大幅提升。
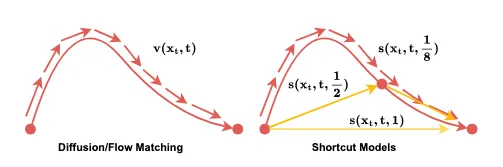
图3 Shortcut Models和Flow Matching的推理过程对比
数据:使用Emilia[4]语料库(约 10 万小时,涵盖多语种和多风格语音)进行训练。
测试集:
干净集:从WenetSpeech[5]和Emilia中抽取的 100 条语音。
噪声集:真实设备录制的 50 条带有环境噪声的语音。
目标说话人:随机选择 10 个未见过的目标说话人,验证零样本能力。
对比系统:
Seed-VC [6](开源的 SOTA VC 系统)
VITS-VC(基于 VITS 的内部模型)
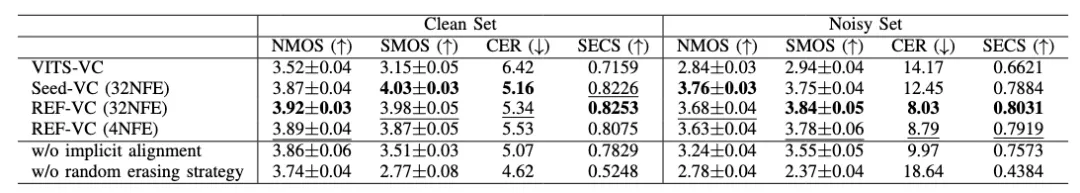
表1 主观测试与客观测试结果
主观评价(MOS, ABX)
在韵律和非语言内容(如笑声、叹息、语气词)还原上,通过ABX测试可以看出,REF-VC 明显优于 Seed-VC 和 VITS-VC。
通过自然度得分(NMOS)和音色相似度得分(SMOS)可以看到,REF-VC在干净测试集上小幅超过Seed-VC,在噪声测试集上保持了与干净测试集非常接近的表现。
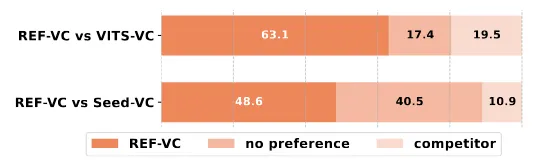
图4 VITS-VC、REF-VC与Seed VC在韵律相似度的ABX测试结果
客观评价(SECS, CER)
在干净语音上,REF-VC 与 Seed-VC 表现相当。而在噪声语音上,REF-VC 显著优于 Seed-VC。Seed-VC 在噪声下性能大幅下降,而 REF-VC 保持稳定。
消融实验
如表1所示,去掉随机擦除策略会导致音频质量和说话人相似度显著下降,说明该策略不仅能抑制 SSL 特征中与语音无关的模式,还能有效减少音色泄露。此外,引入隐式对齐可进一步提升音频重建质量。图 5 的对比显示,原始音频存在明显背景噪声(a),去掉随机擦除策略生成的音频仍有噪声(b),仅去掉隐式对齐时噪声有所残留(c),而我们的完整模型几乎完全消除了背景噪声(d)。
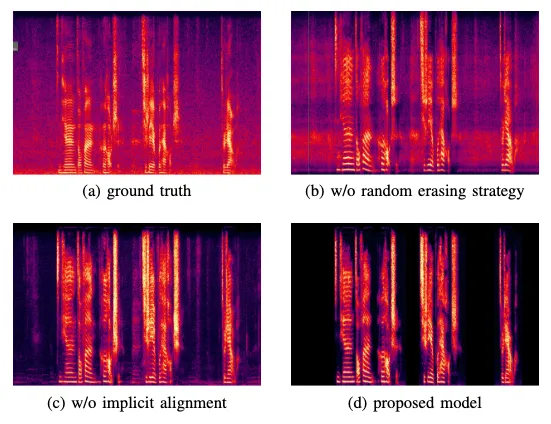
图5 消融实验的语谱图可视化
[1] S. Chen, C. Wang, Z. Chen, Y. Wu, S. Liu, Z. Chen, J. Li, N. Kanda, T. Yoshioka, X. Xiao, J. Wu, L. Zhou, S. Ren, Y. Qian, Y. Qian, J. Wu, M. Zeng, X. Yu, and F. Wei, “Wavlm: Large-scale self-supervised pre- training for full stack speech processing,” IEEE J. Sel. Top. Signal Process., vol. 16, no. 6, pp. 1505–1518, 2022.
[2] S. E. Eskimez, X. Wang, M. Thakker, C. Li, C.-H. Tsai, Z. Xiao, H. Yang, Z. Zhu, M. Tang, X. Tan et al., “E2 tts: Embarrassingly easy fully non-autoregressive zero-shot tts,” in Proc. SLT, 2024, pp. 682–689.
[3] K. Frans, D. Hafner, S. Levine, and P. Abbeel, “One step diffusion via shortcut models,” CoRR, vol. abs/2410.12557, 202.
[4] H. He, Z. Shang, C. Wang, X. Li, Y. Gu, H. Hua, L. Liu, C. Yang, J. Li, P. Shi, Y. Wang, K. Chen, P. Zhang, and Z. Wu, “Emilia: An extensive, multilingual, and diverse speech dataset for large-scale speech generation,” CoRR, vol. abs/2407.05361, 2024.
[5] B. Zhang, H. Lv, P. Guo, Q. Shao, C. Yang, L. Xie, X. Xu, H. Bu, X. Chen, C. Zeng, D. Wu, and Z. Peng, “WENETSPEECH: A 10000+ hours multi-domain mandarin corpus for speech recognition,” in Proc. ICASSP, 2022, pp. 6182–6186.
[6] S. Liu, “Zero-shot voice conversion with diffusion transformers,” CoRR, vol. abs/2411.09943, 2024.
