
 语音小管家
大家好,欢迎来到「AudioCC交我学」专栏!
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、什么是EEG
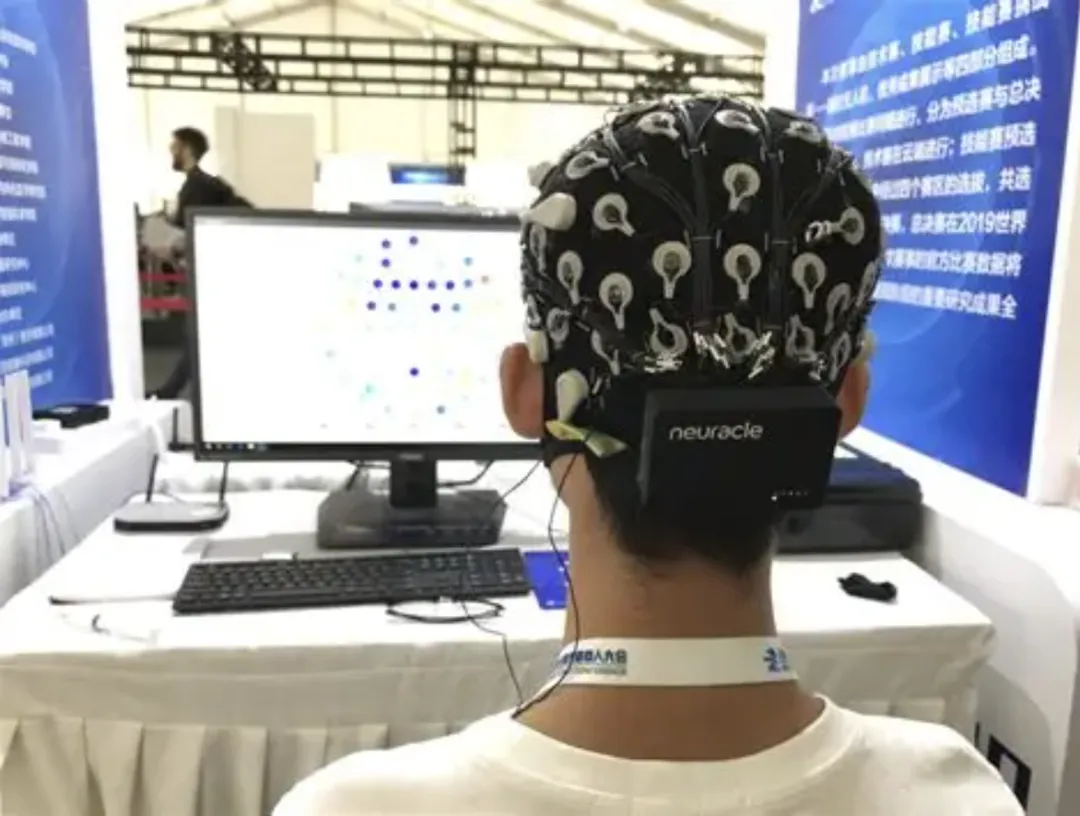
脑电图(EEG)是一种通过头皮电极记录大脑电活动的非侵入式技术,具有毫秒级的时间分辨率,特别适合研究听觉、语言和注意等快速变化的认知过程。相比 fMRI 等成像手段,EEG 虽然在空间分辨率上略逊一筹,但设备成本低、部署灵活,更有希望走向临床床旁监测、可穿戴设备以及日常人机交互等应用场景。
二、EEG和Speech有什么关系
在语音领域,近几年大规模自监督模型,如 wav2vec2、HuBERT,已经在语音识别、说话人识别和语音表示学习等任务上取得了显著进展。这类模型可以从原始声波中自动抽取分层次、富语义的特征,极大减轻了对手工特征设计和大规模标注数据的依赖。
在这两个方向的交汇处,一个自然的问题随之出现:能否把语音领域已经训练好的模型与技术迁移到 EEG 场景中,让“会听声音”的模型也学会“读脑电”,从而提升脑电解码的效率和上限?
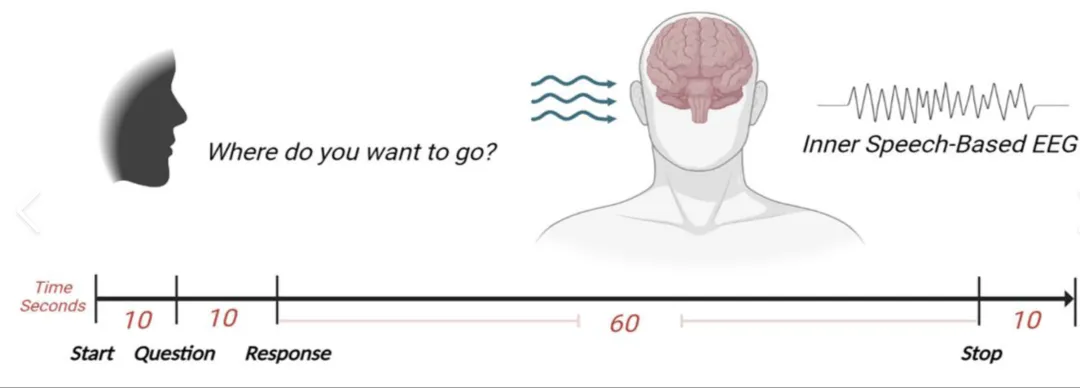
围绕这一问题,目前的研究大致出现了两条路线:一条是直接借用预训练语音模型,把 EEG 或其他脑信号视作一种新的“波形语言”,在其上提取时间特征甚至端到端建模;另一条是借鉴语音自监督学习的范式,为 EEG 设计专门的预训练任务和模型结构,训练出面向多任务、多数据集的 EEG foundation model。
下面讲介绍几篇在这方面具有代表性的工作。
三、论文分享
1.Speech2EEG:让wav2vec2直接理解EEG
Speech2EEG的思路非常直接:将已经在大规模语音数据上预训练好的wav2vec 2.0,当作EEG的时间特征提取器使用。
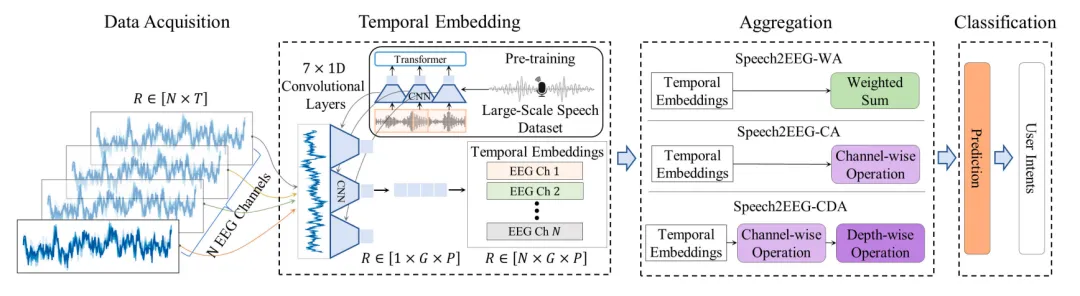
在输入端,可以把一段EEG看成由若干通道组成的多维时间序列。作者对每一个通道,直接套用wav2vec2的7层一维卷积前端。这个卷积子网的总体感受野大约覆盖400个采样点,步长约为320个采样点,在250 Hz采样率下,大致相当于1.5秒长的时间窗,每次滑动约1秒的设置。这样一来,每个通道都会被切分成一串相互重叠的时间片段,每个片段经过卷积子网后被编码成一个512维的特征向量。把所有通道上得到的这些时间特征按通道和时间顺序堆起来,就形成一个大小为“通道数 × 时间帧数 × 512”的时序特征张量,其中时间帧数对应的是卷积滑窗得到的那些时间片段个数。
在时间嵌入之后,Speech2EEG设计了三种聚合方式,将多通道、多时间步的特征压缩成适合分类的表示:
WA(Weighted Average):对所有时间 × 通道× 特征做一次可学习的加权和,结构最简单、参数最少。
CA(Channel-wise Aggregation):使用跨通道的一维卷积在时间轴上滑动,实现类似空间滤波的效果,显式利用电极之间的空间拓扑关系。
CDA(Channel + Depth-wise Aggregation):在CA的基础上再加入逐深度卷积,既聚合通道,也建模不同特征维度之间的交互,表达能力最强。
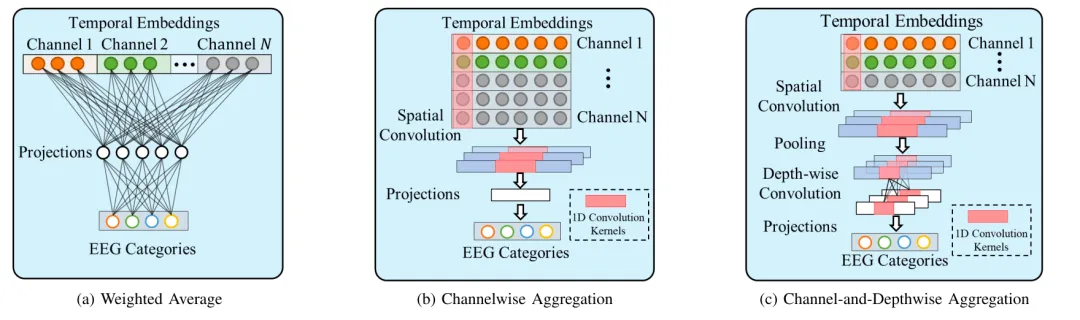
三种聚合方式的输出均接入一个小型的多层感知机(MLP)分类器,用于实现运动想象(MI)任务的类别判别。
实验结果:
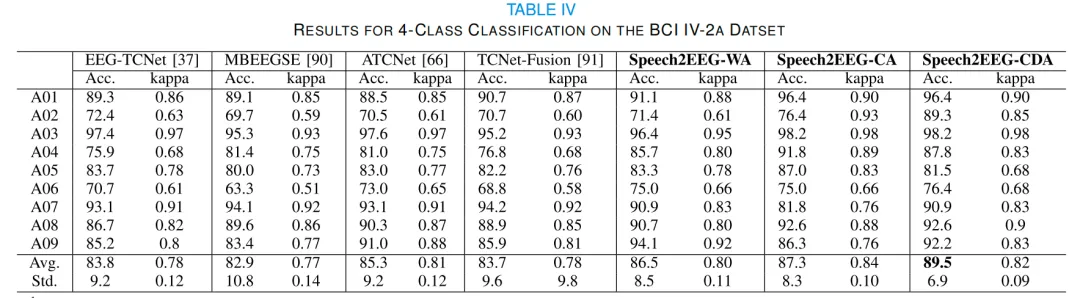
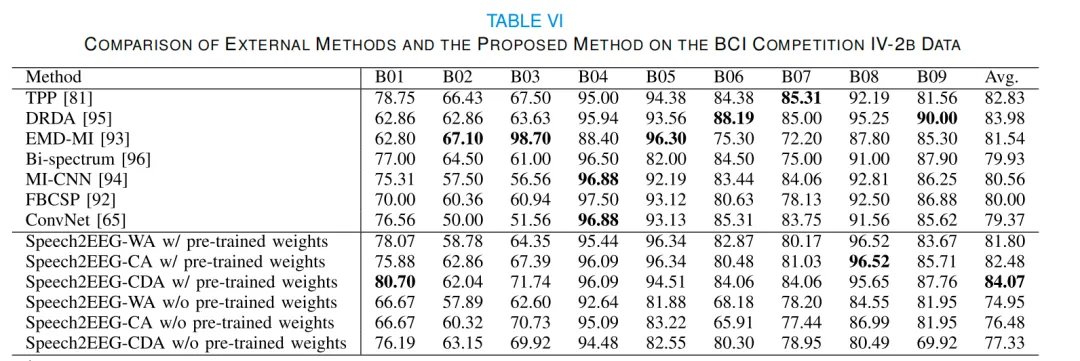
在BCI Competition IV-2a/2b 两个经典MI数据集上,最强的 Speech2EEG-CDA 在四类MI任务中的平均准确率接近89.5%,明显优于 EEGNet、ATCNet 等从零训练的EEG模型。更重要的是,当不加载wav2vec2的预训练权重,仅在EEG上随机初始化训练时,CDA的性能明显下降,甚至会落后于较为简单的基线网络。这表明,在小样本、低信噪比的EEG场景中,预训练语音模型提供的底层时间特征具有重要价值。
2.Teaching Wav2Vec2 the Language of the Brain:将完整语音识别模型迁移到脑信号
相比上一篇只使用wav2vec2的卷积前端,这篇工作尝试将完整的wav2vec2 语音识别模型迁移到脑信号上。该研究使用的是侵入式微电极记录,目标是直接实现brain-to-text:从脑活动解码出字符级别的文本。
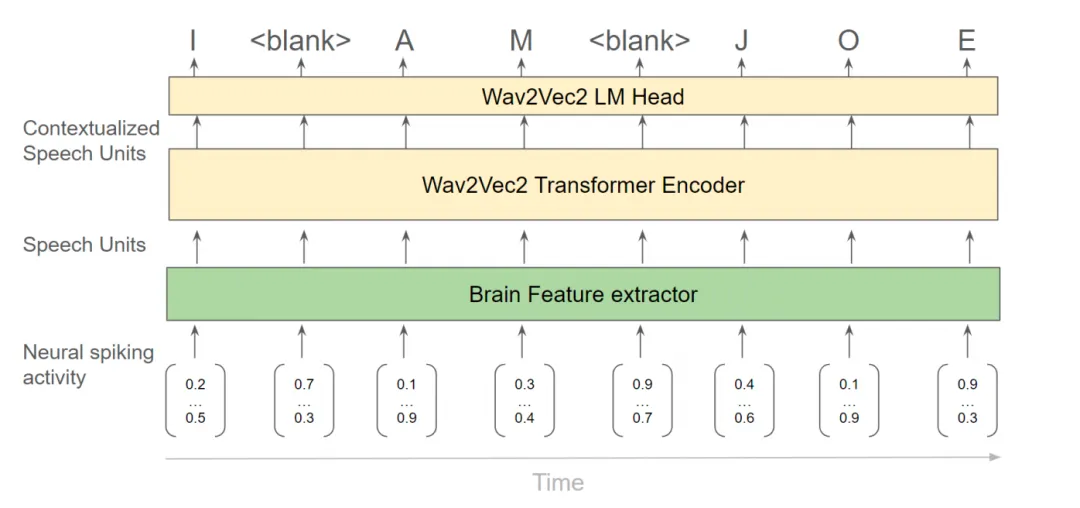
在原始的 wav2vec2 中,前端是一串1D卷积网络,输入为 16 kHz 语音波形;在这项工作中,作者将该部分完全替换为一个Brain Feature Extractor(BFE),包含若干层双向 GRU(Bi-GRU)及全连接层,用于处理每20 ms一帧的神经放电统计特征(阈值越线次数、功率等)。BFE的输出被投影到 768 维,使其形状与原本的语音特征一致,作为“伪语音特征”输送给预训练的wav2vec2 Transformer编码器和CTC语言建模头,直接预测字符序列。
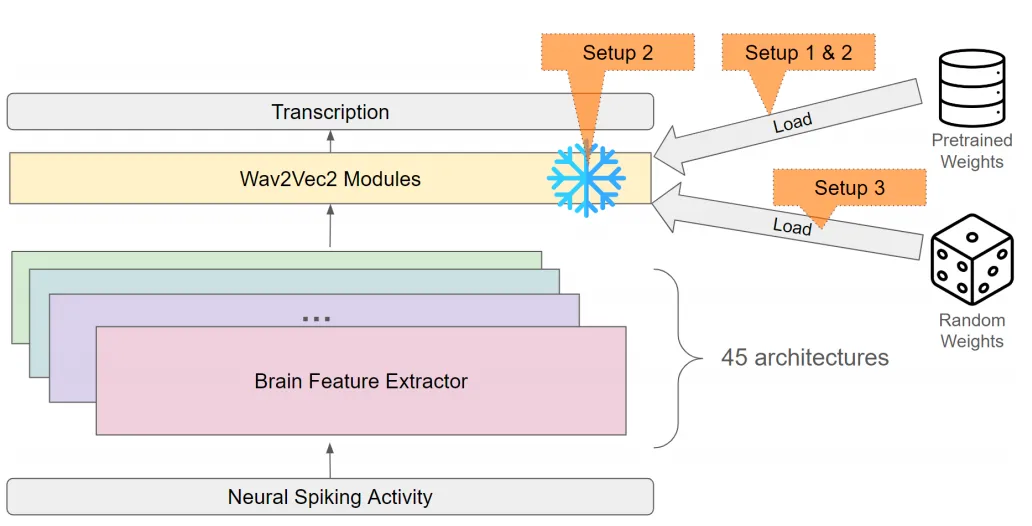
为了系统评估预训练的作用,作者在45种不同BFE架构上设计了三类训练设置:
Full Fine-Tuning:Wav2Vec2 Transformer + CTC 头加载语音预训练权重,与BFE一起端到端微调。
Frozen Wav2Vec2:Wav2Vec2模块同样加载预训练权重,但在训练中完全冻结,只更新BFE的参数。
Training from Scratch:Wav2Vec2与BFE全部随机初始化,从零开始训练。
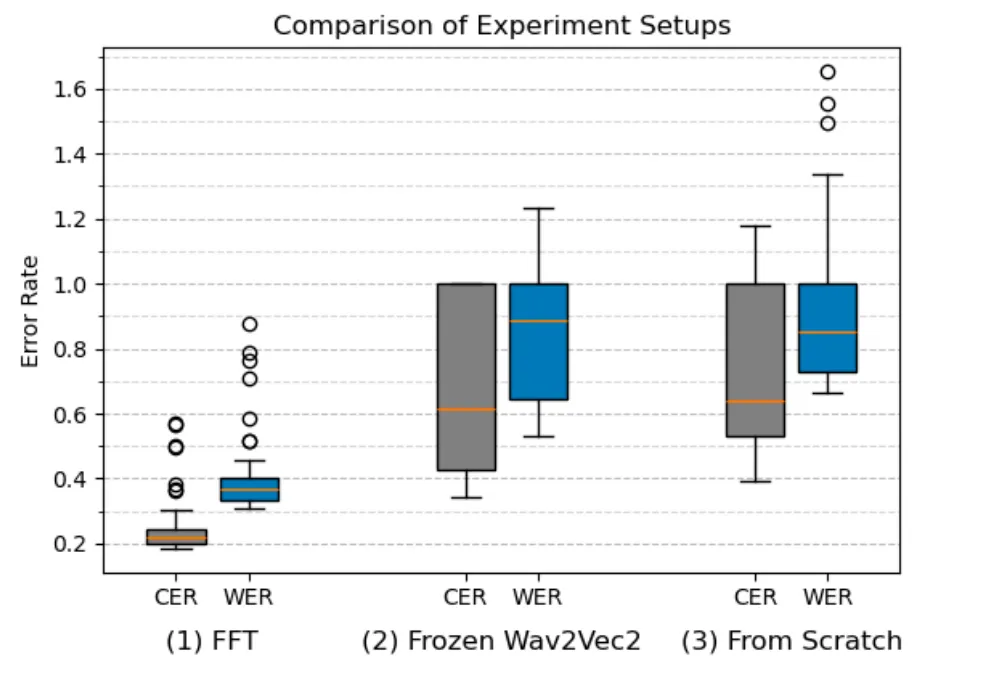
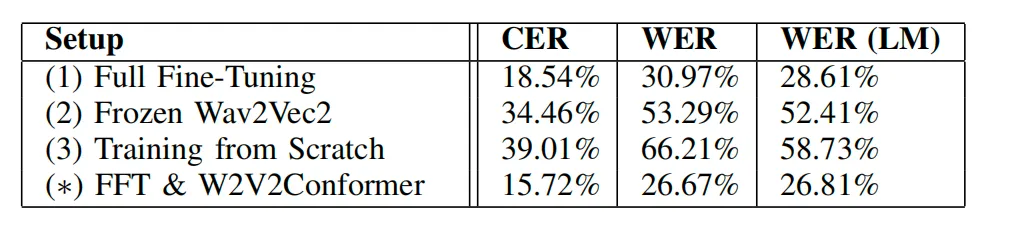
在相同数据集上,三种设置的最佳结果具有明显差异:从零训练时WER约为 66%;预训练但冻结时WER降至约53%;而在预训练 + 全微调的设置下,WER 能进一步降到约31%。在采用更强的Conformer结构后,WER甚至可以进一步降至26% 左右。
迷你尺度的 t-SNE 可视化为这种改进提供了直观解释。作者分别将来自音频CNN的语音特征、来自BFE的脑特征,在进入Transformer前后投影到二维平面:
在进入Transformer之前,两种特征几乎分成两团不重叠的红/蓝点,表明脑特征和语音特征的分布差异很大;经过预训练的Transformer编码后,二者的分布开始明显混合,红蓝点高度交错。
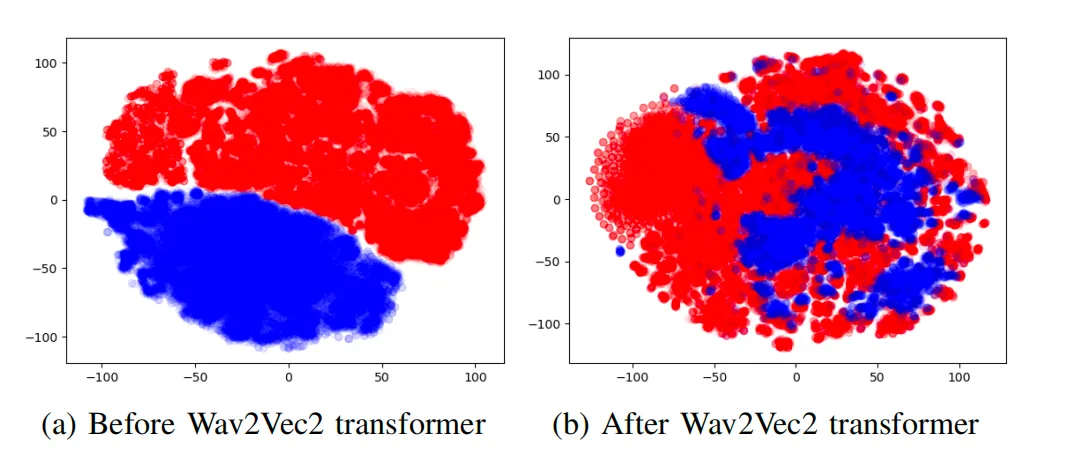
这说明,Wav2Vec2的Transformer模块不仅具备语言建模能力,同时在一定程度上也扮演了“跨模态对齐器”的角色:即便前端的脑特征与原始语音特征差异巨大,预训练的Transformer仍然能够将两种模态映射到相对相似的高层表征空间。这一现象从侧面印证了预训练语音模型在brain-to-text场景中的迁移潜力。
3.LaBraM:EEG 自身的预训练大模型
与以上两篇直接借用语音模型权重的工作不同,LaBraM(Large Brain Model for EEG)代表的是另一条路线:在不依赖语音模型的前提下,为EEG训练专门的foundation model。尽管没有显式使用语音网络结构,其总体框架仍然深受 wav2vec、BERT等在语音和自然语言处理上广泛使用的自监督方法的启发。
LaBraM的预训练主要分为两个阶段:
Neural Tokenizer:从EEG到离散 token将多通道EEG切成时间patch;通过卷积 + Transformer 提取每个patch的连续特征;使用向量量化(VQ)将特征映射到codebook中的离散向量,形成EEG的“词表”;训练目标不是重建原始波形,而是重建每个 patch 的傅里叶幅度和相位,使token更稳定、信息量更高。
MaskedEEGModeling:EEG版的掩码语言建模采用类似 BERT / wav2vec 的 masked prediction 任务:随机遮盖一半的patch,用统一mask向量替换;
将带掩码的序列送入Transformer encoder,只在被遮挡的位置预测正确的token ID;同时引入对称掩码,用补集位置进行第二次遮盖,在一次训练中获得两种视角,提高样本利用率。
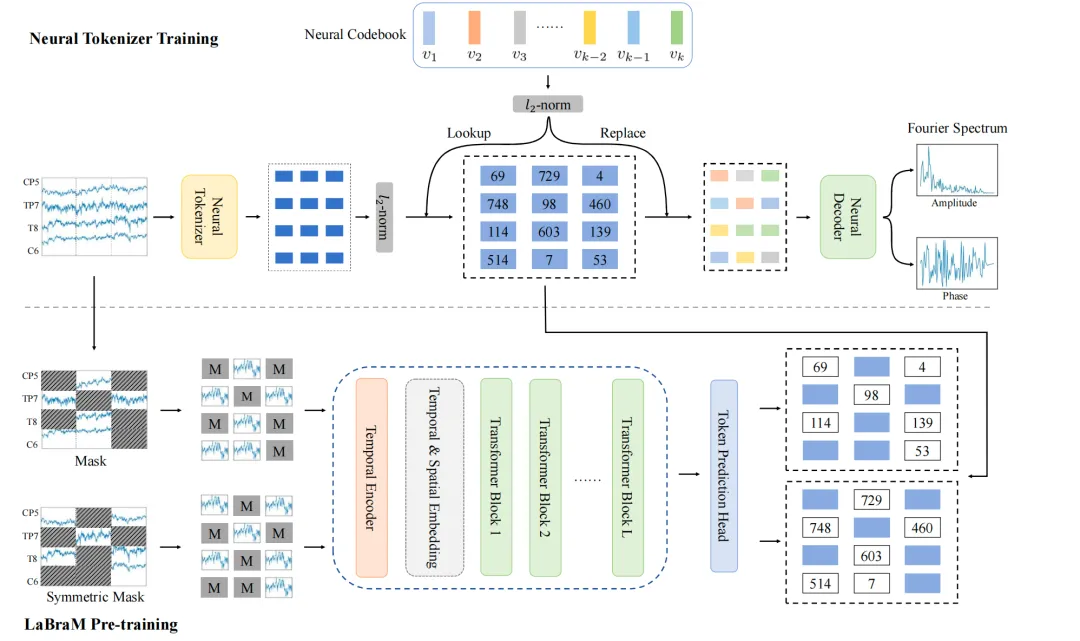
在完成大规模预训练后,作者在多个下游任务上对LaBraM进行微调,包括临床EEG的异常检测(TUAB)和癫痫相关事件分类(TUEV)等。与此前的 BIOT、SPaRCNet 等模型相比,LaBraM在Balanced Accuracy、AUROC等指标上通常能带来3–10个百分点的提升。更重要的是,即使在预训练阶段不包含TUAB/TUEV的样本,这两个数据集上的微调结果也基本不变,表明模型学到的表征具有较好的任务与数据集泛化能力。
从的整体视角来看,LaBraM虽未直接迁移语音网络权重,却在任务设计和训练范式上借鉴了语音自监督学习的成功经验,为EEG构建了一个可以在多任务间迁移的基础模型,与前述两篇基于语音模型迁移的工作形成了一个互补的参照。
四、简要小结
将这三篇工作放在一起,可以勾勒出一条从语音模型到EEG模型的潜在演化路径:
Speech2EEG:利用预训练语音模型的卷积前端,为EEG提供高质量的底层时间特征,再通过相对简单的多通道聚合网络完成分类。
Teaching Wav2Vec2:将完整的wav2vec2 Transformer与CTC语言模型迁移到脑信号领域,仅替换前端为Bi-GRU + 全连接的脑特征提取器,在brain-to-text任务上显著优于从零训练。
LaBraM:在不直接使用语音权重的前提下,为EEG训练专门的foundation model,通过Neural Tokenizer与maskedEEGmodeling学到跨数据集、跨任务的通用表征。
这些路线并不是互斥的。可以预见,未来更大的EEG预训练语料、更精细的EEG–Speech–Text三模态对齐,以及对语音与语言模型的进一步迁移,将共同推动从“会听声音的模型”,走向“既能听声音,也能理解大脑”的脑–机智能系统。
供稿:郑欣虎,编辑:方楠,审核:韩冰
