
 语音小管家
A Survey on Speech Large Language Models for Understanding
论文作者:彭景¹²*,王雨诚³*,李波含¹²,郭奕玮¹²,王翰坤¹²,方衍贵⁵,奚彧¹²,李浩宇¹²,李旭⁴,张克⁶,王帅⁷,俞凯¹²
单位:¹ 上海交通大学计算机学院X-LANCE实验室,² 江苏省语言计算及应用重点实验室,³ 苏黎世联邦理工学院,⁴ 思必驰科技股份有限公司,⁵ 华中科技大学,⁶ 香港中文(深圳)大学,⁷ 南京大学智能科学与技术学院,* 共同一作
发表:IEEE Journal of Selected Topics in Signal Processing
论文简介:
语音理解对于解析语音中所蕴含的多种信息至关重要。这些信息既包括语义信息,也包括副语言信息和非语言信息,它们共同支撑着高效的人机交互。大语言模型(Large Language Models, LLMs)的迅速发展催生了语音大语言模型(Speech Large Language Models, Speech LLMs,后简称为语音大模型),推动语音理解系统向通用化方向发生范式转变。为进一步系统刻画语音理解的任务目标,本文首次对“语音理解”给出形式化定义,并从信息维度、功能维度和形式维度出发构建了一个结构化的任务分类体系。在此定义框架下,我们对当前代表性的语音大模型进行全面综述,从“模态特征提取—模态信息融合—大模型推理”三个阶段对其体系结构进行抽象与分析。同时,我们还系统梳理了现有模型的训练策略、数据集以及主流评测方法。基于实证分析和实验结果,本文提出了当前语音大语言模型面临的核心挑战:对指令高度敏感以及语义推理能力退化等。并据此提出若干具有可操作性的改进方向。通过这一份系统而细致的综述,我们期望为相关研究者和工程实践者提供一个坚实的参考框架,以推动构建更稳健、更具泛化能力且更加符合人类偏好的语音大模型。
完整论文:https://arxiv.org/abs/2410.18908
完整论文:https://ieeexplore.ieee.org/document/11278041(Online Version)
论文结构概览
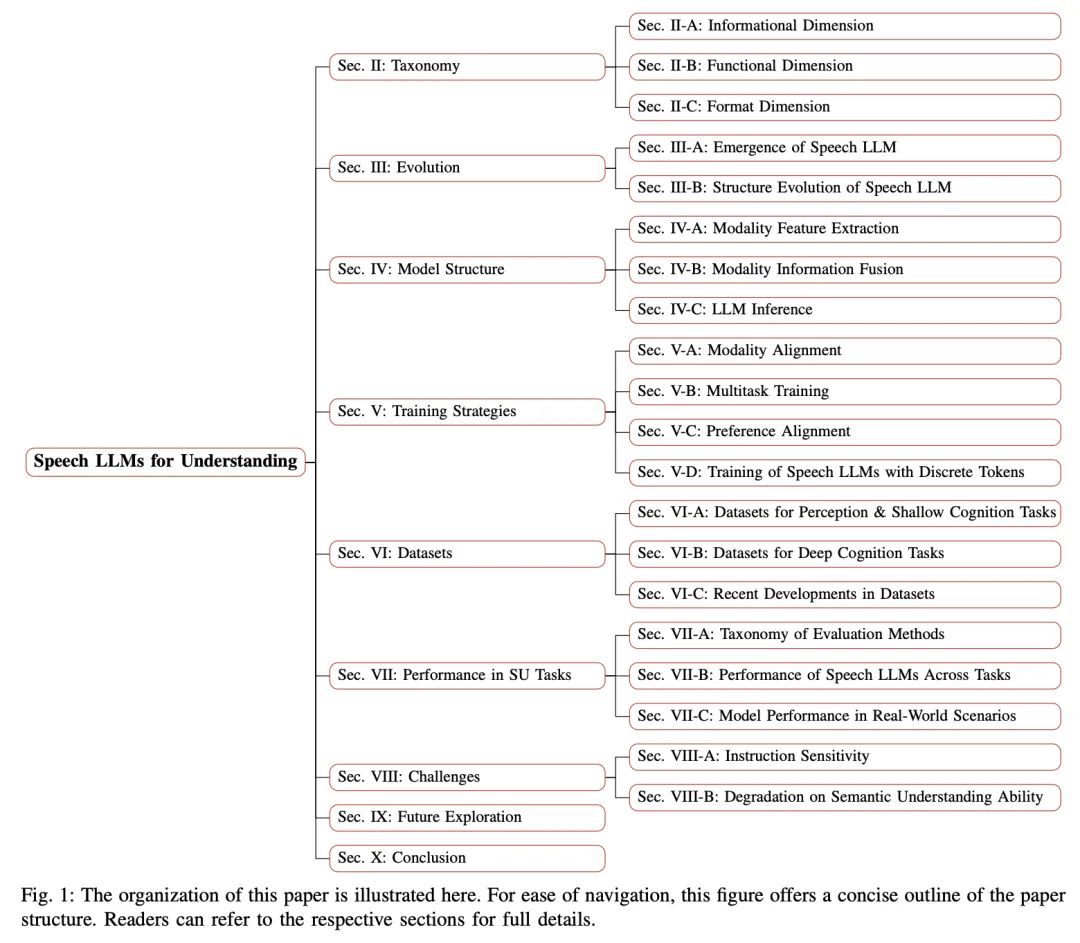
文章主要分为十个章节,从语音理解的定义出发,阐述面向语音理解任务的语音大模型的发展;并着重分析了模型的架构,进一步归纳了当前的主流训练范式以及使用数据集;接着综合展示当前语音大模型在语音理解任务上的性能,归纳总结并用实验论证当前面临的挑战;最后提出未来可能的研究方向并做出总结。(如下图所示)
研究动机
首先,正如文章摘要所述:“大语言模型的迅速发展催生了语音大语言模型,推动语音理解系统向通用化方向发生范式转变”。简单来说,在语音大模型出现之前,面向语音处理的模型系统,往往只能处理一种或者少数几类任务,而当前的语音大模型可以拥有多任务交叉的能力。为了更加明确、清晰地刻画描述这里的“多任务”是什么,这篇综述首次给了“语音理解”做了一个系统性的定义和解读。
其次,在基于给出的语音理解的系统定义下,论文从这一视角展开了当前语音大模型的综合阐述。而为什么需要从语音理解这个视角切入语音大模型,则是本文的第二个研究动机,这也是和其他同期综述论文的重要区别所在:
其一,从语音处理系统的发展来看:当前的语音处理系统,在特定的语音处理任务下(比如自动语音识别、关键词识别等)已经达到了相当优秀的水平,但是在面对更加丰富且较为复杂的语音信息理解任务时,仍有提升的空间。这里的丰富且复杂的语音信息理解任务,需要系统具有处理和整合多样化语音信息的能力,也就是语音理解的能力。故而出色的语音理解,是语音处理系统发展的一个重要目标。
其二,从主流语音大模型的设计来看:几乎当前所有的主流语音大模型都将语音理解作为一个核心的“组件”。无论是在架构上给出相应的设计,还是在训练和评估将其作为一个重要的参考指标。而反过来看,正是因为以文字模态为输出的语音理解任务能够被更加精确地评估,所以才会在语音大模型的设计中得到更加重要的关注。
语音理解任务的定义以及结构化分类
首先,什么是语音理解任务?语音理解是指:从语音输入中挖掘并阐释有意义信息的多模态认知过程。它不同于自然语言理解:后者主要关注语言层面的认知,即从符号化文本中推断语义、逻辑以及情感等含义。相比之下,语音理解还融入了关键的“感知”环节:语音这一模态不仅携带语言内容,还同时承载着副语言信息和非语言信息。
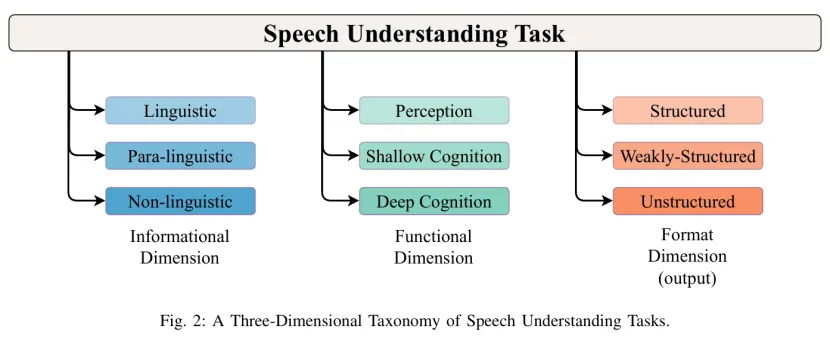
那么,为了更加全面且具象化地描述语音理解任务,我们从三个维度给出了分类阐述:
信息维度(Informational Dimension):按语音中所承载和需要建模的信息类型划分任务:主要包括语言信息(词汇、句法)、副语言信息(情感、语气、说话人意图)以及非语言信息(背景声、声场与交互场景等)。
功能维度(Functional Dimension):从认知目标与任务难度对语音理解进行分级:将任务分为侧重信号抽取的感知任务,依赖模式与启发式的浅层认知任务,以及需要复杂上下文建模和推理的深层认知任务。
形式维度(Format Dimension):依据任务的输入–输出结构与形式化方式进行划分:一方面区分是否结合结构化先验(如热词表、说话人向量、知识库等)与非结构化上下文;另一方面按输出结果是结构化、弱结构化还是开放式生成来衡量任务的结构化程度及其客观可评测性。
面向语音理解的语音大模型的发展
在对语音理解进行了系统化的定义和分类后,本文重点阐释了面向语音理解的语音大模型的发展。我们从两个维度进行展开,纵向从语音理解任务的处理系统的历史发展脉络梳理,以及横向从语音大模型的不同技术架构发展角度阐述,具体来说:
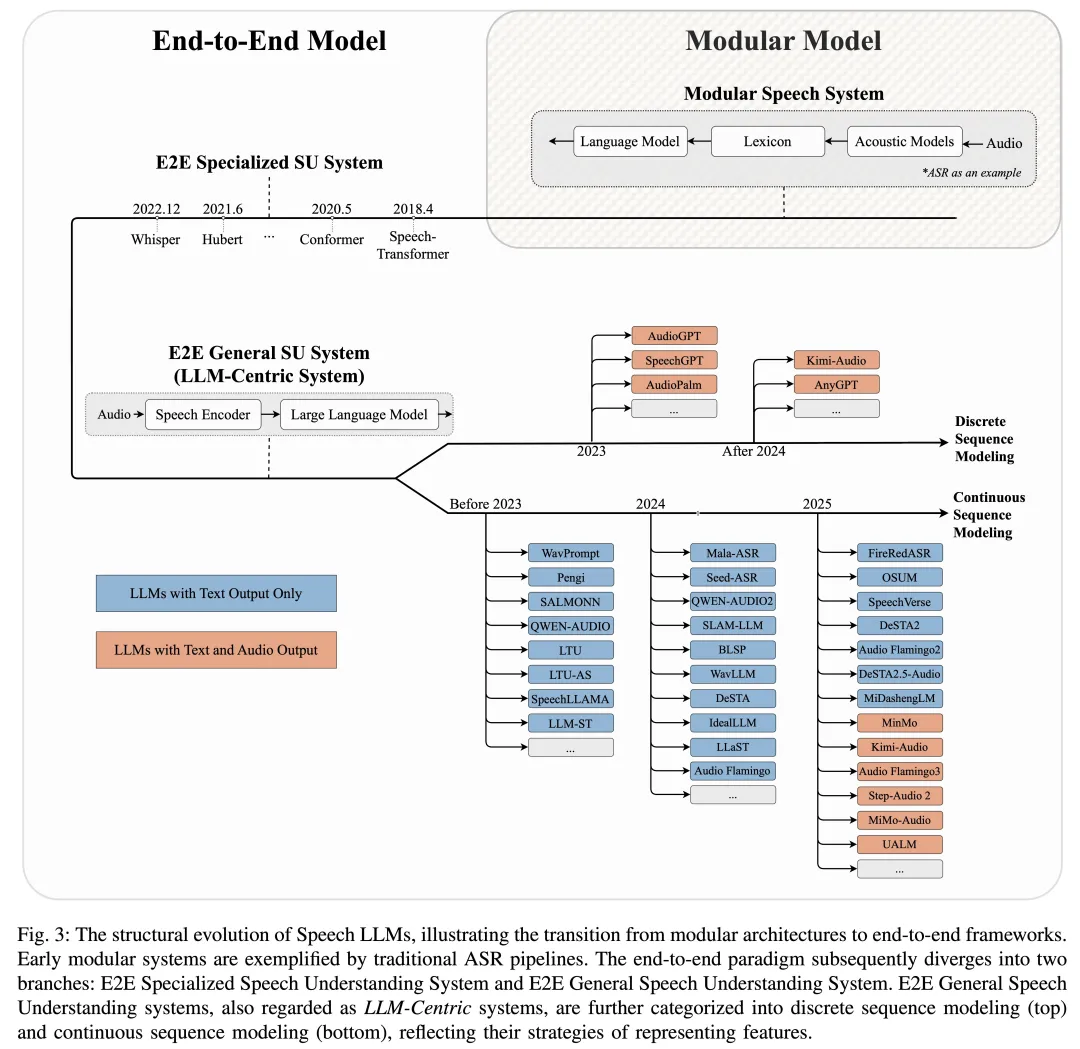
(1)从级联到统一:Speech LLM的出现本文先回顾传统语音理解从“声学模型+语言模型+解码器”的模块化级联系统(ASR→NLU)发展到端到端专用系统(CTC、RNN-T、AED+SSL 编码器),再到以 LLM 为核心的端到端通用语音理解系统。最后一类被称为Speech LLM:用语音编码器把语音映射到文本空间,由大模型统一完成推理、生成与多任务指令式调用,实现从“感知驱动”向“认知驱动”的范式转变。
(2)从离散到连续:Speech LLM 的结构演化本文接着从语音信息的表征建模形式划分两大技术架构路线:
离散序列建模:通过 HuBERT、EnCodec 等将语音量化为离散声学 token,再用 LLM 像处理文本一样处理/生成语音token,便于统一实现听说一体的生成式框架;
连续序列建模:保留 Whisper、WavLM 等编码器输出的连续嵌入,通过投影层接入 LLM,在同一框架下完成精细语音感知与高层推理。
值得一提的是,本文重点关注后者,并认为连续建模更契合当前面向语音理解Speech LLM的发展趋势。
语音大模型的模型架构
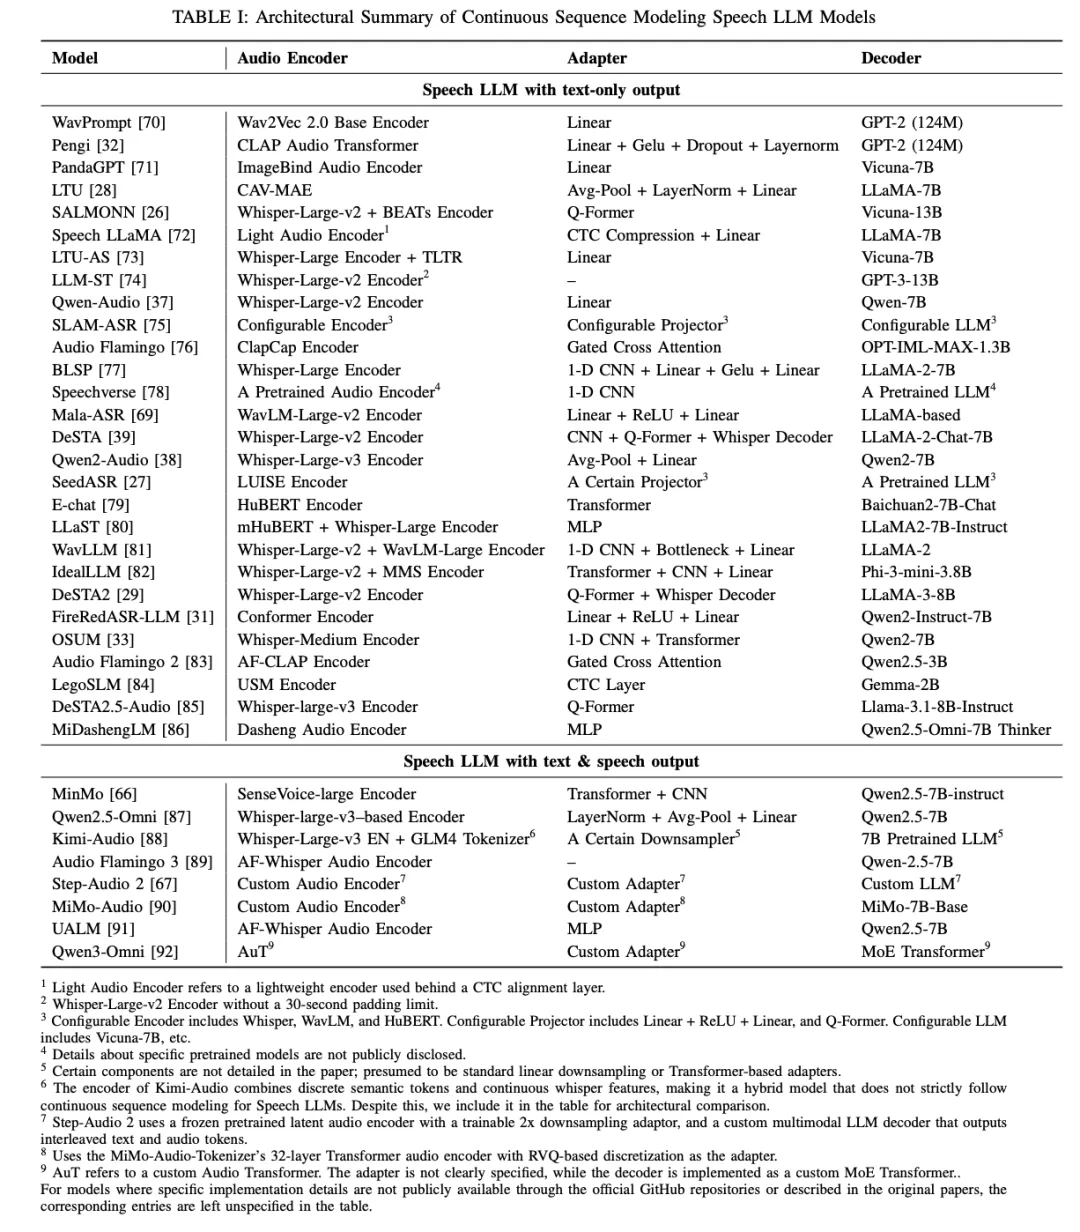
针对目前语音大模型的整体模型架构,我们发现,当前主流的Speech LLM在结构上,已经基本达成了一定的共识。从系统层面看,大多数面向语音理解的 Speech LLM,其实都可以被抽象为一个高度一致的三阶段结构:模态特征提取 → 模态信息融合 → 大模型推理。
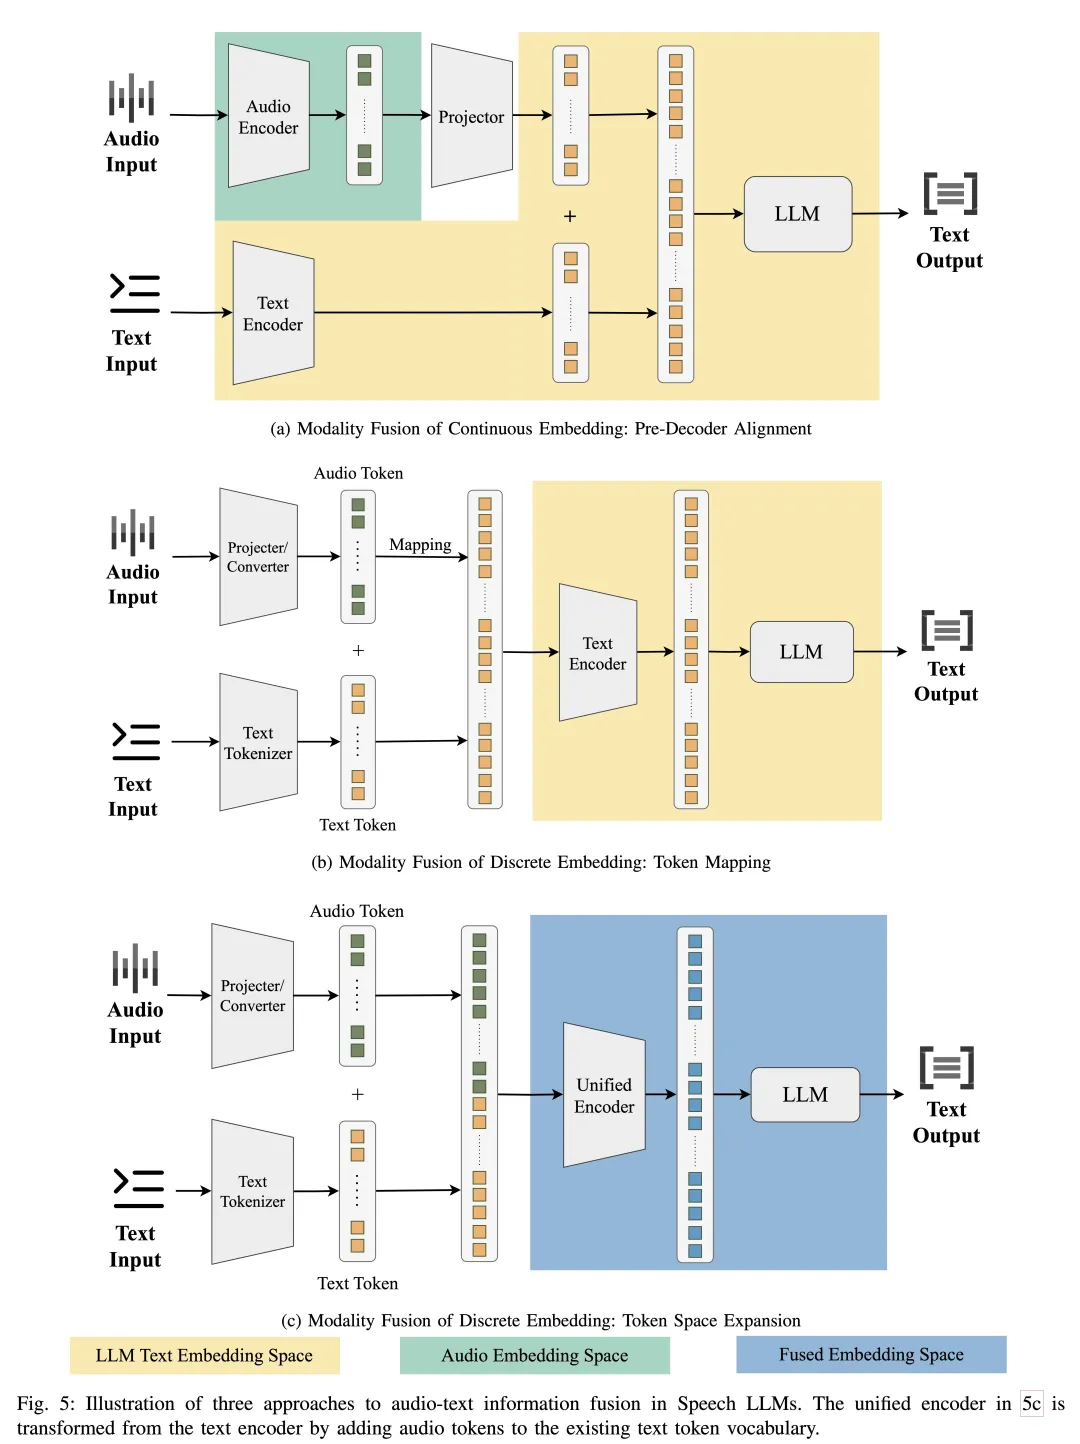
第一阶段:模态特征提取。这一阶段的目标并不是“直接理解”,而是尽可能完整地表征语音中所包含的多种信息——既包括词汇与内容的语义信息,也包括情感、说话风格、背景声等副语言与非语言线索。因此,当前模型需要依赖于强大的预训练语音编码器,将连续语音映射为高维时序表示。
第二阶段:模态信息融合。在这一阶段,模型解决了多模态大模型所共有的核心问题:如何将语音信息对齐并输入语言模型?我们在综述中将现有方法大致归纳为两条技术路线:一类保留连续语音表示,通过投影、Q-Former或交叉注意力机制将语音嵌入注入 LLM;另一类则倾向于将语音离散化为类似文本的 token,以更彻底地融入语言模型的处理范式。
不同选择在信息保真度、计算效率以及与 LLM 兼容性之间,体现了明显的权衡,这些权衡也深刻影响了后续模型的能力边界。
第三阶段:以 LLM 为核心的推理与生成。与传统语音系统不同,在 Speech LLM 中,语言模型不再只是“下游模块”,而是承担起统一推理、指令理解与输出生成的核心角色。语音输入在前两阶段完成对齐后,被视作与文本等价的输入条件,由 LLM 统一完成从感知到认知的映射。这一设计,使得语音理解任务首次真正具备了统一的指令接口,也成为 Speech LLM 支持多任务泛化的关键基础。
依据此,我们对音频使用连续特征建模的主流语音大模型进行了结构化的总结:
语音大模型的训练范式
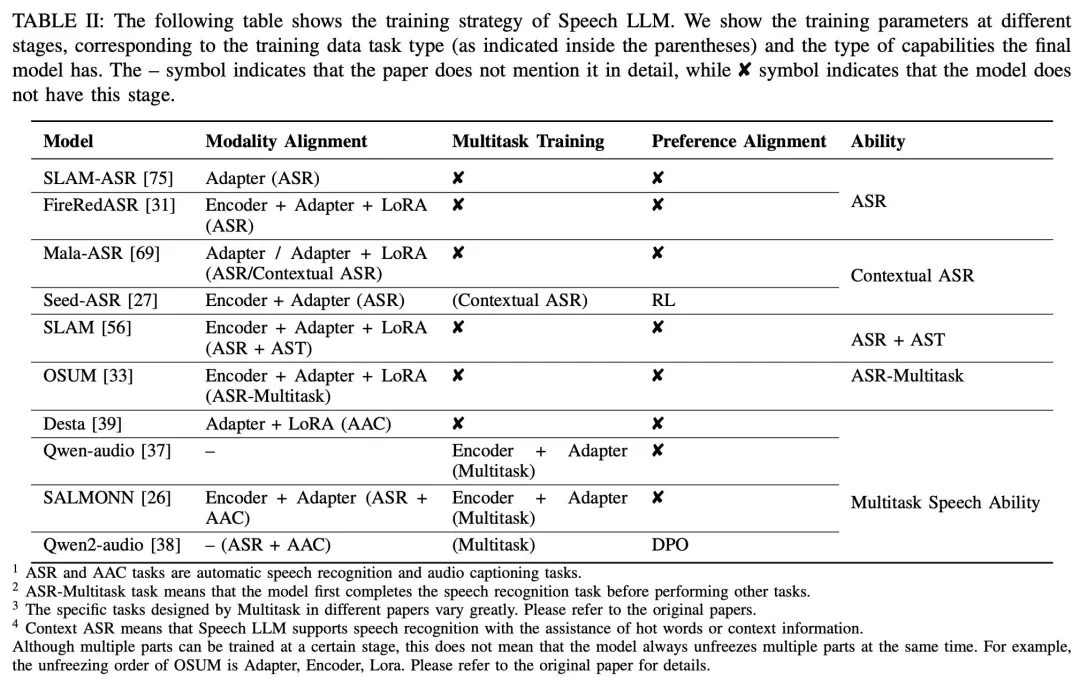
从整体上看,当前主流 Speech LLM 在训练策略上呈现出较为一致的结构特征。不同工作虽然在具体任务和实现上有所差异,但在整体逻辑上,大多围绕语音与文本的对齐、任务能力的扩展以及交互行为的稳定性逐步展开。
首先,模型通常需要完成语音模态与文本空间的对齐。这一阶段常依托 ASR、音频描述等任务,使语音编码器产生的表示能够被语言模型有效利用,从而建立起跨模态的基本映射关系。这一过程更多解决的是模态可用性问题,而非直接提升复杂语义理解能力。
在此基础上,模型的训练目标进一步扩展至多种语音理解任务。通过在翻译、情感识别、问答、总结等不同任务上的联合训练,Speech LLM 开始展现出跨任务迁移与泛化的潜力。这一阶段标志着模型从面向单一目标的语音系统,转向更具通用性的语音理解框架。
最后,许多工作还引入了指令或偏好相关的训练策略,以约束模型的输出形式和响应行为,使其在交互设置下更加稳定和可控。该阶段并不直接决定模型是否具备语音理解能力,但在实际应用中对模型行为一致性具有重要影响。
总体而言,这套训练范式已经在当前 Speech LLM 研究中被广泛采用,并逐渐成为一种默认配置。也正是在这样相对统一的训练背景下,不同模型在任务表现和能力稳定性上的差异,才更值得被系统性地分析和比较。
语音大模型训练数据集总结
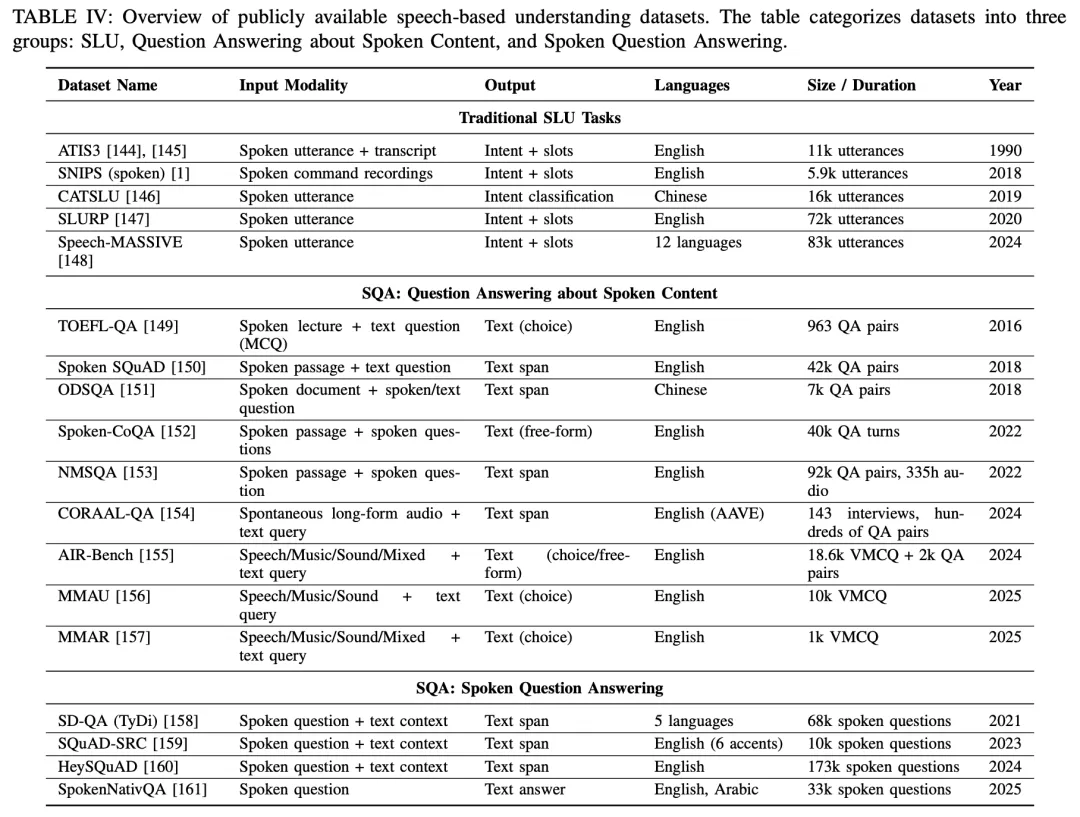
在上述架构与训练范式之上,Speech LLM 的能力边界最终仍然高度依赖于数据。沿着前文提出的功能维度,我们在综述中系统整理了当前语音理解相关的数据集:从支撑感知任务与浅层认知任务的传统语音数据(如 ASR、语音翻译、情感与意图识别),到面向更高层语义理解与推理能力的语音问答、总结与指令式数据。这些数据共同构成了当前 Speech LLM 训练与评测的主要基石。
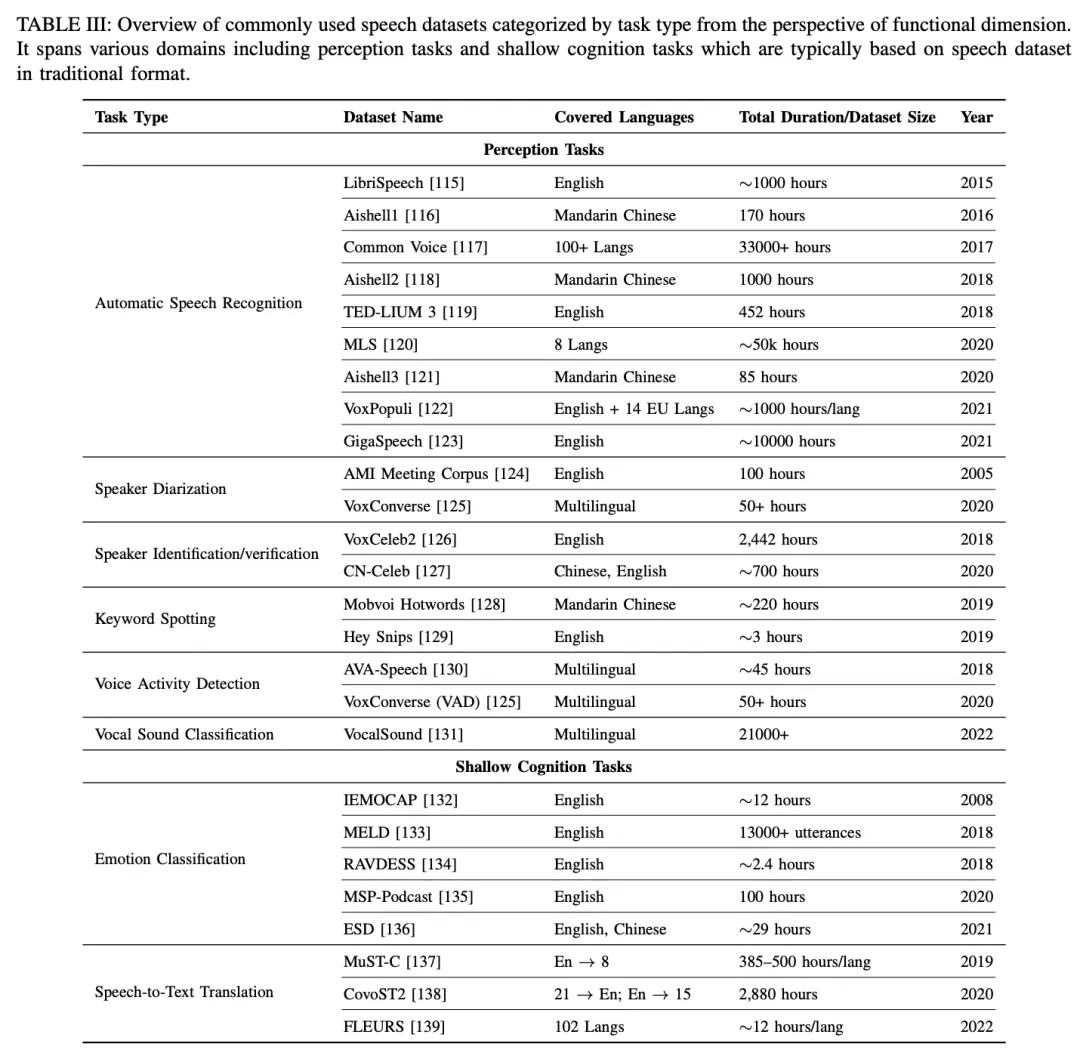
值得注意的是,在大语言模型和 TTS 技术成熟之后,数据集构建本身也正在发生变化。一方面,LLM 被引入数据生产流程,用于生成问题、答案或指令,从而降低高层语义任务的标注成本;另一方面,TTS 使得将原本的文本数据系统性地转换为语音形式成为可能,显著扩展了语音–文本对的规模与覆盖场景。这类自动化构建方式为深层语音理解任务提供了新的数据来源。但同时,这一趋势也引入了新的不确定性。自动生成数据在指令多样性、分布真实性以及评测可靠性等方面仍存在明显挑战。
语音大模型在语音理解任务上的表现
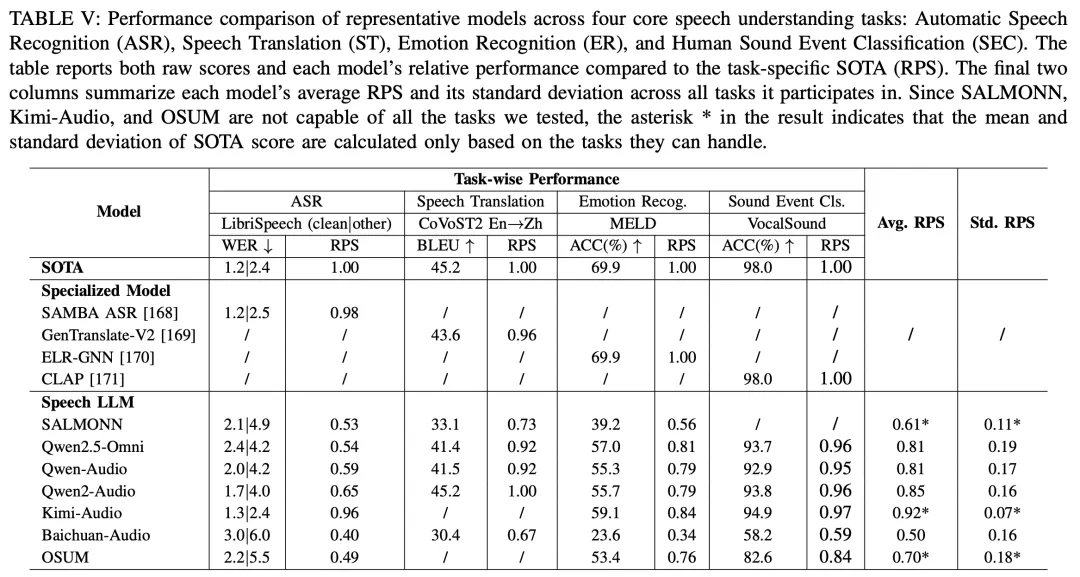
在统一的任务定义与评测框架下,我们系统比较了通用 Speech LLM 与任务专用语音模型在多类语音理解任务上的表现。综合这些实验结果,我们得到了以下结论:
整体性能已具备高度竞争力。从宏观上看,当前主流的语音大模型在多类型语音理解任务上,已经普遍展现出接近任务专用模型 SOTA 的性能水平。无论是感知类任务、浅层语义理解任务,还是部分语义相关任务,Speech LLM 已不再明显落后于为单一任务专门设计和训练的模型。
Speech LLM 已初步具备多任务能力。与传统语音系统相比,一个显著变化是:同一个语音大模型,可以在多个不同领域和形式的任务上同时维持有竞争力的表现。这表明以 LLM 为核心的建模范式,确实在系统层面推动了语音理解从“任务特化”向“任务泛化”的转变。
多任务能力仍然存在明显不均衡性。尽管具备一定的多任务潜力,不同 Speech LLM 在不同任务上的表现差异依然显著。同一模型在某些任务上接近 SOTA,但在其他任务上可能存在明显性能退化;更进一步,当任务形式或指令超出训练时的分布,一些模型几乎无法完成对应任务。这在一定程度上反映出当前 Speech LLM 的泛化能力仍然有限,尤其依赖于测试任务是否与训练任务分布保持一致。
深层语音理解任务仍然是主要短板。这一不稳定性在需要深层语义理解与推理的任务中表现得尤为明显。在涉及复杂语义建模、跨上下文推理或明确逻辑判断的任务上,现有 Speech LLM 的整体表现仍然明显不足,也未能充分继承其文本基座模型在推理能力上的优势。这表明,在当前范式下,语音输入所引入的感知与对齐复杂性,仍然对高层语义能力形成制约。
总体而言,现阶段的 Speech LLM 已经证明了其作为通用语音理解模型的可行性,并在性能上不断逼近专用系统;但与此同时,多任务稳定性不足、泛化能力受限以及深层语义理解能力偏弱等问题,也清晰地暴露出来。这些现象,正是我们在下一节中进一步讨论的核心挑战。
面向语音理解的语音大模型面临的挑战
a)挑战一:指令敏感性
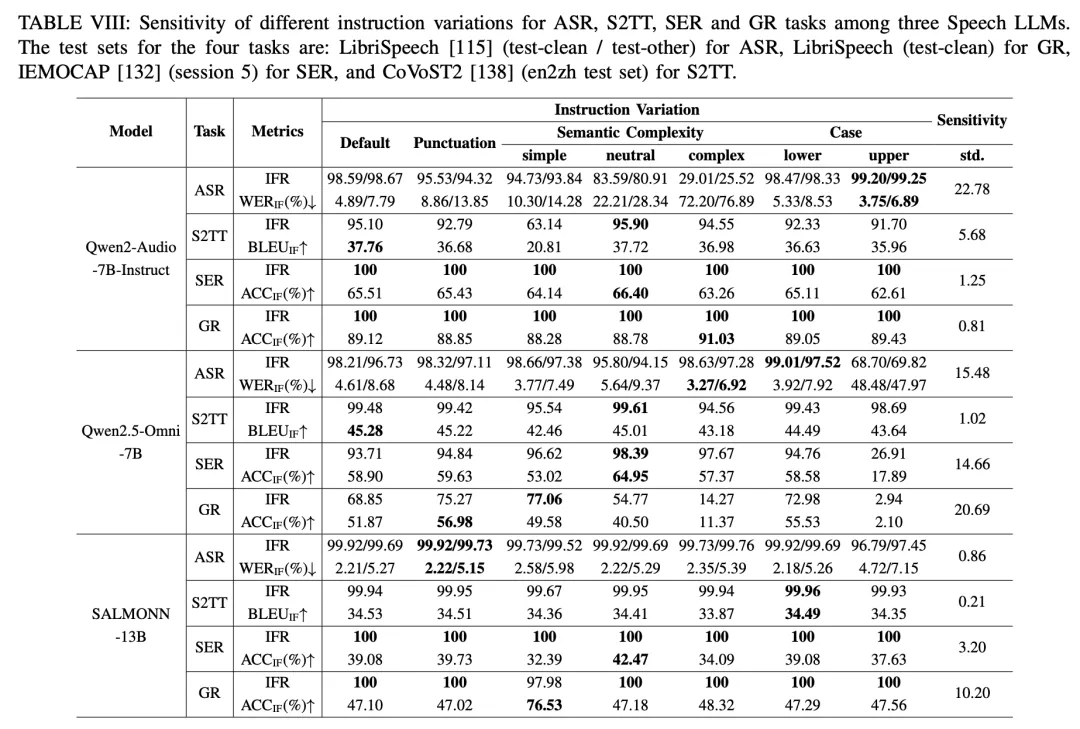
为分析语音大模型在不同设置下表现波动的原因,我们首先研究了其对指令表述变化的敏感性。在实验中,我们固定输入语音与目标任务,仅对指令的表达方式进行控制性改写,以隔离指令理解对模型行为的影响。
实验结果表明,当前 Speech LLM 在指令变化下主要呈现出两类不同的失败模式。第一类是未能完整遵循指令约束,例如在格式、输出结构或响应方式上偏离要求;第二类则是在形式上遵循了指令,但任务本身的性能出现明显下降,即模型给出了符合指令形式的输出,但语义正确性或任务指标显著退化。
综合来看,现阶段 Speech LLM 的多任务能力在很大程度上仍依赖于特定指令分布,而非对任务意图的稳健建模。当测试指令偏离训练阶段的分布时,模型的行为一致性和可靠性仍明显不足。
b)挑战二:语义推理能力
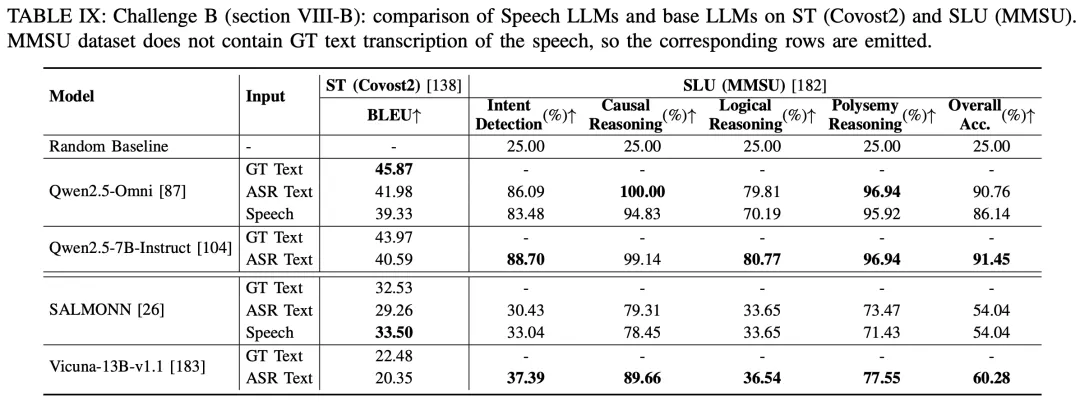
在完成上述挑战的实验论证后,我们提出了新的挑战:当前的语音大模型在语义推理能力上可能会出现“退步”。为了验证这一点,我们对语音大模型和其基座大模型设计了文本/语音双输入对比实验,对这一挑战进行论述:
输入控制:
基座 LLM:输入=由对应 Speech LLM 产生的 ASR 文本(或者标注文本) + 同一条指令;
Speech LLM:输入=原始语音 + 同一条指令。
任务与数据:
机器翻译 ST:CoVoST2(英→中),用 BLEU 评估;
语义理解 SLU:从 MMSU 中选取 433 条样本,覆盖意图识别、因果推理、 逻辑推理和多义推理四类任务,用分类准确率评估。
模型:
Qwen2.5-Omni
Qwen2.5-7B-Instruct
SALMONN
Vicuna-13B。
结果表明:在 MMSU 这类语义推理任务上,Speech LLM 的表现普遍劣于各自的文本基座 LLM;同一个Speech LLM,在输入 ASR 文本时的表现,往往略优于或接近直接输入语音,说明“语音→ASR→文本推理”的两阶段流程,并没有被端到端语音推理明显超越;这共同指向一个结论:当前范式下的多模态对齐与共享容量,会导致深层语义推理能力的下降。
总结和未来展望
本综述首次从“语音理解”的视角,为语音大语言模型领域构建了系统的三维认知框架,并全景式梳理了其从模块化系统迈向LLM中心化通用架构的技术演进。研究不仅量化评估了当前模型的性能与局限,更关键地通过实验揭示了其在指令鲁棒性与深层语义推理上的核心挑战。这标志着领域焦点需从提升感知精度,转向攻克认知层面的通用性与可靠性。
扩展工作
由于综述篇幅内容有限,我们对于文中提出的挑战在其他工作中进行了更加细致地分析和评估,并提出了相应的方法尝试解决上述问题,如有兴趣,可以参考:
ISA-Bench: Benchmarking Instruction Sensitivity for Large Audio Language Models (Authors: Bohan Li, Wenbin Huang, Yuhang Qiu, Yiwei Guo, Hankun Wang, Zhihan Li, Jing Peng, Ziyang Ma, Xie Chen, Kai Yu)
AHAMask: Reliable Task Specification for Large Audio Language Models without Instructions (Authors: Yiwei Guo, Bohan Li, Hankun Wang, Zhihan Li, Shuai Wang, Xie Chen, Kai Yu)
TASU: Text-Only Alignment for Speech Understanding (Authors: Jing Peng, Yi Yang, Xu Li, Yu Xi, Quanwei Tang, Yangui Fang, Junjie Li, Kai Yu),
