
 语音小管家
本篇将围绕趋势三,“单一任务模型将不再是主流,理解为先”,在技术和应用层面展示理解模型的重要性。我认为,在未来,语音识别的API将会几乎不存在,语音理解的API将会替代它发挥更重要的价值。
什么是音频理解?
理解一段音频,也就是如何去解释这段音频,正如自然语音理解一样,首先需要理解用户的意图,然后根据用户的意图进行响应。而音频的理解相比于文字的理解会更加的复杂,或者说音频理解实际上包含了自然语言的理解。
语言是人类发明的,是有规则的符号体系。而声音并不是人类发明的,是无规则,是自然界信息传递的比较原始的方式。人类为了更好的传递和保留信息,发明了语言,音律,用规则约束发音,传递准确的信息。
可以说,在大模型之前,“音频理解”这个方并没有被太多的提及,音频理解被拆分成很多子任务,比如语音识别,语种分类,说话人识别,音频事件检测,音频分类,情感识别等等,非常像大模型之前的自然语言处理中的各个子任务。现在再看自然语言处理,我们会发现只有一个任务,就是大模型。同样的,对于语音领域我们可以把除了生成之外的任务,统一归属到理解的范畴,而不再是单个任务进行独立建模和解决。
举个例子
测试一个模型最好的方式,不要看刷榜得分,用真实的数据测试最可靠。
使用Gemini2.5理解一段音频,看一下它的理解能力。这里我把一段真实的、发生在家庭中的对话数据直接丢给了Gemini2.5,给定提示词,让他按照我们的要求进行音频理解。使用提示词如下:
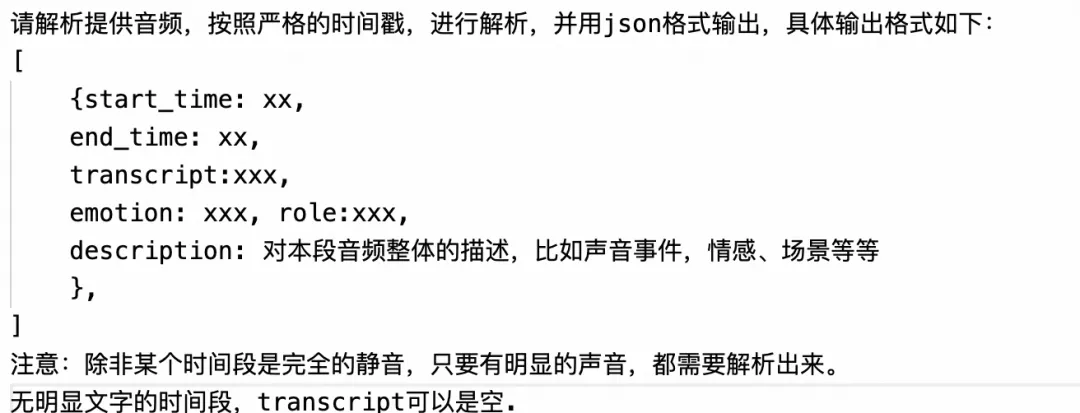
[
  {
    "start_time": "0.0",
    "end_time": "8.0",
    "transcript": "哎呦。 咋了?没有长袖。 像昨天那样怎么样?去干什么呀?",
    "emotion": "哭泣,询问",
    "role": "儿童, 成年男性",
    "description": "一个孩子在响亮而激烈地哭泣。一名成年男子试图通过询问孩子想做什么来理解原因,并提到了前一天的情况。"
  },
  {
    "start_time": "8.0",
    "end_time": "14.0",
    "transcript": "昨天要去干什么呀? 啊,你得说明白啊。",
    "emotion": "哭泣,坚持",
    "role": "儿童, 成年男性",
    "description": "孩子继续激烈地哭泣。成年男子重复他的问题,并坚持要求孩子清楚地解释他们想要什么。"
  },
  {
    "start_time": "14.0",
    "end_time": "31.0",
    "transcript": "",
    "emotion": "哭泣,哀号",
    "role": "儿童",
    "description": "音频中只有孩子响亮、持久且充满情感的哭泣和哀号声,没有可辨别的词语。"
  },
  {
    "start_time": "31.0",
    "end_time": "37.0",
    "transcript": "干嘛? 吃个小面包,喝个牛奶行吗? 可以吗?可以吗?",
    "emotion": "哭泣,建议",
    "role": "儿童, 成年男性",
    "description": "成年男子试图通过提供食物(一个小面包)和饮料(牛奶)来安抚哭泣的孩子,并反复征求同意。孩子的哭声没有减弱。"
  },
  {
    "start_time": "37.0",
    "end_time": "46.0",
    "transcript": "你就把那个外头外套给他穿上。",
    "emotion": "哭泣,建议",
    "role": "儿童, 成年女性",
    "description": "当孩子继续大声哭泣时,一名成年女性建议男性给孩子穿上外衣。"
  },
  {
    "start_time": "46.0",
    "end_time": "57.0",
    "transcript": "穿啥? 把秋衣套棉袄。 穿一套外头,穿一套短袖啊。 嗯。 要不然你那穿上,那就是这个不穿了,光穿个校服外套得了。",
    "emotion": "哭泣,讨论",
    "role": "儿童, 成年男性, 成年女性",
    "description": "孩子在背景中哭泣,而两位成年人讨论孩子应该穿什么衣服。他们讨论了不同的组合,比如在棉袄下穿长袖衬衫,或者只穿校服外套。"
  },
  {
    "start_time": "57.0",
    "end_time": "64.0",
    "transcript": "怎么了这是?",
    "emotion": "哭泣,关心",
    "role": "儿童, 成年男性",
    "description": "孩子继续激烈地哭泣和哀号。成年男子的声音听起来很关心,并再次询问出了什么问题。"
  },
  {
    "start_time": "64.0",
    "end_time": "81.0",
    "transcript": "",
    "emotion": "哭泣,哀号",
    "role": "儿童",
    "description": "孩子非常响亮且无法安抚地哭泣。背景中有成年人走动和模糊交谈的声音。"
  },
  {
    "start_time": "81.0",
    "end_time": "99.0",
    "transcript": "",
    "emotion": "哭泣,哀号",
    "role": "儿童",
    "description": "这一段充满了孩子持续且充满情感的哭泣和哀号声。"
  },
  {
    "start_time": "99.0",
    "end_time": "103.0",
    "transcript": "你看周末就是用来上课的。",
    "emotion": "哭泣,咳嗽,解释",
    "role": "儿童, 成年男性",
    "description": "孩子的哭声减弱为抽泣,并被一声咳嗽打断。成年男子发表了一句话,可能是在试图与孩子讲道理,说周末是用来上课的。"
  },
  {
    "start_time": "103.0",
    "end_time": "113.0",
    "transcript": "周末就用来上周末,就用来玩的。 周末也在学校玩呀,其实。",
    "emotion": "哭泣,讨论",
    "role": "儿童, 成年男性, 成年女性",
    "description": "孩子继续哭泣,而成年人在交谈。男性说周末是用来玩的,女性补充说周末也可以在学校玩。"
  },
  {
    "start_time": "113.0",
    "end_time": "120.0",
    "transcript": "对呀。 学校里有蹦蹦床,有滑滑梯。",
    "emotion": "哭泣,说服",
    "role": "儿童, 成年男性",
    "description": "在孩子的哭声中,成年男子同意女性的说法,并试图通过提到学校的蹦床和滑梯来吸引孩子。"
  },
  {
    "start_time": "120.0",
    "end_time": "131.0",
    "transcript": "你要不要带着你的小车?我看那个刘世达今天带着他的小车。",
    "emotion": "哭泣,建议",
    "role": "儿童, 成年男性",
    "description": "孩子仍在哭泣。男性建议孩子带上他的玩具车,并提到另一个孩子(刘世达)也带了他的。"
  },
  {
    "start_time": "131.0",
    "end_time": "136.0",
    "transcript": "要不我们带着高铁去。",
    "emotion": "哭泣,建议",
    "role": "儿童, 成年女性",
    "description": "孩子的哭声仍在继续。成年女性建议带一个玩具高铁。"
  },
  {
    "start_time": "136.0",
    "end_time": "155.0",
    "transcript": "行吗? 拿着。",
    "emotion": "哭泣,咳嗽",
    "role": "儿童, 成年男性",
    "description": "孩子继续哭泣和咳嗽。有走动的声音,一个男性的声音说“行吗?”和“拿着”。"
  },
  {
    "start_time": "155.0",
    "end_time": "165.0",
    "transcript": "快点儿吧,宝宝来。",
    "emotion": "哭泣",
    "role": "儿童, 成年男性",
    "description": "一个男性的声音催促孩子快一点(“快点儿吧,宝宝来”)。声音听起来像是孩子被抱了起来,哭声变得更大了。"
  },
  {
    "start_time": "165.0",
    "end_time": "177.0",
    "transcript": "",
    "emotion": "哭泣,哀号",
    "role": "儿童",
    "description": "孩子大声地哭泣和哀号,表达了极大的痛苦。"
  },
  {
    "start_time": "177.0",
    "end_time": "188.0",
    "transcript": "妈妈给你发现一个情绪哦,发现了没有,咱俩谈一谈好不好? 你说你不是说好了今天爸爸妈妈要去上班呀,谁陪你玩呀?",
    "emotion": "哭泣,讲道理",
    "role": "儿童, 成年女性",
    "description": "一名成年女性承认孩子的情绪(“妈妈发现你有一种情绪”),并试图开始对话与他讲道理。她提醒孩子父母要去上班。孩子仍在哭泣。"
  },
  {
    "start_time": "188.0",
    "end_time": "196.0",
    "transcript": "咱都有安排的,那妈妈不是说好了,我要不去上班了。",
    "emotion": "哭泣,沮丧",
    "role": "儿童, 成年女性",
    "description": "女性的声音听起来有些沮丧,她告诉哭泣的孩子他们有计划,她不能不去上班。"
  },
  {
    "start_time": "196.0",
    "end_time": "202.0",
    "transcript": "不要上学。",
    "emotion": "哭泣,抗议",
    "role": "儿童",
    "description": "孩子的哭声仍在继续,在泪水中,他清楚地表达了他的抗议:“不要上学。”"
  },
  {
    "start_time": "202.0",
    "end_time": "210.0",
    "transcript": "你看老师,你看妈妈,他想你了。",
    "emotion": "哭泣,安抚",
    "role": "儿童, 成年女性",
    "description": "当孩子哭泣时,女性试图通过说老师想他了来安抚他。"
  },
  {
    "start_time": "210.0",
    "end_time": "231.0",
    "transcript": "",
    "emotion": "哭泣,哀号",
    "role": "儿童",
    "description": "音频中充满了孩子激烈而充满情感的哭泣和哀号声。"
  },
  {
    "start_time": "231.0",
    "end_time": "246.0",
    "transcript": "",
    "emotion": "哭泣,抽泣",
    "role": "儿童",
    "description": "孩子激烈的哭声逐渐平息,在音频结束时变成了轻柔的啜泣和抽泣。"
  }
]
解决理解问题的不是架构
和很多人交流过程中,发现了一个误区,尤其是对语音技术不了解的朋友,他们认为端到端语音对话模型天然的可以解决语音理解的问题。之所以会有这样的理解,是因为直觉上将原始语音输入到模型,模型“理论上”可以获得语音数据中所有的信息,不经过的文本级联和信息丢失,副语言信息可以很好的保留。
其实并不是这样的,在之前介绍语音端到端对话系统的文章[原文]中就提到,如果任务设计的不合理,数据中大量的信息仍然会被丢弃。比如,情感任务,说话人任务,语种和口音区分能力。在数据➕任务驱动的模型中,训练目标的设计,至关重要。另外,理解和生成如何纳入到一个框架中,用生成辅助理解,用理解细化生成,也是一个比较有意思的话题。
因此,解决理解问题的核心,是数据,任务设计和基础模型能力。
语音识别API的价值在将来将会降低,取而代之的是理解
可以看到,现在有很多语音交互类的应用,都在采用语音识别+大模型+语音合成的级联方式。目前各大厂商提供的语音识别接口,基本都是提供转录的文字。如果放在前几年,这样的系统没有任何问题,各种助手类的产品,基本都采用这种模式。
但是随着技术进步,无论是交互类还是记录类,用户对产品体验的要求,对智能的认知,都在不停的提高。特别是去年开始兴起的一些陪伴类的应用,经过一阵兴奋之后,终归冷静。过高的估计了技术的成熟度,特别是在情绪共鸣上,带有语音对话的AI的活人感几乎是零,一个很重要的方面就是现有的技术框架缺少对场景,对声音的精细化理解。
交互系统中,将语音识别模块换成音频理解模块,比如Gemini2.5的音频理解模块,详细描述出用户语音中的感情,音频场景,可能的声音事件,和仅仅使用转录的文字作为大模型的输入,大模型的反馈会更全面,也更有情绪价值。
总结
随着基础模型能力的不断提升,单纯的语音识别将无法满足未来的需求,音频理解能力的有限度,甚至要比端到端语音对话的更高,更有广泛的应用场景。特别是用户对情绪价值、产品体验要求越来越重视的未来。无论是学术界还是企业界,应该将更多的资源倾向在理解上,甚至更极端的说,任何有能力做语音基础服务的公司,都应该将音频理解放到优先级最高的位置,它是数据的储备,基础模型的升级,更是将来交互的必须。Gemini已经验证了其可行性,其商业价值也会越来越高。
