标题:Joint Speech and Text Training for LLM-Based End-to-End Spoken Dialogue State Tracking
地址:https://arxiv.org/pdf/2511.22503
作者单位:捷克布尔诺理工大学 Speech@FIT 实验室
发表日期:2025 年 11 月 27 日
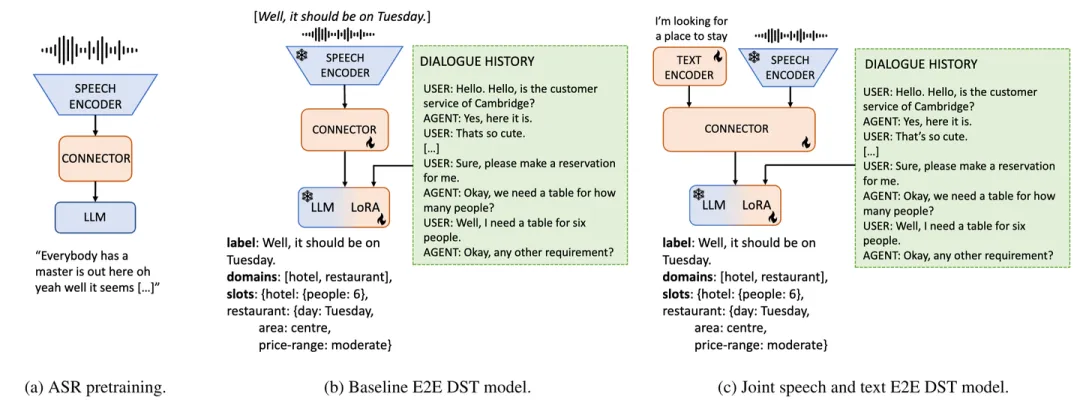
这篇论文主要解决的是“口语对话里提取关键信息(比如订火车票的日期、目的地)”这个难题,尤其聚焦在“不同领域(比如从订火车跨到订酒店)怎么不用重新收集大量口语数据也能做好”的问题。端到端的口语对话状态跟踪(DST)不好做,主要卡两个点:一是得处理语音输入,二是训练数据太少。之前有人想了个招——把语音基础编码器和大语言模型(LLM)结合,虽然在多轮口语DST里拿到了SOTA(最先进)结果,但有个大毛病:跨领域能力差,而且每个领域都得有标注好的口语DST数据(比如想做“订酒店”的DST,就得专门收集订酒店的口语对话),这数据收集又贵又麻烦。作者发现:文本DST数据(比如纯文字的订酒店对话)其实很好拿,所以提出了个新思路——把现有的口语DST数据和其他领域的文本DST数据放一起联合训练。实验证明这招管用:就算没有目标领域的口语数据,也能让模型在跨领域DST上表现不错。先搞懂一个基础概念:任务导向对话(ToD)系统——就是帮用户完成具体目标的对话机器人,比如订餐厅、查景点、订火车票。这类系统的核心模块是DST,简单说就是从杂乱的对话里抠出“结构化信息”:比如用户说“周日下午1点45分之后出发的火车”,DST要提取出“领域:火车”“槽位:日期=周日,出发时间=13:45”。之前做口语DST,都是“ASR(语音转文字)→纠错→文本DST”这么串起来用(叫“级联方式”),但这方法问题多:系统复杂、前面ASR出错会一直传到后面(比如把“13:45”转成“13:54”,后面DST也跟着错)、还会丢语音里的细节(比如用户说“13:45”时的强调语气可能暗示重要性)。后来有了端到端(E2E)方法:直接从语音预测DST,避开了级联的坑,但新问题来了——训练数据不够!收集大量口语DST数据又费钱又费人力。之前有个baseline方法(论文[7])挺好:用一个“连接器”把预训练语音编码器和LLM连起来,再加上LoRA层(一种轻量微调LLM的技术),能直接输出JSON格式的DST结果,在SpokenWOZ(一个口语DST数据集)上效果很好。但它有个硬伤:跨领域不行——比如在“订火车”领域训练的模型,放到“订酒店”领域,连“酒店名”“地址”这些槽位值都提不出来。作者琢磨:既然文本DST数据好拿,而且之前有人用文本数据做“槽位增强”(比如给文本对话加更多槽位例子)能提升DST效果,但语音没法直接这么搞,那不如把口语数据和文本数据放一起训练?这就有了这篇论文的核心思路。先明确baseline模型的结构:预训练语音编码器(比如WavLM)→连接器→LLM(比如Gemma-3-1B-it)。输入是“当前用户的语音”+“对话历史(转成文字的,比如之前用户和机器人的对话)”,语音先过编码器和连接器得到embedding,再贴在“对话历史的LLM embedding”前面,最后输出JSON——里面包含ASR转的文字和提取好的领域、槽位。3.1 核心创新:加个“文本编码器”,实现语音-文本联合训练作者给baseline加了个文本编码器:输入是“当前用户的文本”(比如纯文字的“我要订周日的火车”),输出也过连接器,再和对话历史一起进LLM预测DST。这里有个关键设计:文本编码器只用来辅助训练,推理的时候可以删掉——也就是说,实际用模型的时候,还是只输入语音,不会增加额外的计算成本,很实用!先把LLM冻住(不更新参数),用ASR任务(让模型学“把语音转文字”)预训练语音编码器和连接器,损失函数用交叉熵。用的数据集是Fisher、Librispeech这些通用语音数据集,保证语音编码能力够强。加上文本编码器,给LLM插LoRA层,然后冻住语音编码器和基础LLM,只微调“连接器+文本编码器+LoRA层”。训练时每次喂两个batch:一个语音batch、一个文本batch,要最小化三个交叉熵损失:- 用语音batch转的文字做DST的损失(相当于用ASR结果再练一遍文本DST)。
实验做得很细,重点验证“跨领域”和“不同文本数据、不同LLM”的效果,下面分点说清楚。- SpokenWOZ(简称SW):口语DST数据集,预处理时删了9个损坏的对话,用Whisper-large-v3重新转了文字;
- Speech-aware MultiWOZ(简称MW):另一个口语DST数据集,坑点在于“训练集在剑桥,验证/测试集在纽约”——所以文本训练可能只提升“槽位键”(比如“酒店名”这个键),但提升不了“槽位值”(比如纽约的酒店名,训练集里没有);
- DialogStudio(简称DS):额外的文本数据集,用来模拟“有非目标领域文本”的场景(比如想训“订酒店”,但DS里混了其他对话)。
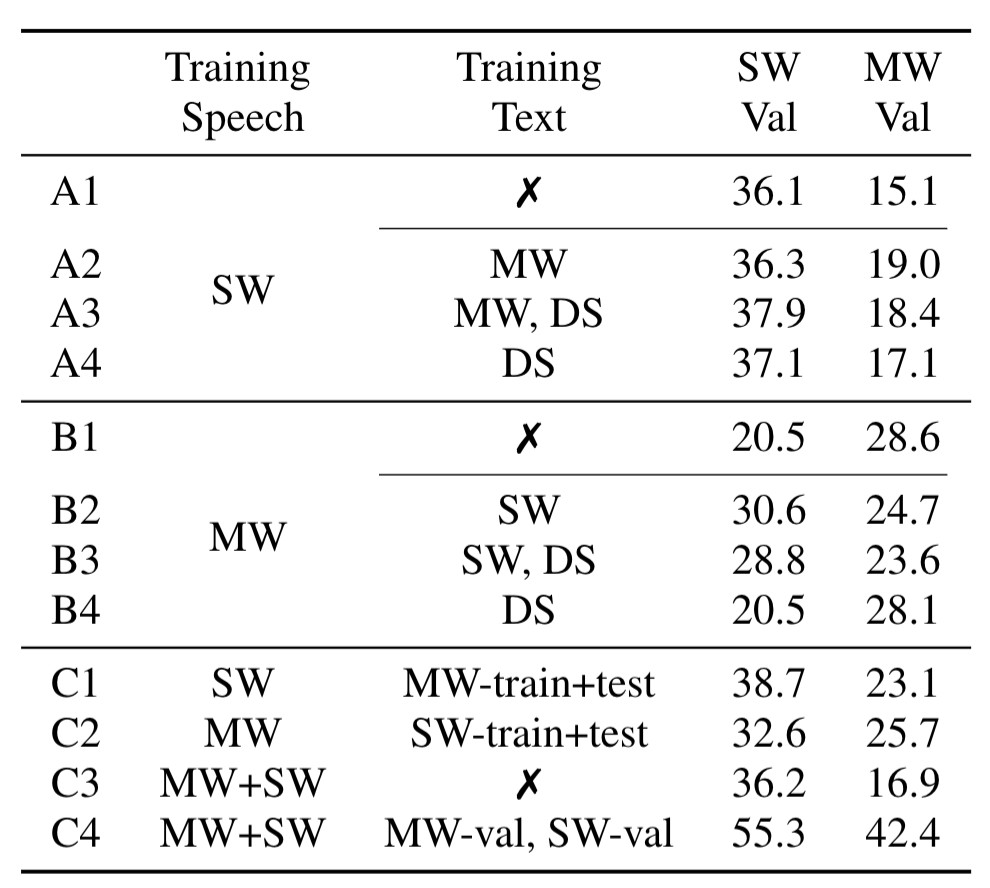
ASR预训练数据:Fisher、Librispeech、CommonVoice v17、VoxPopuli(都是通用语音数据,保证基础能力)。指标:联合目标准确率(JGA)——衡量DST提取的“领域+所有槽位”全对的比例,是DST的核心指标。还会用“模糊匹配”(按编辑距离找最接近的槽位,比如把“13:54”匹配到“13:45”)减少小误差影响。模型架构细节:语音编码器用WavLM;LLM主要测Gemma-3-1B-it,还对比了Gemma-3-4B-it、Gemma-3-12B-it(更大的LLM)和OLMo-1B(另一个LLM,用来和之前的研究对比);连接器是4层Transformer(隐藏层1024,4个注意力头),前面加两个卷积层(步长3和2);文本编码器和连接器的Transformer结构一样,用和LLM相同的tokenizer。超参:ASR预训练用AdamW,100k步,学习率前1000步热身到2e-4,之后线性降到峰值的1%;微调时LoRA的rank和alpha都是32,AdamW,学习率前1000步热身到5e-5,最多60k步,用验证集JGA早停(通常10k步就够了)。实验1:不同文本数据源,对跨领域效果有啥影响?(表1)这个实验想搞清楚:用不同的文本数据训练,模型在目标领域的表现会不会变?比如用SW的语音+不同文本,看MW验证集的JGA;用MW的语音+不同文本,看SW验证集的JGA。- A1(没文本)vs A2(SW语音+MW文本):MW验证集JGA从15.1%升到19.0%,和“用MW语音训练”的差距缩小了28.9%——说明加目标领域文本真有用;
- B1(没文本)vs B2(MW语音+SW文本):SW验证集JGA从20.5%升到30.6%,差距缩小64.7%——效果更明显;
- A2(只MW文本)vs A3(MW+DS文本):A3的MW验证集JGA是18.4%,比A2稍差,但比A1好——说明就算混了非目标文本,也比没文本强;
- A4(只用DS文本):MW验证集有提升,但SW没有——因为DS里有MW的数据,没有SW的数据,进一步证明“文本得和目标领域相关才有用”;
- Topline实验(C1-C4):C1是SW语音+MW的训练+测试文本,MW验证集JGA提升21.6%(因为MW测试/验证集城市一样,槽位值重叠);C4是用两个数据集的语音+两个的验证集文本,效果远超只用两个语音的C3——说明理想情况下,这方法潜力很大。
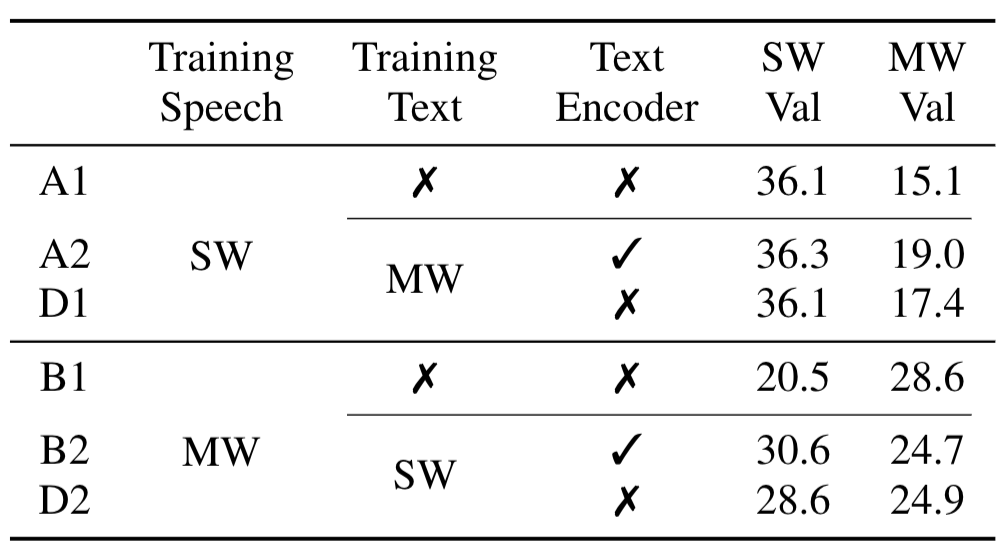
这个实验对比“有没有文本编码器”的效果,想知道提升是来自“让LLM见更多DST例子”,还是“文本编码器帮语音pipeline变强了”。- D1(没文本编码器,只用LoRA微调文本)vs A2(有编码器):D1的MW验证集JGA比A2差,但比A1(没文本)好;
- 同理,D2比B2差,但比B1好——说明提升分两部分:一部分是LLM见了更多目标领域DST例子,另一部分是文本编码器帮语音pipeline提升了提取DST的能力,两者结合效果才最好。
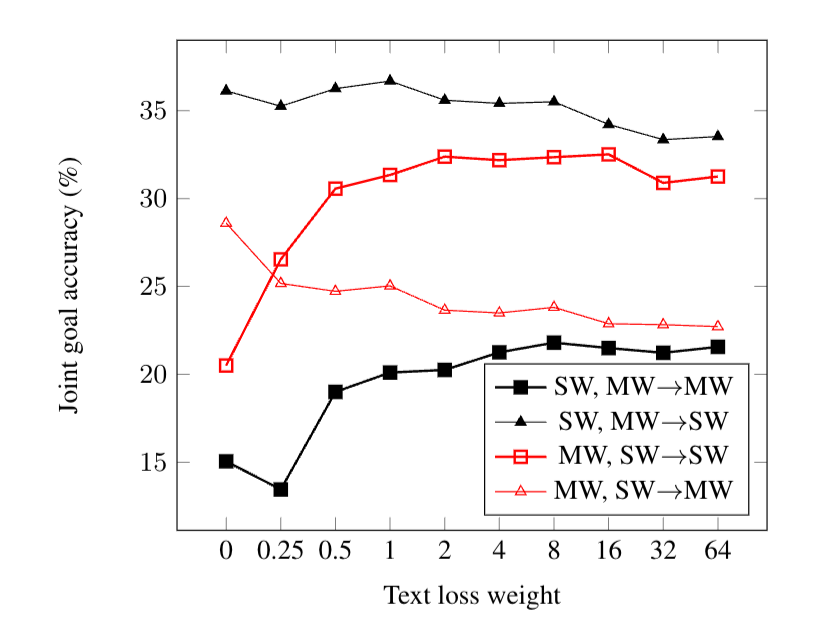
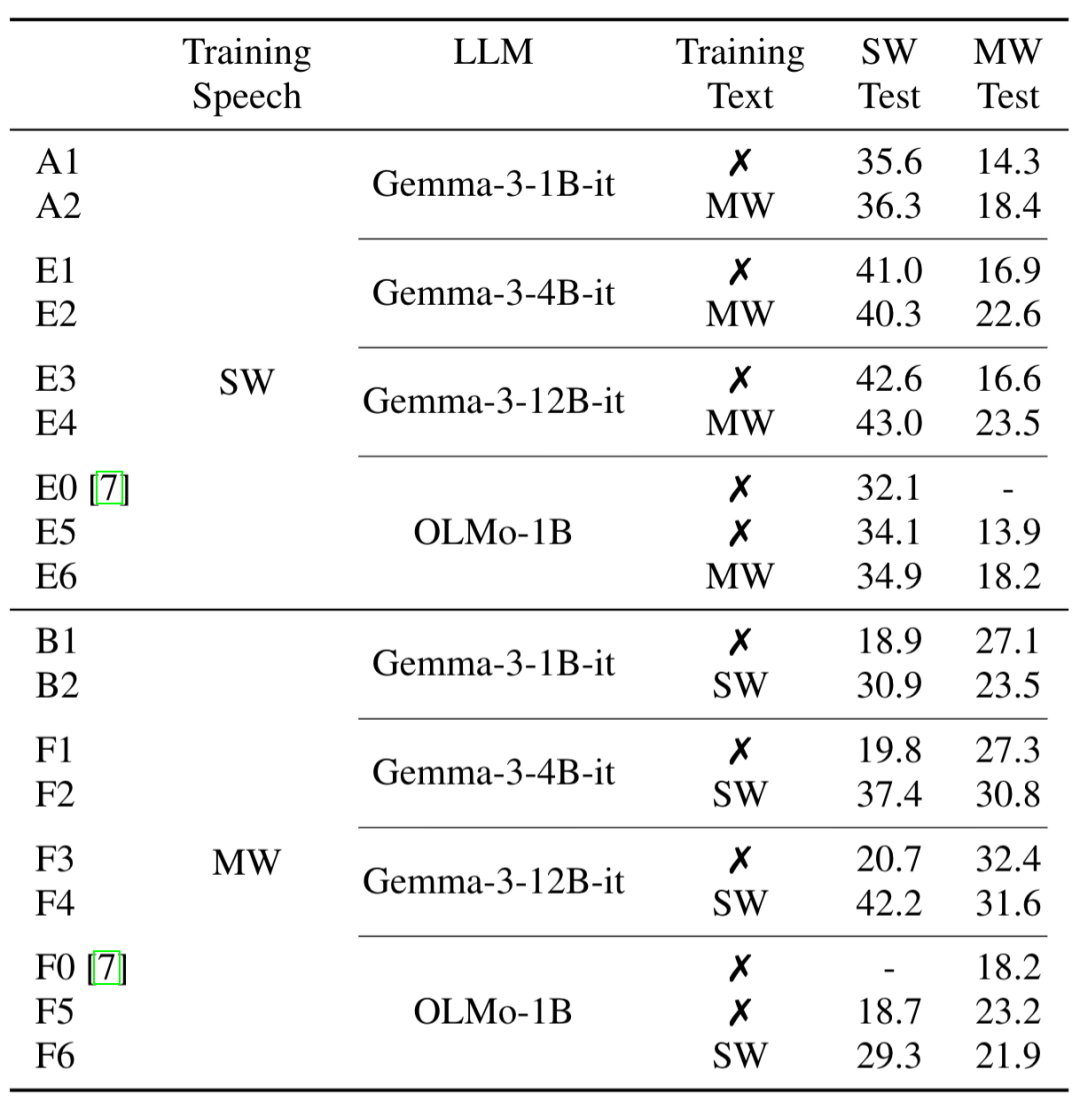
默认文本损失权重是0.5,实验看权重变了对效果的影响。核心发现:增加文本损失权重,目标领域JGA会提升,但源领域会降——比如SW作为源领域时,降得比较轻;MW作为源领域时,降得明显。这意味着可以通过调权重,在“源领域性能”和“目标领域性能”之间做权衡,很灵活。这是最终的测试集结果,还对比了不同大小的LLM,看方法的通用性。- OLMo-1B的效果:作者的基线比之前[7]的好(因为ASR预训练数据更多);联合训练后,E6(SW语音+MW文本)的MW测试集JGA从13.9%升到18.2%,差距缩小46%;F6(MW语音+SW文本)的SW测试集JGA从18.7%升到29.3%,差距缩小79%——证明方法在不同LLM上都管用。
- Gemma-3-12B-it(最大的LLM)的F4(MW语音+SW文本),SW测试集JGA和“用SW语音训练”的E3几乎一样——跨领域效果快赶上直接用目标领域语音了;
- MW那边,小模型(Gemma-1B-it)加SW文本会降效,但大模型(12B-it)要么降得少,要么不降——说明大模型的泛化能力更强,能更好地利用文本数据。
- 槽位键vs槽位值的提升:分析Gemma-1B-it的输出,联合训练让MW的“餐厅名”“酒店名”“景点名”槽位键召回率提升41.5%、31.8%、35.9%,但槽位值只升5.4%、2.6%、19.2%;而SW的槽位值召回率升了36.0%、41.7%、58%——因为SW的训练/测试集城市一样,槽位值重叠,MW不一样,这也解释了MW槽位值提升少的原因。
作者提出的“语音+文本联合训练”方法,解决了口语DST的两个大问题:- 跨领域不用目标领域口语数据:只要有目标领域的文本数据,哪怕混了无关文本,也能让模型在该领域做好口语DST;
- 实用不增加成本:文本编码器只在训练时用,推理时删掉,不额外耗资源;
- 通用性强:不同LLM(Gemma系列、OLMo)都能用,而且LLM越大,提升越明显。
未来还能往这方向挖:比如把文本DST里的“paraphrasing(改写句子)”“槽位增强”这些方法加进来——之前这些方法没法直接用在语音上,现在有了文本编码器,就能通过联合训练让语音DST也受益。
 语音小管家