
 语音小管家
预印版论文标题:
QuarkAudio Technical Report(https://arxiv.org/pdf/2512.20151)
UniTok-Audio:A Unified Audio Generation Framework via Generative Modeling on Discrete Codec Tokens(https://arxiv.org/abs/2510.26372)
开源社区信息:
HugingFace:https://huggingface.co/QuarkAudio
⏩研究背景:为什么需要“统一”的音频编辑与生成?
1、项目背景
在人工智能(AI)快速演进的背景下,音频音效大模型正成为研究与应用的前沿方向,生成式AI在音频生成、音频修复、音频编辑、沉浸式媒体内容创作等方面展现出巨大潜力。然而,当前主流的基于大模型的音频处理模型仍面临一系列关键挑战:
困境一:任务割裂,系统复杂度高
音频理解(如识别、分类)与音频生成/处理任务常采用独立框架,缺乏统一表征,制约模型泛化能力,更严重的是,这些模型之间缺乏协同优化机制,难以实现整体性能最优。此外,语音和一般音频编辑任务差异较大,在一个框架内融合两类任务具有挑战性。
困境二:表征不一致,语义与声学脱节
音频理解类任务(如语音识别)偏好连续特征(梅尔谱、预训练模型表征),生成类任务(如语音合成)则大多依赖离散token(SoundStream、Encodec)。
困境三:模型泛化性差,扩展成本高
生成音频失真:离散编码恢复语音波形受现有音频离散编解码器(Codec)性能限制,容易导致声学细节丢失,影响音效的真实感、连续性与可控性;
建模复杂:音效具有高度多样性与上下文敏感性(如混响、动态包络、非稳态噪声),难以构建通用高保真模型;
可延展性差:现有方法要么是单任务架构(无法在其他任务复用),要么是多阶段流程(例如先生成文本再生成语音)。一旦新增任务,往往需要重新设计网络结构或训练流程。
困境四:指令级编辑性能差
现有方法难实现细粒度、可微分且语义一致的音频编辑,限制了精准控制能力。
✅理想蓝图:All-in-One 的通用音频模型
目标是希望构建一个像人类一样灵活的“全能音频助手”,它能根据指令完成多种操作:
“帮我把这段录音里的主讲人声音提出来。”
“把这个男声换成女声。”
“去掉背景音乐,保留人声。”
“这句话说错了,改成‘明天见’。”
为突破瓶颈,业界正推动从“任务专用模型”向“多能力统一模型”的范式转变,目标是构建具备强大上下文理解能力的通用音频大模型,在单一框架内同时兼顾理解、生成与编辑等多种能力。在这一方向上,一个关键思路是探索融合连续与离散表征的端到端架构,建立共享的潜在表示空间,并在该统一空间中实现音频增强、音频分离、音效理解、自由生成与精细化编辑(如风格迁移、属性调节、局部替换)等任务的协同建模与联合优化。
2、项目亮点概述
QuarkAudio是一个新颖的音频处理与生成大模型框架,它包含音频表征离散化以及基于离散表征的音频修复、音频编辑和音频生成。其核心是语义和声学表征解耦的离散音频编解码器以及统一多种任务的音频大模型范式。
创新一:H-Codec——兼顾语义与声学的双流音频编解码器
🔥解耦的语义-声学令牌器架构:
语义分支:基于HuBERT/WavLM这类自监督学习模型构建,它们利用 Transformer 提取上下文丰富的高层语义信息,增强音频理解能力;
声学分支:采用卷积编码器结合Transformer以及LSTM捕捉波形细节,保留高保真局部声学特征。
两路特征独立量化、并行传输,在重建时融合,实现“听得懂”与“说得好”的统一。
🔥支持多域音频重建+工业级大规模训练体系
支持对语音、音乐、环境音等不同类型音频进行高质量重建,突破大多数Codec 仅聚焦语音的局限。
训练数据规模巨大,语音训练数据量达到500万小时,音乐训练数据量达到80万小时,一般音频训练数据量达到20万小时。在极端信噪比、远场、多说话人等复杂条件下仍保持鲁棒性能。
🔥固定多帧率/动态帧率+多种采样率支持
多个版本支持不同固定帧率输出:6.25Hz、12.5Hz、25Hz,可适配不同任务需求(如语音识别偏好低帧率,语音合成偏好中高帧率);
支持动态帧率机制:根据语音内容复杂度自适应调整token的时间分辨率,达到效率与质量的平衡;
实现从“连续表征”到“离散 token 序列”的可控转换,为下游 LLM 提供灵活输入接口。
不同版本支持16kHz 到 48kHz 不同采样率音频的高质量重建。
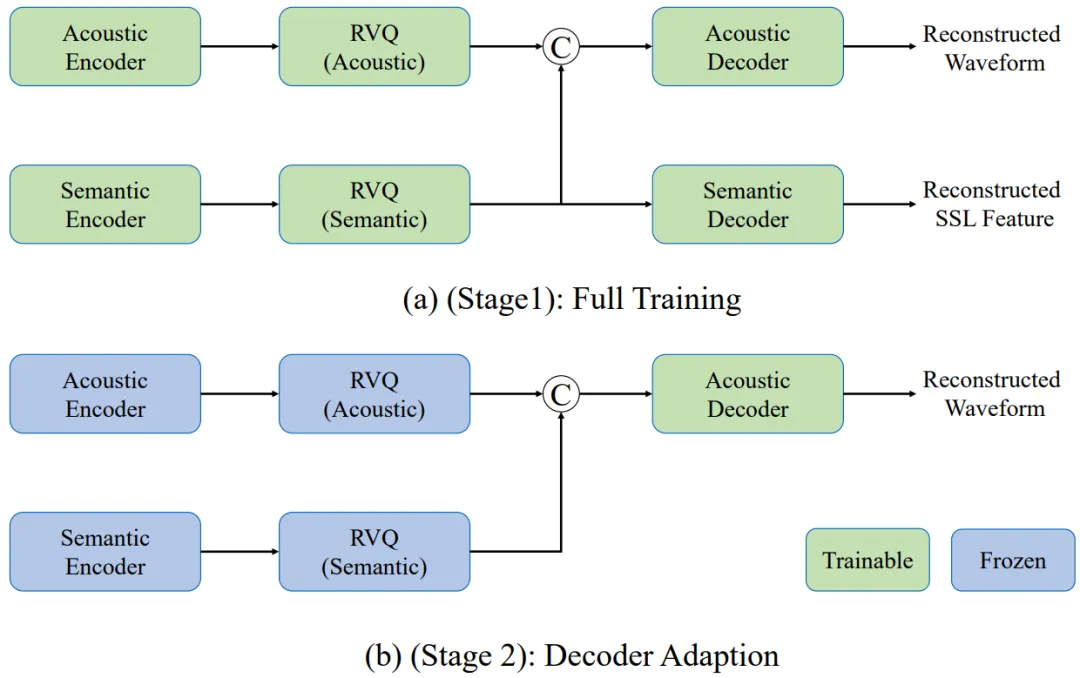
🔥多阶段训练策略
逐步弥合“低码率压缩”与“高音频质量”之间的差距
第一阶段同时训练编码器和解码器,快速收敛基础表示;
第二阶段冻结编码器并微调解码器,进一步提升收敛效果。
创新二:任务即提示(Task-as-Prompt)——统一多任务学习范式
🔥端到端,多任务架构:
以语言模型为引擎,以连续表征和离散音频token为媒介,统一所有时间对齐型(输入和输出间具有严格的时间对应关系)音频任务,包含语音修复(SR)、目标说话人提取(TSE)、语音分离(SS)、音色转换(VC)、基于文本引导的音源分离(LASS)。
通过“前缀条件”任意指定任务类型,定义任务标识符(Task Token)为每种任务分配一个专属token,构造条件序列,将任务token 与条件嵌入拼接作为前缀输入。
🔥自回归生成目标音频token:
模型以decoder-only 架构运行,逐步预测 H-Codec 的多层离散 token,最后由 H-Codec Decoder 重建波形。这一机制实现了真正的“单模型、多任务、共享权重”,无需任何任务特定参数适配。
🔥延迟预测模式(Delay Pattern)——高效生成多层 token:
引入delay pattern(源自MusicGen):不同层级设置不同偏移量,低层 token 提前生成,引导高层预测,实现多层 token 并行生成。
创新三:自然语言指令编辑——兼顾语音和音频的编辑任务
🔥自然语言引导的通用编辑
无需手动标记编辑区域,无需提供时间戳,只需输入编辑任务指令即可精准完成。
语音语义编辑:支持基于自然语言指令对语义文本的删除、插入、替换等操作。
声音事件编辑:支持基于自然语言指令对音频进行声音事件的添加、删除等。
⏩研究方法:统一音频编辑与生成大模型
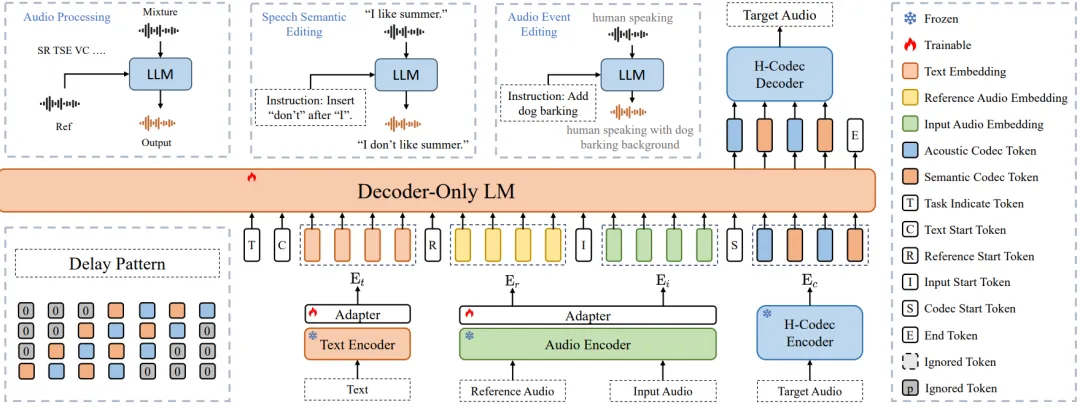
图1 QuarkAudio 整体框架
为实现高质量、低延迟、强泛化的音频编辑与生成能力,QuarkAudio采用端到端的Encoer-LLM-Decoer 框架,整体架构如图1所示,主要由三大模块组成:
条件编码器:包含文本编码器和音频编码器,支持文本、音频等多种提示输入;
H-Codec:双流离散编解码器(语义流+声学流),负责从预测的token恢复出高质量音频;
Decoder-Only语言模型:建模上下文信息,采用自回归学习范式预测H-Codec的多码本token;
1、H-Codec方案
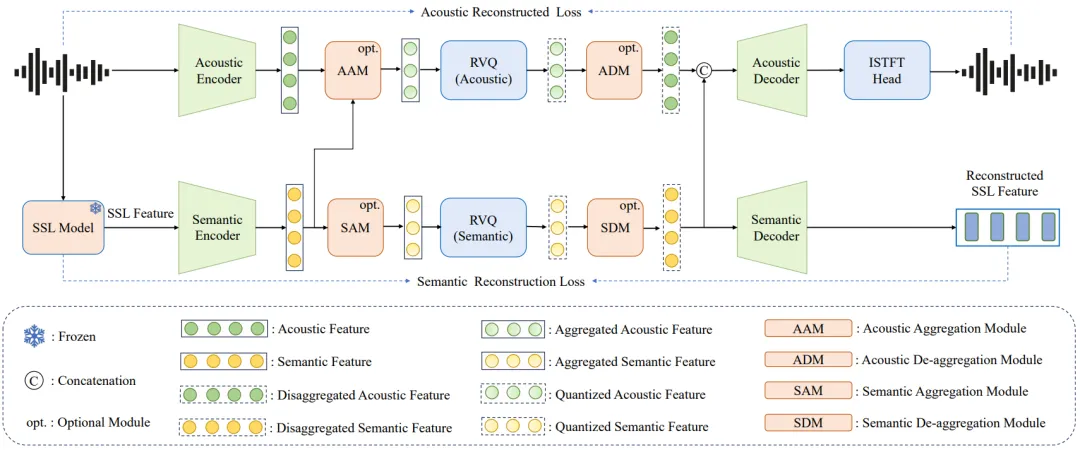
图2 H-Codec 结构
H-Codec结构如图2所示,包含两个分支:声学分支和语义分支。声学分支由声学编码器进行编码,语义分支先由预训练的自监督学习(SSL)模型提取表征,然后再经过语义编码器进行编码。两个分支的特征经过可选的特征聚合模块进行帧率压缩,再分别进行残差矢量量化,获得量化后特征。量化后特征经过可选的解聚合模块后进行拼接,然后由声学解码器重建模型。同时使用语义解码器从量化后的语义特征中恢复SSL特征作为辅助损失,保证语义分支的语义丰富性。
设计了多个版本Codec方案,灵活支持多样的下游任务:
H-Codec-1.0:
训练信息:支持16kHz采样率语音、音乐、一般音频的重建,总训练数据量250万小时;
帧率:声学分支25Hz, 语音分支25Hz,固定帧率;
RVQ数:声学分支4层, 语音分支4层;
支持wavlm或hubert,分别面向语音任务和一般音频任务;
版本参数量:Small版本146M、Large版本1.2B。
HCodec-1.5:
训练信息:支持16kHz采样率语音、一般音频、音乐的重建,总训练数据量20万小时;
帧率:动态帧率机制(参考FlexiCodec),自适应 3.125~25 Hz 帧率, 通过计算相邻帧的语义向量相似度,将语义接近的多个连续帧合并成单一帧,完成从固定帧率到动态帧率的转换;
RVQ数:声学分支4层, 语音分支4层;
版本参数量:678M。
HCodec-2.0:
训练信息:支持48kHz采样率语音、一般音频、音乐的重建,总训练数据量500万小时;
帧率:包含6.25和12.5Hz固定帧率版本;
RVQ数:声学分支16层, 语义分支16层;
版本参数量:Small版本236M、Large版本1.2B。
实验结果:
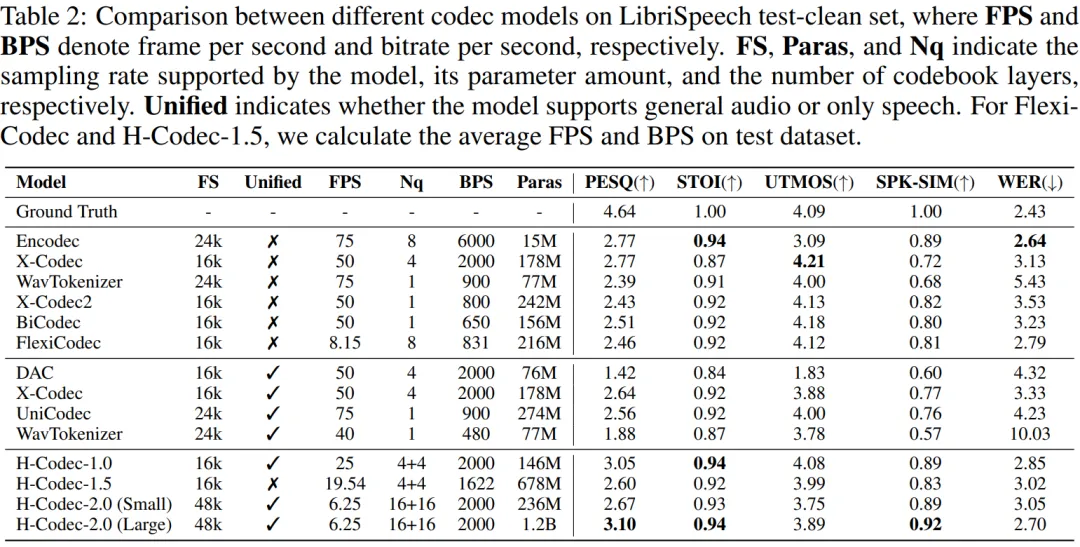
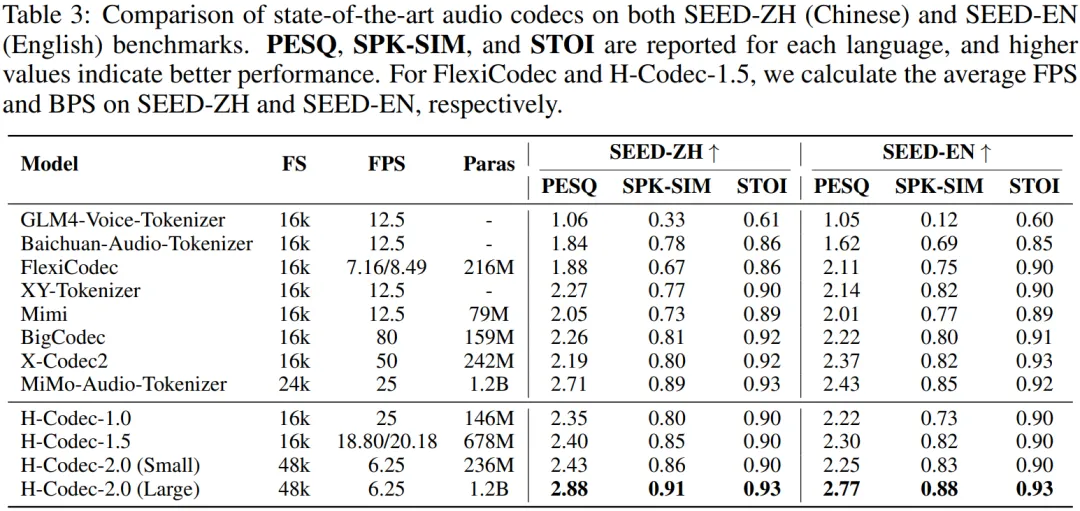
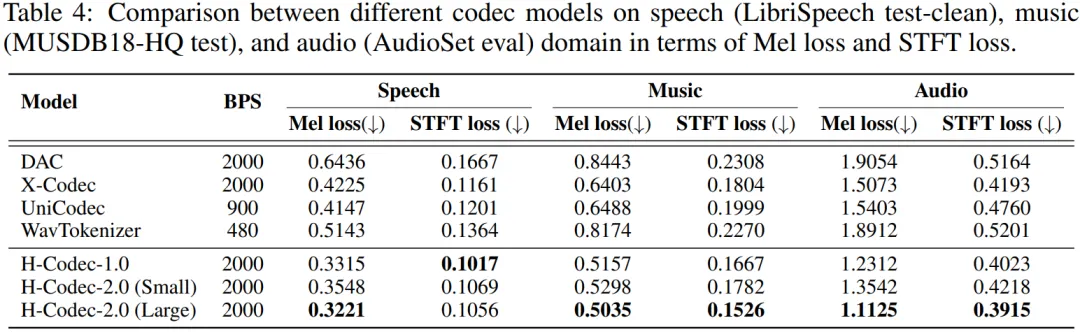
与现有编解码器的对比:H-Codec在多种比特率下均展现出较好的音频重建质量。即使在较低帧率下,H-Codec也与高帧率系统相比具有竞争力。
LibriSpeech test-clean 评测集
SeedTTS评测集
语音、音乐和一般音频统一测试
多阶段训练策略逐步优化性能,逐步弥合“低码率压缩”与“高音频质量”之间的差距
第一阶段同时训练编码器和解码器,快速收敛基础表示;
第二阶段冻结编码器并微调解码器,进一步提升收敛效果。
2、QuarkAudio架构
🔥连续条件嵌入
文本条件:T5-base 提取文本嵌入,经线性适配器映射到 LM 隐空间。
音频条件:共用HuBERT 提取连续特征,经另一适配器映射,保留细粒度声学与语义信息,提升跨任务泛化。
🔥统一多任务建模
引入任务标识符token(SR、TSE、rTSE、VC、LASS),把不同任务的输入条件统一为同一套序列前缀,不同任务共享权重,无需任务特定参数。
🔥离散表示预测
采用decoder-only自回归语言模型(LLaMA结构),预测目标音频对应的H-Codec token。其中token按语义和声学交替拼接,从25Hz拼接为50Hz,然后施加延迟模式(delay pattern),先预测低层token,再延迟预测高层token。
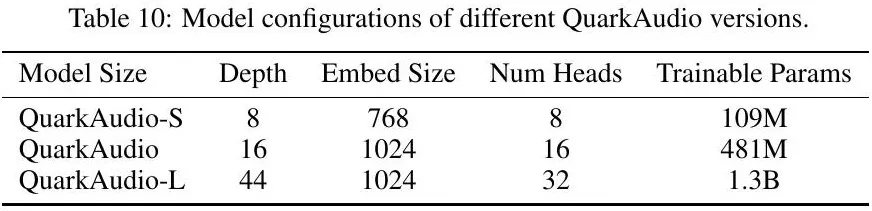
🔥模型大小
多个模型大小版本,灵活支持不同条件的部署。
实验结果:
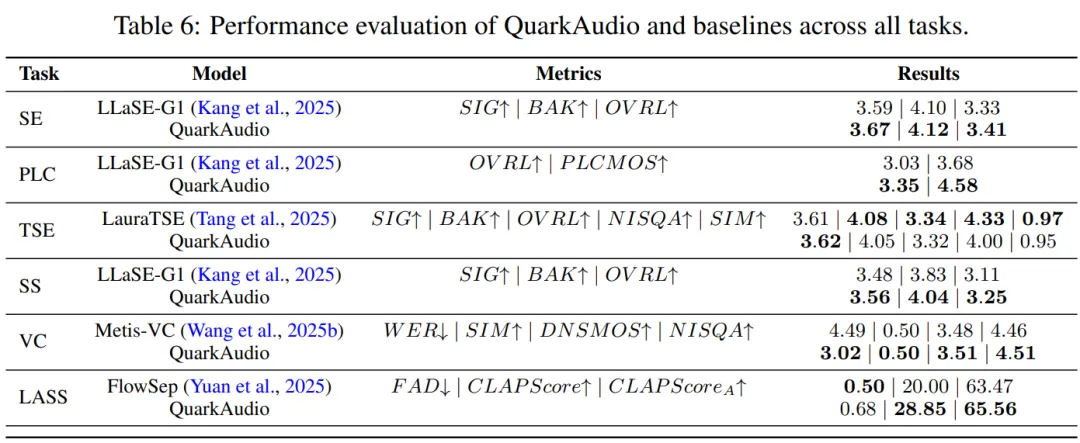
在多个任务(增强、丢包抑制、目标说话人提取、语音分离、音色转换、基于文本引导的音源分离)上,所提出的QuarkAudio达到超越或者与现有SOTA模型可比的效果。更多实验结果参见UniTok-Audio及QuarkAudio论文。
⏩结论与展望
QuarkAudio是在构建通用音频音效大模型道路上的重要一步,其探索了基于语义声学解耦表征的离散音频编解码器(H-Codec)以及多任务音频音效模型的统一训练范式。其提出了简洁通用的大模型框架来将多种孤立的音频类任务统一建模,减少理解与生成之间的差距,是对All in One的一次重要尝试。团队相信开源开放的力量,本次已将现有 QuarkAudio 系列模型对外开放。
⏩参考文章
Interspeech2025 | FlowSE — 基于流匹配的高效语音增强
Step-Audio-R1:比肩 Gemini 3 Pro,StepFun 开源首个音频深度推理模型
LLaSE-G1 | 激发语言模型在语音增强任务上的泛化能力
