
 语音小管家
随着深度学习技术在语音领域的广泛应用,说话人验证(Speaker Verification, SV)系统正朝着更深、更大的神经网络架构演进。以 ResNet101、DF-ResNet 等为代表的深度嵌入提取器显著提升了系统性能,但其高昂的 GPU 内存消耗却严重阻碍了在消费级硬件上的部署与训练。如何在有限资源下实现高性能、高效率的说话人验证模型训练是一个值得研究的课题。
近日,上海交通大学听觉认知与计算声学实验室(AudioCC Lab)在IEEE旗舰期刊IEEE Transactions on Audio, Speech and Language Processing(IEEE T-ASLP)上发表论文:《Memory-Efficient Training for Deep Speaker Embedding Learning in Speaker Verification》。该研究该研究提出了一种面向说话人验证任务的联合内存高效训练框架,通过可逆网络设计 + 优化器状态量化,在几乎不损失性能的前提下,实现高达 16.2 倍的 GPU 内存节省,使得 ResNet101 等深层模型可在单张 RTX 2080 Ti 上完成端到端训练。
Memory-Efficient Training for Deep Speaker Embedding Learning in Speaker Verification
作者列表:刘贝,钱彦旻
合作单位:上海交通大学
背景与简介
近年来,深度神经网络在说话人验证(Speaker Verification, SV)任务中取得了长足进步。以 ResNet 和 DF-ResNet 为代表的深层说话人嵌入提取器通过扩大模型容量与感受野,显著增强了说话人表征的判别能力。例如,DF-ResNet [1] 已达到 233 层;Chen 等人在 CNSRC 2022 与 VoxSRC 2022 [2] 中进一步将 ResNet 拓展至 293 层;而在 VoxSRC 2023 中,UNISOUND 系统 [3] 更是将 ResNet 深度推至 518 层,并凭借该模型夺得冠军。然而,这种“越深越好”的趋势带来了严峻的资源挑战:训练如此庞大的模型往往需要大量高端 GPU。例如,DF-ResNet233 需依赖 4 块 40GB A100 GPU;[3] 中的 ResNet314 使用了 10 块 32GB V100 GPU,而 ResNet518 的训练甚至动用了 60 块同类型 GPU。这种巨大的显存开销严重限制了深度说话人嵌入模型在消费级硬件或资源受限环境中的可及性与可复现性。在训练过程中,深度模型面临两大内存瓶颈:
1. 中间激活缓存:反向传播需保存前向计算中的所有中间特征图,其内存占用随网络深度线性甚至超线性增长;
2. 优化器状态存储:如 Adam 优化器需为每个参数维护一阶和二阶动量,通常以 32 位浮点格式存储,导致显存需求进一步膨胀。
这些限制使得百层以上的先进模型往往只能在多卡高端 GPU 集群上训练,严重阻碍了其在资源受限环境(如单卡工作站、边缘设备或中小实验室)中的应用与复现。尽管Gradient Checkpointing[4]等技术可在一定程度上缓解激活内存压力,但无法解决优化器状态带来的开销,且会引入额外的计算延迟。因此,亟需一种端到端的内存高效训练框架,既能大幅降低 GPU 显存占用,又不牺牲模型性能,从而推动高性能说话人验证系统在更广泛场景下的部署与研究。这正是本工作所要解决的核心问题。
核心方法
1. 可逆说话人验证网络架构设计
(1) 可逆操作(Reversible Operator):
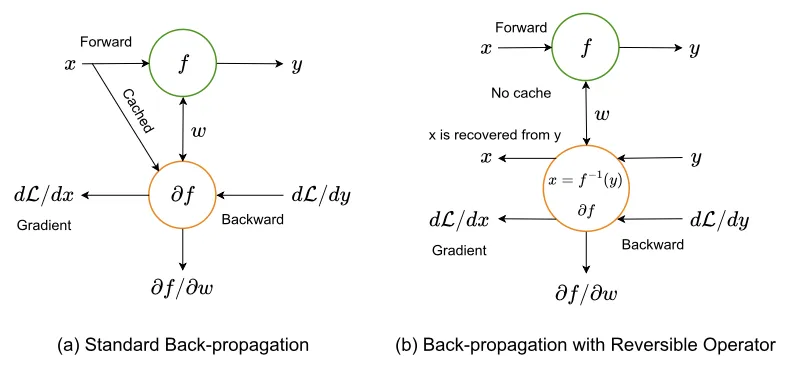
与标准计算模块不同,可逆模块在反向传播过程中无需依赖前向阶段缓存的中间激活值。它能够仅根据模块输出精确地重构输入,并利用恢复出的输入重新计算梯度以更新参数。这一特性消除了对中间激活值的存储需求。
(2) Type I RevNet:
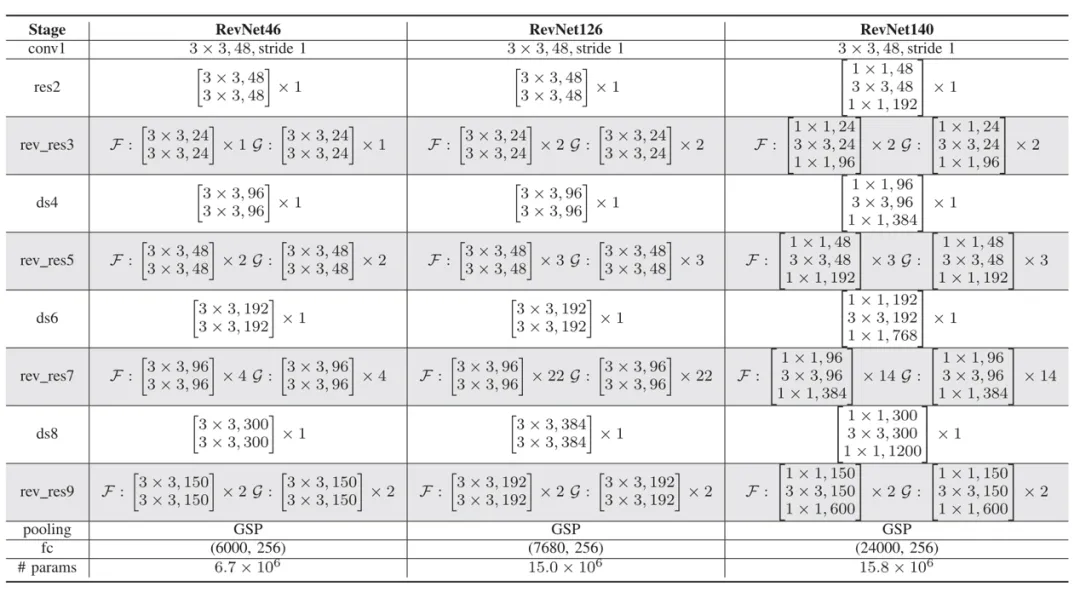
通过将ResNet和DF-ResNet标准残差块转化为可逆模块,可以避免存储中间激活值,从而降低训练阶段显存的需求。
前向传播
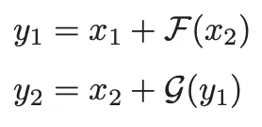
反向传播
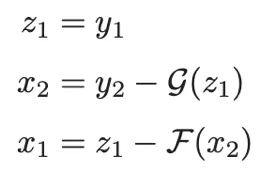
训练算法
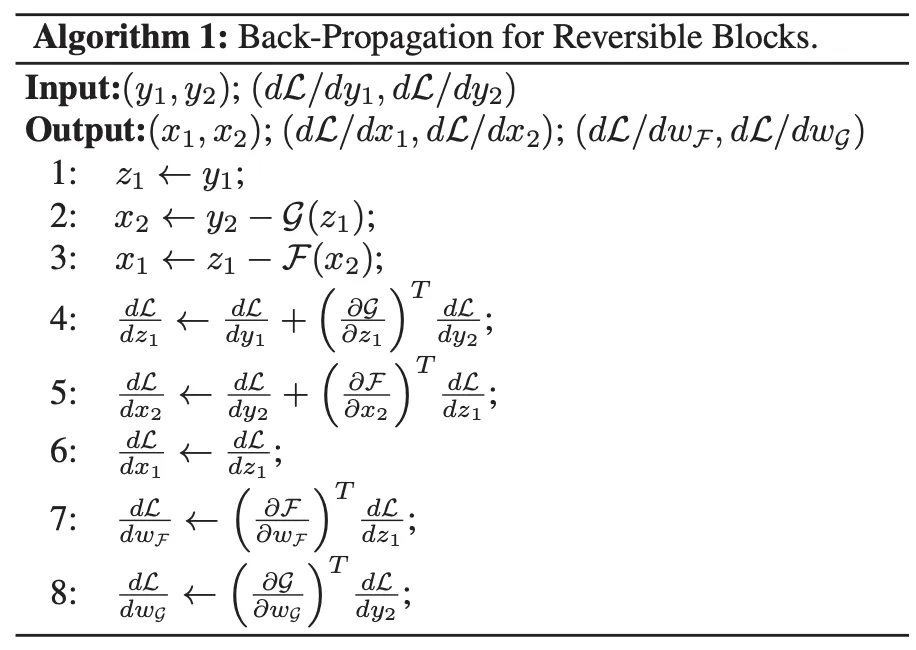
详细模型架构设计
(3) Type II RevNet:
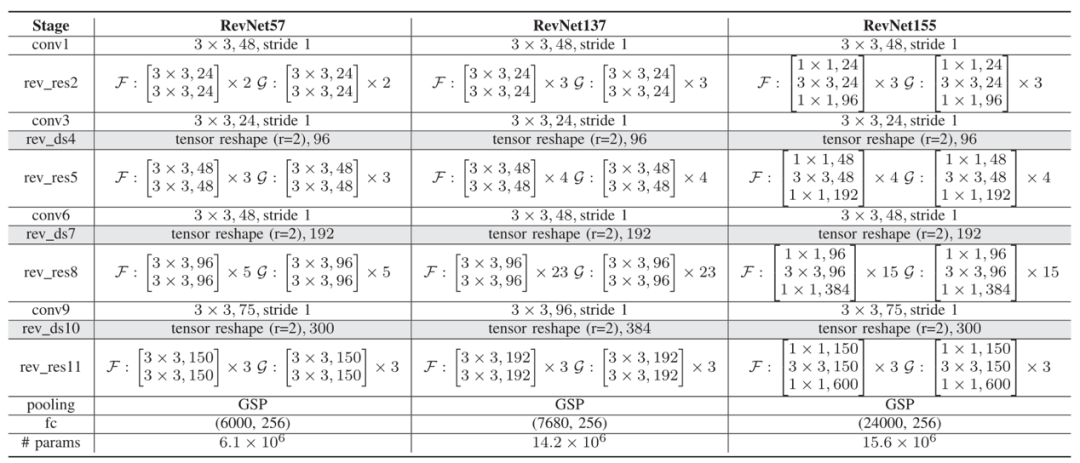
在Type I RevNet的基础上,通过引入 reshape-based 可逆下采样机制,在池化/卷积下采样层也保持可逆性,进一步提升整体网络结构的可逆程度,从而进一步降低显存需求。
可逆下采样操作
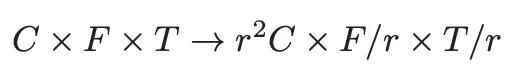
详细模型架构设计
2. 动态树状 8-bit 优化器状态量化
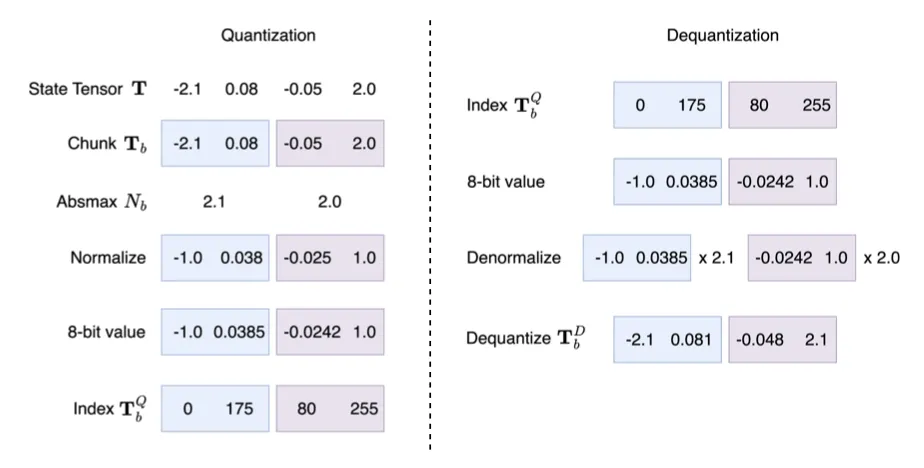
图1 8-bit 量化与反量化流程示意图
该算法通过将原始的 32-bit 浮点优化器状态转换为 8-bit 整数进行存储,并在参数更新时将其反量化回 32-bit 浮点值,在几乎不影响训练精度的前提下显著节省显存。
(1) Tensor 分块
张量被划分为B大小的子块,每个块独立进行量化,可以降低离群值的影响;
(2) 动态量化
对每个分块单独进行归一化,并采用 8-bit 动态树状数据结构 存储量化信息。量化过程通过最近邻查找算法,将浮点值映射到最接近的 8-bit 表示;
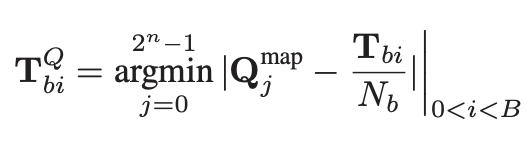
(3) 反量化
在梯度更新阶段,根据存储的量化索引 i 检索对应的 8-bit 值,再通过块内归一化参数将其还原为 32-bit 浮点张量,用于精确的梯度计算与参数更新。
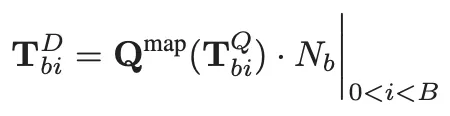
3. 联合内存高效训练框架
将上述两项技术无缝集成,形成统一训练流程:
前向/反向:通过激活重计算消除激活内存;
优化器更新:使用8-bit 动态量化压缩动量状态;
整体内存占用降低 16.2×,FLOPs 仅增加约 1.5×(主要来自重计算)
实验结果
1. 可逆网络效果评估
(1) RevNets
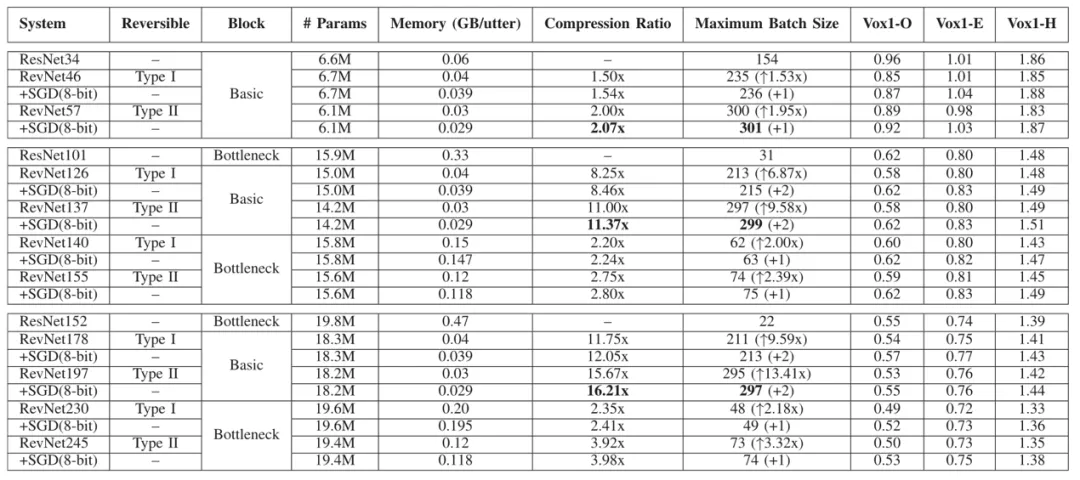
表1 ResNets和RevNets实验结果分析
我们提出的可逆架构在参数量范围为 6M 至 20M 的不同模型规模下,均能实现与原始 ResNet 相当的说话人验证性能。
所设计的两种可逆网络结构在各类配置中显著降低了 GPU 内存占用,最高可减少达 15.7 倍。
得益于内存效率的提升,训练时的批处理大小(batch size)最多可扩大 13.4 倍。
(2) DF-RevNets
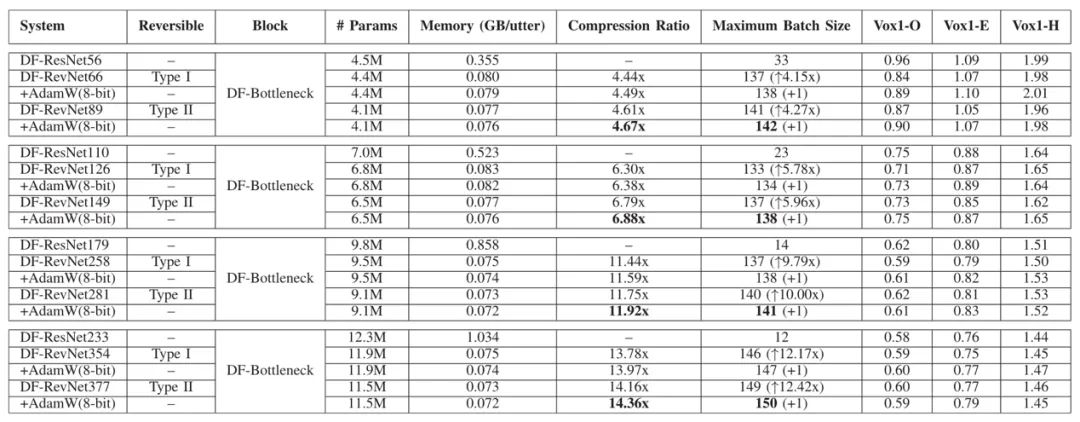
表2 DF-ResNets和DF-RevNets实验结果分析
类似的实验结论同样适用于 DF-ResNet 系列模型。
(3) 与 AMP 的对比
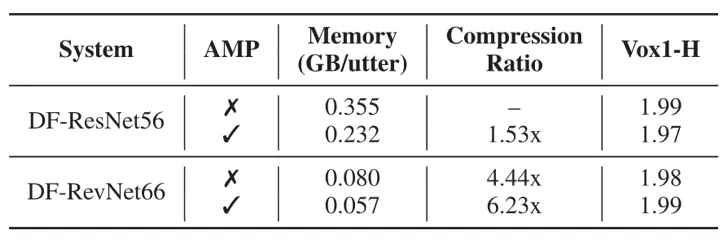
表3 与自动混合精度(AMP)训练的比较
与自动混合精度(AMP)相比,我们的方法在保持相近性能的同时,能够实现更高的显存压缩比。
此外,我们的方法与 AMP 是互补的——二者可结合使用,进一步降低训练过程中的内存开销。
2. 8-bit 优化器状态量化效果评估
从表1和表2可以看出,SGD 和 Adam 优化器的 8-bit 版本在几乎不损失模型性能的前提下,可以有效降低训练过程中的内存占用。
表4进一步表明,我们提出的 8-bit 优化器具有良好的架构通用性,不仅适用于基于卷积神经网络(CNN)的说话人验证系统,也能无缝集成到基于 Transformer [5] 的架构中。
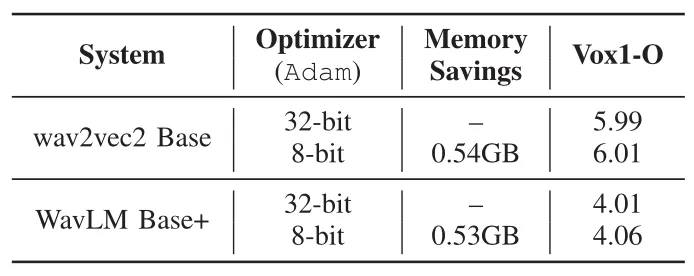
表4 Transformer-based系统显存使用情况
3. 显存使用分析
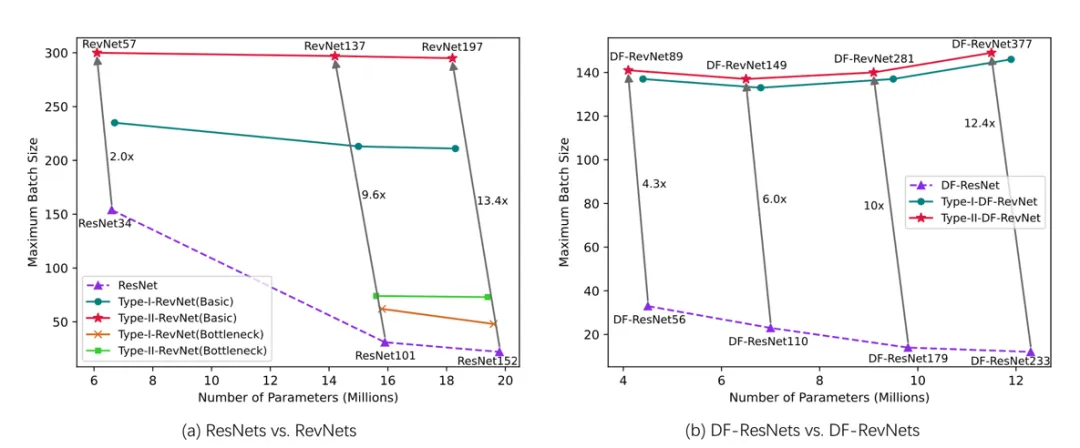
图2 显存使用分析图
原始的 ResNet 和 DF-ResNet 在训练时的内存占用随网络深度增加而近似线性增长,严重限制了深层模型在有限显存设备上的可训练性。
相比之下,我们提出的两种可逆架构(RevNet 与 DF-RevNet)展现出与网络深度几乎无关的内存消耗特性。
这一特性充分表明,在说话人验证系统中实现内存高效的深度训练具有巨大潜力和实用价值。
4. GPU 资源需求分析
我们提出的方法显著减少了训练所需的 GPU 数量,尤其在训练更深的神经网络时优势更为明显,同时在几乎不损失性能的前提下,保持了与原始模型相当的训练时间。
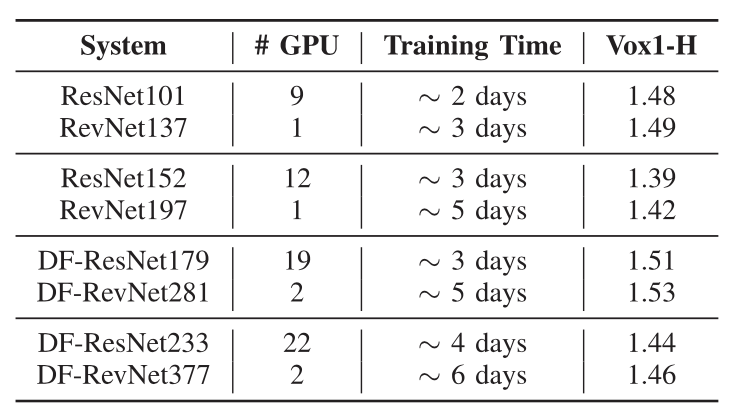
表5 GPU 资源需求分析
与原始模型相比,可逆网络的浮点运算量(FLOPs)大约增加了 1.5 倍,这主要源于反向传播过程中需重新计算前向激活值以节省显存。
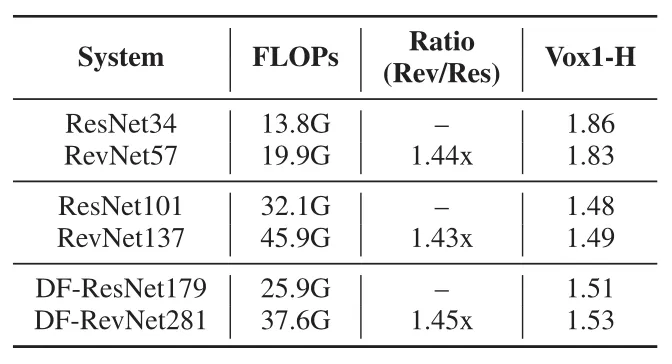
表6 FLOPs分析
总 结
本工作为资源受限场景下的深度说话人验证提供了切实可行的解决方案,其核心优势包括:
✅ 极致内存压缩:最高 16.2× 显存节省,单卡训练百层模型;
✅ 性能无损:EER 与原始模型几乎一致;
✅ 通用性强:框架可扩展至 Transformer(如可逆注意力模块);
✅ 部署友好:适用于科研实验室、边缘服务器、低功耗设备。
参考文献
[1] B. Liu, Z. Chen, and Y. Qian, “Depth-first neural architecture with attentive feature fusion for efficient speaker verification,” IEEE Trans. Audio, Speech, Lang. Process., vol. 31, pp. 1825–1838, 2023.
[2] Z. Chen, B. Han, X. Xiang, H. Huang, B. Liu, and Y. Qian, “SJTU- AISPEECH system for voxceleb speaker recognition challenge 2022,” 2022, arXiv:2209.09076.
[3] Y. Zheng, Y. Zhang, C. Niu, Y. Zhan, Y. Long, and D. Xu, “Unisound system for voxceleb speaker recognition challenge 2023,” 2023, arXiv:2308.12526.
[4] A. Gruslys, R. Munos, I. Danihelka, M. Lanctot, and A. Graves, “Memory- efficient backpropagation through time,” in Proc. Adv. Neural Inf. Process. Syst., 2016, pp. 4132-4140.
[5] A. Baevski, Y. Zhou, A. Mohamed, and M. Auli, “wav2vec 2.0: A framework for self-supervised learning of speech representations,” in Proc. Adv. Neural Inf. Process. Syst., 2020, vol. 33, pp. 12449-12460.
供稿:刘贝,编辑:方楠,审核:钱彦旻
