
 语音小管家
新一代 Kaldi 团队近日开源了一个自研音频生成模型(声码器)Flow2GAN,质量高、速度快、好训练,是 BigVGAN 一个不错的替代方案,欢迎体验。
论文:Flow2GAN: Hybrid Flow Matching and GAN with Multi-Resolution Network for Few-step High-Fidelity Audio Generation 论文地址:https://arxiv.org/abs/2512.23278 代码:https://github.com/k2-fsa/Flow2GAN 示例:https://flow2gan.github.io
音频生成模型(声码器),旨在从压缩的中间表示中重建高分辨率语音波形,例如从 Mel 频谱或离散 audio token。
当前主流方法是基于生成对抗网络(GAN)[1]。GAN 通过精心设计的判别器来捕捉多粒度的音频细节,代表性工作包括 BigVGAN [2] 和 Vocos [3]。其优势在于:能够以一步推理实现高保真音频生成;但其不足也较为明显:对抗训练不稳定,收敛较慢,并存在潜在的模式崩塌风险。
另一类重要方法是基于 Diffusion [4] / Flow Matching [5,6] 模型,其核心思想是学习从噪声分布逐步演化到真实数据分布的生成轨迹,代表性工作包括 MBD [7] 和 RFWave [8]。这类方法的优势是:训练稳定、生成能力强;但代价在于:通常需要多步采样,计算开销较大,推理效率受限。
我们提出Flow2GAN,旨在结合 GAN 和 Flow Matching 的优点,以少步推理的代价,实现高质量音频生成,同时保证训练稳定。
1.针对音频优化的 Flow Matching
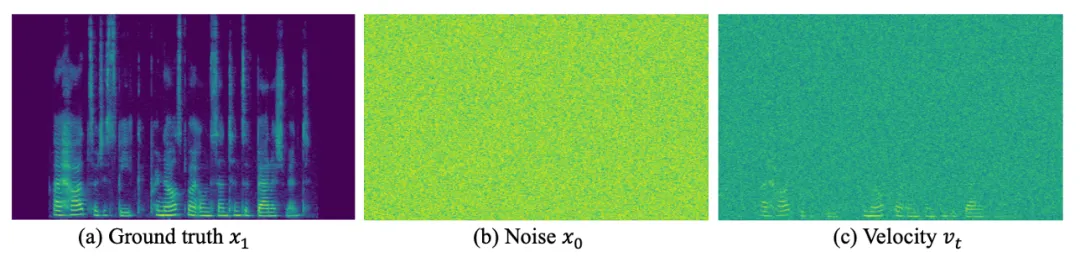
Flow Matching 的核心思想是:学习一个速度场(velocity field),将噪声分布逐步“搬运”到真实数据分布,从而实现生成。然而,将 Flow Matching 直接应用到音频建模中,会面临一些独特挑战:
1)速度(velocity)估计困难。如图 1 所示,音频信号中普遍存在静音片段或能量为零的频带。在这些区域,模型需要精确估计速度场,才能在去噪过程中准确抵消初始噪声,并恢复出“本应为空”的目标信号。这一过程对速度预测的稳定性和精度提出了更高要求。
2)损失函数与听觉感知不匹配。Flow Matching 通常采用 MSE 损失,对所有时频区域的误差一视同仁。然而,人耳对不同能量区域的感知敏感度并不相同,在听觉上人耳通常对相对安静区域更加敏感。
针对上述问题,我们针对音频建模的特殊性,对 Flow Matching 进行以下优化:
1)将速度预测重构为端点估计(Endpoint Estimation)。我们不再让模型直接学习中间时刻的速度场,而是将优化目标改写为对生成端点的预测。这一形式对音频数据更加一致且稳定,使模型能够专注于学习与音频结构相关的模式,避免静音或空能量区域速度难以估计的干扰。
2)引入基于频谱能量的自适应 Loss 缩放。在 Flow Matching loss 计算中,我们根据参考音频的频谱能量对误差进行加权,对低能量区域赋予更高权重,从而引导模型更加关注那些能量较低但对听觉感知至关重要的细节。
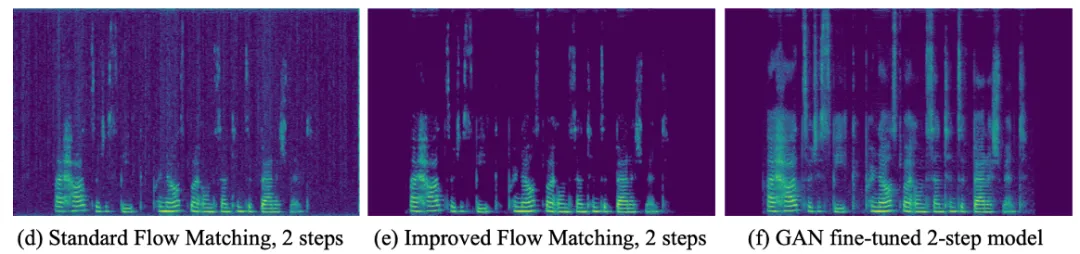
具体公式详见论文 Section 4.1,消融实验见论文 Table 3。如图 2 所示,相比较于标准的 Flow Matching(a),优化后的 Flow Matching(b)对于安静 / 低能量区域明显生成得更加干净。
2.结合轻量级 GAN 微调实现少步数高质量生成
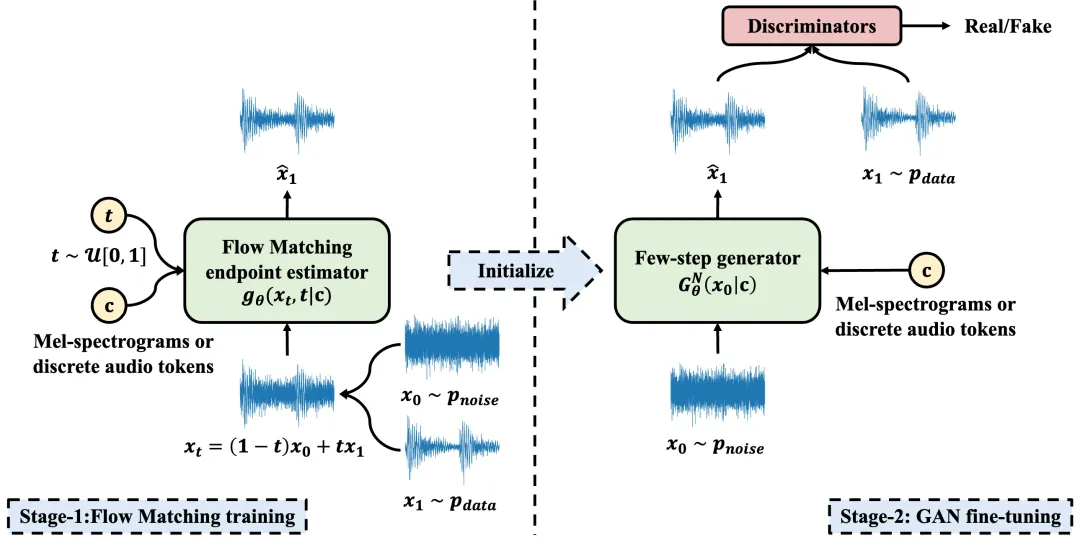
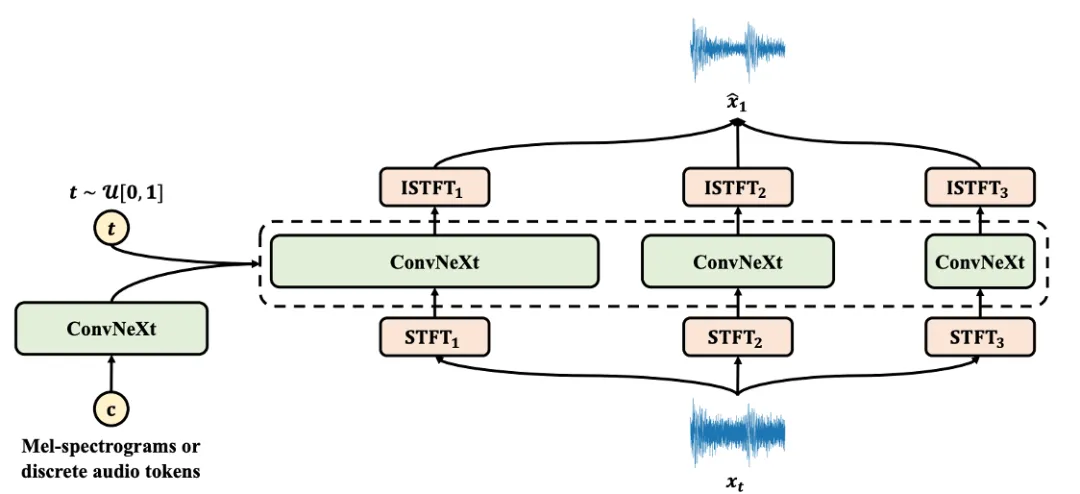
如图 3 所示,在使用针对音频建模优化的 Flow Matching 训练完后,我们初始化一个少步(1,2,4-step)生成器,引入轻量级的 GAN 微调阶段,增强音频的细节建模能力。
具体而言,该阶段利用已有的、经过充分验证的判别器设计,例如 Multi-Period Discriminator [9] 和 Multi-Resolution Discriminator [10],有效学习音频不同粒度的细节。如图 2(b)到(c),通过这一微调过程,模型可以在仅需少步推理的情况下生成高保真音频。具体消融实验见文章 Table 4。
整体上,Flow2GAN 结合了两类范式的优势:Flow Matching 负责稳定、鲁棒地学习生成能力,GAN 则用于强化音频细节。
3.多时频分辨率结构
如图 3 所示,我们在 Vocos 的结构基础上,引入多分辨率建模机制,以学习音频信号在不同时频尺度上的复杂结构,从而得到更强的生成骨干网络。为了权衡性能与效率,我们对低帧率(序列较短)分支使用更大的 embedding 维度,对高帧率(序列较长)分支则采用更小 embedding 维度。
LibriTTS test-set Mel condition 结果比较
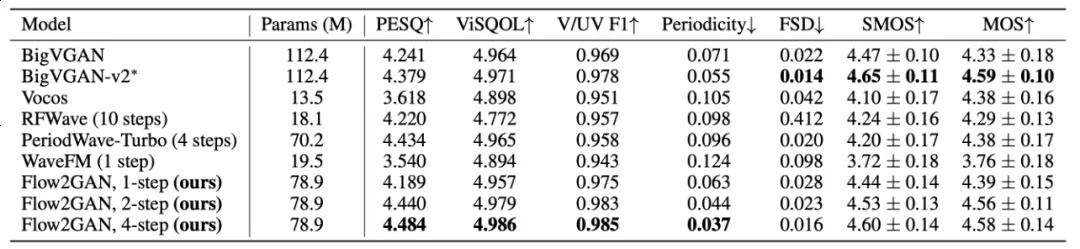
如表 1 所示,一步推理的 Flow2GAN 在绝大多数评价指标上均优于 Vocos、RFWave 和 WaveFM [11],仅在 PESQ 指标上略逊一筹。 当推理步数增加到两步和四步时,Flow2GAN 的整体性能进一步提升,除少数指标(如 FSD、SMOS 和 MOS)外,均超过所有对比方法。 其中,四步版本在 PESQ、ViSQOL、V/UV F1 以及 Periodicity 等关键指标上取得了最佳结果,表明该模型具有明显优势。需要指出的是,BigVGAN-v2 是在规模更大的数据集上训练得到的。在这种前提下,Flow2GAN 仍能取得与其接近的性能表现,进一步体现了所提出方法的有效性。
通用音频 Encodec audio token condition 结果比较
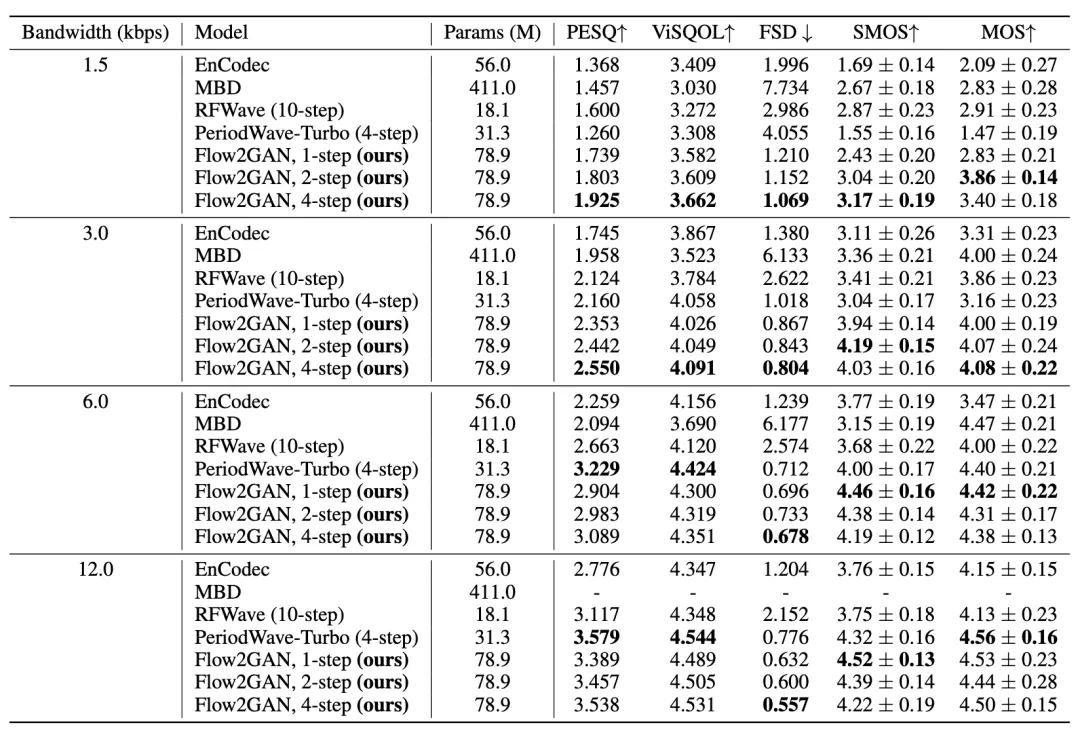
如表 2 所示,在低码率(1.5 和 3.0 kbps)条件下,Flow2GAN 的各个版本在大多数客观指标上均优于其他方法。仅在 3.0 kbps 的 ViSQOL 指标上,一步和两步版本略逊于 PeriodWave-Turbo。 在较高码率(6.0 和 12.0 kbps)下,尽管 PeriodWave-Turbo [12] 在 PESQ 和 ViSQOL 上表现最优,但 Flow2GAN 在所有客观指标上整体领先于其他模型。其中,四步 Flow2GAN 在 FSD 指标上显著优于 PeriodWave-Turbo。随着码率提升,Flow2GAN 的各个版本在主观听感指标(SMOS 和 MOS) 上均持续取得更优表现。
推理速度比较
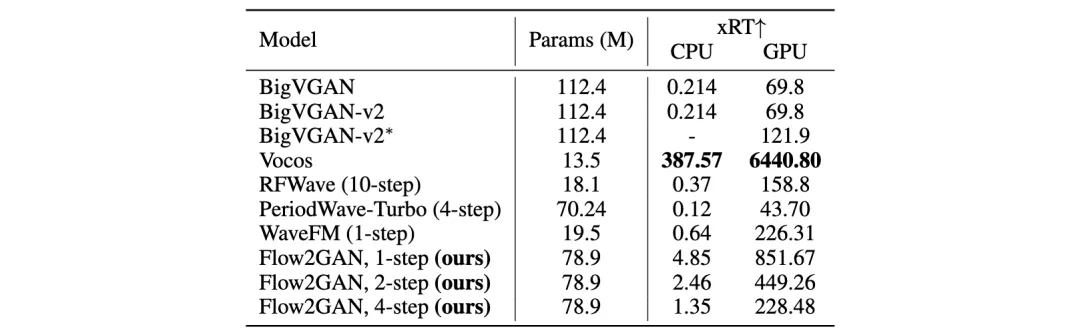
如表 3 所示,我们在 Mel 频谱条件下,对 Flow2GAN 与多个模型进行了推理速度对比,采用 xRT作为衡量指标。实验在 Intel Xeon Platinum 8457C CPU 和 NVIDIA H20 GPU 上进行,batch 大小为 16,音频片段长度为 1 秒。除 Vocos 外,Flow2GAN 的所有版本在 CPU 和 GPU 上的推理速度均显著快于其他方法,甚至在 CPU 上即可实现快于实时的生成。这表明 Flow2GAN 不仅在生成质量上具备优势,同时在推理效率方面同样表现突出。
Flow2GAN是一个兼顾生成质量与推理效率的音频生成模型,是 BigVGAN 的一个不错的替代方案,欢迎大家使用和拓展。如果觉得我们的代码可能对你有帮助,欢迎在 GitHub 上点个 star ⭐️ 支持一下:
https://github.com/k2-fsa/Flow2GAN
参考文献
[1] Ian J Goodfellow, Jean Pouget-Abadie, Mehdi Mirza, Bing Xu, David Warde-Farley, Sherjil Ozair, Aaron Courville, and Yoshua Bengio. Generative adversarial nets. Advances in neural information processing systems, 27, 2014.
[2] Sang-gil Lee, Wei Ping, Boris Ginsburg, Bryan Catanzaro, and Sungroh Yoon. Bigvgan: A universal neural vocoder with large-scale training. arXiv preprint arXiv:2206.04658, 2022.
[3] Hubert Siuzdak. Vocos: Closing the gap between time-domain and fourier-based neural vocoders for high-quality audio synthesis. arXiv preprint arXiv:2306.00814, 2023.
[4] Jonathan Ho, Ajay Jain, and Pieter Abbeel. Denoising diffusion probabilistic models. Advances in neural information processing systems, 33:6840–6851, 2020.
[5] Yaron Lipman, Ricky TQ Chen, Heli Ben-Hamu, Maximilian Nickel, and Matt Le. Flow matching for generative modeling. arXiv preprint arXiv:2210.02747, 2022.
[6] Xingchao Liu, Chengyue Gong, and Qiang Liu. Flow straight and fast: Learning to generate and transfer data with rectified flow. arXiv preprint arXiv:2209.03003, 2022a.
[7] Robin San Roman, Yossi Adi, Antoine Deleforge, Romain Serizel, Gabriel Synnaeve, and Alexandre D́efossez. From discrete tokens to high-fidelity audio using multi-band diffusion. Advances in Neural Information Processing Systems, 36:1526–1538, 2023.
[8] Peng Liu, Dongyang Dai, and Zhiyong Wu. Rfwave: Multi-band rectified flow for audio waveform reconstruction. arXiv preprint arXiv:2403.05010, 2024.
[9] Jungil Kong, Jaehyeon Kim, and Jaekyoung Bae. Hifi-gan: Generative adversarial networks for efficient and high fidelity speech synthesis. Advances in neural information processing systems, 33:17022–17033, 2020a.
[10] Won Jang, Dan Lim, Jaesam Yoon, Bongwan Kim, and Juntae Kim. Univnet: A neural vocoder with multi-resolution spectrogram discriminators for high-fidelity waveform generation. arXiv preprint arXiv:2106.07889, 2021.
[11] Tianze Luo, Xingchen Miao, and Wenbo Duan. Wavefm: A high-fidelity and efficient vocoder based on flow matching. arXiv preprint arXiv:2503.16689, 2025.
[12] Sang-Hoon Lee, Ha-Yeong Choi, and Seong-Whan Lee. Accelerating high-fidelity waveform generation via adversarial flow matching optimization. arXiv preprint arXiv:2408.08019, 2024b.
