
 语音小管家
标题:Index-ASR Technical Report
链接:https://arxiv.org/pdf/2601.00890
发表日期:2026年1月6号
作者单位:Artificial Intelligence Platform Department, bilibili
01、引言:为啥要做Index-ASR?
抗噪声能力差:背景噪声一大会让LLM-based ASR“瞎编”,输出没根据的长文本; 上下文定制弱:没法灵活用用户定义的热词,识别领域术语(比如特定行业的词)不准。
02、模型架构:Index-ASR由哪几部分组成?
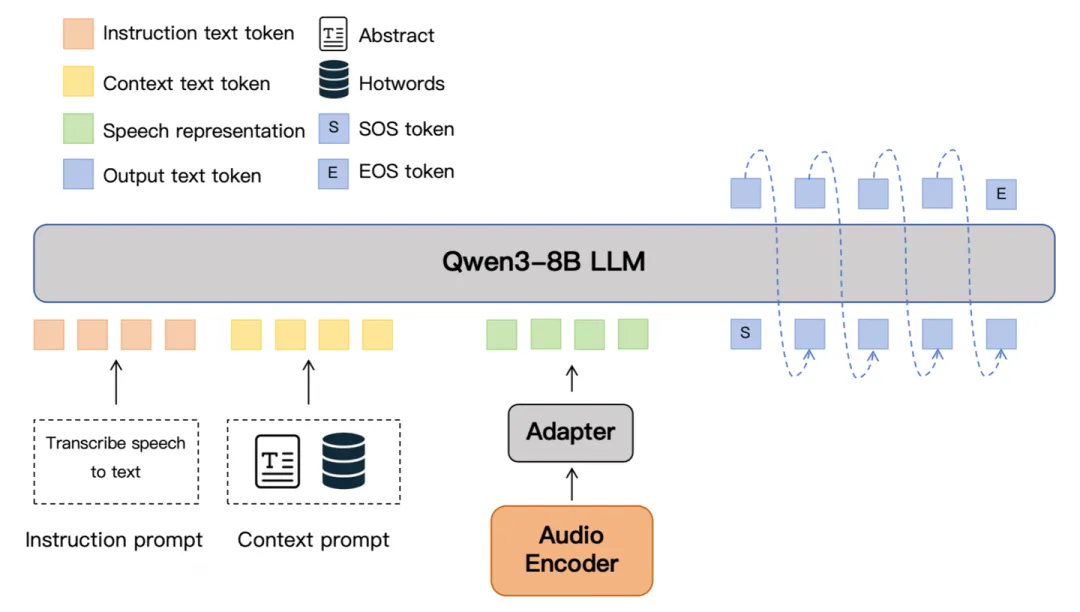
音频编码器:核心是提取语音的“高层表征”——就是把输入的语音信号转换成模型能懂的特征; 音频适配器:做两件事:一是“时域下采样”(简化时间维度的特征),二是把编码器输出的特征,投影到LLM需要的维度(让音频特征和文本特征能对齐); LLM解码器:基于Qwen3-8B模型,用“自回归(autoregressive)”的方式生成转录文本——生成时会同时参考适配器处理后的语音特征,以及文本prompt。
03、训练数据:用什么数据训模型?
音频编码器的训练数据:主要用开源数据集(覆盖中英),比如LibriSpeech(英文)、GigaSpeech(多领域)、WenetSpeech(中文)、AISHELL-2(中文),再补点bilibili内部的标注数据,提升数据多样性; 监督微调(SFT)数据:在上面数据集的基础上,加了两个:一是开源的Multilingual LibriSpeech(只用到英文部分),二是内部的“伪标注数据”(就是模型初步预测后,人工稍微调整过的数据); 上下文监督微调数据:专门为提升上下文能力做的,分两种:
热词上下文数据:用DeepSeek-V3模型,从ASR样本里提取关键词、领域术语; 摘要上下文数据:把同一个视频的所有转录文本拼起来,让DeepSeek-V3生成简洁摘要,作为上下文信息。
04、训练过程:分三步走,不一步到位
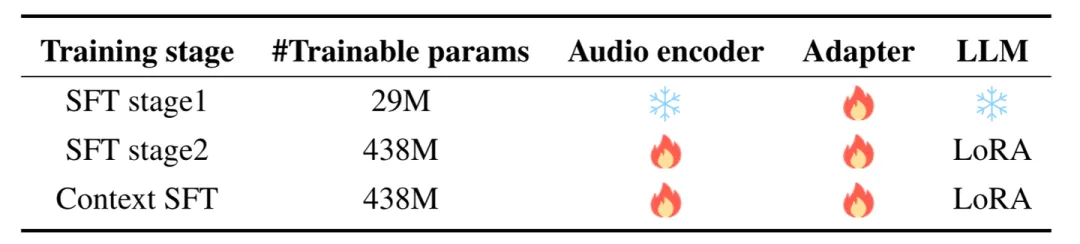
音频编码器训练:跟着FireRedASR的思路,用Wenet框架训一个“Conformer编码器+Transformer解码器”的AED模型——Conformer擅长抓语音的局部和长距离依赖,Transformer擅长序列转换;训完后,把这个AED模型的“编码器”拿出来,作为Index-ASR音频编码器的初始参数; 监督微调(SFT):分两阶段 Stage1:冻结音频编码器和LLM,只训适配器——目标是让适配器把音频特征“转译”到LLM能懂的语义空间,实现音频和文本的“对齐”; Stage2:音频编码器和适配器全参数训,LLM用LoRA微调——进一步提升识别性能,同时避免全训LLM太费资源; 上下文监督微调:用第3节说的“上下文数据”训,但会混一部分SFT阶段的普通ASR数据——防止模型只适应有上下文的场景,没上下文时性能下降;LLM还是用LoRA微调,可训练参数和Stage2一样是438M。
05、实验评估:Index-ASR表现怎么样?
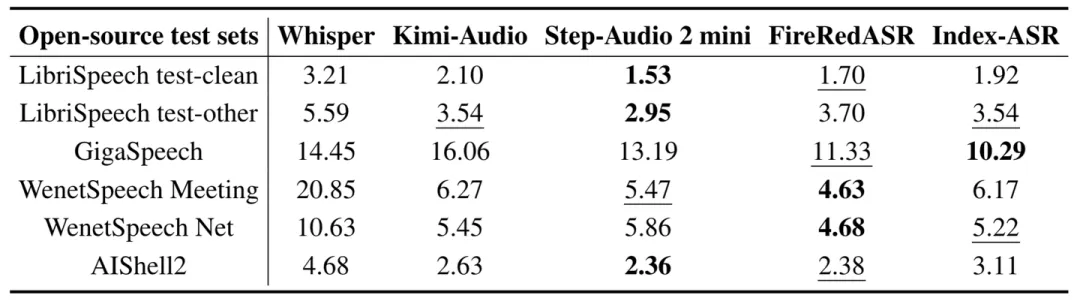
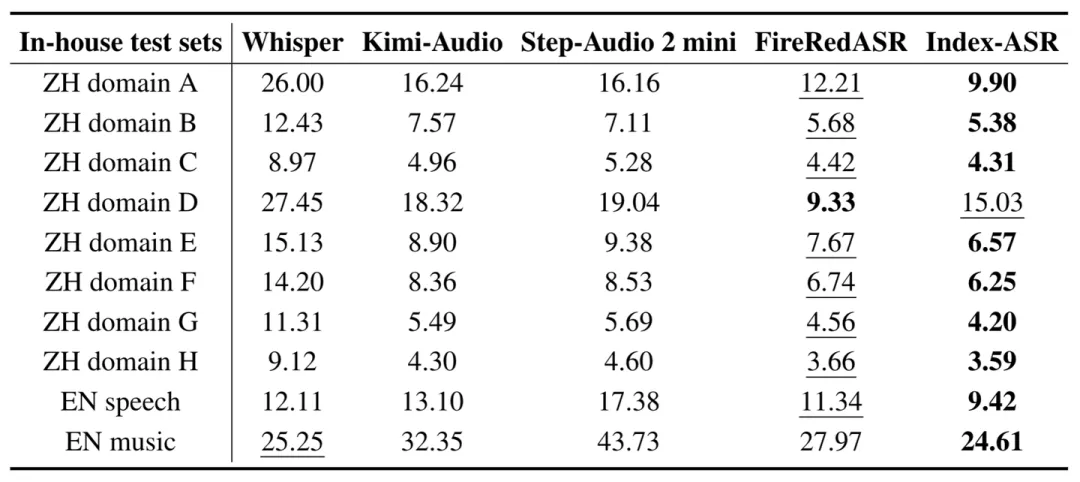
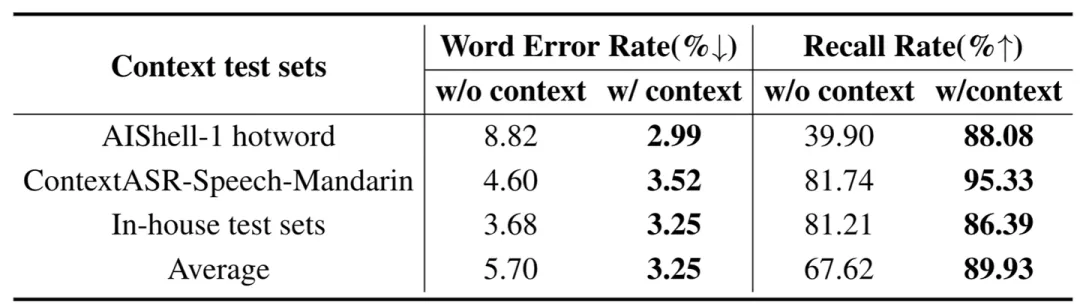
加了上下文后, 平均WER从5.70降到3.25,降了43% ; 热词召回率从67.62升到89.93,升了33%——尤其是AIShell-1热词集,召回率从39.90飙到88.08,翻了一倍多; 证明Index-ASR能很好地利用上下文提示,识别热词、领域术语的能力很强。
06、核心创新点
架构创新:把音频编码器、适配器、Qwen3-8B LLM结合,还支持“上下文prompt”(热词、摘要),专门针对上下文定制; 数据创新:用大量带真实噪声的语音数据抗幻觉,用“热词+摘要”的上下文数据提升定制能力; 训练创新:分三阶段训练(先训编码器、再分两阶段SFT、最后上下文SFT),还在上下文SFT里混普通数据,避免性能下降; 问题解决:同时搞定了“噪声引发幻觉”和“上下文定制弱”两个痛点,而不是只优化一个。
07、局限与未来计划
目前只支持中文和英文,没法处理其他语言——未来要做“多语言版”; 训练数据量比工业级ASR模型还少,得再扩充; 不支持“流式ASR”(就是边听边转文字,实时输出)——这是下一步重点优化的方向。
08、结论
