
 语音小管家
海洋越来越“吵”。货轮、集装箱船、拖网渔船的低频轰鸣叠加成持续背景声,被广泛部署的被动声学监测(PAM)系统悉数录入。全球已有数百套PAM系统全年无休地记录海底声音,但由于高质量船舶录音标注稀缺,大量数据难以有效分析。
如何在标注船舶录音稀缺的情况下,利用 PAM 的海量录音提取船舶类型信息?
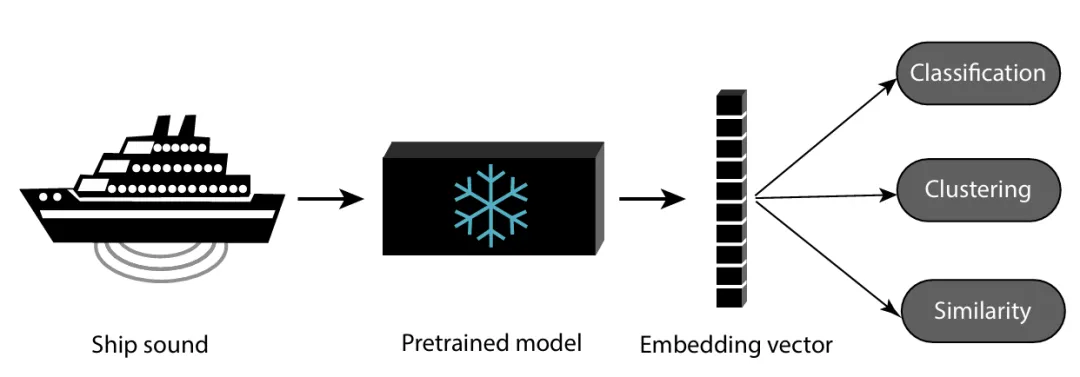
图1 各种预训练音频模型的评估方法示意图。展示本研究采用的三种互补的评估方法:通过线性探测的船舶分类、基于聚类的嵌入分析、基于相似度的嵌入评估。
该研究采用了迁移学习中的“线性探针”范式:将预训练模型作为固定的特征提取器,仅训练最后一层线性分类器,以适应下游任务。研究系统评估了来自不同音频领域的预训练模型对船舶噪声识别的适用性。
团队选取了16个代表性模型,覆盖通用音频、语音、生物声学和海洋生物声音四个领域,包括BEATS、AudioMAE、Wav2Vec 2.0等,并设置了基于梅尔频谱的基线模型进行比较。所有预训练模型的权重均被冻结,用于提取音频片段的嵌入向量,随后用同一逻辑回归分类器进行船型分类。
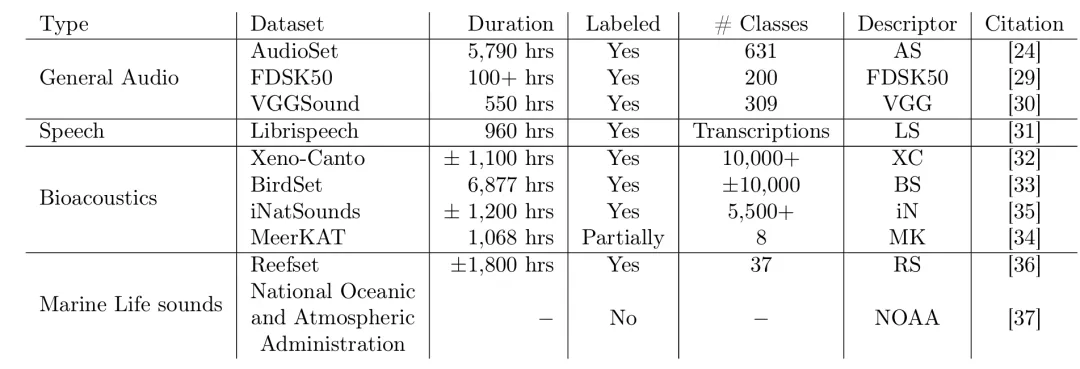
表1:预训练数据集概览(此表系统性地列出了研究中使用的所有预训练数据集,包括它们的类型(如通用音频、语音、生物声学、海洋生物声音)、数据集名称、时长、是否标注、类别数量、描述符和引用。)
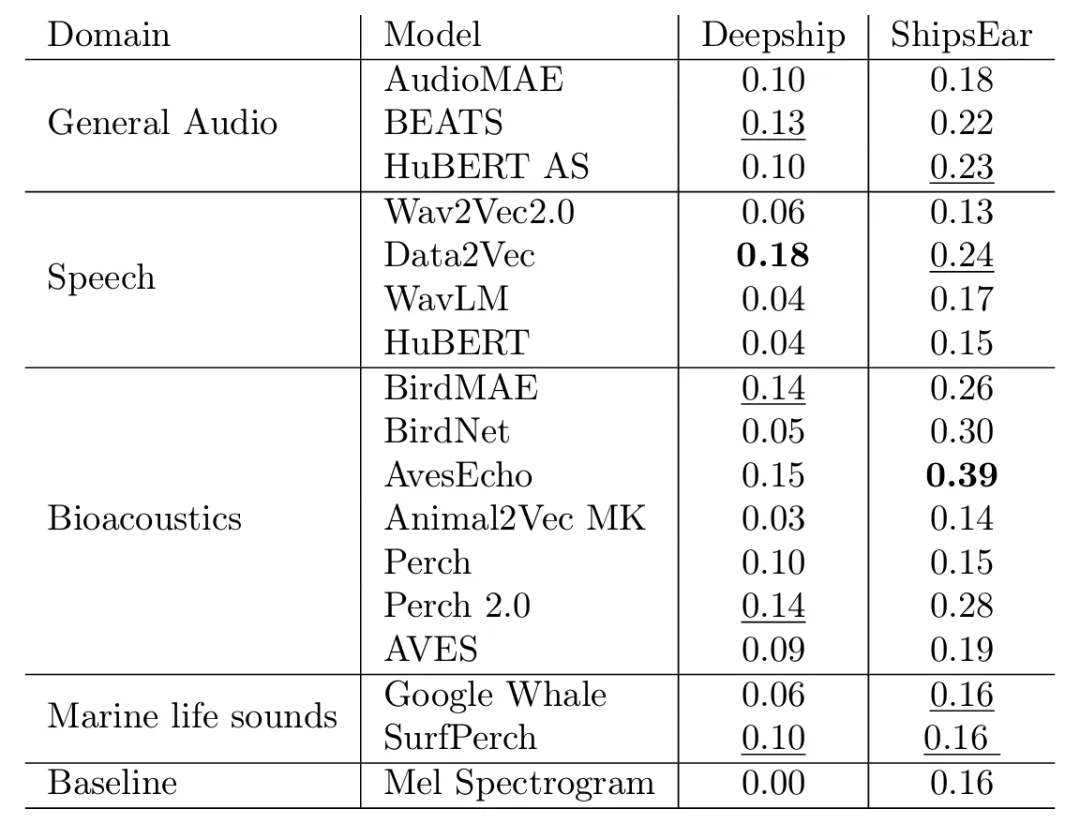
表2 此表展示了所有预训练模型在两个基准数据集(Deepship, ShipsEar)上,通过K-Means聚类后得到的归一化互信息分数,用于无监督评估嵌入空间的语义可分离性。粗体标出整体最佳性能,下划线标出各领域最佳。
为考察模型性能,研究选用了两个独立的数据集:加拿大温哥华外海的DeepShip(4类船舶,按时间划分训练/测试集,测试集包含新船舶)和西班牙西北岸的ShipsEar(5类船舶,随机划分)。这两个数据集声学环境不同,有助于评估模型的泛化能力。
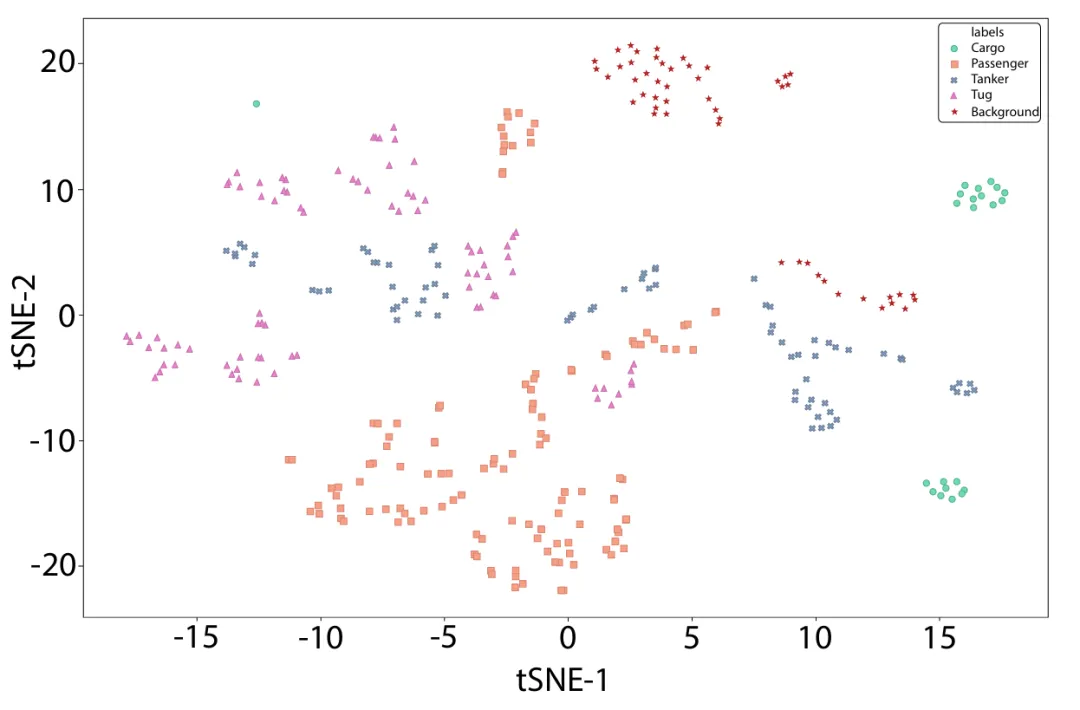
图2 使用ShipsEar测试集生成的BEATS嵌入的t-SNE图。此可视化图(t-SNE降维)直观展示了BEATS模型在ShipsEar数据集上生成的嵌入向量的分布。图中显示,相同录音的样本点倾向于聚在一起,形成子簇,揭示了嵌入空间的结构主要由录音特定信息(如录音ID)驱动。
结果显示,在分类任务中,多数预训练模型通过线性探针后性能超过基线,但部分模型表现未达预期;受数据集划分方式影响,模型在 DeepShip 数据集的整体准确率低于 ShipsEar。
其中,通用音频模型 BEATS 在 DeepShip 上取得了 65.4% 的准确率,语音模型 Wav2Vec 2.0 在 ShipsEar 上达到了 78.0% 的准确率。而专门用于海洋生物声音识别的模型(如 Google Whale 和 SurfPerch)表现相对较差。
研究人员分析指出,通用音频和生物声学模型(特别是基于鸟类数据的模型)在训练中接触了更多样化的声学环境与声音类别,这可能使其学到的特征表示更具普适性。相比之下,专门的鲸歌模型所学的特征可能更特化,迁移到船舶噪声领域时效果受限。
进一步的嵌入空间分析发现,通过归一化互信息(NMI)量化,嵌入向量与船舶类型标签的关联较弱(多数模型 NMI<0.3),但与录音 ID 的关联显著更强(BEATS 模型 ShipsEar 数据集上录音 ID NMI 达 0.66)。
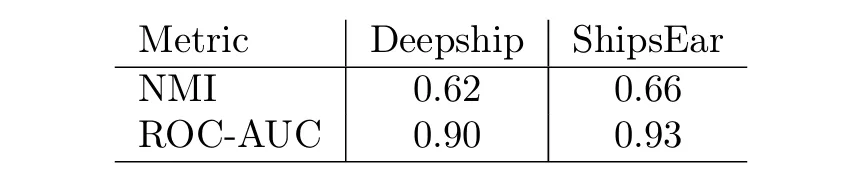
表3BEATS嵌入中录音ID信息的评估(当使用“录音ID”(而非船舶类型)作为标签时,BEATS嵌入在聚类(NMI)和相似度排序(ROC-AUC)任务上的性能。)
这表明,预训练模型生成的嵌入空间,其整体结构更多地被录音特定的信息(如环境、设备参数)所影响,而非语义上的船舶类别。
为探究线性分类器为何仍能有效工作,研究进行了标签打乱实验:将船舶类型标签随机重排后训练线性分类器,其准确率大幅下降。这证明分类器的有效性依赖于嵌入向量与船型标签之间真实的语义关联。
特征重要性分析也显示,在BEATS模型的768维嵌入中,仅有少部分维度对分类结果有显著影响。这表明线性层起到了“特征选择”的作用,从包含大量录音特定信息的嵌入中,筛选出了与船型相关的判别性特征。
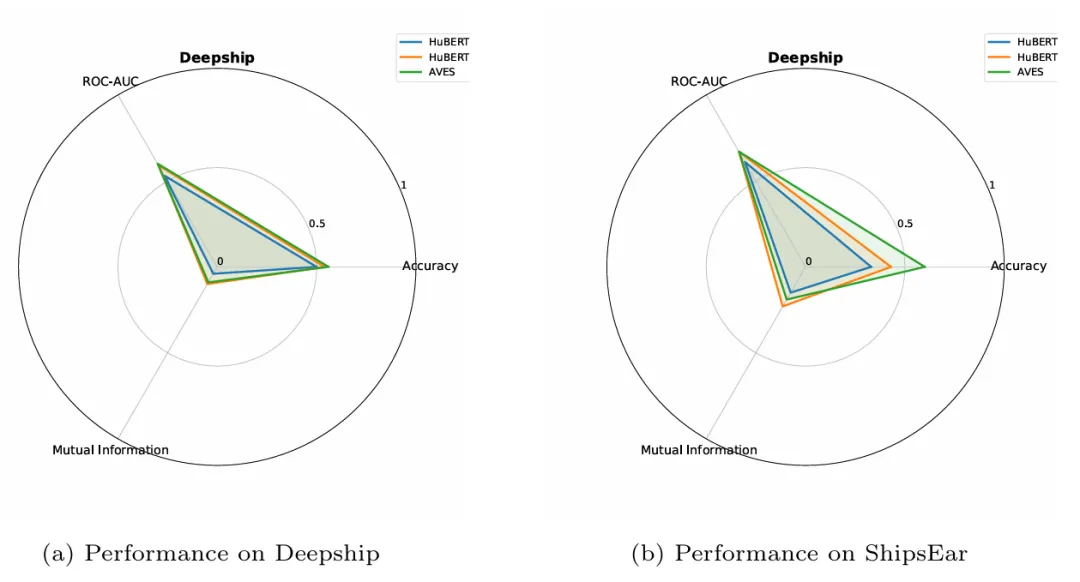
图3 在不同领域数据集上训练的基于HuBERT的模型性能雷达图(此雷达图比较了三个共享相同架构(HuBERT)但预训练数据域不同(语音、通用音频、生物声学)的模型在所有评估指标上的综合表现,展示了预训练数据域对模型迁移性能的影响。)
该方法在计算上具有效率优势:由于无需微调大型预训练模型,主要计算成本在于提取嵌入向量和训练小型线性分类器,可在普通计算设备上完成。
未来工作可包括结合少量标注数据的优化,以及呼吁建设更全面的开放船舶音频数据集,以促进该领域发展。
论文信息:Hilde I. Hummel, Sandjai Bhulai, Rob van der Mei, Burooj Ghani. Decodable but not structured: linear probing enables Underwater Acoustic Target Recognition with pretrained audio embeddings. arXiv preprintarXiv:2601.08358v1, 2026.
