
 语音小管家
标题:MoE Adapter for Large Audio Language Models: Sparsity, Disentanglement, and Gradient-Conflict-Free
链接:https://arxiv.org/pdf/2601.02967
发表日期:2026年1月6日
作者单位:百度、内蒙古大学、清华大学深圳国际研究生院
01、先说说背景:为啥之前的方法不好用?
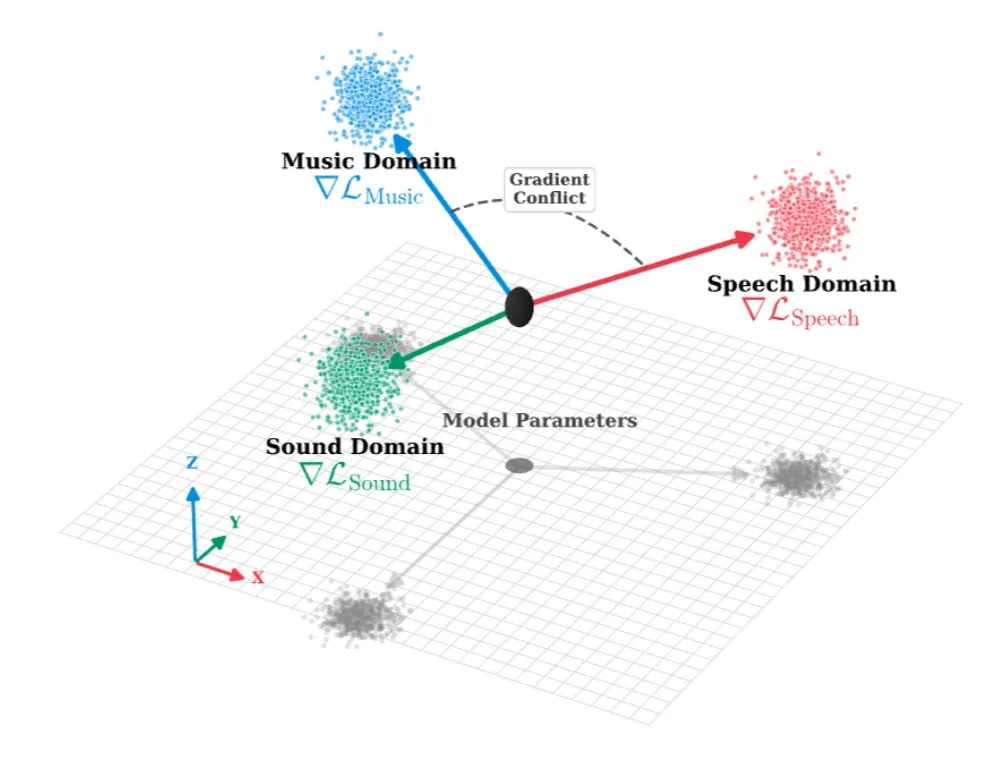
音频本身“太杂” :语音(比如说话内容)、音乐(旋律节奏)、环境音(比如雨声、汽车鸣笛)是完全不同的“数据类型”,它们的统计规律差很远(论文里叫“异质(heterogeneous)”);
Adapter“太死板” :之前都用Dense Adapter,所有参数共享,不管是语音还是音乐,都用同一套参数处理。但优化时,语音需要的参数更新方向,可能和音乐完全相反——这就导致“梯度冲突”(比如想让语音识别更准的更新,会让音乐理解更差),论文里图1就画了这个问题:
02、相关工作:我们站在哪些“前人肩膀”上?
早期是“级联式”:先把音频转文字(ASR),再让LLM处理文字,但会丢非语言信息(比如语气),还会传播ASR的错误;
现在是“端到端”:用Adapter直接把音频特征映射到文本空间,主流是两种:Q-Former架构(比如SALMONN)和线性投影器(比如Qwen2-Audio、Kimi-Audio),但后者还是用密集型参数,没解决梯度冲突。
MoE的思路是“稀疏激活”:把复杂任务拆给多个“专家”(小模型),用一个路由机制选几个合适的专家干活,不用所有专家都启动。之前在视觉、多模态领域已经证明能解决异质数据问题,但在“音频-文本对齐”里几乎没人用——这就是论文的突破口。
03、核心创新:MoE-Adapter到底是怎么设计的?
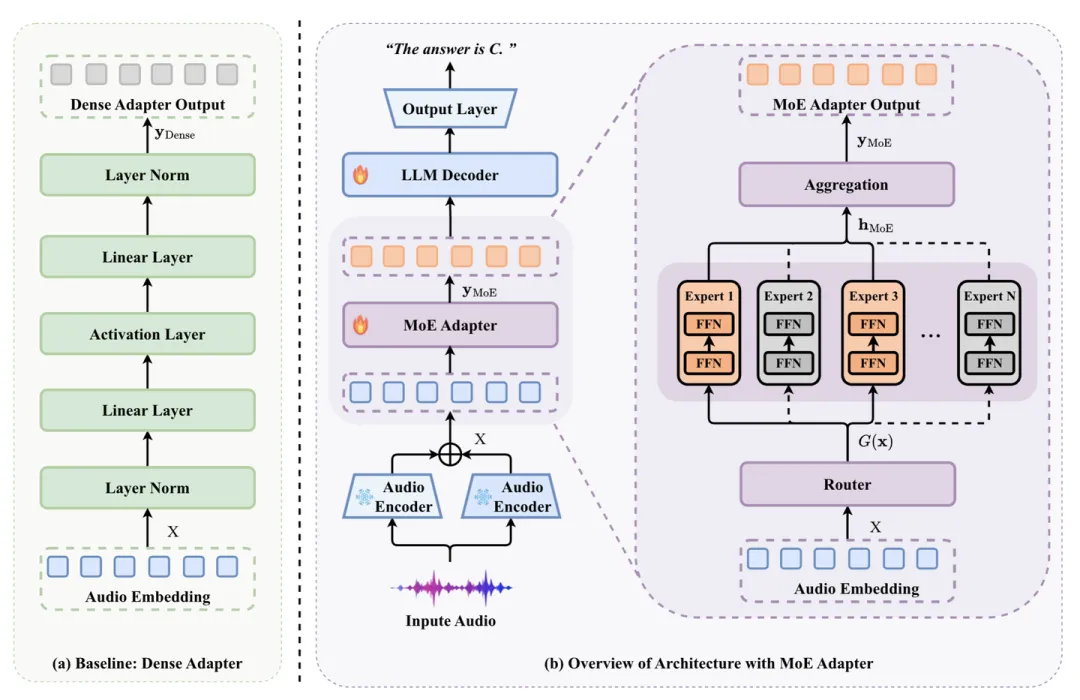
一个“冻结的Tokenizer”:提取离散的语义token;(图中这里似乎写错了) 一个“语音编码器”:提取连续的声学特征;
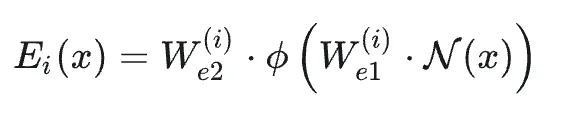
主损失LNTP:下一个token预测损失,和普通LLM一样,就是让模型根据音频和前文,准确预测下一个文本token;
辅助损失 Laux:专家负载均衡损失(防止“专家崩溃”)。因为路由器可能偷懒,只激活少数几个专家,其他专家没训练到。这个损失会计算每个专家的“平均路由概率”和“被激活的比例”,强制让专家们的工作量更均衡。
04、实验:我们怎么测?结果怎么样?
基础模型:LLM用Qwen3-1.7B; 音频前端:Whisper-VQ Tokenizer(提离散token)+ Whisper Encoder(提连续特征); 训练数据:400亿token的高质量语料; 优化器/学习率:AdamW(β1=0.9,β2=0.95),学习率用“Warmup-Stable-Decay”调度(峰值1e-5,热身20步); 参数控制:Dense Adapter和MoE-Adapter的总参数都是94.4M,但MoE推理时只激活70.8M(约75%)——更省计算; 评估任务: 知识推理:MMSU、OBQA(都是VoiceBench里的语音版任务,需要结合世界知识,比如“听到下雨声,推测可能的天气”); 副语言理解:MMAU(覆盖语音、音乐、环境音,测感知能力,比如“区分开心和生气的语气”); 解码方式:贪心解码(保证结果可重复、可比)。
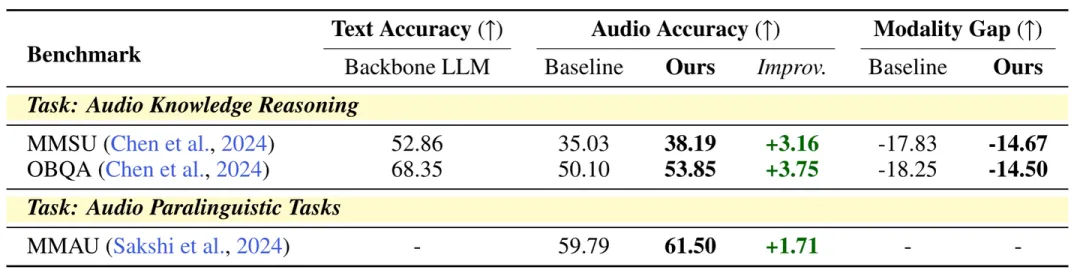
知识推理更强 :MMSU和OBQA分别提了3.16%和3.75%,说明专家分工能更好捕捉“音频+知识”的关联(比如听到“救护车鸣笛”,能联系到“紧急医疗”);
副语言理解更稳 :MMAU提了1.71%,证明MoE能处理不同类型的音频(语音、音乐、环境音);
模态差距缩小 :“模态差距”是“文本准确率-音频准确率”,差距越小说明音频和文本的对齐越好。比如MMSU从-17.83缩小到-14.67,说明MoE-Adapter把音频特征映射到文本空间的效果更好。
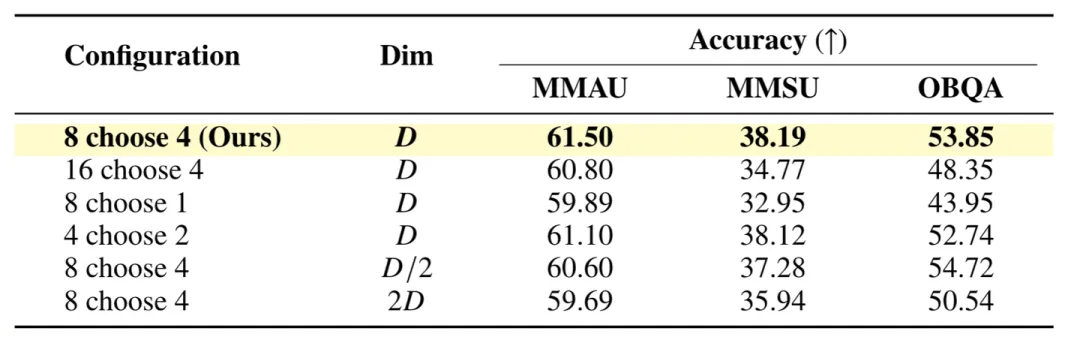
专家太多没用:16选4比8选4差,因为专家多了会分散能力,路由也难选对;
活跃专家太少不行:8选1太稀疏,专家覆盖不了所有音频类型,性能掉得厉害;
维度太大反而糟:8选4(2D)把专家维度翻倍,性能反而降了,说明不是参数越多越好,均衡最重要;
最优是“8选4”:兼顾了专家多样性和稀疏性,性能全方面最好。
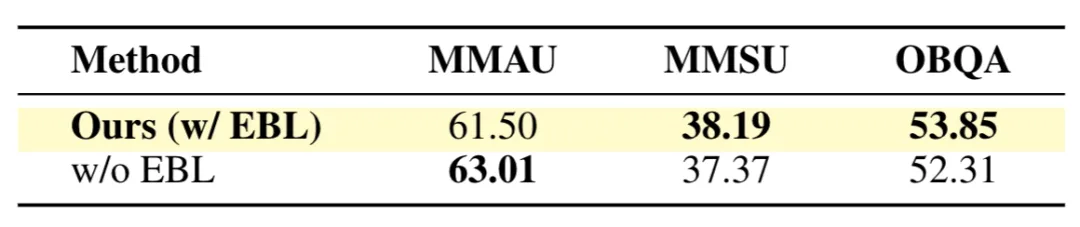
无EBL时,MMAU更高:因为MMAU多是“感知类任务”(比如区分声音类型),路由器会自动把更新集中到“主导专家”(擅长感知的专家),处理常见模式更高效;
有EBL时,MMSU和OBQA更高:因为EBL强制专家均衡,避免了“专家摸鱼”,能覆盖更多“知识推理”需要的场景(比如结合音频和世界知识)。 ——所以论文最终选了“有EBL”,因为更适合复杂的音频理解任务。
05、深入分析:MoE-Adapter为啥能行?看内部机制
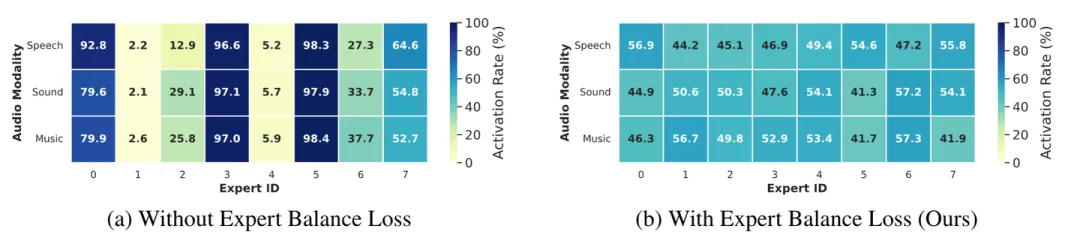
无EBL(左图):专家激活极不均衡,比如专家0对语音的激活率92.8%,但对音乐只有2.2%;专家5对音乐激活98.3%,对语音只有5.2%——说明路由器只靠“主导专家”干活,其他专家没用到;
有EBL(右图):激活率更均衡,比如语音在专家0-7的激活率大概44%-56%,音乐在41%-57%——而且能看到“模态分工”:
没有专家同时擅长语音和音乐(符合两者差异大的特点);
环境音(Sound)是“声学桥梁”:和语音、音乐都有共享专家(比如专家2对Sound激活45.1%,对语音44.2%,对音乐41.7%)——因为环境音和两者都有低层次声学特征重叠。
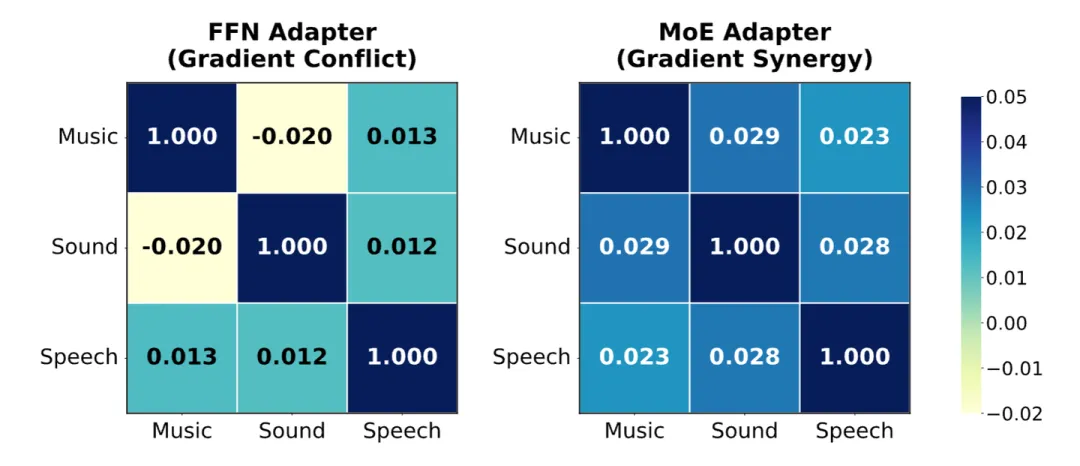
左图(Dense Adapter):有负相关!比如“音乐-语音”的相似度是-0.020——说明优化音乐的梯度,和优化语音的梯度方向相反,冲突实锤;
右图(MoE-Adapter):都是正相关!比如“音乐-语音”到了+0.023,“音乐-环境音”+0.028——说明路由把不同音频的梯度“分流”到不同专家,冲突缓解了。
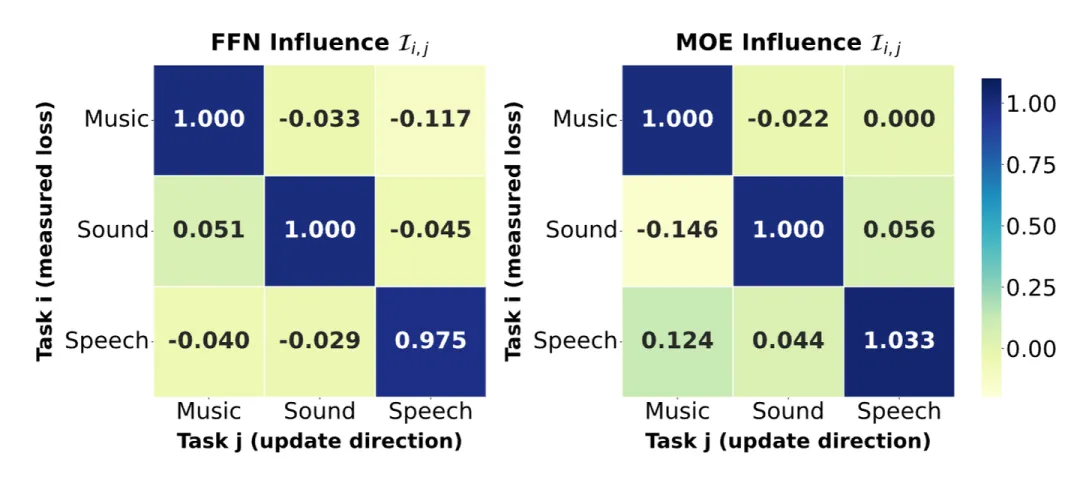
左图(Dense Adapter):负分很多!比如“用语音的梯度更新,对音乐的影响是-0.117”——说明优化语音会让音乐理解变差,典型的冲突;
右图(MoE-Adapter):大多正分!比如“用语音的梯度更新,对环境音的影响是+0.044”——说明不仅没冲突,还能“正迁移”(语音的优化帮了环境音),因为两者共享了专家。
06、结论和局限
性能:在知识推理、副语言理解任务上都超Dense Adapter;
效率:总参数和Dense Adapter一样(94.4M),推理时只激活75%(70.8M),更省算力;
机制:通过专家分工和负载均衡,实现了“音频异质特征的解耦”,还促进了模态对齐。
只在Qwen3-1.7B上测了,没试更大模型(比如70B),不知道普适性怎么样;
没探索“训练数据量”和“专家分工”的关系(比如数据量翻倍,专家要不要加?);
只做了“音频理解”,没扩展到“音频生成”(比如用LLM生成音乐)。
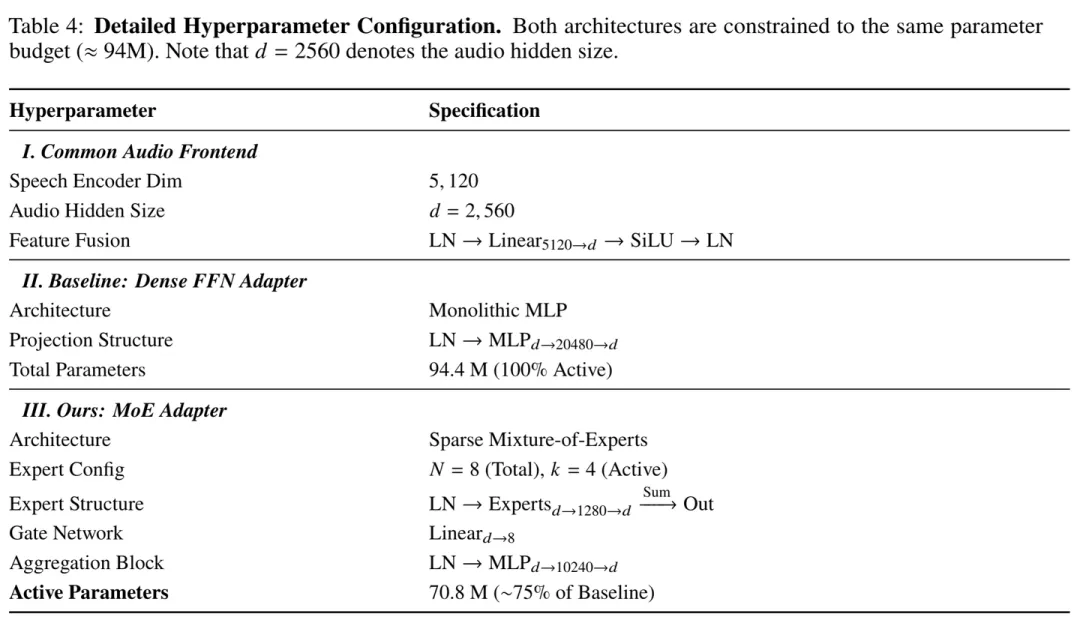
Dense Adapter:单一个MLP,中间维度20480,所有94.4M参数全激活;
MoE-Adapter:8个专家,每个中间维度1280,加一个中间维度10240的聚合块,总参数94.4M,推理激活70.8M——彻底保证了“公平对比”。
