
 语音小管家
标题:A Study Of Data Selection Strategies For Pre-Training Self-Supervised Speech Models
链接:https://arxiv.org/pdf/2601.20896
作者单位:Avignon Universit´e、University of Cambridge、Universit´e Grenoble Alpes
发表日期:2026 年 1 月 28 日
开源地址:论文中说最终定稿版会有代码,目前暂未提供
说明:Accepted to ICASSP 2026
01、引言:为啥要做这个研究?
02、相关工作:之前大家都做了啥?
之前大家想让SSL模型更高效,主要走了三条路:
简化预训练框架:比如BEST-RQ用“随机投影量化器”+简单交叉熵损失,比wav2vec 2.0(用学出来的码本+对比损失+多样性损失)简单多了;还有人用预训练好的模型生成更高质量的embedding当训练目标,既提效又提性能。
改进模型架构:比如简化声学特征提取器——Whisper只用2层卷积处理mel滤波器组,而不是像之前那样用7层卷积处理原始音频;还有用更高效的结构替代多头自注意力,或者用知识蒸馏缩小模型 size。
优化评估方法:比如通过SSL模型生成的embedding的“排序”来判断预训练质量,不用等训练完再测。
主动学习:选“最需要标注”的数据(比如模型预测信心低的语音),目的是减少标注成本,针对的是全监督ASR模型,不是SSL的预训练。
SSL专属数据选择:选“和下游任务领域像”的数据(比如下游要处理电话语音,就选预训练里像电话语音的数据),但作者想找的是“通用的预训练数据特性”——不管下游任务是啥,选这类数据都能让模型效果好。
03、实验方法:具体怎么做的?
预训练用两种规模:“中量级”(2500小时)、“大量级”(25000小时);
微调ASR模型用“小量级”(250小时)——目的是看不同预训练数据,对最终ASR效果的影响。
全量基线(All):用所有预训练数据(比如中量级就用2500小时);
随机基线(Random):随机选50%的预训练数据(比如中量级选1250小时)。
声学特征:用13维MFCC,加上一阶、二阶导数,最后平均成39维向量;
说话人特征:用WeSpeaker模型+pyannote提取256维的speaker embedding(能区分不同说话人的特征);
语言特征:用SENSE模型(支持多语言、跨语音和文本的模型)提取1024维向量,代表语音的语义内容。
纯长度策略(Length):直接选所有语音里“最长的50%”;
说话人+长度策略(Speaker+Len):先按说话人特征聚类(和上面多样性的说话人聚类一样),再从每个聚类里选最长的语音,最后凑够50%——因为 preliminary实验发现,说话人多样性稍微有点用,所以把两者结合试试。
预训练框架:用BEST-RQ(效率高、效果好,还开源),模型是12层Conformer,隐藏层640维,8个注意力头,前馈网络2048维,总参数约100M;
硬件:NVIDIA A100 GPU,8张卡一起训;
Batch处理:动态批处理(把长度相近的语音放一起,每GPU的batch最大800秒,8张卡总共约1.77小时/Batch);
训练步数:所有模型都训20万步,用动态分块(dynamic chunking)模拟流式和非流式场景,最后测非流式ASR效果;
微调:ASR微调用SpeechBrain脚本,用前馈神经网络+CTC损失,词汇量是1024个BPE token;
统计可靠性:用1000次bootstrapping算95%置信区间,确保结果不是偶然的。
04、实验结果:最意外的是“长度比多样性重要”
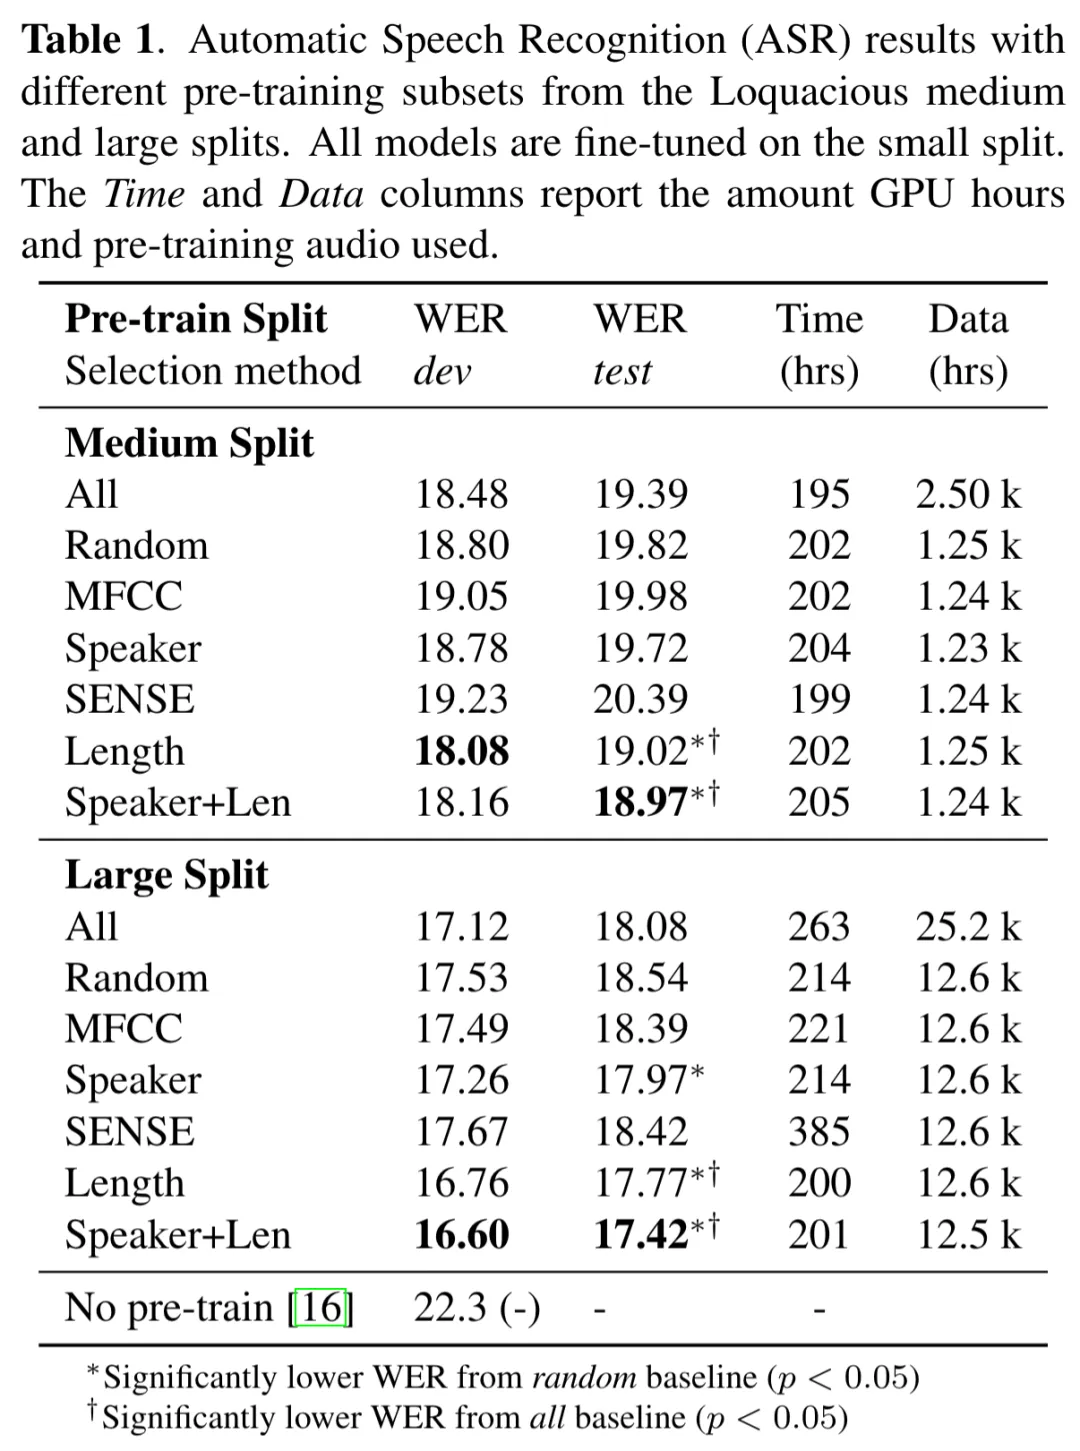
中量级数据集:比如声学策略(MFCC)的测试WER是19.98,比随机基线的19.82还高;说话人策略19.72,只比随机好一点点,但不显著; 大量级数据集:只有说话人策略的测试WER是17.97,比随机基线18.54显著好(p<0.05),但还是不如全量基线的18.08。
中量级:纯长度策略测试WER 19.02,比全量基线19.39低(p<0.05),比随机基线19.82低更多;说话人+长度18.97,比纯长度还略好一点; 大量级:纯长度策略17.77,比全量基线18.08低(p<0.05);说话人+长度17.42,是所有策略里最好的,比随机基线18.54低了1.12个点!
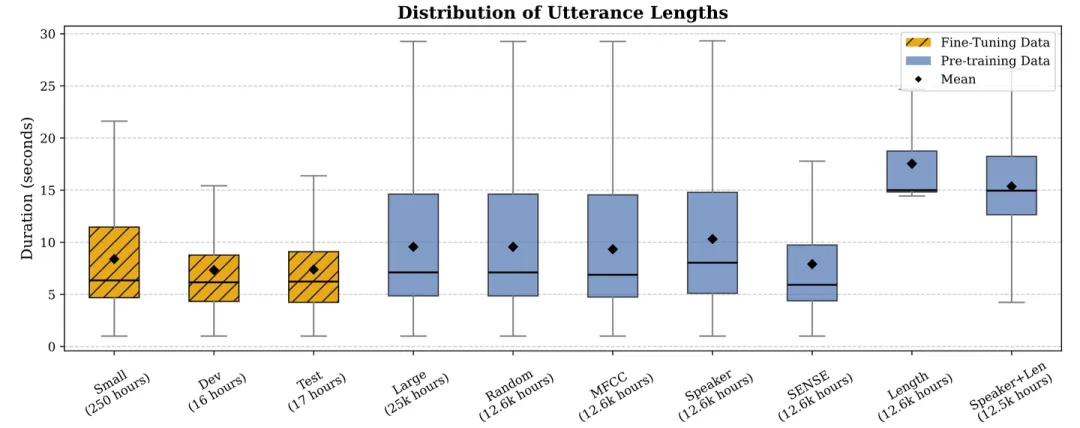
微调数据的语音长度大多在5-10秒; 而效果最好的两个预训练子集(Length和Speaker+Len),语音长度中位数约15秒,均值超15秒,和微调数据的分布差异最大; 其他子集(比如随机、MFCC、说话人)的语音长度都在5-10秒,和微调数据分布更近,但效果反而差。
05、讨论与结论:核心发现是“长度比规模、多样性更关键”
首次系统对比了“多样性”和“长度”两类无监督数据选择策略,发现之前被忽视的“语音长度”才是关键;
用50%的长语音数据,就超过了全量数据的效果,还把大量级预训练时间减少24%,既提性能又提效率;
打破“预训练数据要和微调数据分布匹配”的认知——长语音虽然分布差异大,但效果更好;
方法不用说话人标签,数据规模到2.5万小时,更贴近工业界实际场景,代码还开源了(最终定稿版本会给链接)。
