语音小管家
本期分享杭州电子科技大学智能语音课题组在信号处理领域顶级会议ICASSP 2026上录用的3篇论文,入选论文涵盖生成式语音增强、高保真神经音频压缩以及基于最优传输的无监督学习。作为IEEE主办的全球旗舰会议,ICASSP是语音与音频前沿技术的重要展示平台,这三项工作彰显了杭电智能语音课题组在语音信号处理领域的创新能力。
论文作者:张杨(23级本科生)、江文斌、汪振、吴开颖、张雯、文飞
论文单位:杭州电子科技大学,上海交通大学
作者邮箱:zhangyang77@hdu.edu.cn; wbjiang@hdu.edu.cn
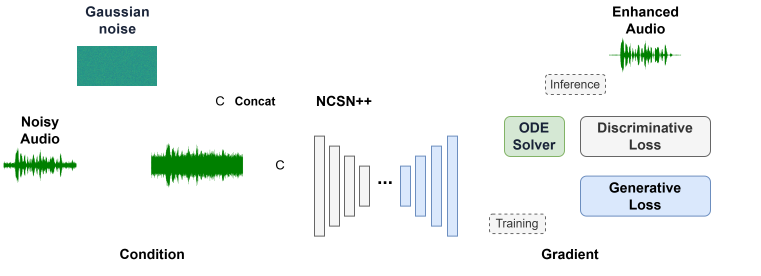
论文亮点:本文提出的HyFlowSE核心在于利用神经常微分方程(Neural ODE)的可微求解器特性,实现了生成与判别目标的端到端联合优化。该架构通过在条件流匹配语音增强过程中引入包含时域L1损失与频域多分辨率STFT损失的判别式目标,使得监督信号能够通过ODE求解器反向传播,直接指导生成过程。这种机制有效兼顾了效率与质量,仅需5.2 M参数与极少的函数评估次数(NFE=5),便在多个数据集评估中优于现有的参数量更大的生成式模型。
论文简介:生成式语音增强(SE)方法通常基于扩散模型或流匹配(Flow Matching)实现,在应对未见声学条件时展现出强大的泛化能力。然而,在匹配的域内场景中,其表现往往逊色于判别式方法。近期旨在缩小这一差距的尝试主要依赖于预训练的判别模型或级联多流架构,但这不仅增加了推理步骤,也提高了计算成本。
针对这一轻量级生成式模型在计算效率与语音增强性能之间的权衡难题,本文提出了一种基于混合生成-判别学习的端到端流匹配语音增强框架HyFlowSE。HyFlowSE以流匹配为骨干网络,利用神经常微分方程(Neural ODE)的可微求解器特性,实现了端到端的联合优化。模型不仅采用标准的条件流匹配损失来学习向量场,还引入了包含时域L1损失与频域多分辨率STFT损失的判别式目标,以提供更精细的监督信号。这种混合学习机制使得判别式目标能够通过ODE求解器反向传播,直接指导生成过程。在推理阶段,HyFlowSE保持了流匹配的高效性,仅需极少的函数评估次数(NFE=5)即可完成高质量语音生成,无需额外的后处理步骤。
在主流基准数据集上的实验表明,HyFlowSE仅需5.2 M参数,便在几乎所有评估指标上优于其他生成式SE方法,特别是在低信噪比条件下的性能提升尤为显著,为打破生成式语音增强领域中效率与性能之间的权衡提供了一条新路径。
Demo链接:https://zhangyang77.github.io/HyFlowSE/
论文作者:王相博(23级本科生),江文斌,王劲,尤禹博,方晟,文飞
论文单位:杭州电子科技大学,上海交通大学
作者邮箱:23200410@hdu.edu.cn; wbjiang@hdu.edu.cn
论文亮点:创新残差专家向量量化(REVQ)机制,双路径自适应量化架构解耦量化器选择与顺序;集成轻量级VBR策略,0.89-8 kbps宽比特率覆盖且额外开销极低;多阶判别器优化谱细节,核心指标全面超越主流模型。
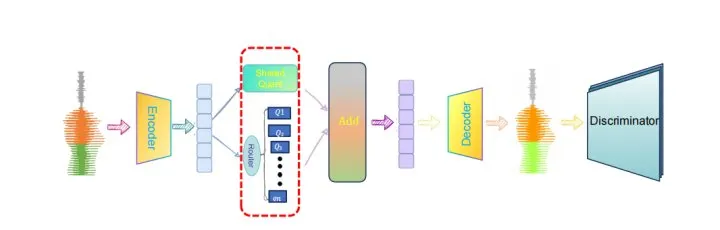
论文简介:本文针对低比特率约束下神经音频编码的嵌入空间受限问题,提出SwitchCodec高保真编解码框架,创新性引入残差专家向量量化(REVQ)机制,在极小带宽开销下实现嵌入空间的高效扩容,为复杂音频场景的率失真权衡提供全新解决方案。核心突破在于设计双路径自适应量化架构:共享基础量化器完成潜变量的粗粒度表征建模,REVQ模块通过门控路由网络,依据音频局部特征稀疏激活量化器池中的最优专家子集,实现残差信号的精细化逼近。该架构创新性地将量化器选择与应用顺序解耦,选中专家按固定索引顺序执行量化,既继承传统残差向量量化(RVQ)的能量递减层级特性,又通过负载均衡策略保障扩容嵌入空间的充分利用,显著提升训练稳定性与模型泛化能力。为适配多场景比特率需求,框架集成轻量级可变比特率(VBR)后训练策略,无需重构模型,仅通过动态调整激活专家数量,即可实现0.89-8 kbps的宽范围比特率覆盖,路由掩码额外开销占比低于总比特率的0.1%。同时,采用多阶判别器设计,通过周期性分层STFT谱建模,引导生成器同步优化音频全局结构与细粒度细节,有效降低谱模糊效应。实验验证显示,在2.67 kbps与5.33 kbps比特率、44.1 kHz带宽条件下,该方案的Mel谱距离较主流模型降低13%,PESQ与ViSQOL指标分别达到2.87与4.04,主观MUSHRA评分高达91.7-93.4,全面超越EnCodec、DAC等基准模型。
论文链接:https://arxiv.org/abs/2601.20362
Demo链接:https://raconiy.github.io/Switchcodec/index.html
论文作者:文飞,王伟,颜泽宇,江文斌【论文单位】上海交通大学,杭州电子科技大学
作者邮箱:wenfei@sjtu.edu.cn; wbjiang@hdu.edu.cn
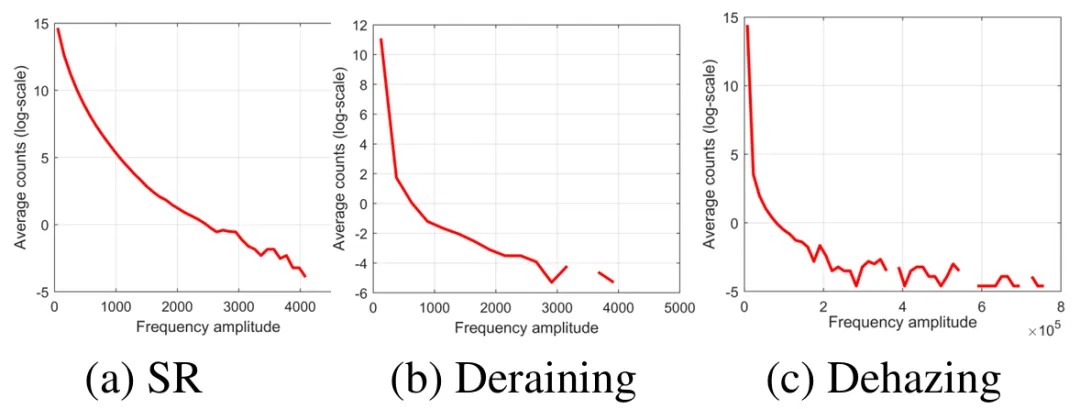
论文亮点:提出稀疏感知最优传输(SOT)通用框架,发现三类任务退化的频域强稀疏性,融入ℓ_q 范数优化传输准则;无需配对数据,仅无监督训练即可在超分辨率、去雨、去雾任务中媲美有监督模型,关键指标表现优异。
论文简介:无监督图像恢复任务长期面临退化逆映射模糊、有监督方法依赖配对数据的痛点,本文创新性提出稀疏感知最优传输(SOT)框架,为超分辨率、去雨、去雾三大核心任务提供通用解决方案。
核心突破在于发现关键先验:三类任务的退化在频域具备强稀疏性。基于此,框架将ℓ_q范数(0≤q≤1)融入最优传输准则,通过稀疏性促进机制降低恢复歧义,同时保留恢复图像与自然干净图像的分布对齐约束,实现感知质量与失真度的精准平衡。
模型训练基于WGAN-GP架构与MPRNet生成器,无需任何退化-干净配对数据,仅通过无监督方式即可完成训练。实验验证显示,在真实场景数据集上,SOT表现惊艳:超分辨率任务PSNR达23.89 dB;去雨任务PSNR高达44.37 dB,超越多数有监督方法;去雾任务LPIPS低至0.1451,感知质量领先。作为首个在三类任务中均能媲美有监督模型的通用无监督方案,该框架为低级别视觉恢复提供了高效新范式。