想象这样一个场景:你使用声纹锁保护隐私,攻击者在旁边播放了一段看似普通的陌生人录音(比如一段新闻或别人的谈话)。人耳听不出异样,声纹锁却被“欺骗”并打开了——这就是物理信道(OTA)对抗攻击。 以往,空气中的噪音和回声是天然的屏障,会让这种攻击失效。但我们提出了一种神经模拟器 (NRS),成功让对抗攻击样本克服了空气传播带来的扰动,验证了这种安全隐患的真实存在。为了防御这种威胁,我们进一步设计了CODA-OCC 检测器,它不需要预知攻击手段,通过识别“什么是真声”,有效拦截环境中的各种未知攻击。自动声纹识别(ASV)已经走进了我们的生活,从微信声音锁到银行身份验证。但是,这也带来了一个安全疑问:如果有人用一段经过伪装的声音去骗机器,能成功吗?在电脑模拟的数字世界里,这种“对抗攻击”很容易成功。但在真实的物理世界中(比如通过音箱播放攻击声音),事情变得很不一样:物理环境的阻隔:声音在空气中传播时,会受到环境噪音、房间回声、距离衰减的影响。这些物理因素就像“过滤器”,往往会破坏掉攻击代码,让攻击失效。防御的盲区:现有的防御系统往往需要“见过”攻击样本才能拦截。但在现实中,攻击方式千变万化,防御者很难提前预知。为了提升声纹系统在真实物理环境下的安全性,我们完成了以下工作:验证威胁 (NRS):我们开发了一个“环境模拟器”,让攻击样本学会适应空气传播的干扰,证明了在物理环境下,声纹锁依然可能被攻破。提供数据 (AdvSV 2.0):我们开源了大规模的物理场景攻击数据集,涵盖多种设备和环境,为行业研究提供弹药。构建防御 (CODA-OCC):我们设计了一种通用的防御模型,它专注于学习真实人声的本质,从而有效抵御未知的物理攻击。
「核心技术:从验证安全隐患到通用防御」
1️⃣ NRS:神经重放模拟器 (Neural Replay Simulator)
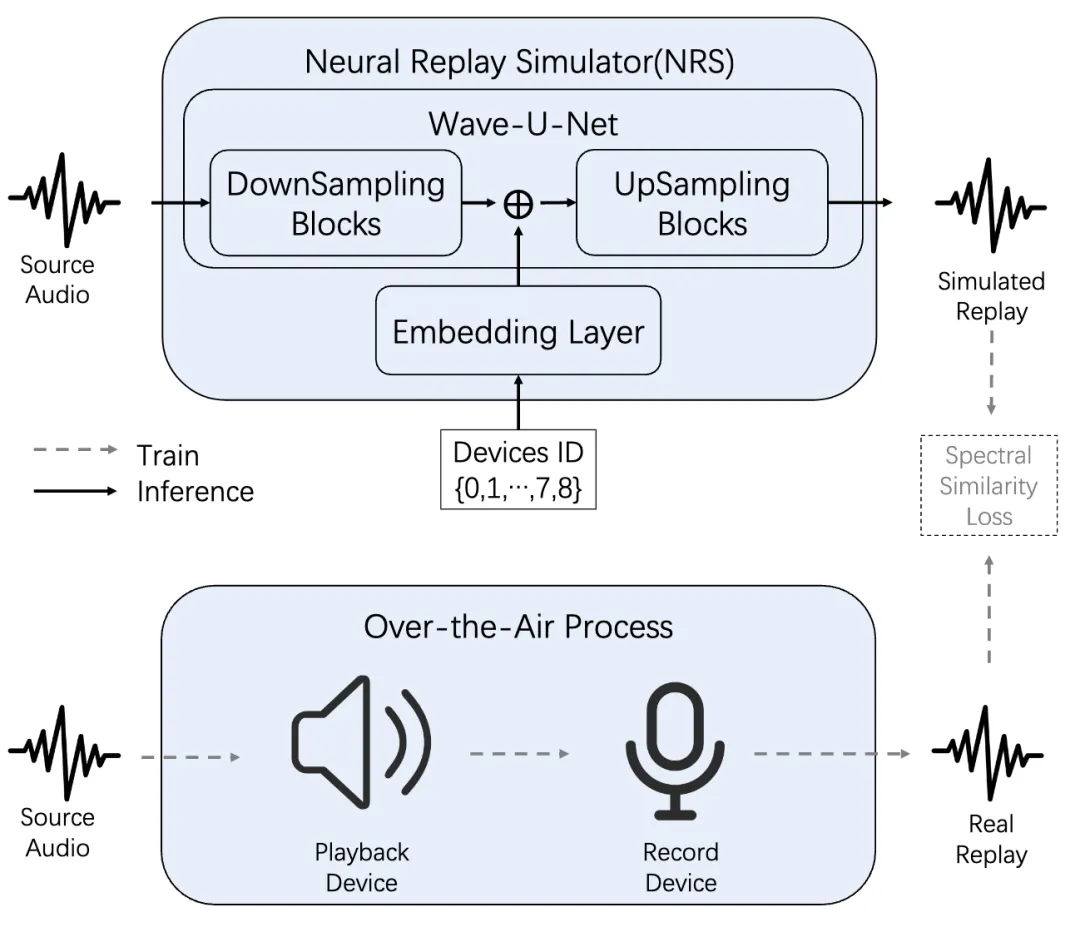
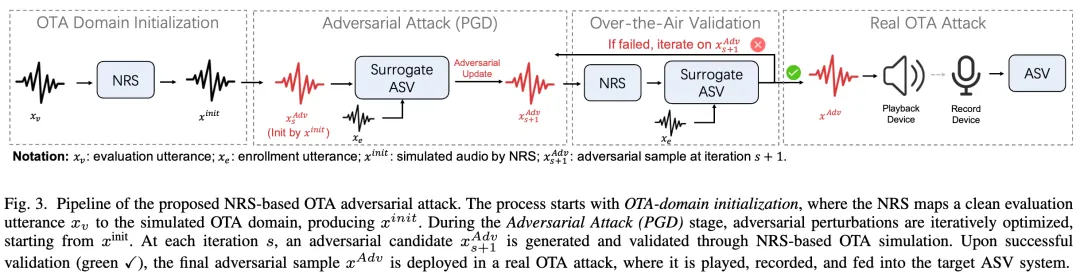
在真实场景中,从扬声器发出的声音到达麦克风时,已经发生了变形。为了研究这种影响,我们提出了NRS (Neural Replay Simulator)。模拟真实传输:它能精准模拟声音在不同扬声器播放、经过空气传播、再被麦克风录制的全过程。适应性训练:我们将这个模拟器嵌入到算法中。攻击样本在生成过程中,就在这个“虚拟实验室”里反复演练,学会了如何在噪音和回声中保持攻击力。结果:经过 NRS 优化的声音,即使通过普通的音箱播放,也能穿透空气干扰,欺骗声纹系统。2️⃣ AdvSV 2.0 开源数据集
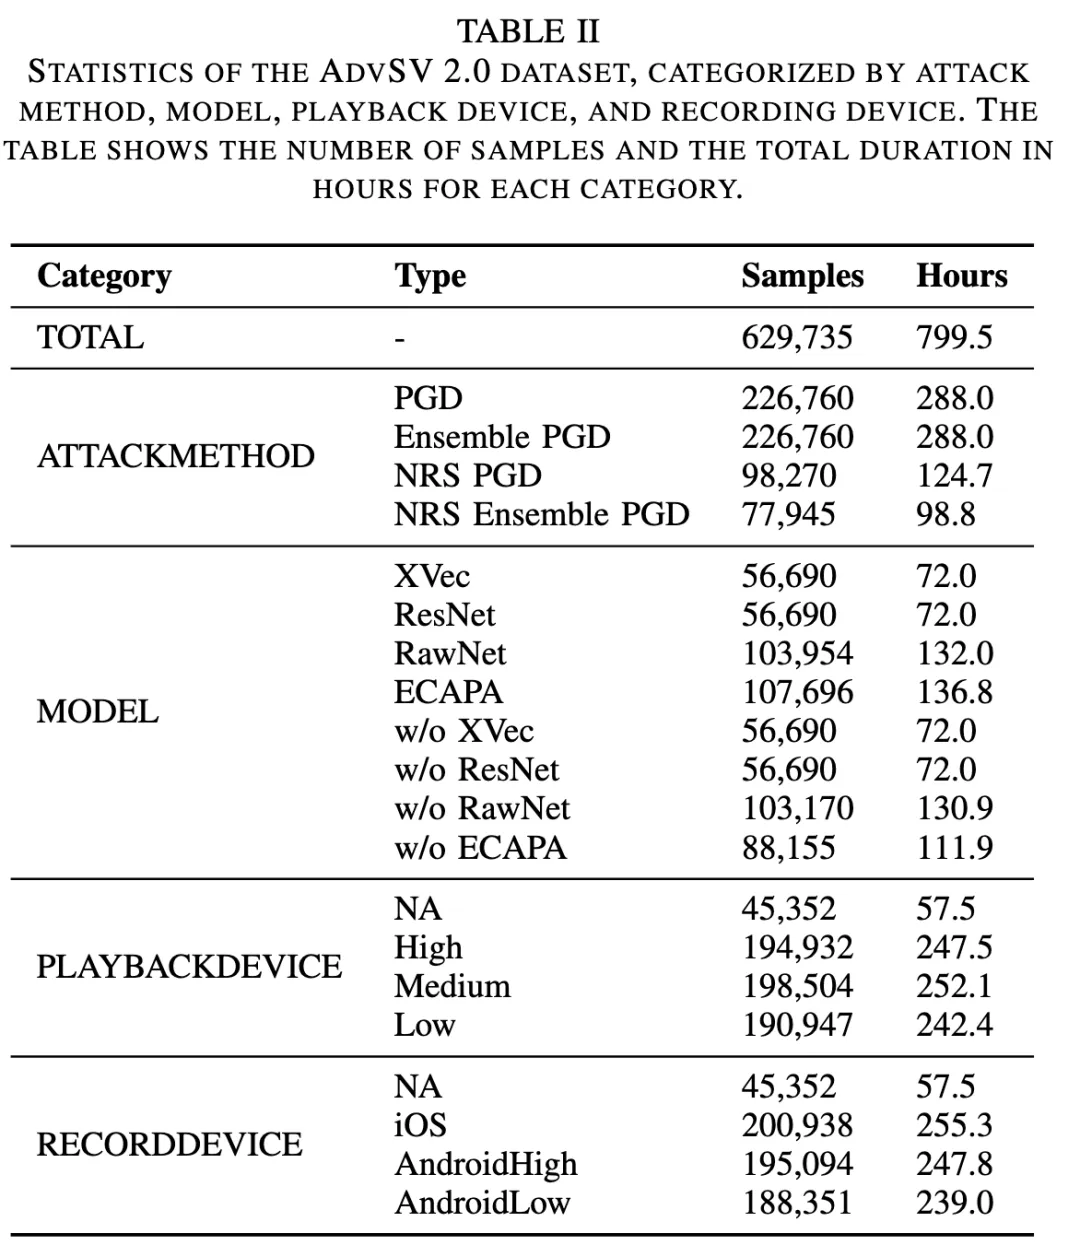
为了让研究者们都能研究物理环境下的声纹安全,我们开源了AdvSV 2.0 数据集规模大:包含 62.8 万条语音数据(约800小时)。场景真:不仅包含数字生成的样本,我们还利用 NRS 技术,以及在真实的房间里,使用多种高低端设备(如 iPhone、安卓手机、专业音响)进行了实际的播放和录制。这是目前最接近真实物理环境的公开数据集。3️⃣ CODA-OCC:对比域对齐单类分类器
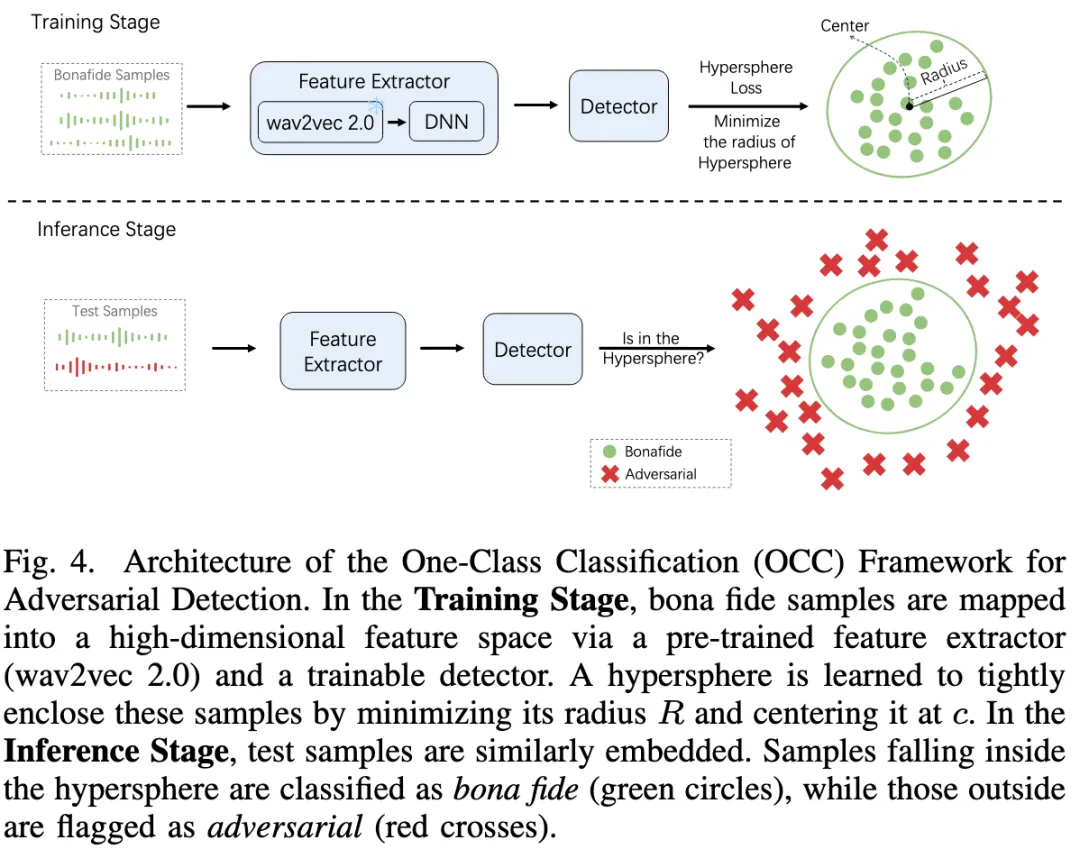
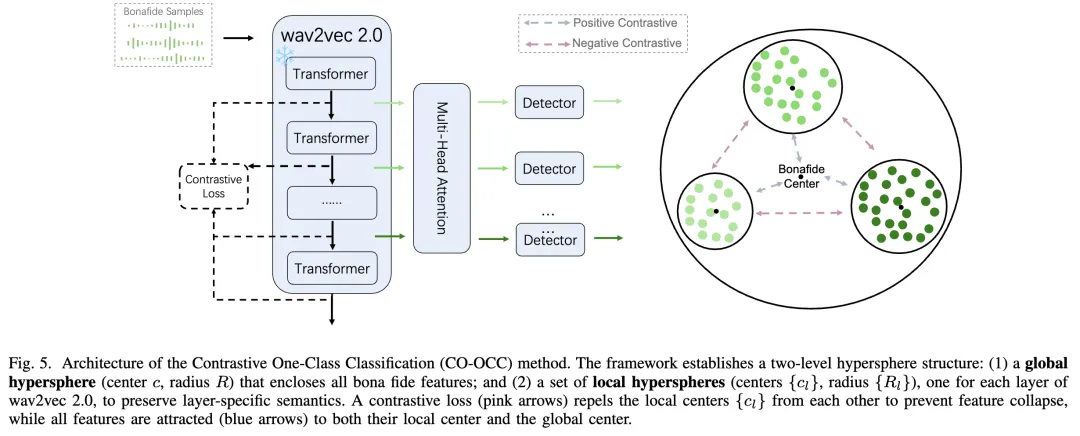
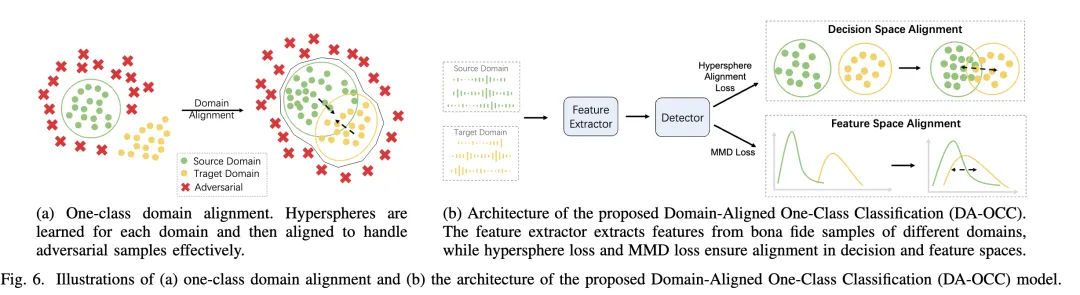
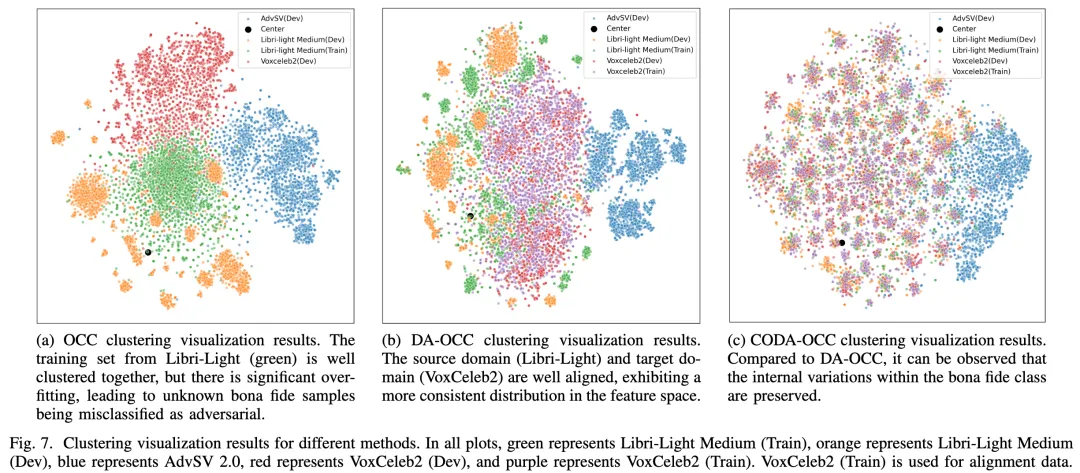
研究攻击是为了更好的防御。面对层出不穷的伪装声音,防御系统不可能把所有攻击方式都存入黑名单。因此,我们转变思路,提出了CODA-OCC。它的核心逻辑是:只要不符合“真实人声”标准的,一律拦截。单类分类 (One-Class Classification):不同于二分类,我们只对“真实语音(Bona Fide)”建模。任何落在真实语音分布超球体之外的样本(无论是何种 OTA 对抗攻击)都被判定为异常。对比学习 (Contrastive Learning):为了防止单类分类器在训练深度网络时出现“特征坍塌”(即所有样本被映射到同一个点,丢失语义信息),我们引入了对比学习机制。通过设计“全局+局部”的多层超球体结构,利用对比损失强制不同层的特征中心相互分离。这确保了模型不仅能聚类真实语音,还能保留语音内部丰富的层次化语义信息,从而更敏锐地捕捉对抗扰动带来的细微异常。域对齐 (Domain Alignment):针对物理世界中录音设备和环境多样化带来的挑战,我们采用了域对齐策略。由于不同麦克风录制的真实语音存在“域偏差(Domain Shift)”,容易被误判为攻击。CODA-OCC 通过对齐源域(训练数据)和目标域(物理录制数据)的特征分布与决策边界,使模型能够忽略正常的物理信道差异,专注于检测真正的对抗攻击行为,从而降低误报率。「威胁验证:NRS 让物理攻击成为可能」
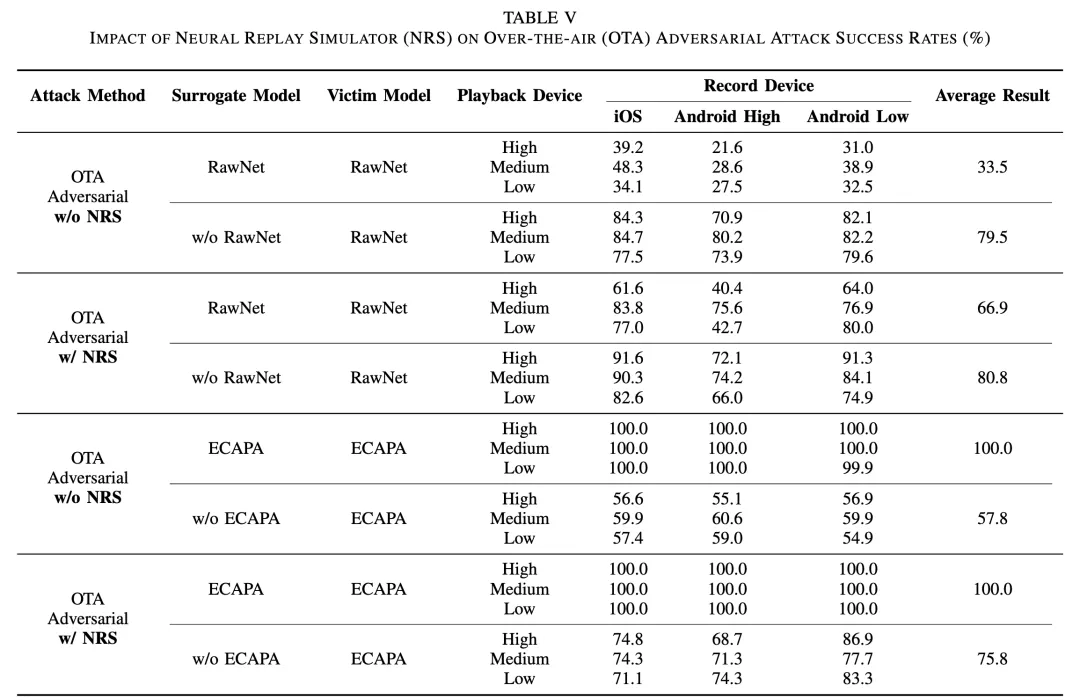
实验数据表明,在不使用我们技术的情况下,针对 RawNet 模型的物理播放攻击成功率仅为 33.5%。而引入 NRS 模拟器后,攻击成功率提升到了66.9%。这33.4%的绝对提升证实了:物理环境并不是绝对的安全屏障,经过优化的攻击手段完全可以跨越空气阻隔。「防御验证:误报率大幅降低」
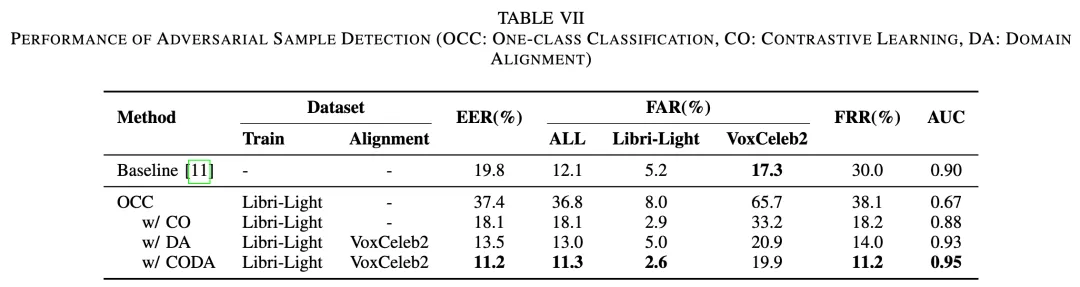
显著降低错误率:CODA-OCC 实现了11.2% 的等误差率(EER)。相比于主流的基线方法(EER 为 19.8%),我们的方法将错误率降低了 8.6 个百分点(相对降低约 43%)。可视化分析:CODA-OCC 成功地将真实语音聚类,并将各种未知的OTA对抗样本排斥在分布之外。「 结 论 」
本工作通过模拟真实的物理声学环境,揭示了声纹识别系统在现实应用中可能面临的安全风险(NRS & AdvSV 2.0);同时,我们提出了一种不依赖先验知识的通用防御框架(CODA-OCC),证明了通过学习真实语音的本质特征,可以在复杂的物理环境中构建起有效的安全防线。

 语音小管家