
 语音小管家
标题:Eureka-Audio: Triggering Audio Intelligence in Compact Language Models
链接:https://arxiv.org/pdf/2602.13954
发表日期:2026年2月15日
作者单位:百度
01、研究背景与待解决的核心问题
高性能的音频模型基本都是大参数量的(7B及以上),推理延迟高、计算成本大,根本没法在实时场景或手机、边缘设备这类资源受限的平台部署; 轻量级音频模型的性能又普遍拉胯,核心原因有三个:一是音频本身具有异构性,语音、环境音、音乐的特征完全不同,简单的跨模态投影会引发优化冲突;二是轻量模型的表征能力有限,语义信息和副语言线索会争抢有限的模型容量,导致参数效率低、泛化性差;三是高质量的音频指令数据特别稀缺,模型后训练时容易出现性能不稳定、效果下滑的问题。
02、核心创新点
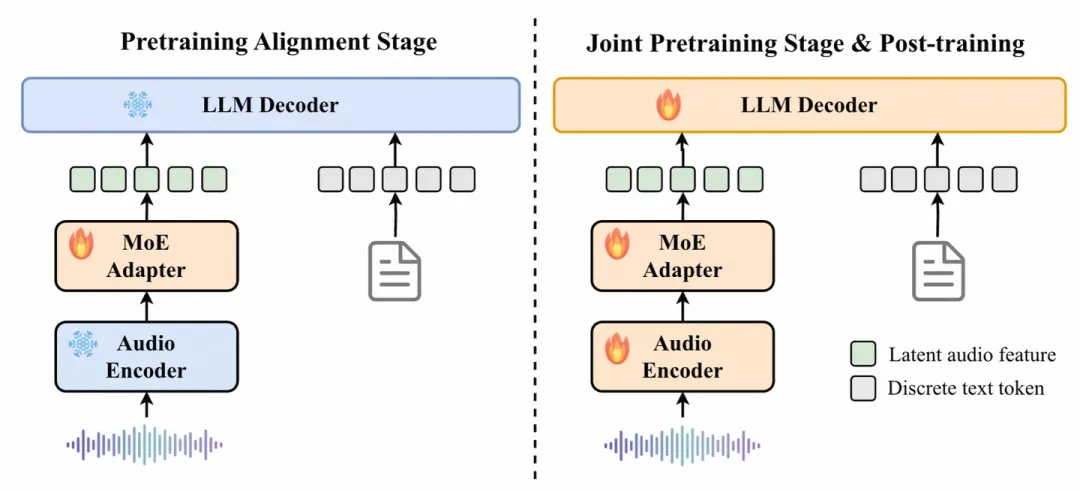
Whisper-based音频编码器:把原始的音频波形转换成高时间分辨率的声学特征,能捕捉到音频里细粒度的感知和语义信息;
稀疏MoE Adapter:这是跨模态对齐的核心桥梁,没有用传统的稠密投影层,而是用稀疏专家路由的方式,让不同类型的音频特征匹配对应的“专家网络”处理,既解决了音频的异构问题,又在有限参数量下提升了表征效率;同时为了避免“专家坍缩”(部分专家被频繁调用,部分闲置),还加入了负载平衡辅助损失,让专家的调用更均衡;
Qwen3-1.7B语言主干模型:作为轻量级的语言模型基础,将经过MoE适配器对齐后的音频embedding和文本token的embedding拼接,用自回归的方式联合建模,支撑各类音频理解下游任务。
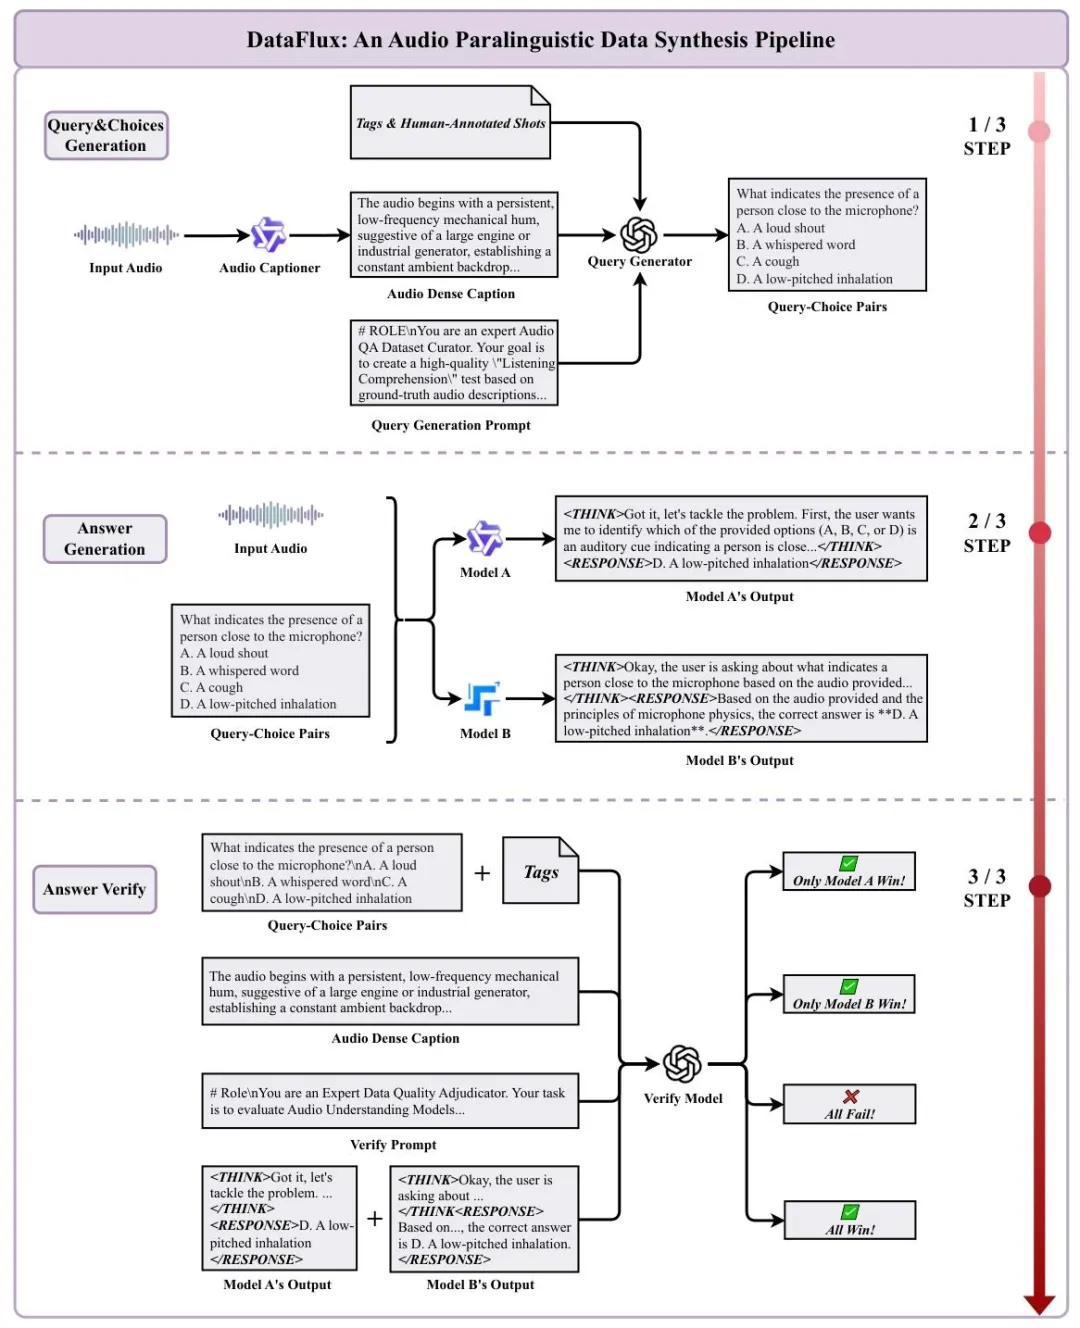
第一步:先通过音频描述模型生成原始音频的详细描述,再结合预定义的副语言分类体系,把描述转换成结构化的问答选择题(Query-Choice),将无结构的音频信号映射到适合模型训练的离散指令空间; 第二步:把音频和问答选择题输入多个不同的音频大模型,让它们生成推理过程和最终答案,利用不同模型的推理特性增加答案多样性,为后续硬样本挖掘做准备; 第三步:用裁判模型对多模型的输出做自动化评估,从逻辑一致性、细节覆盖度、和音频描述的语义匹配度三个维度判断,保留高质量样本,过滤掉有冲突、推理失败的噪声样本,减少后训练的噪声干扰。
预训练分对齐阶段和联合预训练阶段:先冻结音频编码器和语言主干,只训练MoE适配器,让模型先建立稳定的音-文跨模态对齐;再解冻所有参数联合训练,加入音频描述数据,让模型学习更丰富的音频语义和副语言线索; SFT后训练:用开源数据+自研数据+DataFlux生成的高质量数据做微调,全程保持文本和音频数据1:1采样,总训练量30B token,进一步提升模型的指令跟随和副语言推理能力。
03、训练过程
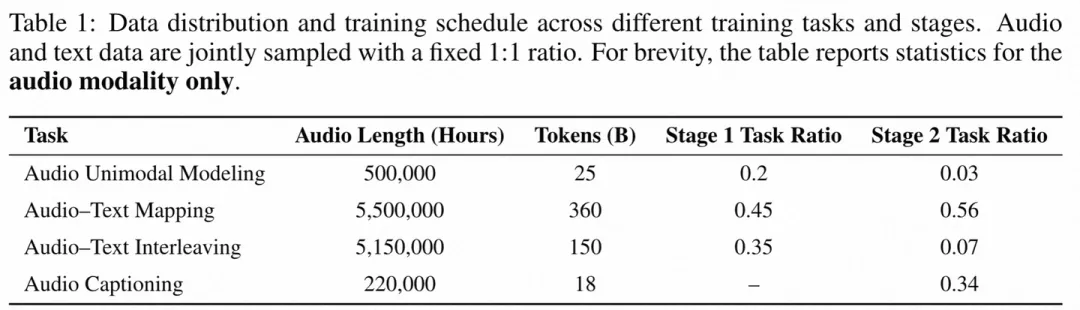
阶段1(对齐阶段):仅训练MoE适配器,音频编码器和Qwen3-1.7B语言主干参数冻结,训练数据约100B token,包含三类任务:音频单模态建模(50万小时,占比0.2)、音-文映射(550万小时,占比0.45,核心是ASR、TTS这类直接的跨模态对应任务)、音-文交错建模(515万小时,占比0.35),核心目标是让MoE适配器学会将声学特征映射到语言模型的embedding空间,建立稳定的跨模态对齐;
阶段2(联合预训练阶段):解冻所有模型参数联合优化,训练数据扩容到约1T token,在阶段1的三类任务基础上,新增音频描述数据(22万小时,占比0.34),其他任务的占比相应调整,核心目标是让模型学习高层的音频语义信息和副语言线索,提升整体的音频理解能力。
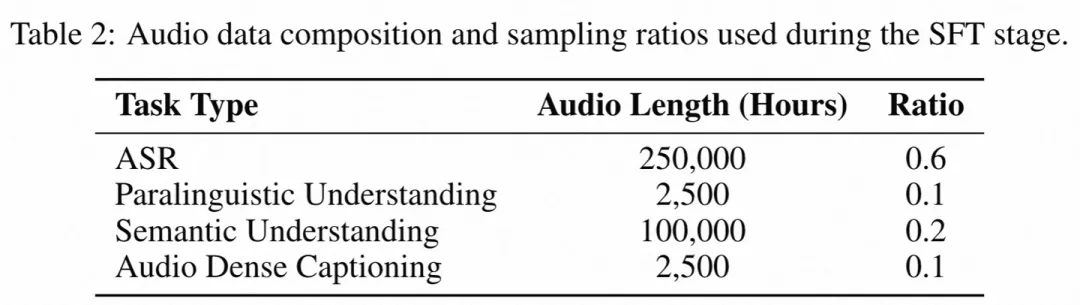
ASR任务占比最高(25万小时,0.6),保证模型的基础语音识别能力;
语义理解(10万小时,0.2)、副语言理解(2500小时,0.1)、音频稠密描述(2500小时,0.1)占比均衡,兼顾模型的多维度音频理解能力;
04、实验结果与核心图表分析
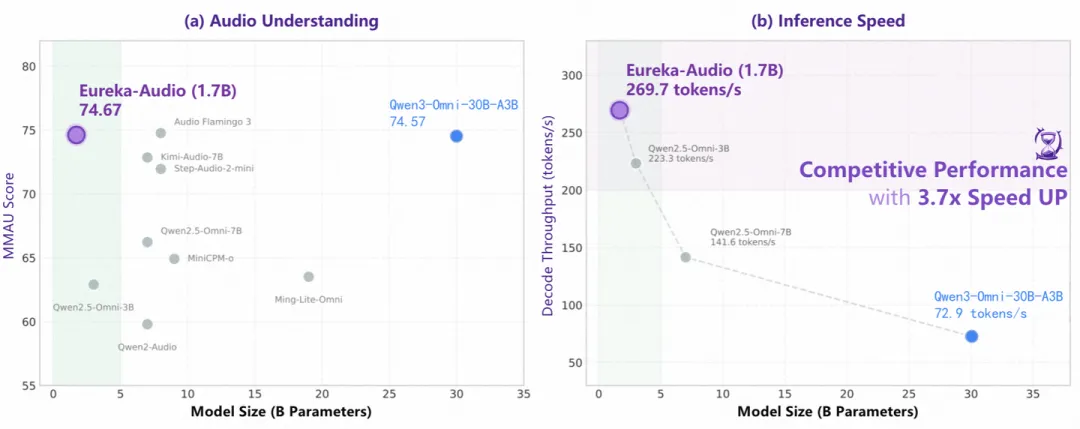
图a:MMAU基准得分(音频理解核心指标,分数越高越好),Eureka-Audio(1.7B)得74.67,和参数量是它17倍的Qwen3-Omni-30B-A3B(74.57)持平,完胜其他7B~8B级的音频模型,证明其音频理解能力能和大模型抗衡;
图b:推理解码速度(tokens/s,数值越高越快),Eureka-Audio达到269.7 tokens/s,而Qwen3-Omni-30B-A3B仅72.9 tokens/s,推理速度提升了3.7倍,是所有对比模型中速度最快的。
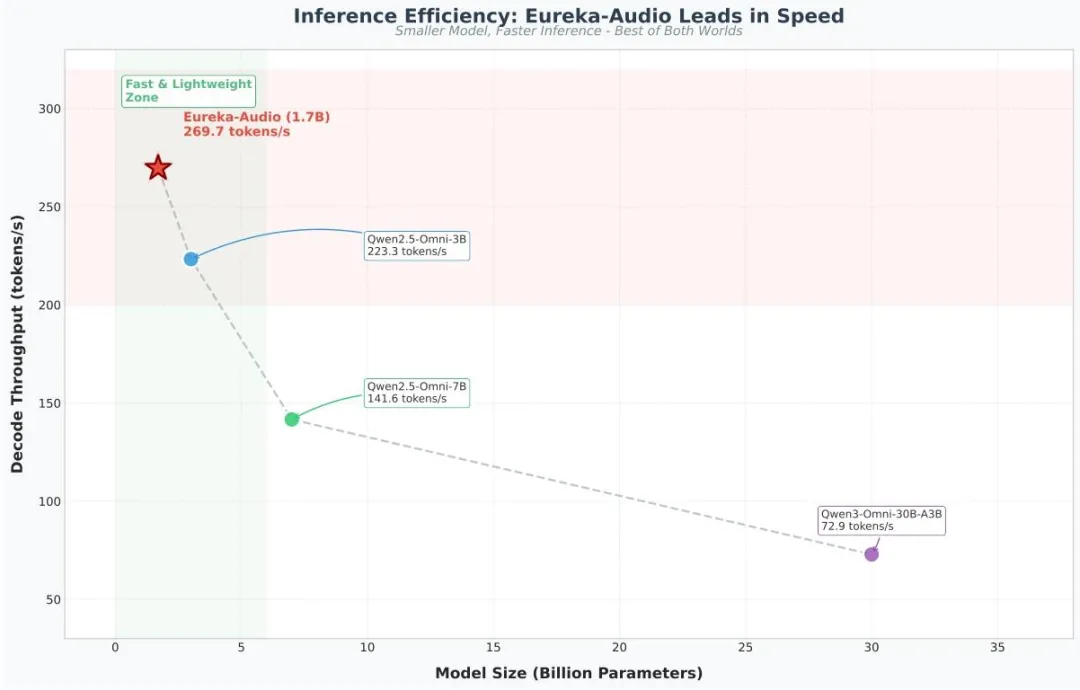
Eureka-Audio(1.7B)以最小的参数量,实现了最高的解码吞吐量(269.7 tokens/s);
对比同类型轻量模型,比3B的Qwen2.5-Omni(223.3 tokens/s)快1.2倍,比7B的Qwen2.5-Omni(141.6 tokens/s)快1.9倍;
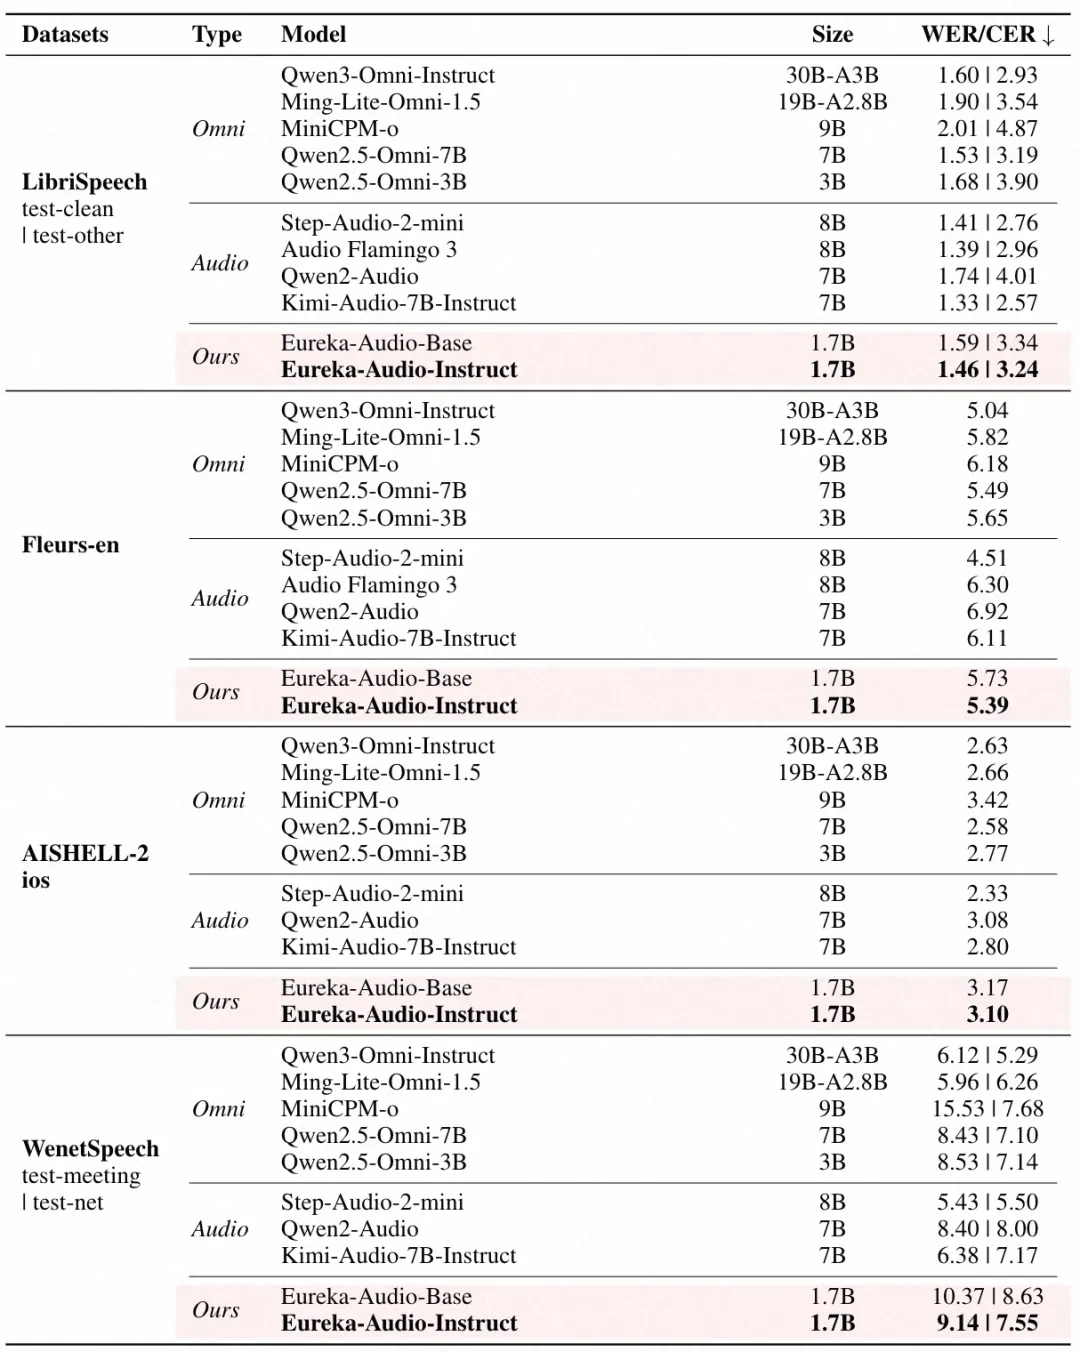
尽管Eureka-Audio只有1.7B参数量,但在所有ASR基准上,错误率都低于Qwen2.5-Omni、MiniCPM-o等参数量更大的多模态/音频模型;
比如在英文LibriSpeech、Fleurs基准上,其错误率显著低于3B的Qwen2.5-Omni,在中文AISHELL、WenetSpeech基准上,也优于多款7B~8B级的音频模型;
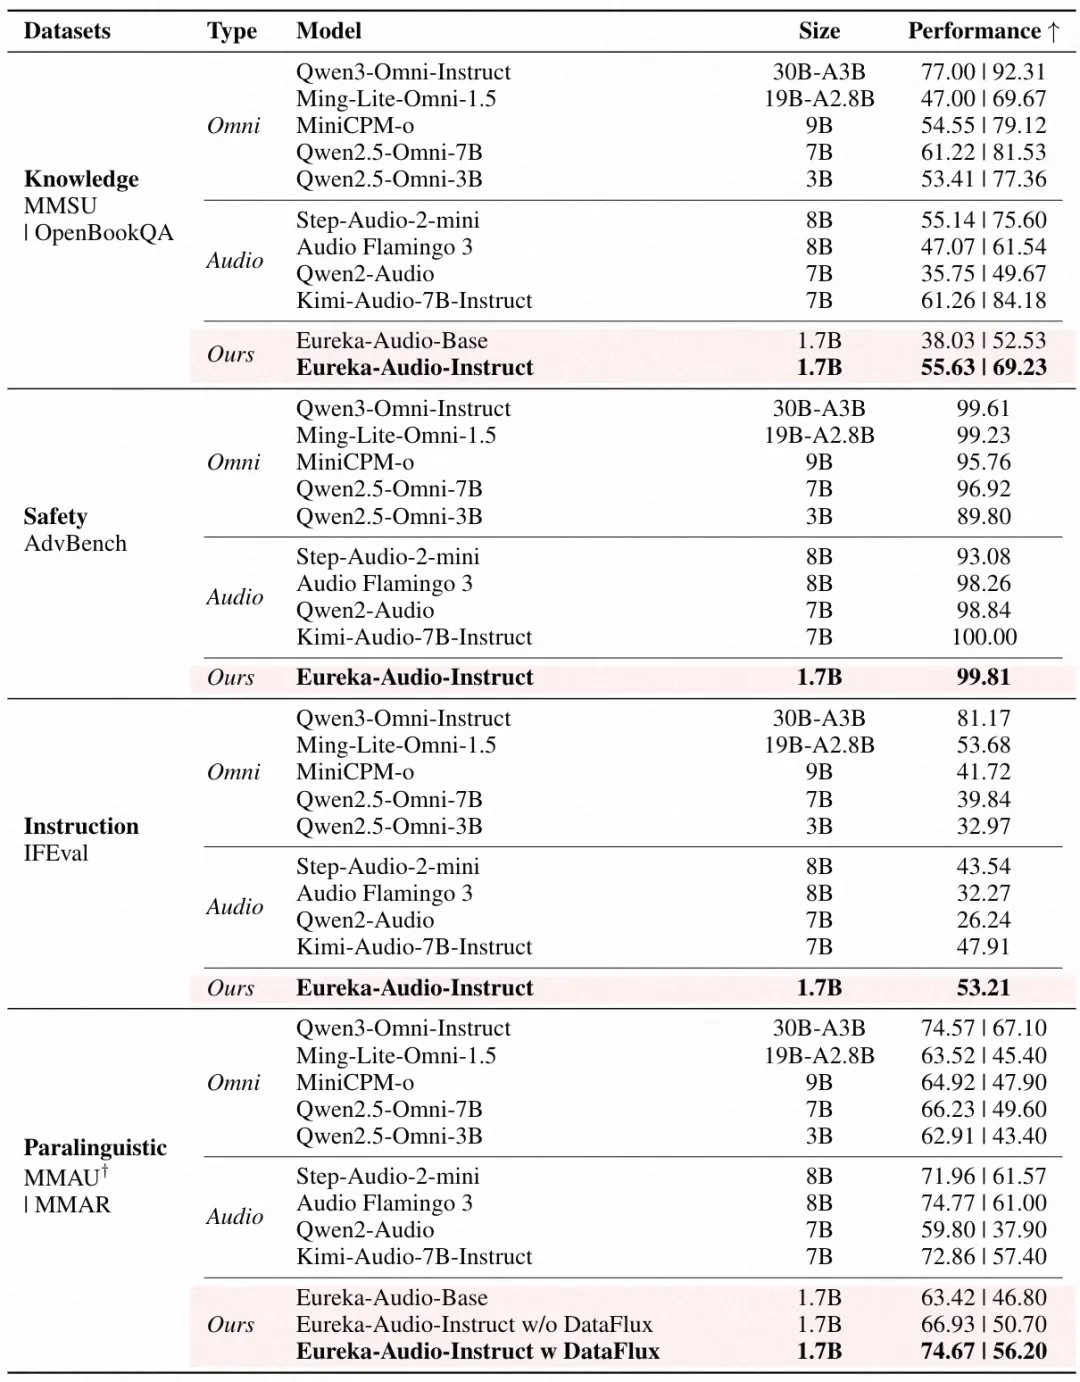
知识推理(MMSU):Eureka-Audio-Instruct得55.63,略超8B的Step-Audio-2-mini(55.14),虽不如30B的Qwen3-Omni-Instruct,但在1.7B参数量下能达到这个分数,已属优秀;
安全基准(AdvBench):得分99.81,接近满分,远超同量级模型,甚至媲美专门做了安全优化的大模型,说明模型的安全鲁棒性拉满;
指令跟随(IFEval):得分53.21,不仅远超所有同量级模型,还比7B的Kimi-Audio-7B-Instruct(47.91)更高,证明其指令跟随能力突出;
副语言理解(MMAU/MMAR):这是最亮眼的维度,带DataFlux的Eureka-Audio-Instruct在MMAU上得74.67,超过了30B的Qwen3-Omni-Instruct(74.57);同时消融实验显示,没用DataFlux的版本仅得66.93,两者差距巨大,直接证明DataFlux数据合成管道对提升副语言理解能力的关键作用。
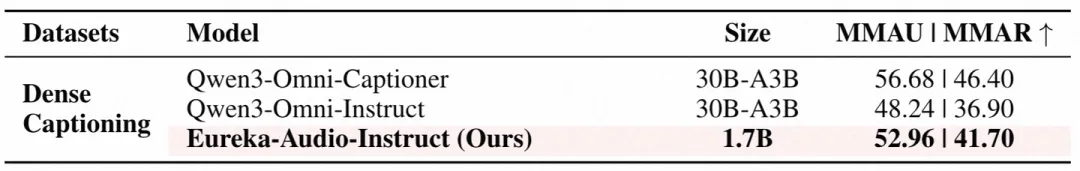
Eureka-Audio-Instruct(1.7B)在MMAU得52.96、MMAR得41.70,远超30B的Qwen3-Omni-Instruct(48.2/36.90);
同时其性能接近专门做了音频描述优化的Qwen3-Omni-Captioner模型(30B参数,56.68/46.40);
Eureka-Audio能精准还原音频里的对话细节、说话人的语气(如“夸张的无奈”“平淡的死腔回应”),还能准确识别音频中无背景噪音、无观众笑声等客观信息,描述完全忠实于原始音频; 而Qwen3-Omni-30B系列模型要么脑补剧情(比如直接说这是《老友记》某季某集的内容),要么添加不存在的背景音(比如健身房器械声、观众笑声),描述的忠实度远不如Eureka-Audio。
05、论文总结与未来研究方向
性能上,在ASR、音频语义/副语言理解、音频稠密描述等所有维度,都能媲美甚至超过7B~30B级的音频/多模态大模型,尤其是副语言理解能力超越了30B的Qwen3-Omni-Instruct;
效率上,推理解码速度达到269.7 tokens/s,是30B级Qwen3-Omni-A3B的3.7倍,能适配手机、边缘设备等资源受限平台的部署;
更重要的是,这一成果证明模型参数量的堆砌并不是提升音频智能的唯一路径,通过合理的架构设计(稀疏MoE适配器)、高质量的指令数据合成(DataFlux)、科学的分阶段训练策略,轻量级模型也能实现高性能的通用音频理解。
把Eureka-Audio从“音频理解”拓展到统一音频生成,研发轻量级、低延迟的音频生成机制;
支持流式,让模型支持实时的音频对话交互,适配智能助手等实时场景;
将音频的“感知”和“生成”能力更紧密地整合到一个紧凑模型中,进一步缩小轻量级模型和大模型的能力差距,让音频智能更贴近实际产业需求。
