首页
声浪
活动
AI科普
学堂
SOTA
分享
热聘
会员服务
登录
注册
中国科研团队开发DBMIF框架实现骨导与气导语音的智能融合
语音小管家
2026-03-11
阅读 18
转载
语音增强
0
0
分享
来源丨21db声学人
在极低信噪比环境下,传统语音增强系统性能急剧下降,气导麦克风常被环境噪音淹没。近日,来自军事科学院国防科技创新研究院、中国科学院声学研究所和计算技术研究所的研究团队提出了一种名为深度平衡多模态迭代融合框架(DBMIF)的创新解决方案,成功实现了骨导与气导语音的智能融合,在极端噪音条件下仍能重建高保真语音。相关研究成果已在arXiv平台发表。
气导麦克风捕捉通过空气传播的语音,包含丰富的高频细节,使语音听起来自然清晰。然而,在强噪音环境中,目标语音极易被环境噪音掩盖。相比之下,骨导传感器通过捕捉颅骨振动来获取语音,天然具有抗噪优势——即使在极嘈杂环境中,骨导传感器仍能稳定捕捉语音信号。但骨导语音存在明显的高频衰减(约1kHz以上),导致语音听起来沉闷、不自然,且存在由传播路径和传感器-皮肤接触引起的频谱失真。
如何将这两种互补但各有缺陷的传感器信号智能融合,成为语音增强领域的一大挑战。
DBMIF:三项创新机制实现平衡融合
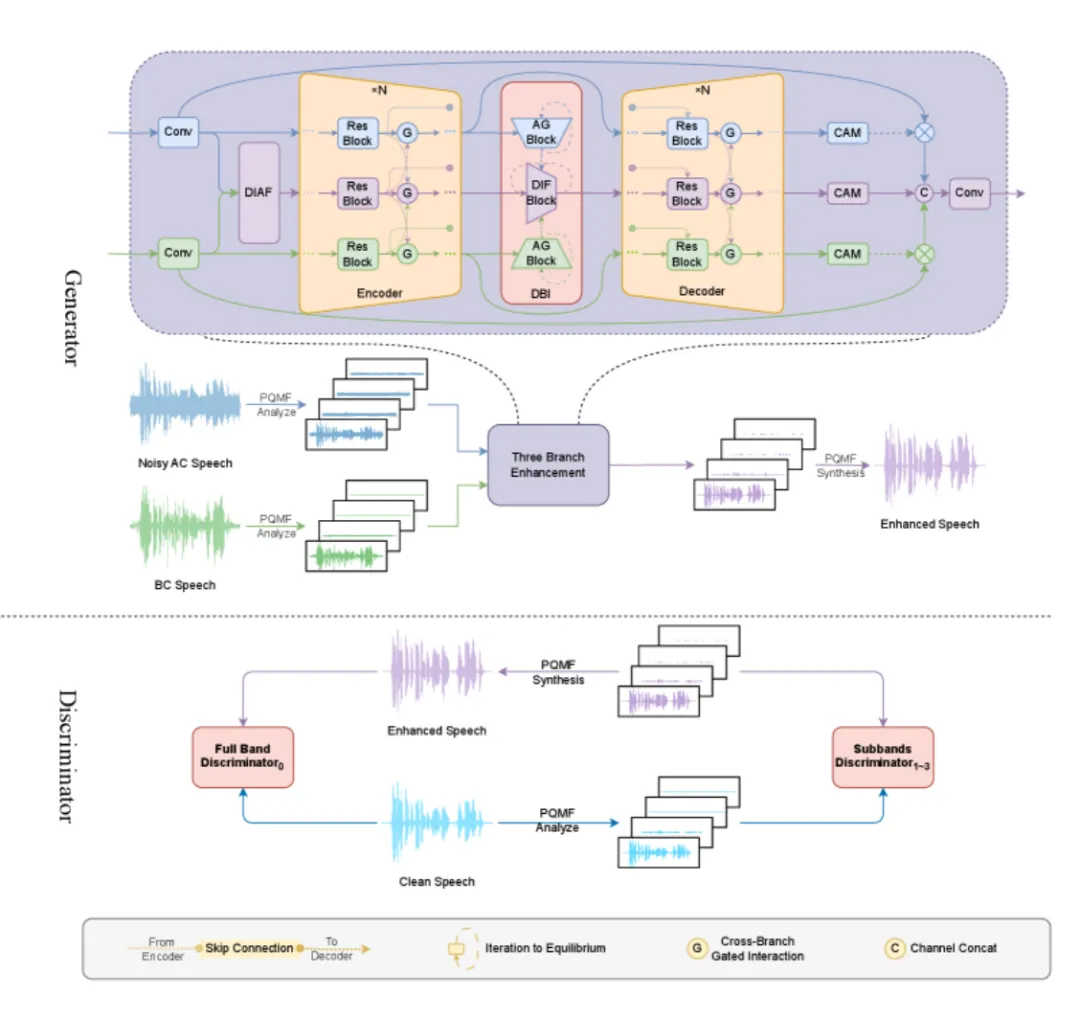
图1展示DBMIF的整体架构,包括生成器(处理核心增强任务)和多尺度判别器(评估语音质量)两大组件。生成器包含PQMF分析/合成滤波器组和多分支编码器-解码器网络,判别器则包含全带和子带两个分支。
研究团队提出的DBMIF框架整体包含
生成器(Generator)和多尺度判别器(Discriminator)
两大核心组件,其中生成器采用
三分支多尺度交互式编解码器架构
,分别处理气导、骨导信号及融合分支,并在该架构基础上设计了三个核心创新模块,实现骨导与气导语音的动态平衡融合:
1.早期深
度迭代
注意力融合模块
(DIAF)
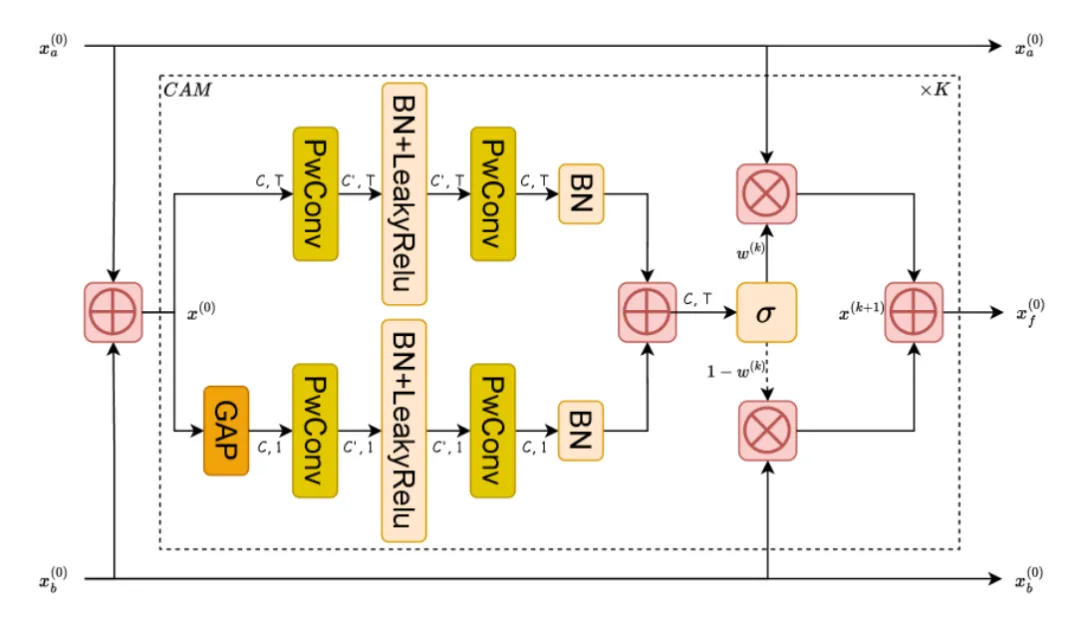
图2 早期DIAF模块示意图。展示深度迭代注意力融合模块的工作流程。通过K次迭代(论文中K=3),通道注意力模块根据当前融合状态生成注意力掩码,动态平衡气导和骨导模态的贡献。
该模块通过迭代通道注意力机制,为后续处理提供更干净、稳定的输入,动态平衡两种模态的贡献。实验表明,DIAF 能根据信噪比智能调整融合权重:在极低信噪比环境下(-15dB),模型优先依赖抗噪性更强的骨导信号;随着信噪比提升,注意力逐渐向保留高频细节的气导信号转移。
这种适应具有频率和子带依赖性—— 基于 PQMF 子带分解的低频区域(通道 1)始终保持较低的权重,表明模型将基音信息更多地锚定在更鲁棒的骨导模态上;高频区域(通道 3 和 4)则依赖气导特征补偿骨导带宽限制;中频区域(通道 2)则作为动态平衡区,根据瞬时噪音水平灵活调整模态权重。论文中 DIAF 的迭代次数设置为 3 次,在融合质量和计算成本间实现了鲁棒平衡。
2.跨分支门控交互模块
(CBGI)
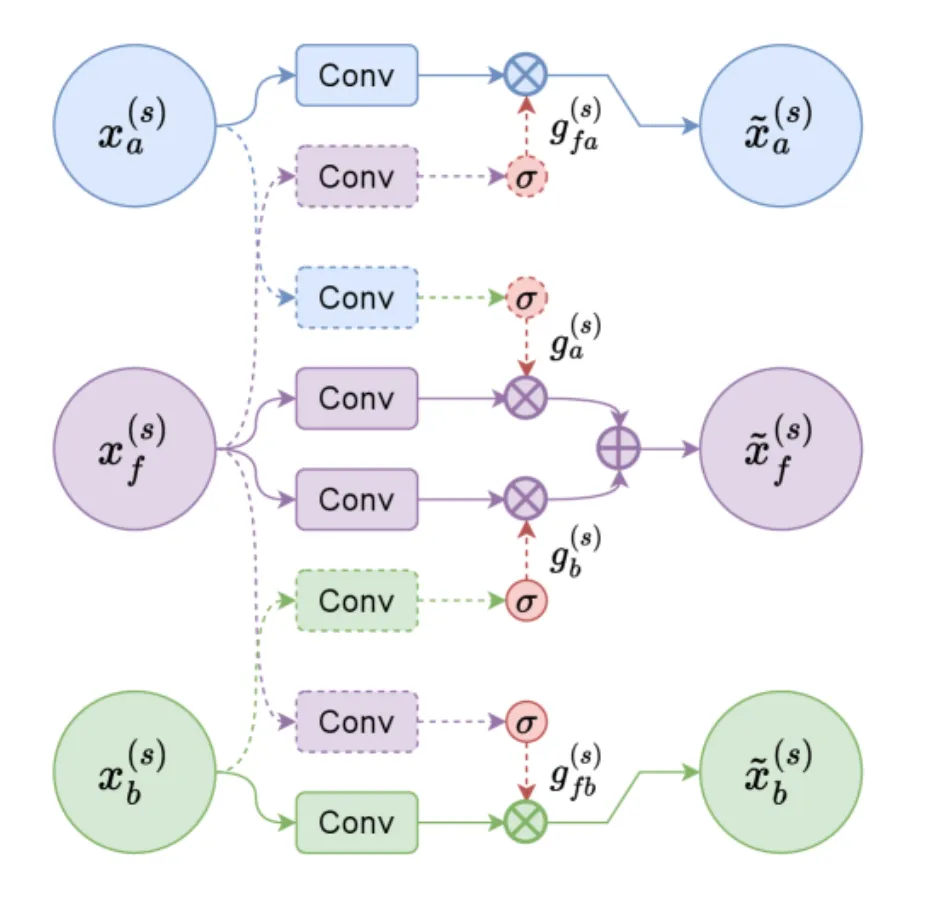
图3 CBGI模块示意图。展示跨分支门控交互模块的工作原理,实现融合分支与单模态分支之间的双向调制:融合分支生成门控信号抑制单模态分支中的噪声成分,单模态分支产生反馈门控为融合流补充模态特异性细节。
该模块实现了融合分支与单模态分支之间的
双向调制
:融合分支生成门控信号,利用全局上下文抑制单模态分支中的无关成分;同时,每个单模态分支基于原始特征产生反馈门控,为融合流补充可靠的模态特异性细节。这种双向门控机制建立了闭环信息流,确保信息有效交换的同时,保持各分支的独特表征,避免单一模态主导优化。
消融实验显示,CBGI 模块带来了最显著的性能提升,在三分支基线模型(Whisper CER 26.90%、WeNet CER 22.00%)基础上,分别将 Whisper 和 WeNet 系统的字错误率(CER)降至 19.80% 和 15.25%,降低幅度显著。
3.深度平衡交互模块
(DBI)
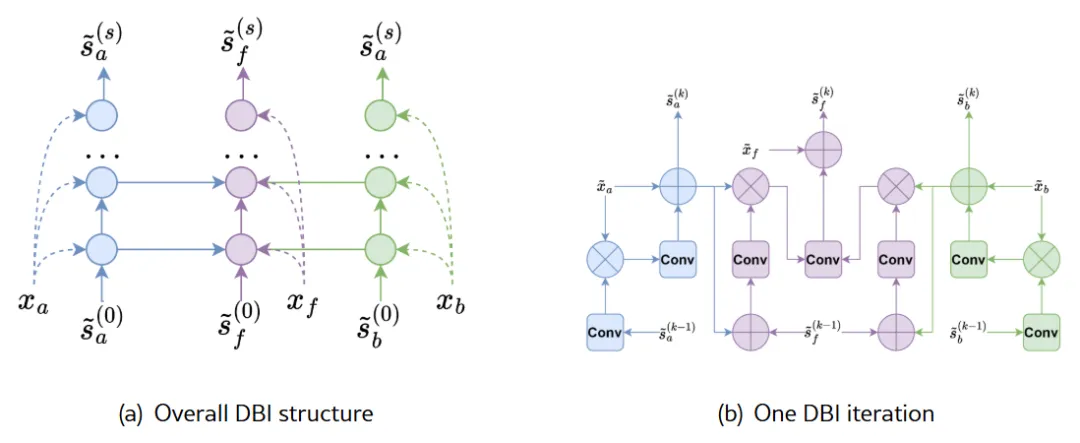
图4 DBI模块示意图。展示深度平衡交互模块的结构和工作原理。图4a显示DBI模块在编码器-解码器瓶颈层中的位置;图4b展示一次迭代更新的两个阶段:模态内精炼和融合反馈,通过共享参数的迭代不动点更新实现特征精炼。
受深度平衡多模态融合框架启发,DBI 模块部署在编码器 - 解码器的瓶颈层,通过
迭代不动点更新
精炼模态特征。该模块的参数在所有迭代中共享,使得 DBI 能在不增加参数量的情况下实现深度特征精炼和动态模态平衡,提升模型在全 SNR 范围内的稳定性。实验显示,DBI 求解器通常在
5 次迭代内收敛(中位数),均值迭代数为 6.89
,远低于预设的最大迭代数 50 次,保证了推理效率。
实验验证
研究团队在公共数据集上进行了大量实验,将DBMIF与多种单模态和多模态基线方法进行比较。主要发现包括:
客观指标领先:
在SI-SDR、PESQ、STOI、ESTOI和DNSMOS等多项客观指标上,DBMIF均取得优良结果。
在低至-15dB的信噪比条件下
,DBMIF仍能保持稳定性能。
下游
ASR任务显著提升:
使用Whisper和WeNet两个端到端ASR框架评估,DBMIF增强后的语音将字错误率分别降至15.84%和12.07%,比次优方法降低至少2.5%。
频谱
重构质量优异
:
在-10dB街道噪音环境下,DBMIF重构的频谱图最接近干净参考,有效消除其他方法产生的结构伪影,同时恢复被其他模型忽略的精细频谱细节。
主观
听感评分表现突出
:
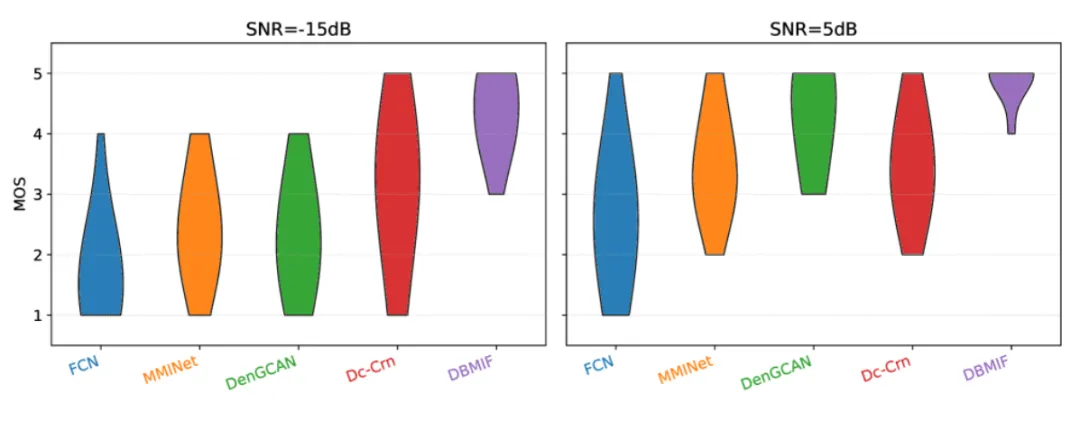
在-15dB极端噪音条件下开展绝对类别评分主观听测,DBMIF 的平均意见得分(MOS)密集分布在 4-5 分之间(满分 5 分),无样本低于 3 分;而对比方法得分方差大且常降至 1 分,表明 DBMIF 能有效防止语音可懂度崩溃,在极端噪音下仍能保证良好的听觉体验。
图5 主观听感测试MOS得分分布。展示极端噪音条件下(-15dB)和高信噪比条件下(5dB)各方法的MOS得分分布。DBMIF在-15dB下得分密集分布在4-5分之间,无样本低于3分,证明其极端噪音下的鲁棒性。
消融研究
系统性消融研究验证了各模块的必要性:
模块累积贡献:
从三分支基线模型(CER 26.90%)开始,依次添加CBGI(19.80%)、DIAF(18.50%)和DBI(15.84%)模块,下游ASR性能持续提升,证明各模块具有互补效益。
分支策略对比:
三分支配置在各信噪比和噪音类别下均优于单分支和双分支变体。尤其在脉冲噪音和嘈杂人声等挑战性噪音环境中,三分支设计的优势更加明显。
自适应模态融合行为:
DIAF 的融合权重随信噪比呈正相关变化,且具有明确的频率子带依赖性;DBI 的不动点迭代收敛效率高,无额外计算负担,验证了模型自适应调整模态贡献的设计有效性。
未来展望
尽管DBMIF在极端噪音条件下取得显著进展,但研究团队也指出当前局限:
非因果架构和较高的计算复杂度
给实时部署带来挑战;在超低信噪比场景下,增强语音与干净语音之间仍存在可懂度差距,需要进一步创新。
未来工作将聚焦于优化模型以适应因果流式推理,探索在嵌入式平台上的高效部署,并研究自监督预训练以进一步提升增强性能。
论文
信息:
Wu, Y., Zheng, C., Zhang, X., Zhang, Y., Zheng, C., Yang, S., Yan, Y., & Yin, E. (2026).
Deep Balanced Multimodal Iterative Fusion Framework for Air-Conducted and Bone-Conducted Speech Enhancement
. arXiv preprint arXiv:392603.02877v1.
评论 0
文明发言,友善讨论
发表评论
还没有评论,发表你的看法,来抢沙发~
 语音小管家