
 语音小管家
这带来了一个非常具体的问题:时间偏差(temporal misalignment)。当你生成一个雨滴敲打金属屋顶的视频时,音频(如果有的话)通常是独立生成的。视频里门被猛地关上,但音频中的关门声却没有同步;角色在说话,但声音和嘴型并不匹配。最终的效果会显得很诡异,就像一部已经被淘汰的配音电影,总有某些地方微妙地对不上。
更深层的问题在于架构设计。大多数多模态模型把文本当作唯一的指挥者,其他模态都只是为它服务。但在真实的电影制作中,画面与声音是持续互相影响的。一个雨景的特写不仅仅是像素问题,它同时意味着一种声学环境;一个拥挤的市场场景需要声音来告诉观众哪些对话更重要。在实际拍摄中,摄影师和录音师需要协同合作,而不是按顺序各自完成工作。
01、为什么AI声音需要与画面一起诞生,而不是事后添加
想象两位音乐家在一间昏暗的房间里演奏。他们彼此看不见,但都在专注地倾听。一个演奏弦乐,一个演奏打击乐。他们共享同一位指挥(文本提示)和同一份参考录音(场景描述)。虽然看不到彼此,但他们能听到彼此的演奏,因此始终保持在同一个节奏上。而变革已经开始,例如:新的 SkyReels-V4 的架构洞见了问题所在。
在这个系统中,音频并不是在视频生成之后才产生。相反,两个分支会并行生成,并相互作为条件进行约束。例如,视频分支会了解到音频参考中有狗在叫,于是生成与狗叫节奏和能量相匹配的动作;而音频分支则“知道”画面中有一只狗,因此会生成与这种动物存在相一致的声音。这与许多其他方法有本质区别——那些方法只是把音频作为事后添加的元素附加到视频上。
当两个生成过程共享同一种输入理解时,它们就可以被统一编排。它们不再是按顺序交接的独立模型,而是同一个整体思维中的两个部分。
02、架构:共享思维的双流系统
SkyReels-V4 使用一种 双流多模态扩散 Transformer(MMDiT) 架构,其中一个分支负责合成视频,另一个分支负责生成音频,而两者都建立在同一个共享的概念基础之上。下面是这些组件如何协同工作的。
视频分支在一个学习到的潜在空间中通过扩散过程生成视频帧,并接受丰富的视觉条件输入:文本描述、参考图像、用于修复的遮罩(mask),甚至完整的视频片段。音频分支则通过相同的扩散过程生成声音频谱图,并以文本和音频参考作为条件输入。
这两个分支都建立在一个基于 多模态大语言模型(MMLM) 的文本编码器之上,该编码器既能理解语言,也能理解视觉概念。当你描述“麦田上空的雷暴”时,这个编码器会同时捕捉到该描述中包含的视觉丰富性以及声音上的预期。
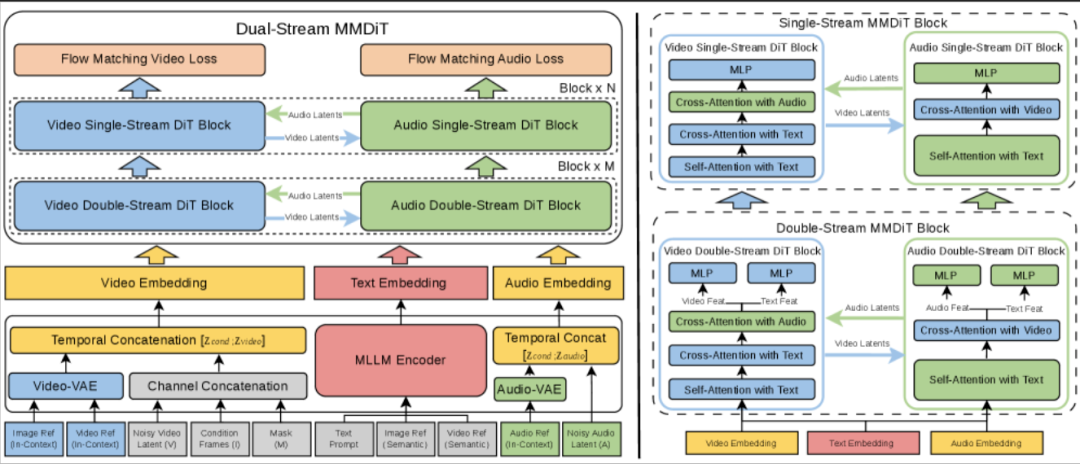
SkyReels-V4 架构概览展示了双流视频与音频生成分支共享同一个多模态编码器
这种双流架构通过共享的多模态编码器运行,其中视频分支和音频分支在同一文本理解的条件下同时生成内容。
信息从文本提示进入共享编码器,被解析为语义理解,然后这些理解被传递到两个分支中。两个分支不会彼此等待,但它们都由同一个概念输入统一协调。
扩散模型非常适合这种联合生成方式,因为视频和音频都可以通过逐步迭代的方式不断优化。在每一个扩散步骤中,视频分支都可以根据音频分支当前的估计结果进行轻微调整,反之亦然。这就像两位音乐家在实时完善他们的演奏——彼此倾听,并不断根据对方进行调整。
03、一个统一接口:用于生成、编辑和修复
这正是架构优雅之处转化为实际能力的地方。大多数视频模型需要为不同任务准备不同的代码路径,例如“从零生成视频”“编辑已有视频”以及“延长视频片段”。而 SkyReels-V4 通过一种叫做 通道拼接(channel concatenation) 的机制,将这些功能统一到同一个系统中。
这个方法看似简单,但非常巧妙:不同的输入通道可以填入不同内容,也可以保持为空(被遮罩)。
文本生成视频(Text-to-video)
所有输入通道都是空的(被遮罩),因此模型会从零开始生成全部内容。
图像生成视频(Image-to-video)
起始图像被嵌入到部分通道中,其余通道保持为空,模型随后生成接下来的视频。
视频扩展(Video extension)
已有的视频帧填入部分通道,其余通道为空,模型生成后续内容。
视频修复(Inpainting)
输入视频中包含被遮罩的区域,这些区域对应的通道为空,模型会连贯地填补这些缺失部分。
视觉参考编辑(Vision-referenced editing)
需要编辑的视频以及展示目标风格的参考图像都会作为条件输入嵌入,模型据此进行编辑。
传统方法通常需要为每一种任务训练不同的模型或使用不同的训练流程。而 SkyReels-V4 只学习一个统一的扩散生成过程。在训练时,模型会看到各种随机组合的已填充通道和空通道,从而学会如何进行智能修复。
这种统一方式也自然扩展到更复杂的场景,例如多个参考图像同时指导生成的情况——这正是电影级制作流程中非常关键的一点。
04、让影院级分辨率在计算上变得可行
生成 15 秒 1080p、32 帧/秒的视频在计算上非常昂贵。你不能简单地扩大扩散过程并寄希望于可行的推理时间。相反,SkyReels-V4 采用了一种三阶段策略,在最关键的地方保持质量,同时降低其他方面的计算成本。
第一阶段使用双流 MMDiT 以较低分辨率生成整个视频。这 computationally efficient,并捕捉到了完整的时间连贯性、整体构图以及音视频同步。模型已经解决了难题:场景应该是什么样子,以及声音和视觉应该如何对齐。
第二阶段识别关键帧——视觉或音频变化最大的点、关键的叙事时刻——并仅以全 1080p 分辨率重新生成这些帧。这是细节和保真度最为重要的地方。
第三阶段应用智能放大和插帧。低分辨率帧通过超分辨率模型进行处理,放大至 1080p 的同时保留内容。关键帧及其放大后的相邻帧通过帧插帧模型进行处理,生成中间的帧,从而保持平滑的运动和时间连贯性。
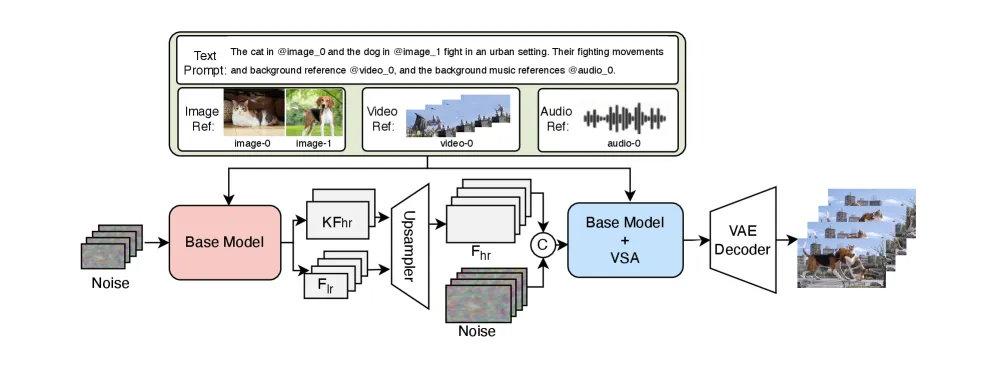
低分辨率生成 + 关键帧放大 + 帧插值的流程示意图
三阶段流程:低分辨率完整序列 (F) 生成、关键帧 (KF) 选择与放大、帧插值以保持平滑运动。
这种方法之所以有效,是因为低分辨率模型已经学习了硬约束。放大和插值是更简单、可学习的问题。你不是要求模型从头开始创造细节,而是要求它合理地完成一个它已经理解的模式。与全分辨率生成所有内容相比,内存占用和推理时间显著减少,使得影院级画质的输出变得可行。
05、实际表现如何
架构只有在能够交付成果时才重要。论文将 SkyReels-V4 置于竞争格局中进行定位,而非宣称其拥有显而易见的优势,这反而 paradoxically 增强了可信度。
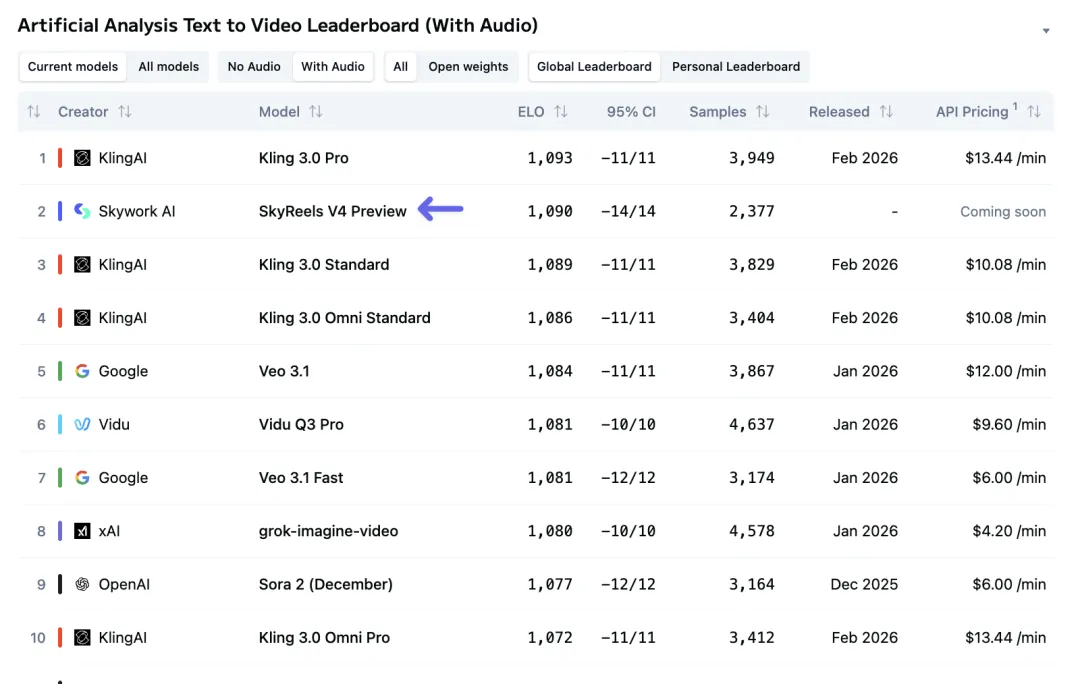
Artificial Analysis 文生视频(含音频)竞技场排行榜显示 SkyReels-V4 的排名
SkyReels-V4 在 Artificial Analysis 文生视频(含音频)竞技场排行榜上排名第三,与 Veo 3.1、Sora-2 及其他 state-of-the-art 模型同台竞技。
在 Artificial Analysis 排行榜上,SkyReels-V4 综合排名第三,与 Veo 3.1、Sora-2、Wan 2.6 等模型同场竞争。这使其跻身于真正具有竞争力的模型梯队,而非 claims the obvious winner。
跨多个维度的绝对质量指标(视觉质量、时间连贯性、音视频同步)为理解良好性能的表现建立了基准:
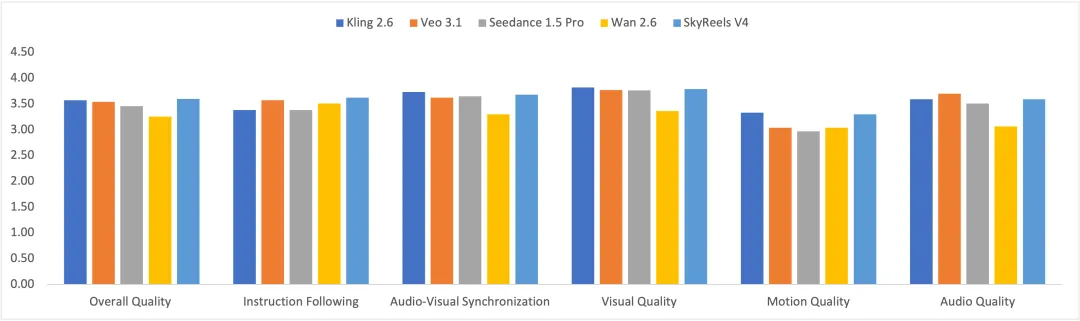
基于 5 分 Likert 量表 的绝对评分结果,对 SkyReels V4 与基线模型进行了比较
绝对质量指标显示,SkyReels-V4 在多个维度上表现稳定,包括视觉质量、运动连贯性和音视频同步。
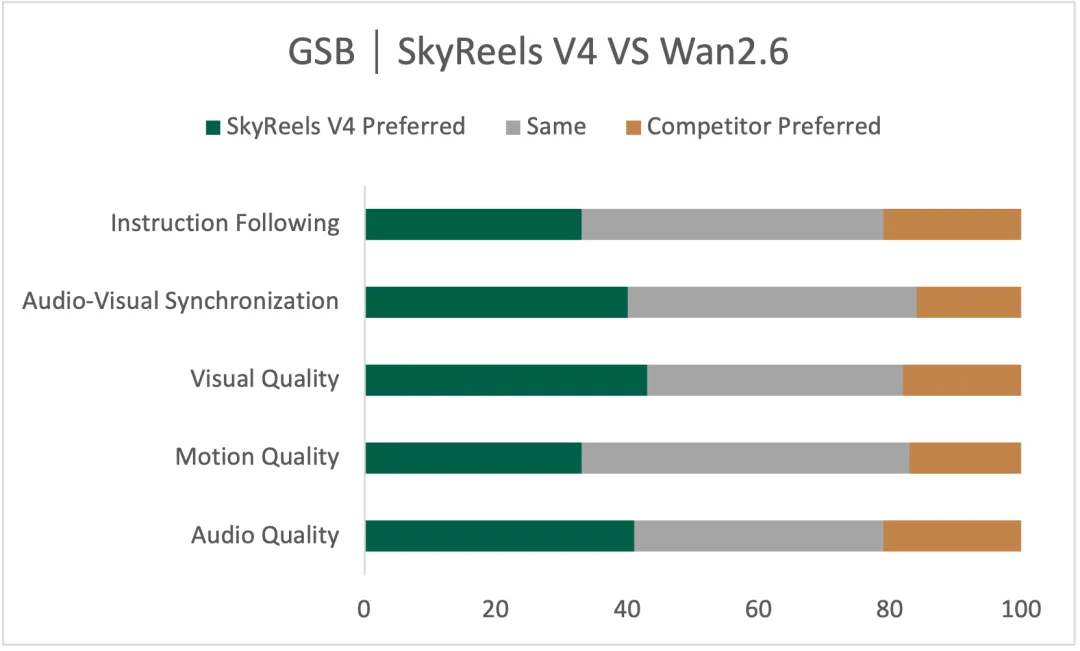
一对一的对比分析也揭示了更细致的差异。与 Kling 2.6 相比,整体性能相当,在某些特殊情况下双方各有优势。与 Veo 3.1 的竞争非常接近,这表明这些模型处在一个更高的技术层级。与 Seedance 1.5 Pro 和 Wan 2.6 相比,质量评估显示 SkyReels-V4 基本稳定处于 “Good(良好)” 的水平。
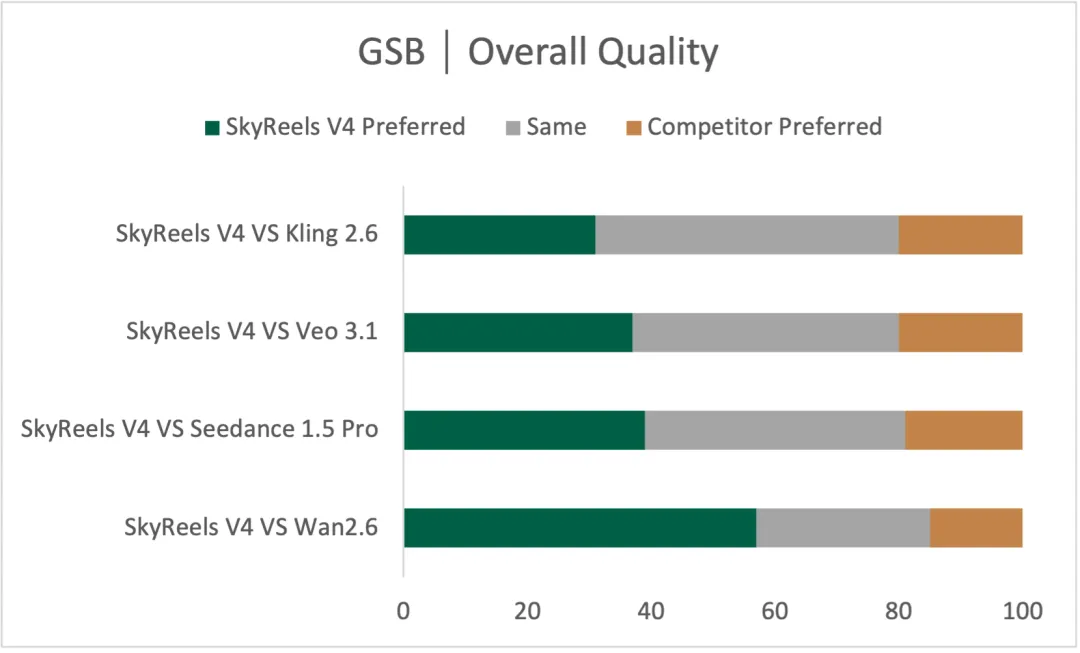
整体质量比较,显示在所有基线模型中的 良好(Good)、相同(Same)和较差(Bad) 评分情况
整体质量比较(良好/相同/较差评分)显示,SkyReels-V4 在整个领域中具有竞争力。
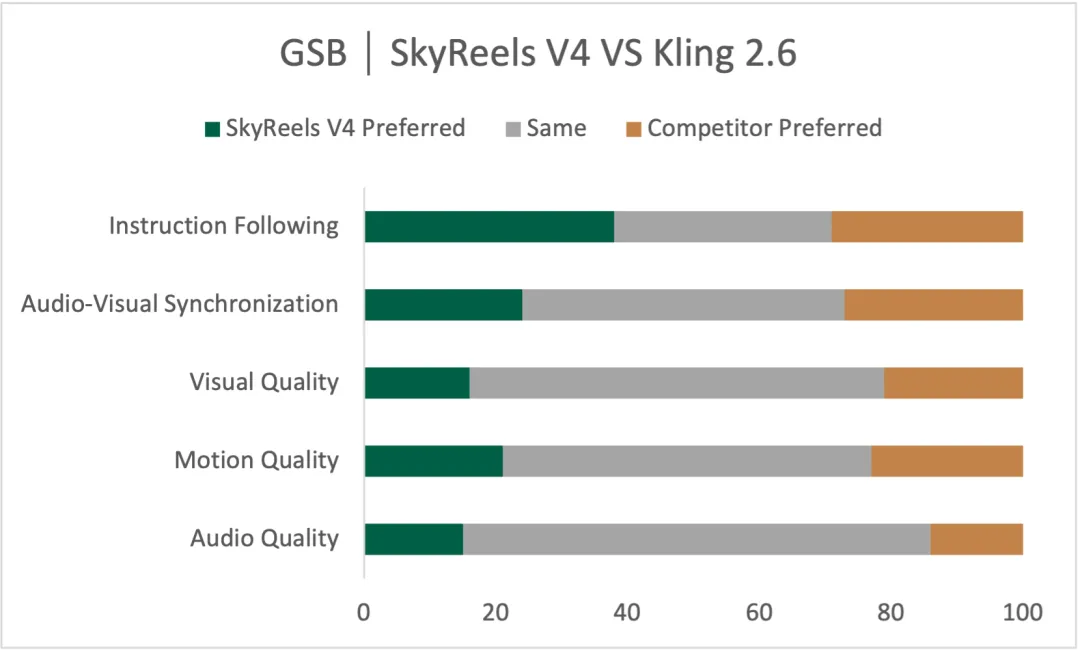
SkyReels V4 与 Kling 2.6 对比
与 Kling 2.6 的对比显示,SkyReels V4 性能具有竞争力,并在某些方面互为优势。
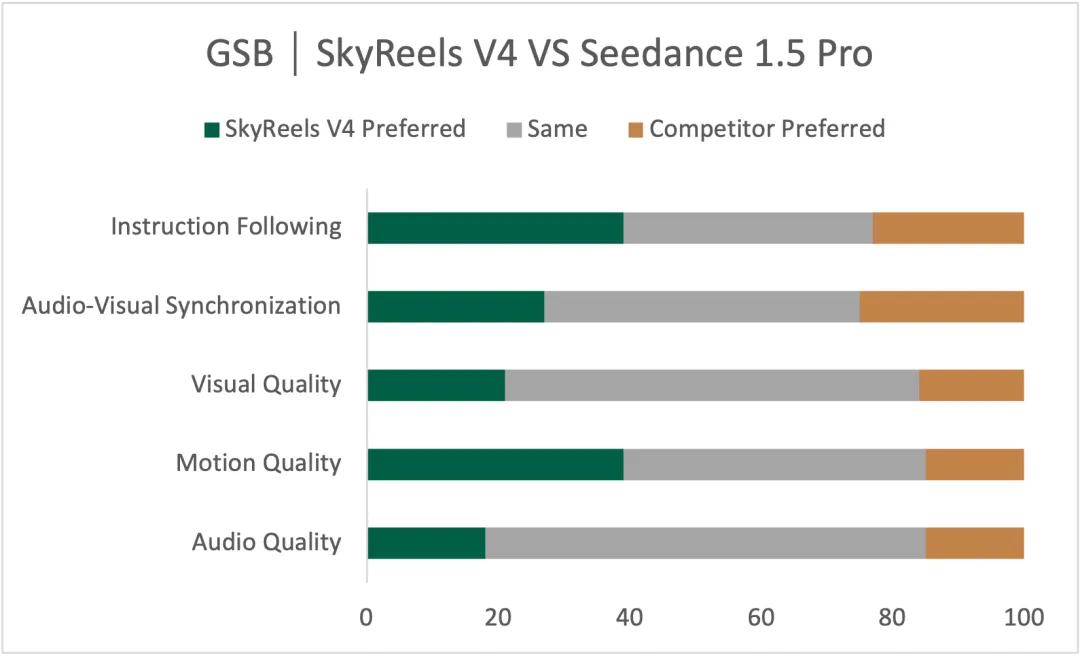
SkyReels V4 与 Seedance 1.5 Pro 对比
与 Seedance 1.5 Pro 的对比显示,SkyReels V4 在各项评估指标上表现稳定且质量一致。
SkyReels V4 与 Veo 3.1 对比。
与 Veo 3.1 的对比显示,这两款模型在前沿水平上竞争非常接近。
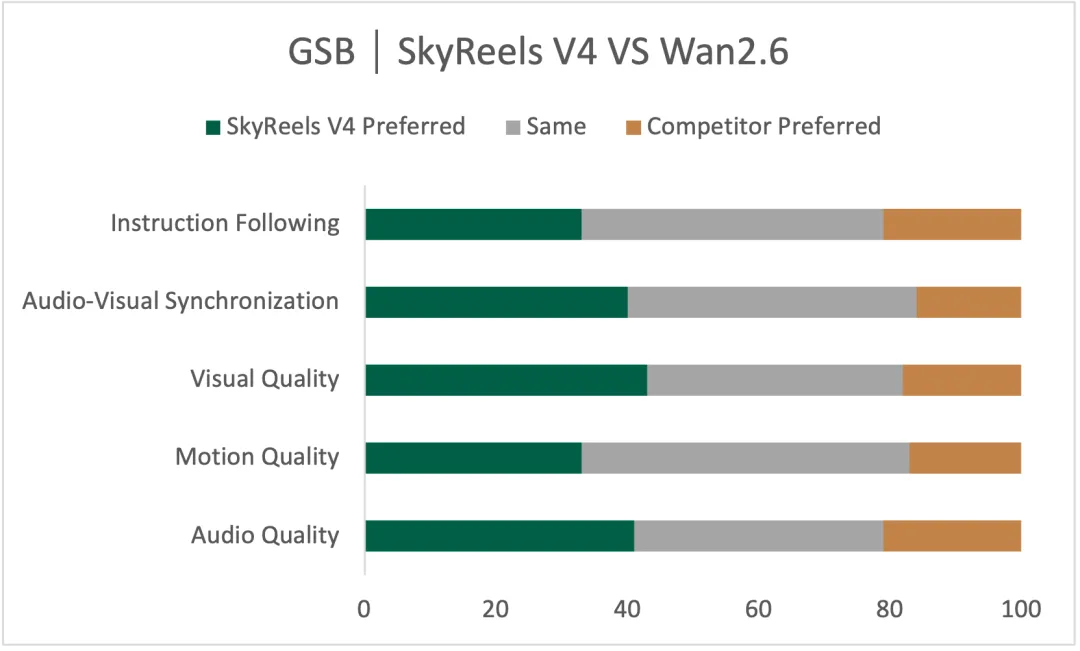
SkyReels V4 与 Wan 2.6 对比
与 Wan 2.6 的对比显示,SkyReels-V4 在性能上保持了稳定的优势。
该架构真正发挥优势的地方,是它设计的初衷所在:丰富条件输入的场景。在涉及多张图像参考、音频参考以及复杂遮罩的情况下,统一的多模态接口能够带来显著收益。对于简单的提示,其优势可能不明显,但在电影级制作中——天然涉及丰富参考和复杂指导——该模型表现尤为出色。
示例展示了多张图像和音频参考如何指导生成
通过多图像和音频参考的复杂条件输入,展示了模型在处理丰富多模态信息方面的灵活性。
这种竞争定位非常诚实。SkyReels-V4 并未被呈现为明显的赢家,这反而让其实际优势更具可信度。它在特定领域表现出色,如多模态条件输入、音视频同步和统一编辑,同时仍处在一个由多款模型共同推动技术前沿的生态中。
06、为什么这种方法重要
SkyReels-V4 的真正创新不在于任何单一组件。它的理念是:视频和音频生成应当统一,多模态条件输入应自然融合,并且效率不应以牺牲电影级质量为代价。
通过构建一个双流架构并共享概念基础,通过在一个接口下统一生成与编辑,并策略性地应用超分辨率与插帧技术,模型展现了一种事后看起来必然,但实际上需要真正洞察才能实现的设计。
之前的工作包括:
SkyReels-V3:建立了视频生成基础
SkyReels Audio:展示了音频条件下视觉合成的潜力
SkyReels-V2:解决了长视频生成问题
V4 将这些技术线程整合到一个统一系统中,使模型能够同时在视频和声音层面进行思考,在一个通常由专业化占主导的领域,这是一种罕见的架构选择。
结果是一个基础模型(foundation model),能够生成电影级视频,并实现音频与画面完美同步,同时保持编辑、延长或填补空白的灵活性。对于制作而言,这改变了可能实现的创作范围。
