
 语音小管家
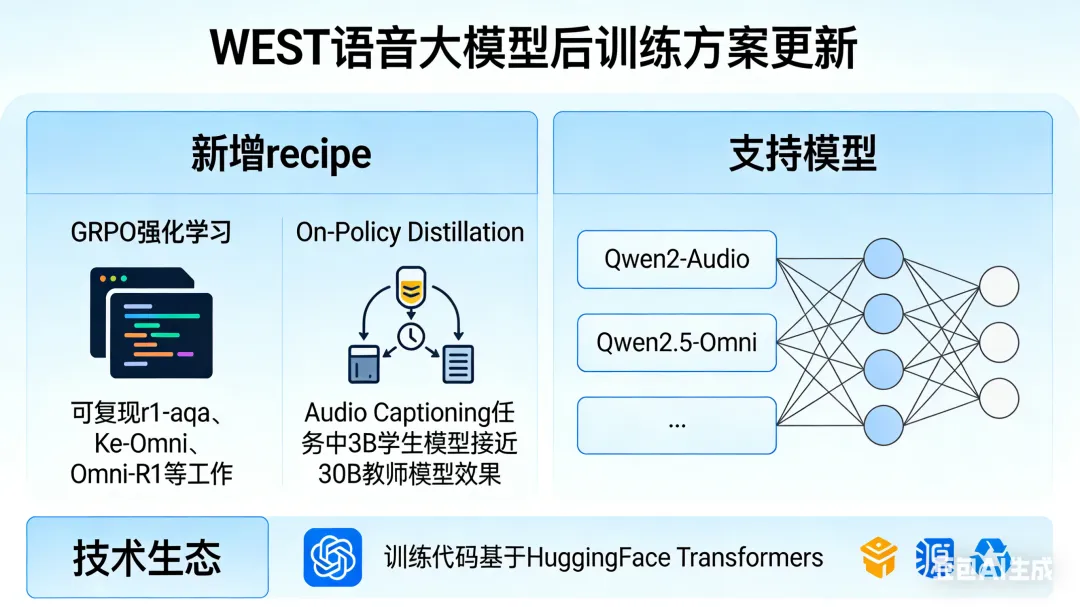
WEST 新增了 GRPO 强化学习和 On-Policy Distillation 两个 recipe,支持对 Qwen2-Audio、Qwen2.5-Omni 等音频模型做后训练。GRPO 方案可复现 r1-aqa、Ke-Omni、Omni-R1 等工作;On-Policy Distillation 方案在 Audio Captioning 任务上, 让 3B 大小学生模型实现了接近 30B 参数教师模型的效果。训练代码基于 HuggingFace Transformers 生态,便于二次开发和快速想法验证。
最近,强化学习(RL)和在线策略蒸馏(On-policy Distillation)已成为提升大语言模型能力的重要后训练手段。社区流行的后训练框架如 VeRL、NeMo-RL 等主要面向文本和图像模态的大模型。在音频多模态大模型领域,相关的开源训练框架支持仍然不太完备。
本文介绍 WEST 工具包中的两个后训练 recipe:GRPO和On-Policy Distillation,分别面向音频问答(Audio QA)和音频描述(Audio Captioning)任务,提供了完整的数据准备、训练和评测流程。
方法介绍
GRPO
GRPO 是 DeepSeek 提出的一种无需额外 Reward Model 的强化学习方法。其核心思想是:对同一个 prompt 采样多个回答(group),通过组内相对比较来估计 baseline,从而优化策略模型。相比 PPO,GRPO 省去了 Value Model 的训练开销,实现更加简洁高效。
在音频问答场景中,我们对选择题格式的音频问答数据(AVQA)使用 GRPO 进行训练,以答案的正确性和模板的匹配性作为 reward signal。
On-Policy Distillation
传统的 Off-Policy 蒸馏直接使用教师模型生成的数据训练学生模型,但这容易导致 distribution shift——学生在推理时遇到的分布与训练时不同。On-Policy Distillation通过以下流程解决这一问题:
学生在线生成:学生模型对 prompt 进行采样,产生 completion 教师评估学生输出:教师模型对学生生成的 completion 计算 logits KL 散度对齐:学生通过最小化与教师输出分布的 KL 散度来学习
由于训练数据始终来自学生当前策略,避免了 off-policy 的分布偏移问题,训练更加稳定。
支持模型与数据
GRPO 训练方案
实验设置
训练使用 8 张 Nvidia H20 GPU,主要超参数如下:
实际训练时间约两个小时,训练几百个 step,使用不到 10k 个样本,对训练数据本身没有特别的筛选策略。模型每 100 个 step 保存一个 checkpoint,解码评测后取结果最好的 checkpoint。
我们尝试了两种 prompt template 来做训练:
default | | |
think | |
# default template
{question} Please choose the answer from the following options: {choices}.
Output the final answer in <answer> </answer>.

# think template (Chain-of-Thought)
{question} Please choose the answer from the following options: {choices}.
Output the thinking process in <think> </think> and final answer in <answer> </answer>.
实验结果
| 71.6 | 60.46 | |
| 73.4 | 65.38 | |
| 67.2 | 54.12 |
结果分析
GRPO 对上面三个模型均有帮助:三个不同规模的模型经过 GRPO 训练后,在 MMAU 和 MMSU 上均获得了提升。 Think 模板未带来提升:对于 MMAU 和 MMSU 测试集,引入 think模板的思考过程并未提升最终结果,还需要进一步探索。(上面实验表格中的结果均使用了default无思考模板)
On-Policy Distillation 训练方案
教师模型部署
On-Policy Distillation 支持两种教师模型部署方法。
RemoteKnowledgeDistillationTrainer | ||
KnowledgeDistillationTrainer |
实验
On-Policy Distillation 在两个任务上进行了实验验证。
Task 1: Detailed Audio Captioning
实验设置
学生模型训练使用了 8 张 H20 GPU,教师模型使用了额外 4 张 H20 通过 vLLM 部署。
该任务训练学生模型生成详细的音频描述。评测采用级联评估方法:模型生成详细 caption,再用 LLM 基于 caption 文字内容回答下游 QA 问题,以此评估 caption 的完整性。该评估方法参考自 Omni-Captioner。
| OPD (Student: Omni-3B, Teacher: Step-Audio-R1.1) | 69.6 |
| OPD (Student: Omni-3B, Teacher: Omni-Captioner) | 69.1 |
| OPD (Student: Omni-7B, Teacher: Omni-Captioner) | 70.1 |
3B 学生模型通过 On-Policy Distillation,在 MMAU 上从 65.6 提升至 69.6(+4.0),逼近了 30B 总参数的 Omni-Captioner(72.8)的效果。
Caption 质量对比
蒸馏后的模型能够生成更加详细、结构化的音频描述,包含声音类型、说话人特征、背景音效等丰富信息。
Task 2: Audio QA
该任务使用 Local HuggingFace 模式加载教师模型,在音频问答任务上进行 On-Policy Distillation。
| 67.2 | 54.12 | |
| 67.9 |
On-Policy Distillation 在 MMAU 上取得了 67.9 的结果,略优于 GRPO 的 67.2,验证了蒸馏方法在 Audio QA 任务上的有效性。
快速上手
GRPO
# Step 1: 下载数据和模型
bash run.sh --stage prepare

# Step 2: 训练 (8 GPU)
bash run.sh --stage train

# Step 3: 评测
bash run.sh --stage mmau   # MMAU 评测
bash run.sh --stage mmsu   # MMSU 评测
On-Policy Distillation
# Step 1: 下载数据和模型
bash run.sh --stage prepare

# Step 2: 启动教师模型 vLLM 服务(Remote 模式,在另一台机器上)
bash run.sh --stage vllm_teacher

# Step 3: 训练
# 修改 run.sh 中的 teacher_model_name_or_path 为教师机器的 IP
bash run.sh --stage train

# Step 4: 评测(级联 Caption + LLM 评估)
export LLM_API_KEY=sk-xxxx
bash run.sh --stage decode
每个 recipe 都遵循prepare → train → eval的三步流程,开箱即用。
总结
本文介绍了 WEST 工具包中的 GRPO 和 On-Policy Distillation 两个后训练方案:
GRPO在三个音频大模型上均取得了效果提升,复现出了相关论文中结果。 On-Policy Distillation通过在线蒸馏避免分布偏移,让 3B 学生模型在 Audio Captioning 任务上逼近 30B 总参数教师模型的效果。
未来我们将继续探索更多的后训练方法,支持更多的音频多模态模型和任务。欢迎关注 WEST 项目,一起交流和贡献!
致谢
GRPO recipe 参考了 r1-aqa 的实现,感谢相关作者的开源工作。
