
 语音小管家
针对当前AI生图中的审美疲劳、色彩失控等痛点,Wan2.7-Image带来了更具“活人感”的人物生成、精准的色彩控制以及超长文本渲染能力。
体验 Wan2.7-Image:
👉 体验入口:https://tongyi.aliyun.com/wan/
👉 开发者调用:https://bailian.console.aliyun.com/cn-beijing?tab=api#/api/?type=model&url=3026980
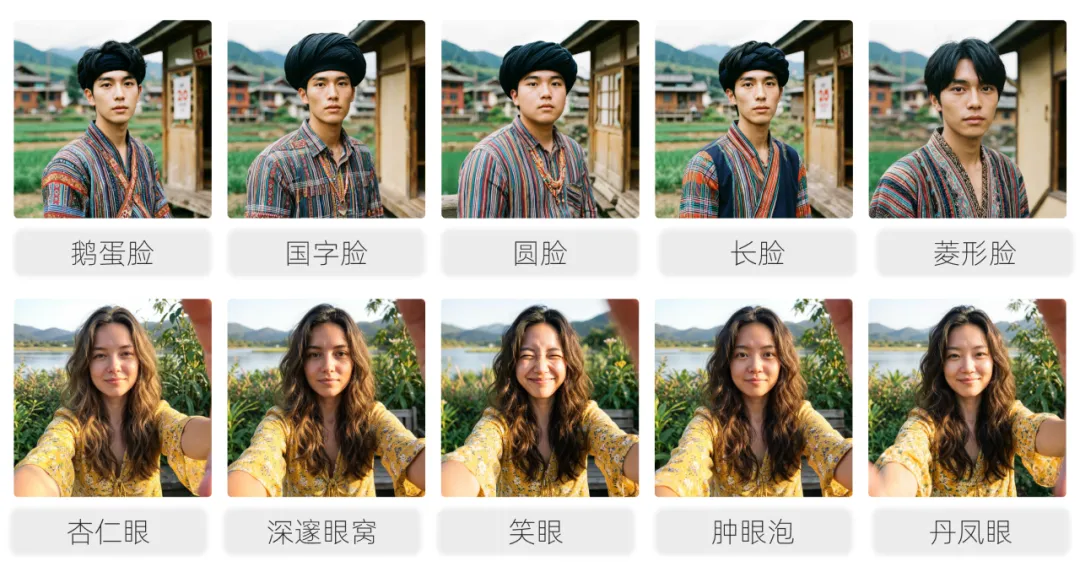
塑造“千人千面”:让面孔更真实
为了让AI生成的人物告别同质化,Wan2.7-Image进一步强化了虚拟形象捏脸功能。
通过对骨相、眼眸及五官细微处的全方位定制,模型支持在提示词中灵活更换脸型(如圆脸、方脸、长方脸)与眼部特征(如丹凤眼、深邃眼窝)。这让AI不再只是生成一张“标准脸”,而是能根据创意需求,塑造出极具辨识度、富有生命力的面孔。
玩转“调色盘”:精准对齐创作意图
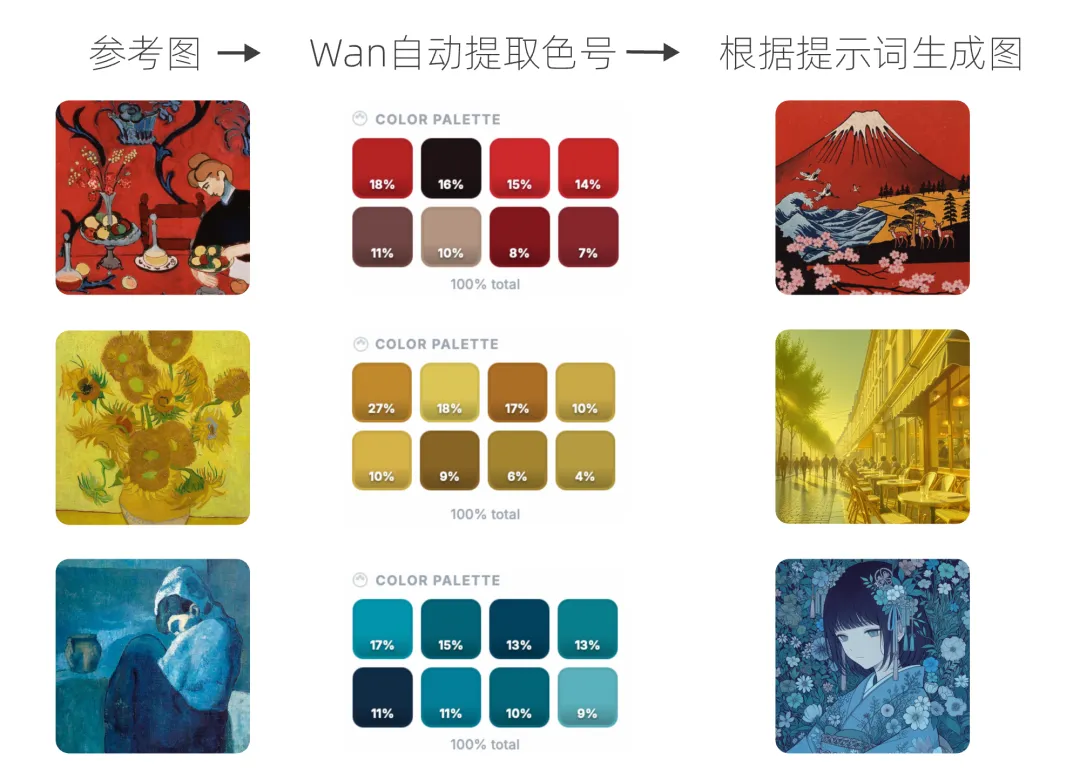
Wan2.7-Image全新支持“调色盘”功能,用户可以一键提取参考图的色彩分布比例。无论是复刻名画的色系,还是对齐品牌手册的严格配色,模型都能在保持构图的同时,实现色彩的精准迁移。
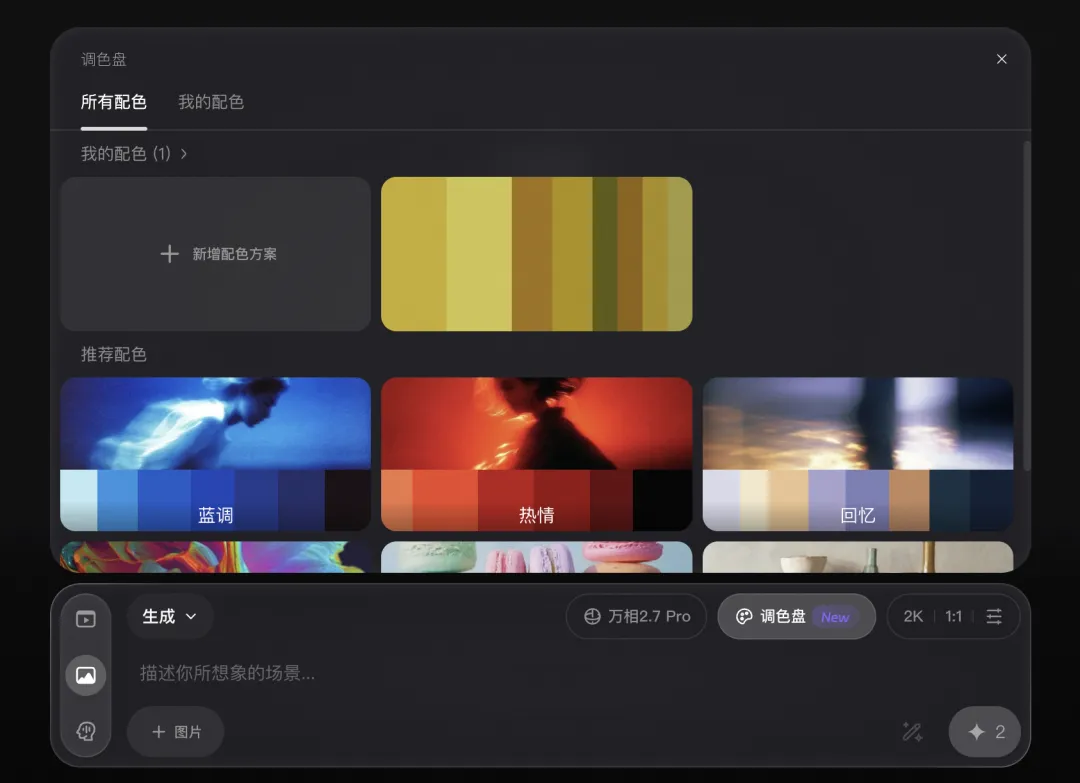
Wan2.7-Image「调色盘」功能界面
3K Token 超长渲染:挑战文本排列极限
文本渲染一直是生图模型的“硬伤”,容易出现容易文字模糊、内容错乱甚至漏写。但在Wan2.7-Image上,我们尝试突破这一瓶颈。
得益于对超长序列的记忆解析,该模型支持最高3K token的长文字输入。无论是复杂的表格、精准的公式,还是需要铺满整页A4纸的文字内容,Wan2.7-Image都能实现印刷级的清晰度,支持中、英等12种语言。
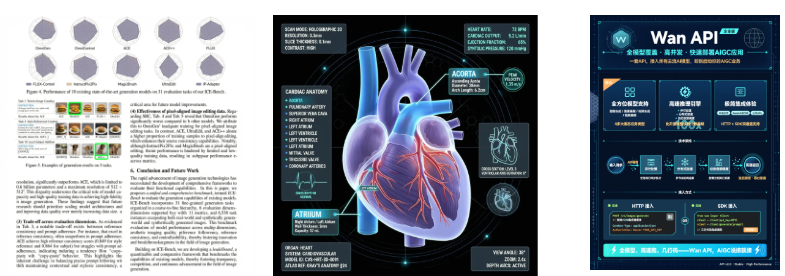
Wan2.7-Image可生成复杂论文报告、信息图、数学公式计算过程图等
交互式编辑:哪里不爽点哪里
除了生成,Wan2.7-Image更强调“可操控性”。
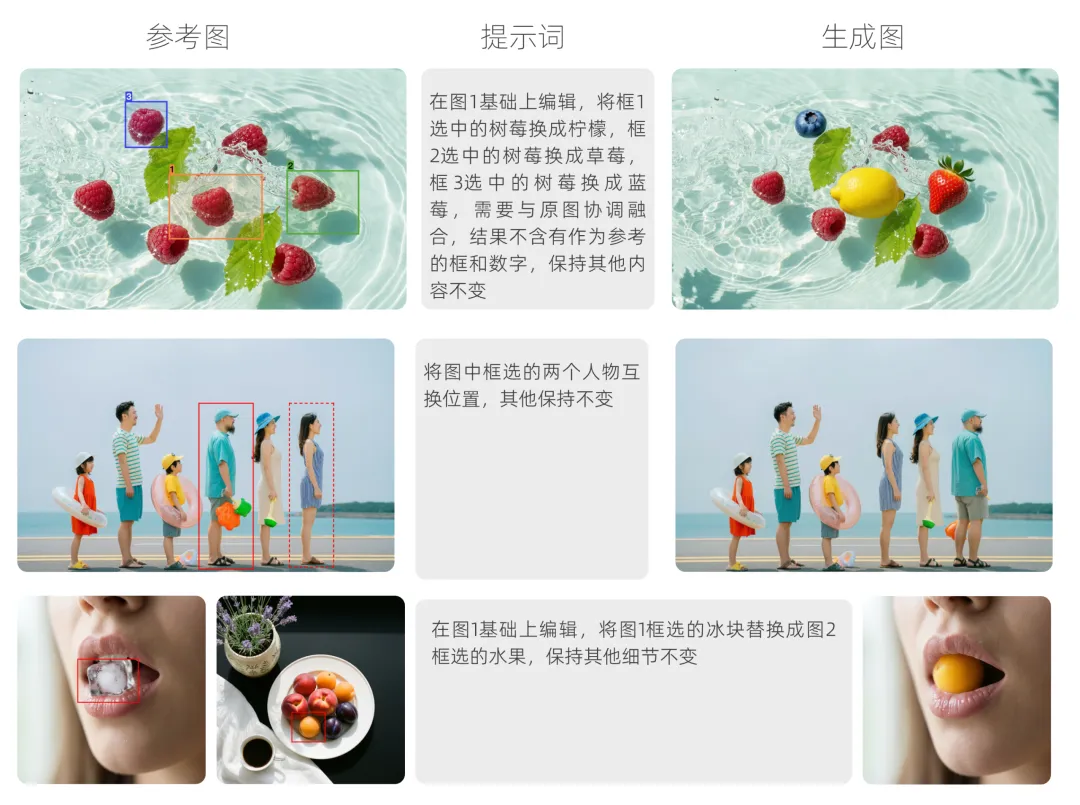
它原生支持交互式编辑模块。通过简单的框选指令,用户可以在指定区域实现元素的添加、对齐或移动。
多主体一致性:多图生成保持风格统一
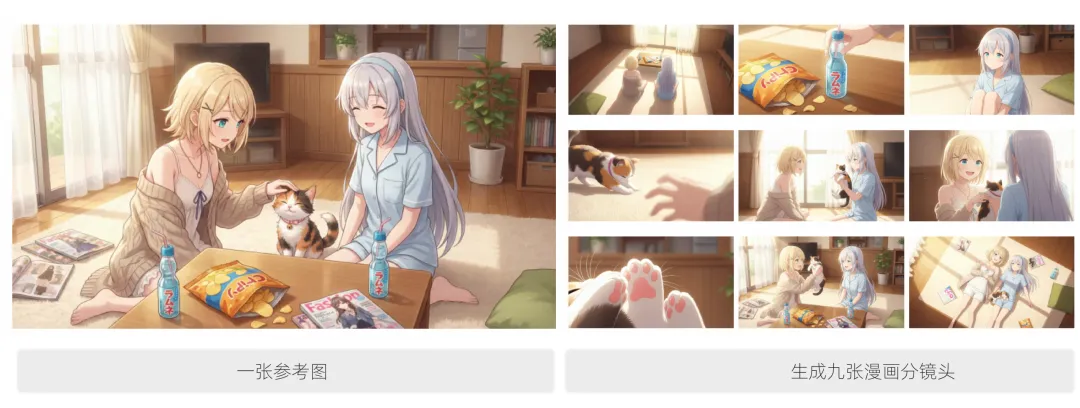
同时,模型具备更强的主体一致性(最高支持9张参考图),在生成分镜脚本、电商套图等系列化内容时,能够有效保持角色与风格的统一,降低创作中的“随机性”。
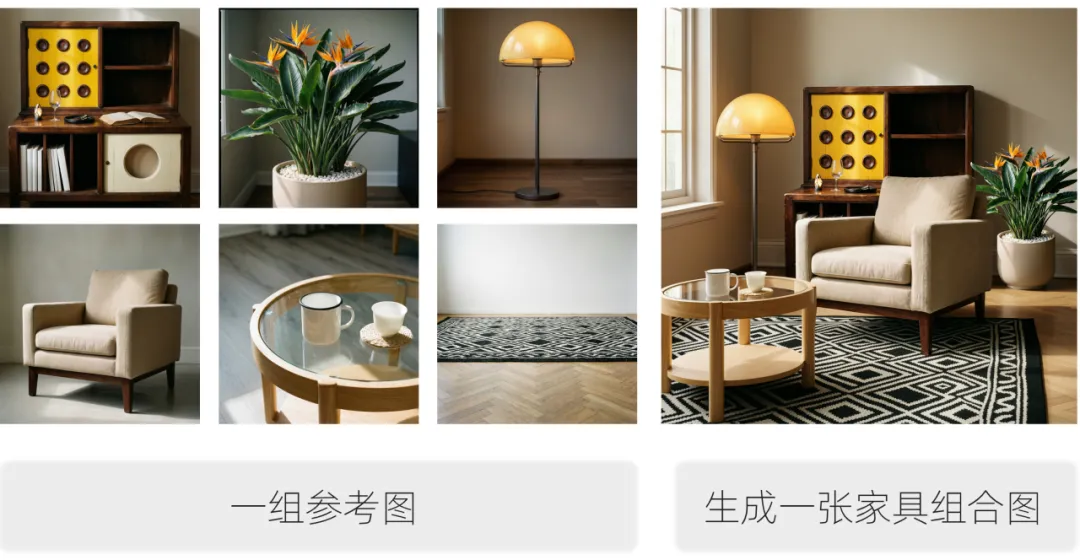
组图生成:一次最多生成12张
Wan2.7-Image还具备强大的组图生成能力,可生成多达12张,用于批量制作同风格系列图、PPT配图、分镜脚本、电商模特套图及多视角建筑图。
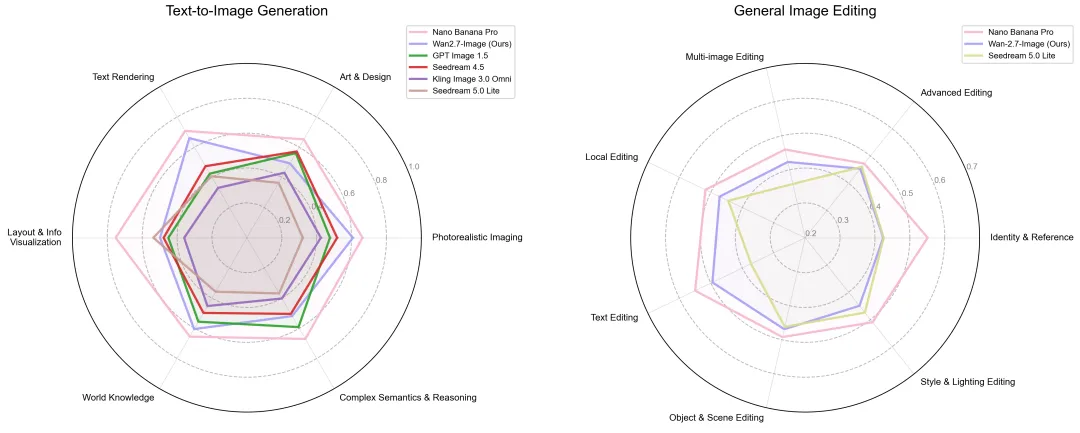
支持调用WanImage Skill,可让龙虾画画。人类偏好盲测评分,多项能力位列全国第一,接近Nano Banana Pro。
在训练数据上,超大规模的异构数据底座不仅涵盖全域品类的视觉素材,还整合了理解类数据;
在模型架构上,采用了领先的生成与理解统一模型架构,在共享隐空间(Latent Space)来实现语义映射,文字紧挨着画面,模型不需费力去猜文字对应的画面;
在训练流程中,引入多模态指令(比如文字+图片),使得模型实现了从单纯“像素拟合”到“底层语义认知”的飞跃。
基于更大规模数据及尺寸训练而成的Wan2.7-Image-pro同步上线,生成图像的构图更加稳定,语义理解更强更精准。
