
 语音小管家
文章链接:https://arxiv.org/pdf/2508.07375
想象一下,当你和AI 语音助手聊天时,它可以像真人一样自然地倾听、适时地“嗯、啊”附和,甚至在你打断它时迅速反应。这就是全双工语音大模型(FD-SLMs)的魅力所在:它们通过对双通道音频数据进行同步建模,来支持打断、后台确认(backchannels) 和重叠语音等复杂的真实对话交互。
然而,现有的端到端(e2e) FD-SLMs 常常面临一个极为尴尬的瓶颈:虽然它们的声音听起来极度拟人、交互节奏非常自然,但是一旦聊到具体内容,往往显得“言之无物”、“前言不搭后语”。这是因为处理超长的双通道连续语音序列非常困难,且高质量的口语对话数据非常稀缺,导致它们在语义连贯性和对话内容的丰富度上,相比于纯文本大模型出现了明显的退化。
如何拯救这些“声音拟人但聊天内容空洞”的双工语音大模型?来自香港中文大学的研究团队提出了一项名为TurnGuide的突破性技术!
⏩核心动机(Motivation):为什么在真实对话中插入文本这么难?
为了提升语音模型的“语商”(语义交互能力),业内的一条主流思路是通过文本-语音交错生成,引入文本来预先指导语音的生成,从而将纯文本大模型的强大语义能力迁移过来。
目前有一些基于级联(Cascaded)架构的方法,它们依赖预定义的规则(比如触发特定关键词来打断)和合成对话数据来进行状态预测。虽然这种方法能引入文本,但合成数据生成的对话往往非常死板,失去了人类日常交流的自然感和灵动感。
与之相反,端到端(e2e) FD-SLMs 选择直接使用真实世界的双通道电话录音数据(如包含2000 小时数据的 Fisher 数据集)进行训练,以捕捉最真实、微妙的人类交互动态。但这带来了一个巨大的挑战:如何在不破坏真实双通道精准时间对齐的前提下,聪明地将离散的文本token 插入到连续的音频流中?
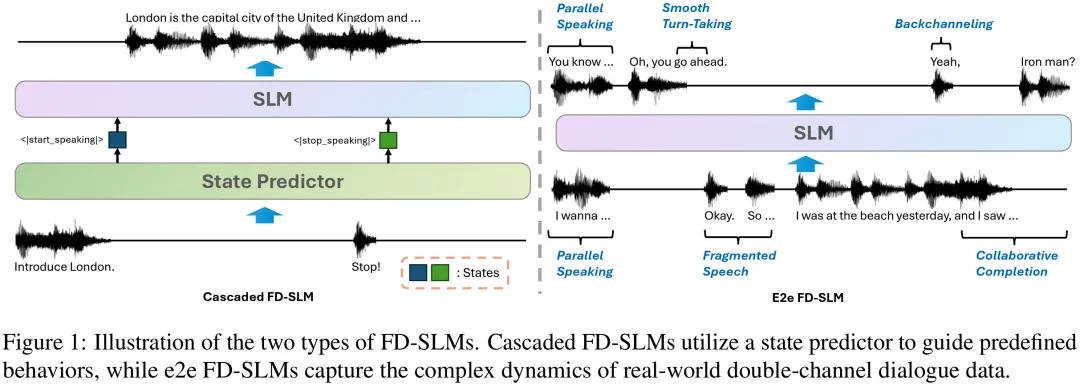
研究团队一针见血地指出,在真实双通道音频中插入文本面临两座大山:
1.插入时机(Insertion timing):文本必须在助手开始说话的精确时刻插入。如果插得太早,AI 会在没有听完用户完整上下文的情况下“抢答”,导致严重的幻觉;如果插得太晚,语音都已经生成了,文本的指导作用也就成了马后炮。
2.插入长度(Insertion length):插入的文本太长,AI 就会变成“话痨”,无法及时响应用户随后的新输入;太短又会导致语义碎片化,大大削弱了文本指导的有效性。
⏩方法论(Methodology):TurnGuide 的巧妙解法
为了完美解决真实数据下的文本插入难题,TurnGuide 提出了一种动态轮次级文本-语音交错生成方法(Dynamic Turn-Level Text-Speech Interleaving)。这套魔法主要分为两步:
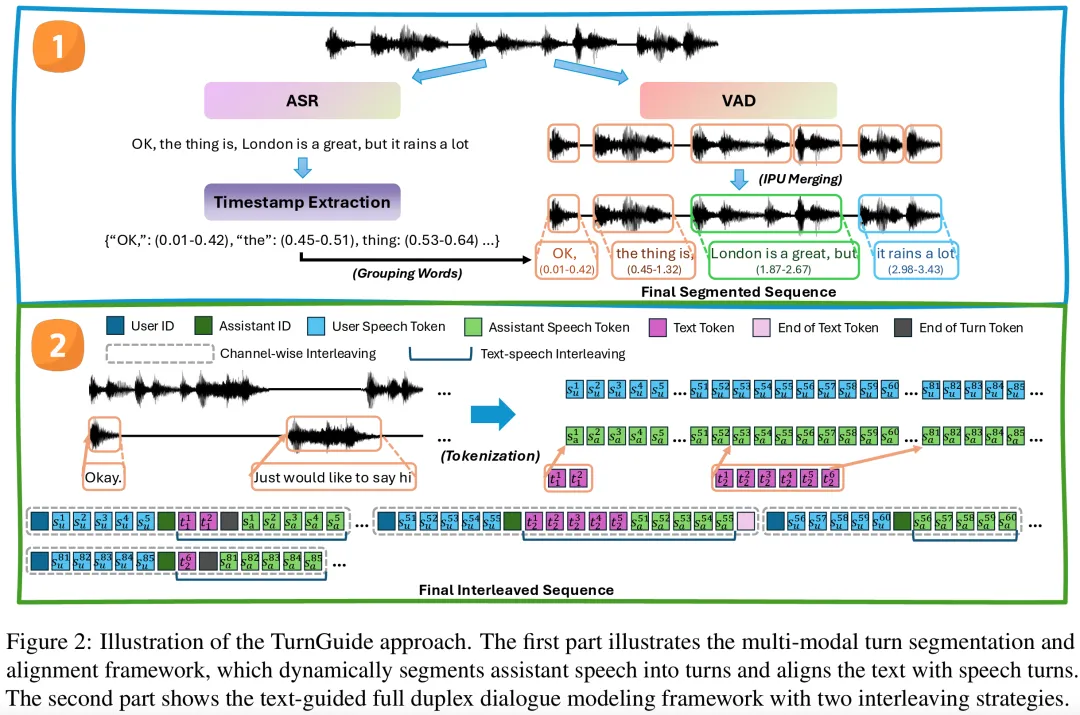
第一步:动态轮次分割与对齐(Dynamic Turn Segmentation and Alignment)
TurnGuide拒绝暴力、盲目地插入文本,而是为真实语音数据进行“精细化手术”。
首先,使用VAD (语音活动检测)精确识别音频流中的语音片段,并将距离相近的片段合并为IPUs (跨停顿单元)。
随后,利用ASR (自动语音识别)提取词级别的时间戳,并将每段文本精准对齐、分组到对应的语音轮次(Turn)中。
这样一来,模型就清楚地知道了哪段文本对应哪段真实的语音,从根本上解决了“何时插入”和“插入多长”的难题。
第二步:文本引导的全双工对话建模(Text-Guided Full Duplex Dialogue Modeling)
在基于GLM-4-Voice架构的训练阶段,TurnGuide采用了极其巧妙的双重交错策略:
通道级交错(Channel-wise Interleaving):将用户和助手的连续音频序列切分成一个个包含5个token(约400毫秒)的“语音块(Speech Chunks)”,然后交错排列,让模型学会捕捉跨通道的交互动态。
文本-语音交错(Text-speech Interleaving):在每一个划分好的对话轮次中,TurnGuide会将文本切分成块,并放置在该轮次对应语音块的生成之前。同时,引入“轮次结束(EOT)”和“块结束(EOC)”的特殊标记,强制模型学习对话的节奏和边界。
⏩实验结果(Experiments):显著超越基线模型
研究团队在Fisher数据集上进行了严苛的评估。实验证明,TurnGuide真正做到了“极致拟人”与“言之有物”的完美统一:
1.语义连贯性:拥有“满分语商”,真正言之有物。在引入GPT-4o进行细粒度的语义评分(GPT-score)以及人类评估的交叉验证下,TurnGuide生成的对话在意义和连贯性上大幅领先。与现有的Moshi模型以及其他语音交错基线方法(如SCI、STI)相比,TurnGuide的语义质量显著提升。
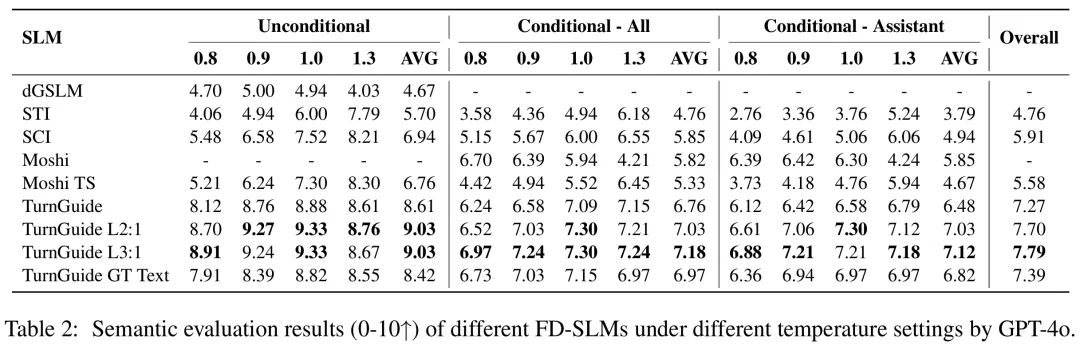
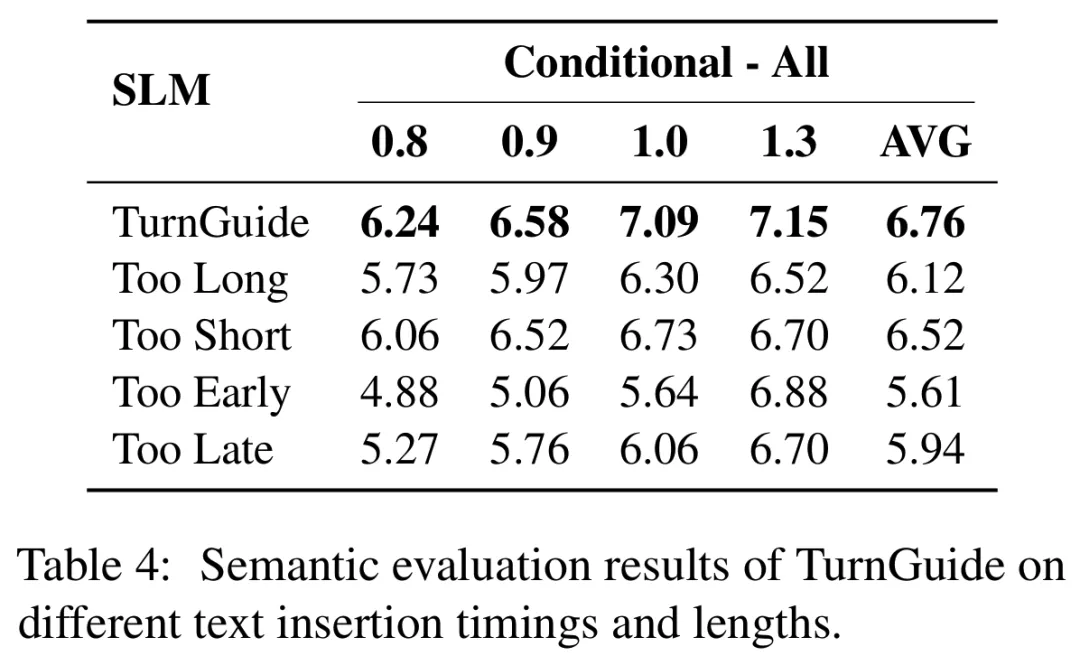
2. 极限测试证明动机:时机与长度决定成败。为了验证设计的必要性,研究者还故意进行了模拟测试。当强制让文本插入“太早”、“太晚”、“太长”或“太短”时,模型生成的对话性能出现了非常显著的下降。这硬核地证明了:在双通道连续对话中,文本插入的时机与长度确实是巨大挑战,而TurnGuide 的动态对齐策略是不可或缺的!
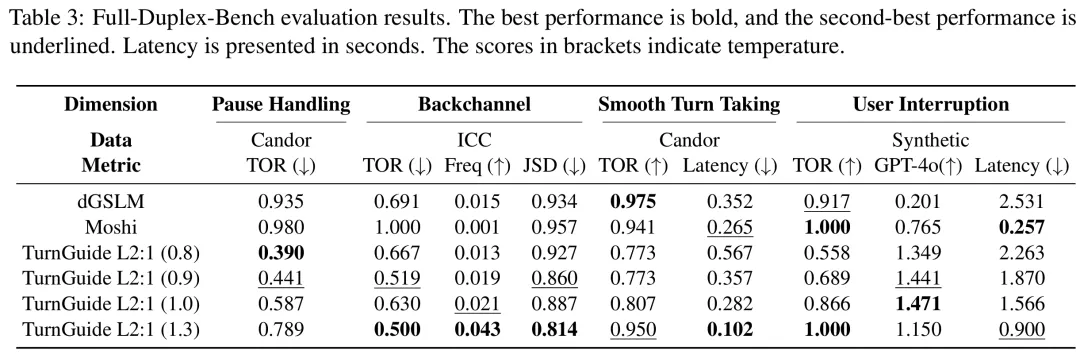
3. 对话自然度:保持“极致拟人交互”。沟通能力变强了,交互会变呆板吗?完全不会!在专门评估微观对话轮换行为的Full-Duplex-Bench 基准测试中,无论是平滑轮换 (Smooth Turn-taking)、应对用户打断 (User Interruption)、处理沉默停顿 (Pause Handling),还是适时的后台确认 (Backchanneling),TurnGuide 均展现出了超越基线模型的极度自然交互能力。
⏩结语
基于真实的双工语音数据进行训练是通向自然交互的必经之路。而TurnGuide 的出现,完美解决了在这条路上“如何聪明地利用文本语义指导”的业界难题。它成功打破了“声学自然度”与“语义连贯性”之间的壁垒,为未来更具意义、更像人类的实时语音交互系统确立了新的标杆。
崔文谦,香港中文大学博士生,致力于语音大模型,多模态大模型,AI音乐生成等方向的研究,其工作发表于ACL,ICML,AAAI,EMNLP等学术会议中。
