
 语音小管家
生成式通用语音增强(Universal Speech Enhancement, USE)旨在利用生成式模型改善各类失真条件下的语音质量。当前主流方法虽能有效提升感知质量,但在语义一致性方面仍面临挑战——生成语音常出现语义偏差、词汇误换或上下文不连贯等问题。这一问题的根源在于传统生成式模型缺乏显式的语义建模机制,仅通过端到端学习难以捕捉语音的深层语言学结构,导致生成内容与原始语义产生偏离。在实际应用场景中,语义错误可能造成语音可懂度低、语音指令误识别等问题,极大限制了生成式增强技术在高可靠性场景的应用。此外,现有的通用增强框架在面对多种复合失真(如噪声叠加混响、削波伴随带宽限制)时,模型难以同时兼顾声学保真度与语义完整性,经常出现"听着清晰但内容错误"的矛盾现象。
作者列表:李星辰,谢晗轲,王子谦,张子晗,肖龙帅,王帅,谢磊
论文预印版:https://arxiv.org/abs/2509.24708
背景动机
语音增强(Speech Enhancement, SE)旨在改善在噪声、混响、信号削波及带宽限制等不良声学条件下退化的语音感知质量与可懂度。传统方法通常针对单一失真类型设计,而通用语音增强(USE)方法则采用单一模型同时处理多种失真类型,近年来受到广泛关注。现有技术主要分为两类:1)判别式方法:通过端到端神经网络建立从退化语音到清晰语音的直接映射,但在严重失真条件下容易引入额外失真与伪影,导致感知质量显著下降;2)生成式方法:利用扩散模型或流匹配技术建模纯净语音分布,在给定退化输入条件下生成对应清晰信号,虽能产生高质量语音,但面临语义不一致问题——在实践中,大量语音幻觉现象仍然存在,难以保留原始语音结构。
与其它生成式任务不同,语音增强更强调利用生成式模型重建高保真纯净语音。然而,由于语音失真的高度复杂性,在某些场景下区分语音成分与干扰信号变得尤为困难。这一挑战构成许多生成式语音增强方法的根本局限:对退化语音中语音成分的准确识别困难,往往导致生成输出与真实纯净语音之间的不匹配,从而降低重建保真度。这种退化通常表现为语义相似度与说话人相似度的下降。尽管基于语言模型的离散标记生成方法或掩码生成模型已取得一定进展,但离散表示的固有信息损失以及细粒度声学标记预测的困难,阻碍了这些方法有效解决语义不一致问题。扩散模型或流匹配方法虽建立了退化语音与纯净语音分布之间更直接的映射,通常能达到较高的整体保真度,但语音成分混淆问题依然存在,尤其在严重失真条件下更为突出。
针对上述挑战,我们提出了SenSE——一种语义感知的双阶段生成式通用语音增强框架。该框架创新性地引入语义感知语音语言模型(Semantic-Aware Speech Language Model)建模语义先验,通过语言模型从完整退化语音输入中显式建模语义标记分布。与先前基于语言模型的语音增强方法不同,我们利用语言模型建模语义先验,而非直接生成完整语音。此外,我们设计了双路径掩码条件训练策略,使流匹配模型能够灵活整合退化语音声学线索、语义线索及参考语音等多源条件信号,在防止过拟合退化声学特征的同时提升模型泛化能力。
提出的方案
如图1所示,SenSE由两个关键阶段组成:
语义感知语音语言模型:该模块采用语言模型,从对退化语音进行编码得到的连续语音嵌入中提取纯净的语义标记(semantic tokens)。
语义引导的基于流匹配的语音增强:第一阶段获得的语义标记被作为额外的条件引入到基于流匹配的语音增强过程中,从而在生成过程中更好地保留语义信息。
双路径掩码条件训练策略使模型能够充分利用所有可用信息,以生成干净的语音。
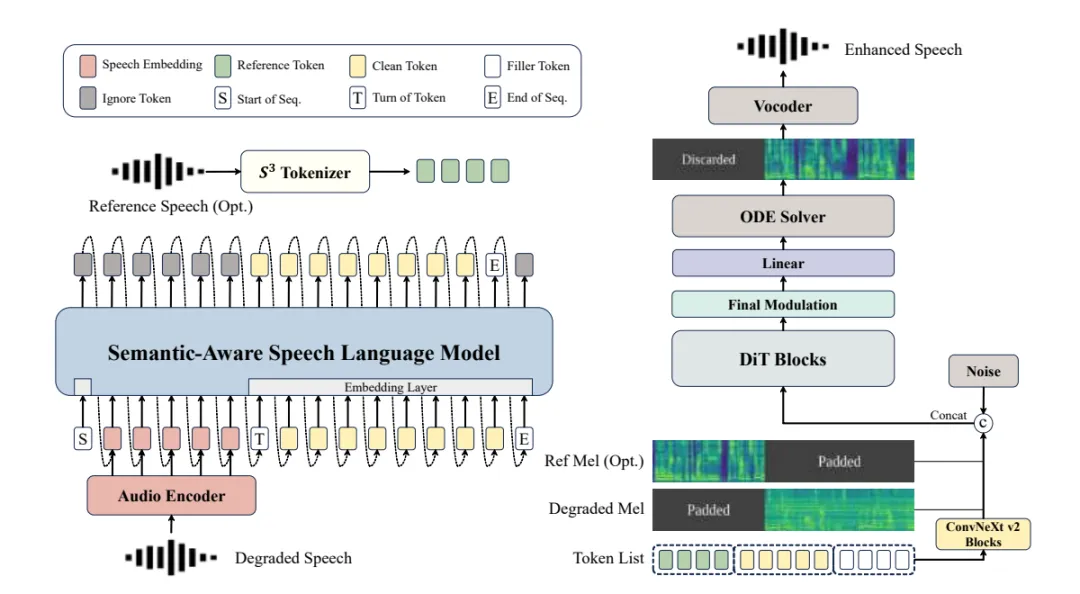
图1 SenSE的两阶段架构的概述
语义感知语音语言模型(SASLM)
该模块以随机初始化的LLaMA模型为骨干网络,接收语音编码器提取的连续表示与S³ Tokenizer生成的离散语义标记作为联合输入,通过next-token预测训练目标实现语义建模能力的学习。该架构的核心创新在于利用语言模型强大的序列建模能力,建立从退化语音嵌入到干净语义空间的映射关系。S³ Tokenizer(来自CosyVoice项目)创新性地将SenseVoice ASR模型与量化模块(VQ/FSQ)深度融合,能够从任意语音信号中提取高度抽象的离散语义标记,这些标记编码了语音内容中的语言学信息,包括词汇序列、语法结构及语义关系,而非声学细节。在训练阶段,SASLM采用"⟨Start⟩, 语音嵌入, ⟨Turn⟩, 语义标记, ⟨End⟩"的序列格式,以自回归方式预测下一个语义标记,使模型学习如何从带噪的语音表示中恢复纯净的语义序列。推理阶段则冻结SASLM参数,将其作为语义提取器从输入语音中生成语义约束序列,为后续流匹配增强提供高层语义指导。
语义引导的流匹配语音增强
该模块采用F5-TTS风格的DiTblocks作为生成骨干网络,通过零初始化的自适应层归一化(adaLN-zero)机制实现条件信息的有效注入。与传统扩散模型需要数百步迭代采样不同,流匹配技术建立了从噪声分布到目标分布的直接映射,通过预设的速度场实现高效生成。训练过程中,输入被构造为 (1-t)x₁ + tx₀ 的线性插值形式,其中x₀采样自标准正态分布,t采样自均匀分布U[0,1],模型学习预测速度场v=dx/dt。条件信号的注入采用多分支架构:声学条件通过掩码操作整合掩码纯净语音m₁⊙x₁与不完整退化语音m₂⊙y,保留部分原始声学结构信息;语义条件则将第一阶段生成的语义标记序列与填充标记混合后,通过ConvNeXt V2模块编码为与语音特征维度对齐的向量表示。两类条件信号经交叉注意力机制与主生成网络交互,引导生成过程朝语义一致的方向演化。该模块支持灵活的条件组合策略:在标准模式下仅使用退化语音与语义标记作为条件;在参考增强模式下可额外引入高质量参考语音,为严重失真场景提供说话人信息补充。生成后的频谱特征通过BigVGAN或Vocos声码器转换为高质量语音波形。
双路径掩码条件训练策略
该策略是实现语义一致性与声学保真度协同优化的关键设计,通过两条互补路径整合多源条件信号并防止模型对退化特征的过拟合,如图2所示。第一路径以掩码纯净语音m₁⊙x₁为主干输入,模型学习在部分干净信号引导下重建完整纯净语音,该路径确保了生成结果保持较高的声学保真度;第二路径以退化语音y经随机时序掩码后的m₂⊙y作为条件输入,强迫模型在缺失大量声学信息的条件下,主要依赖语义标记提供的语言学线索进行语音重建。两路径的输出通过门控机制自适应融合,使模型能够根据失真严重程度动态调整对声学线索与语义线索的依赖权重。退化掩码策略采用随机时序掩蔽设计,在每个训练样本上随机选择若干时间帧将其置零,确保模型在训练初期依赖声学线索快速学习,在训练后期转向语义主导的生成模式。此外,该框架支持参考语音的引入——通过说话人编码器从同说话人的高质量参考样本中提取说话人嵌入,在流匹配过程中将其作为额外条件信号注入,有效解决了严重失真场景下说话人信息丢失的问题,显著提升了SIM-o(说话人相似度)指标。
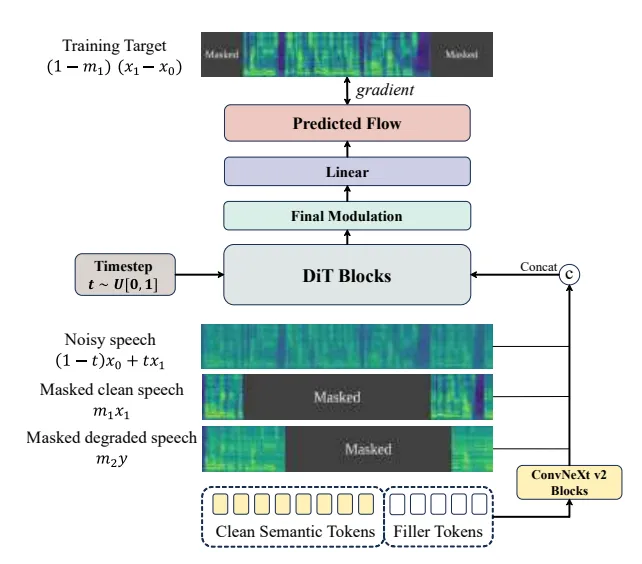
图2 所提出的双路径掩码条件训练策略示意图
实 验
实验数据:基于Emilia ZH/EN以及DNS Challenge干净语音库,基于DEMAND、ESC-50以及DNS Challenge的噪声数据集,以及基于SLR26,SLR28的RIR数据集,进行多失真类型仿真训练,包括噪声(SNR∈[-10, 10]dB,概率0.9)、混响(概率0.5)、削波(阈值∈[0.05, 0.90],概率0.25)及带宽限制(2/4/8/16/22.05kHz,概率0.5)。
对比系统:
VoiceFixer[1]:判别式语音修复模型
TF-GridNet[2]:判别式通用语音增强的经典模型
PGUSE[3]:判别式与生成式结合的USE模型
GenSE[4]:基于扩散的生成式增强模型
LLaSE-G1[5]:基于LLaMA的多任务语音增强模型
FlowSE[6]:基于流匹配的语音增强方法
AnyEnhance[7]:基于MGM的生成式增强框架
表1展示了不同模型的参数量以及RTF,表示模型的规模和计算复杂度。其中SenSE_tiny的参数量、计算量相比于其他生成式的baseline更小,SenSE_base则进行了规模化来体现模型的性能上限。
表1 SenSE 及其他对比模型的模型大小和 RTF
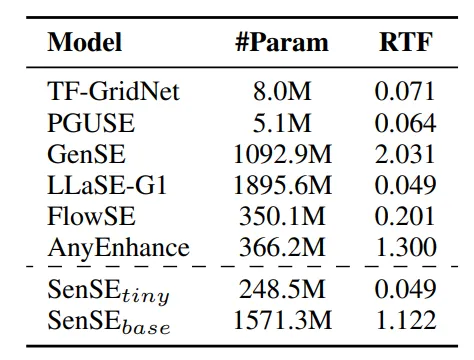
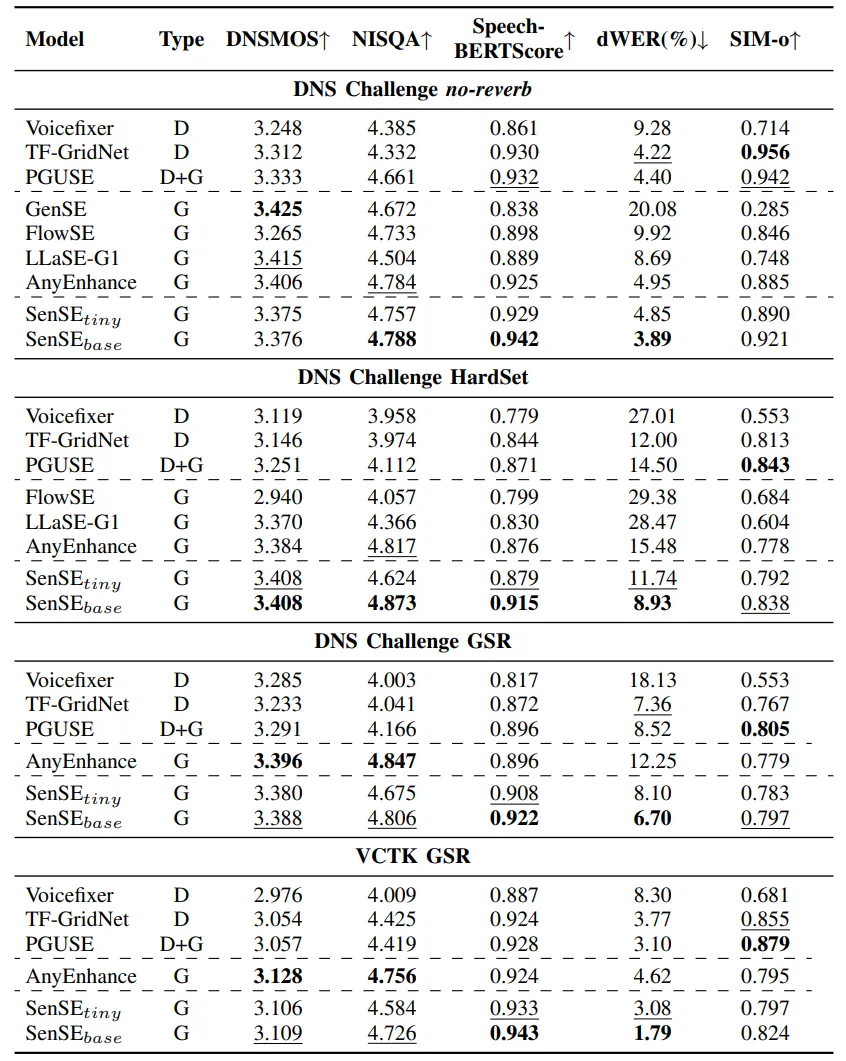
表2展示了SenSE与各基线方法在各个测试集上的性能对比。SenSE_base在DNSMOS、NISQA等感知质量指标上达到最优,同时在SpeechBERTScore(语义相似度)和dWER(词错误率差异)上取得所有生成式方法中的最佳表现,验证了语义引导机制的有效性。SenSE_tiny尽管计算复杂度较小,与其他baseline相比也同样具备较强的竞争性。
表2 所提出的方法和对比模型在多个测试集上的结果。粗体表示最佳结果,下划线表示次佳结果。“D”和“G”分别表示判别式方法和生成式方法。对比中均未使用参考语音。
消融实验:
我们进行了系统性消融研究,分析各模块对整体性能的贡献,结果如图3所示。语义引导机制在所有评估指标上均带来一致提升,特别是SpeechBERTScore和SIM-o(说话人相似度)两个语义相关指标的显著改善,证明了语言模型引导的双阶段架构对于保持语义一致性的关键作用。
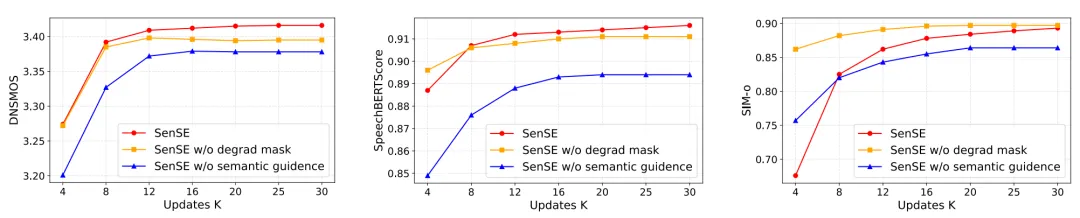
图3 对SensE框架进行消融研究的结果,其中“w/o”表示移除特定方法或组件。
退化掩码策略的消融结果表明:虽然初期训练指标略有下降,但最终收敛性能明显超越基线模型,且训练过程更加稳定。该策略有效防止了模型对退化声学线索的过拟合,增强了模型在复杂失真场景下的鲁棒性。
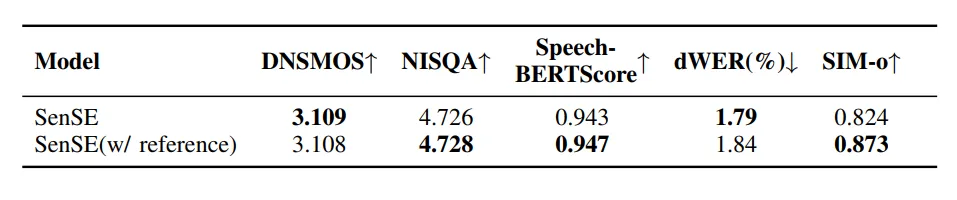
如表3所示的参考语音消融实验显示:引入同说话人参考语音后,SIM-o指标从0.824提升至0.873,其他感知质量指标保持相当水平,证实了参考语音对说话人信息恢复的重要价值。
表3 参考语音的影响
相关工作
LLaSE-G1 | 激发语言模型在语音增强任务上的泛化能力
Interspeech2025 | FlowSE — 基于流匹配的高效语音增强
ICLR2025 | GenSE: 基于层次化建模的生成式语音增强
参考文献
[1] Haohe Liu, Xubo Liu, Qiuqiang Kong, Qiao Tian, Yan Zhao, DeLiang Wang, Chuanzeng Huang, and Yuxuan Wang, “VoiceFixer: A Unified Framework for High-Fidelity Speech Restoration,” in Interspeech, 2022, pp. 4232–4236.
[2] Zhong-Qiu Wang, Samuele Cornell, Shukjae Choi, Younglo Lee, Byeong-Yeol Kim, and Shinji Watanabe, “Tf-gridnet: Making timefrequency domain models great again for monaural speaker separation,” in ICASSP, 2023, pp. 1–5.
[3] Jie Zhang, Haoyin Yan, and Xiaofei Li, “A composite predictivegenerative approach to monaural universal speech enhancement,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2025.
[4] Jixun Yao, Hexin Liu, Chen Chen, Yuchen Hu, EngSiong Chng, and Lei Xie, “GenSE: Generative speech enhancement via language models using hierarchical modeling,” in ICLR, 2025.
[5] Boyi Kang, Xinfa Zhu, Zihan Zhang, Zhen Ye, Mingshuai Liu, Ziqian Wang, Yike Zhu, Guobin Ma, Jun Chen, Longshuai Xiao, Chao Weng, Wei Xue, and Lei Xie, “LLaSE-g1: Incentivizing generalization capability for LLaMA-based speech enhancement,” in ACL, 2025, pp. 13292–13305
[6] Ziqian Wang, Zikai Liu, Xinfa Zhu, Yike Zhu, Mingshuai Liu, Jun Chen, Longshuai Xiao, Chao Weng, and Lei Xie, “FlowSE: Efficient and HighQuality Speech Enhancement via Flow Matching,” in Interspeech, 2025, pp. 4858–4862.
[7] Junan Zhang, Jing Yang, Zihao Fang, Yuancheng Wang, Zehua Zhang, Zhuo Wang, Fan Fan, and Zhizheng Wu, “Anyenhance: A unified generative model with prompt-guidance and self-critic for voice enhancement,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 33, pp. 3085–3098, 2025.
