
 语音小管家
文生音频(Text-to-audiogeneration, T2A)与视频配音(Video-to-audiogeneration, V2A)等音频生成任务近年来随着扩散模型的发展取得了显著进展。现有研究从数据空间、网络结构以及条件控制等多个角度不断优化生成效果,但大多数方法仍依赖于模型的重新训练,带来了较高的计算成本与应用门槛。
在采样阶段,Classifier-Free Guidance (CFG)被广泛用于增强生成结果与条件之间的对齐程度,从而提升音频质量。然而,这类方法往往以牺牲生成多样性为代价,导致结果不够丰富。近期提出的Autoguidance (AG)方法尝试在保持多样性的同时进行引导,但在音频生成任务中的表现仍不及CFG。
为解决上述问题,清华大学和生数科技提出了一种无需额外训练的音频生成采样方法AudioMoG,通过融合多重引导机制,在不增加训练开销的前提下,同时提升生成质量与多样性,有效改进了T2A, V2A等音频任务的表现。目前,该工作已被IEEE ICME 2026录用。
论文链接:https://arxiv.org/pdf/2509.23727
Demo链接:https://audiomog.github.io/
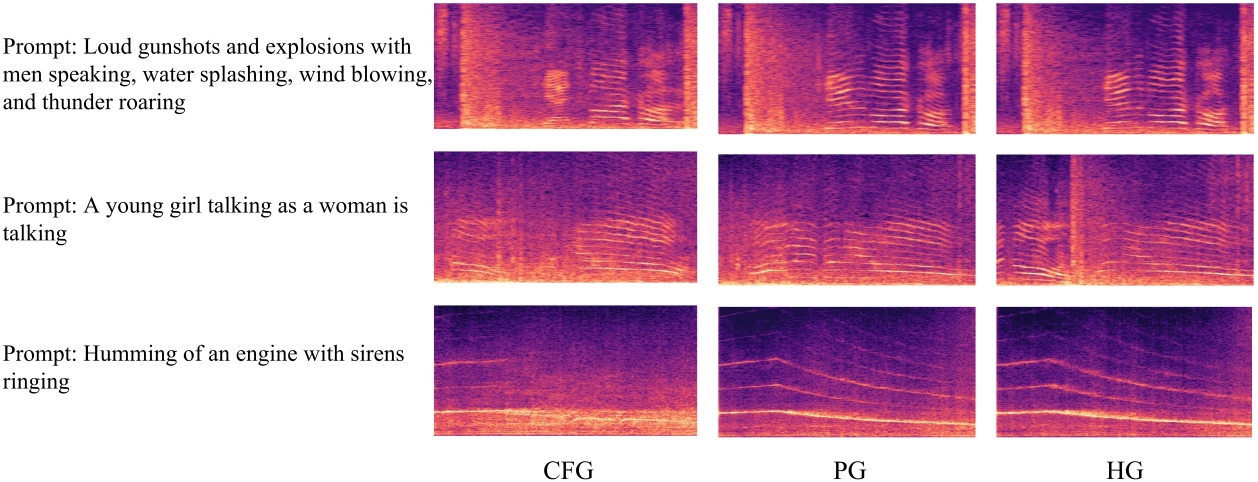
音频1:左列为CFG方法,中间列和右列分别是我们提出的PG和HG方法
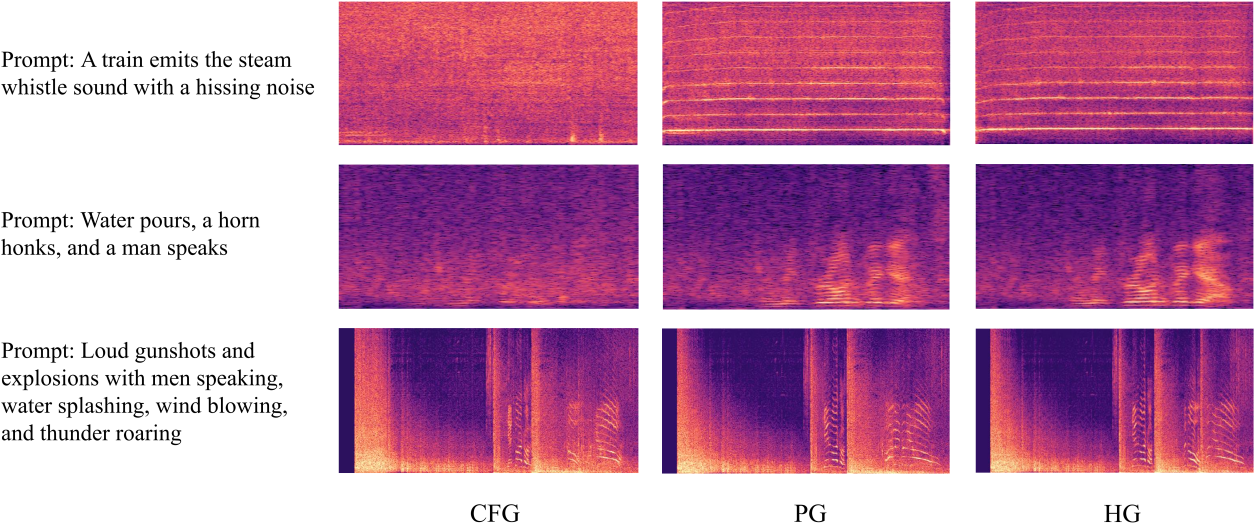
音频2
尽管近年来T2A和V2A技术取得了显著进展,但在生成质量与多样性的平衡以及高效优化方面仍面临关键挑战:
现有方法主要从数据增强、模型结构和条件控制等多个角度提升生成效果,但大多依赖模型的重新训练或复杂的工程优化,带来了较高的计算成本与应用门槛,限制了方法的实际可扩展性。
在采样阶段,CFG虽被广泛用于增强生成结果与条件之间的对齐程度,但往往以牺牲多样性为代价,导致生成结果缺乏丰富性;而近期提出的AG方法虽然在一定程度上缓解了这一问题,但在音频生成任务中表现仍不稳定,难以全面超越CFG。
不同引导方法在生成过程中具有互补优势,但现有工作缺乏对其内在机制的系统分析与有效整合,导致其潜力尚未被充分挖掘,限制了采样阶段进一步优化生成质量的空间。
为应对上述挑战,本文提出AudioMoG,一种无需额外训练的多重引导音频生成框架。该方法从引导机制的角度出发,系统分析了CFG与AG的行为差异与内在局限:其中,CFG通过耦合“分数(score)修正”与“条件对齐增强”来提升生成质量,但难以在质量与多样性之间实现独立调控;而AG则通过引入弱模型以解耦分数修正过程,在提升质量的同时保留多样性,但其效果对弱模型选择较为敏感。在此基础上,AudioMoG充分挖掘不同引导方式的互补优势,设计了并行引导(Parallel Guidance, PG)与层级引导(Hierarchical Guidance, HG)两种融合策略,实现多种引导机制的协同优化与优势累积。AudioMoG能够在不增加训练开销的前提下,同时提升生成质量与多样性,在T2A与V2A等任务中均取得了稳定且显著的性能提升。
AudioMoG首先对CFG与AG方法进行统一分析,以揭示其内在机制与局限性。
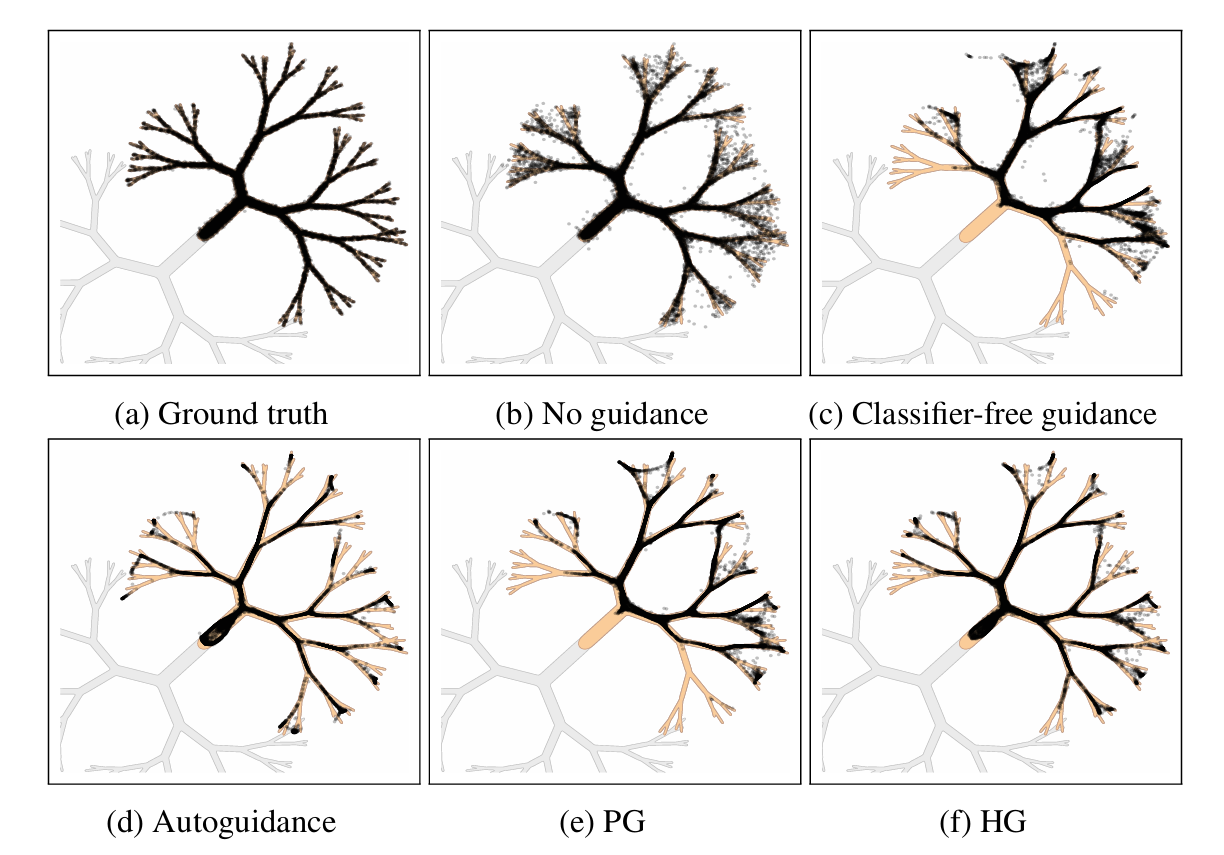
图1:对不同指导方式的可视化
1.CFG:通过结合有条件与无条件预测结果,增强生成内容与输入条件之间的对齐程度,其形式为:
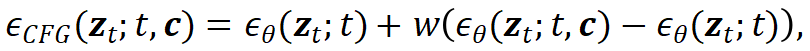
其中 控制条件引导强度。CFG在提升生成质量的同时,本质上同时引入了“分数修正”和“条件对齐增强”两种作用,但二者相互耦合,往往导致多样性下降,难以实现独立调控。
2.AG:通过引入一个弱模型,并利用强弱模型之间的差异对生成过程进行修正,其形式为:
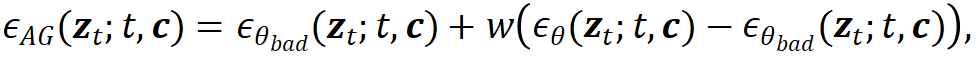
其中 表示一个弱模型,通常具有更小的模型规模或更少的训练程度。该方法能够在一定程度上解耦分数修正过程,在提升质量的同时保留多样性,但其效果依赖于弱模型的构建,稳定性较差。
进一步地,我们通过一个二维toy实验对两种方法的机制进行分析,如图1所示。结果表明:CFG的提升来源于“强弱模型(条件模型与无条件模型)对比带来的分数修正”,但同时伴随着条件对齐的过度放大,从而可能导致分布收缩和多样性下降;而AG则通过显式引入弱模型,分离了这一修正过程,在不破坏分布形态的前提下改善生成质量。然而,当弱模型构建不合理时,其引导效果会显著下降。
总体来看,CFG更侧重于条件对齐,而AG更侧重于误差修正,二者具有互补优势,但单独使用时均存在明显局限,这为后续多重引导机制的设计提供了基础。
基于上述引导机制分析,AudioMoG将CFG与AG进行统一建模,并提出两种融合策略,实现不同引导信号的协同优化:
1.并行引导(Parallel Guidance, PG):在每一步采样过程中,并行引入CFG与AG两种引导信号,从条件对齐与分数误差修正两个角度对生成结果进行共同优化,其形式为:
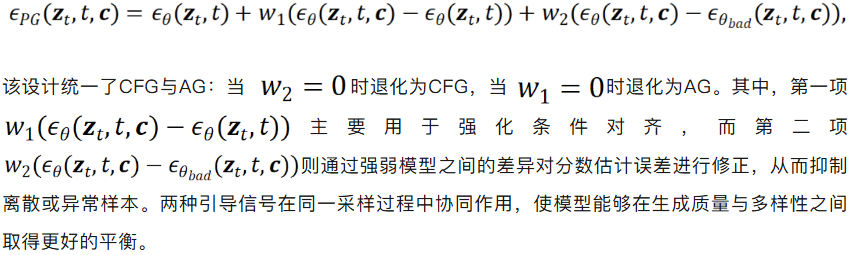
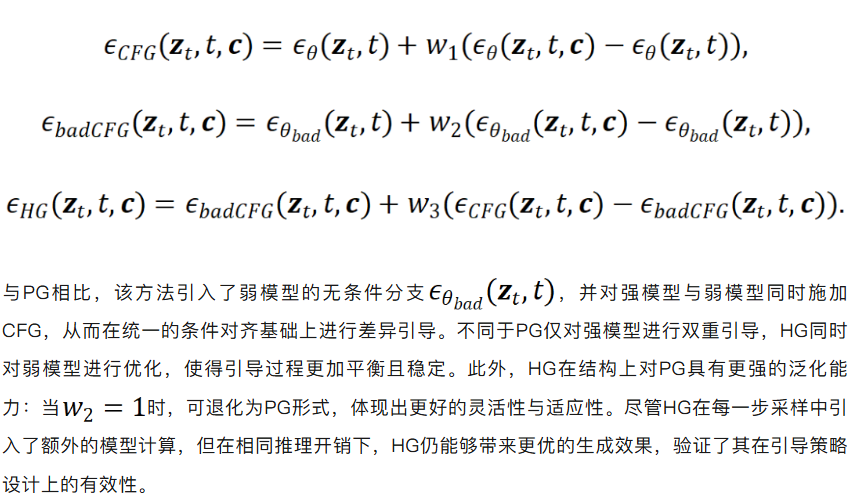
2.层级引导(Hierarchical Guidance, HG):尽管PG能够有效融合CFG与AG,但其默认两种引导信号在每一步采样中是相互兼容的。实际上,二者在作用方向上可能存在干扰:一方面,过强的条件对齐可能导致生成结果趋于单一;另一方面,基于弱模型的误差修正可能引入语义偏移。为更好地协调这两种机制,AudioMoG提出分阶段的层级引导策略,通过结构化地组织引导过程,实现更加稳定和有效的生成优化。具体形式为:
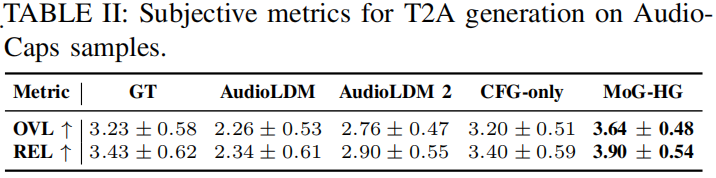
在T2A实验中,AudioMoG在AudioCaps测试集上显著优于基线方法。在相同推理开销(固定NFE)下,相较于仅使用CFG的模型,AudioMoG在FAD, KL, IS, CLAP相似度等多个客观指标上均取得一致提升,并在主观评估中同样取得了最高的音频整体质量与语义相关性评分,表明其能够在不增加计算成本的前提下有效提升音频生成质量。进一步消融实验表明:
1.PG和HG均明显优于CFG,其中HG在各项指标上表现更佳,展现出更优的效果,这一结果验证了HG在协调不同引导信号、提升生成稳定性方面的优势。
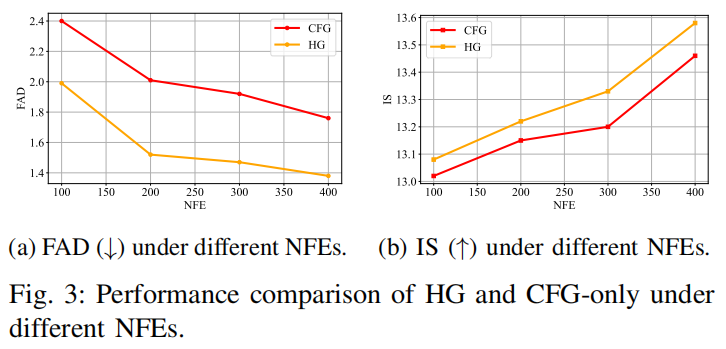
2.在不同推理步数的对比实验中,HG在100、200、300和400等多种NFE下均持续优于CFG,在FAD与IS上保持稳定领先。这表明AudioMoG在不同推理资源条件下均具备良好的鲁棒性与适应性,既能够在低计算开销下维持较高生成质量,也能够在更高计算预算下进一步释放性能潜力。
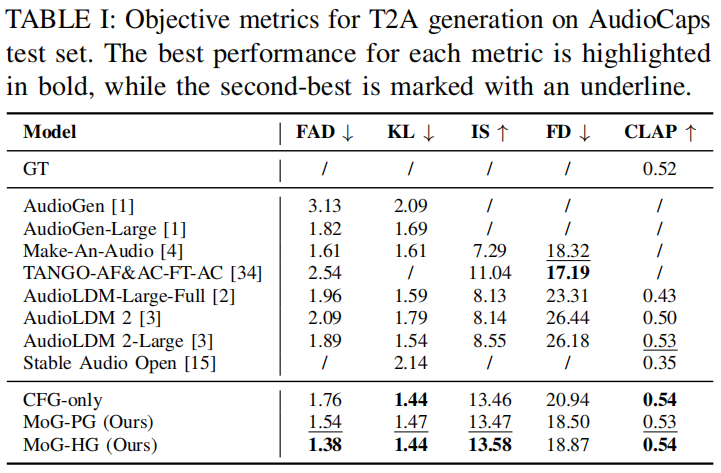
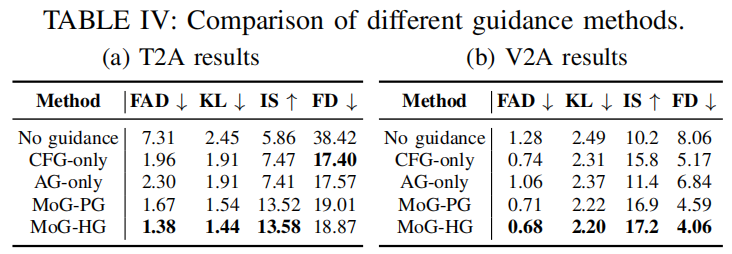
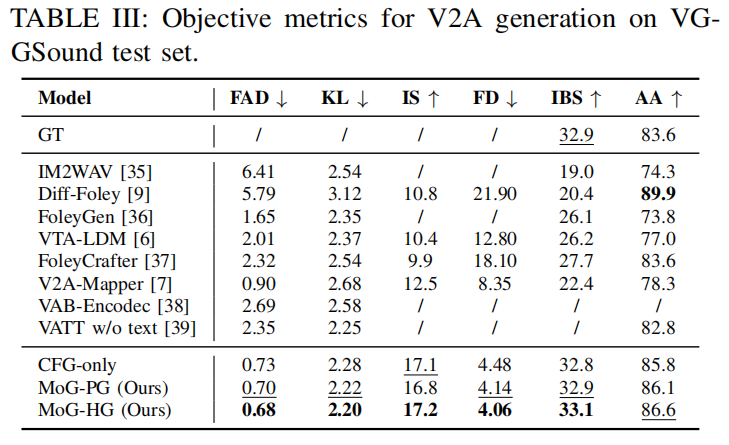
在V2A任务中,AudioMoG同样展现出优越的性能。在VGGSound测试集上的评估结果表明,该方法在音频质量(如FAD、KL、IS、FD)以及跨模态对齐(如ImageBind对齐度IBS)和时间一致性(AA)等多个维度均取得全面提升。尤其是在时间对齐这一关键指标上,AudioMoG显著优于CFG,说明其能够更准确地捕捉视频与音频之间的时序关系。整体结果表明,AudioMoG不仅适用于文本驱动的音频生成,也能够有效提升跨模态音频生成任务的性能。
本文提出了AudioMoG,一种基于多重引导机制的音频生成框架,从采样阶段出发提升生成质量。在方法设计上,我们系统分析了CFG与AG的作用机制,并据此提出了并行引导(PG)与层级引导(HG)两种融合策略,分别从直接并行组合与分阶段协同的角度充分挖掘不同引导方式的互补优势。在实验方面,AudioMoG在不增加推理开销的前提下,在T2A和V2A等音频生成任务中均显著优于广泛使用的CFG方法,验证了所提出方法在不同模态与生成任务中的通用性与有效性。
未来工作中,我们将进一步探索更加自适应的引导组合策略,以动态协调不同引导信号之间的关系;同时,将该框架拓展至更复杂的多模态生成场景与更大规模模型中,以进一步提升生成质量与可控性。
作者介绍
王俊又是中国科学技术大学少年班学院的本科生,主要研究方向是音频与多模态相关的生成模型,曾以第一作者身份在多媒体领域国际会议上发表相关研究工作。
