
 语音小管家
标题:《Audio Flamingo Next: Next-Generation Open Audio-Language Models for Speech, Sound, and Music》
链接:https://arxiv.org/abs/2604.10905
作者单位:NVIDIA、University of Maryland
发表日期:2026 年 04 月 13 日
开源地址:https://github.com/NVIDIA/audio-flamingo
值得参考的点
Temporal Audio Chain-of-Thought(时间锚定推理链):与以往 CoT 数据主要针对短音频的做法不同,AF-Next 将推理链中的每一步骤显式绑定到音频时间戳,这一设计在需要跨多个时间片段聚合证据的长音频场景下效果明显。
三变体差异化发布策略:AF-Next 同时开源 AF-Next-Instruct(通用 QA)、AF-Next-Think(链式推理)、AF-Next-Captioner(详细描述)三个检查点,以满足不同下游需求,而非强求一个检查点兼顾所有场景。
RoTE(Rotary Time Embeddings)替换标准 RoPE:位置编码的旋转角度由绝对时间戳
背 景
Large Audio Language Model(LALM)领域的开源进展一直落后于视觉语言模型。现有开源模型存在两类主要问题:一是训练数据过度依赖学术基准数据集,导致模型在真实世界长音频、噪声场景下泛化能力弱;二是 CoT 推理数据局限于短音频,在需要跨时间段聚合证据的复杂问题上收益有限。
NVIDIA 与马里兰大学联合推出的 Audio Flamingo Next(AF-Next)是 Audio Flamingo 系列的最新一代,与 AF3 相比,AF-Next 在四个维度做出改进:更强的基础音频语言模型、超越学术数据集的大规模数据构建策略、最长 30 分钟的长音频原生支持,以及新提出的 Temporal Audio Chain-of-Thought 推理范式。
核心方法
模型架构
AF-Next 延续 Audio Flamingo 3 的四组件结构,但各组件均有调整。
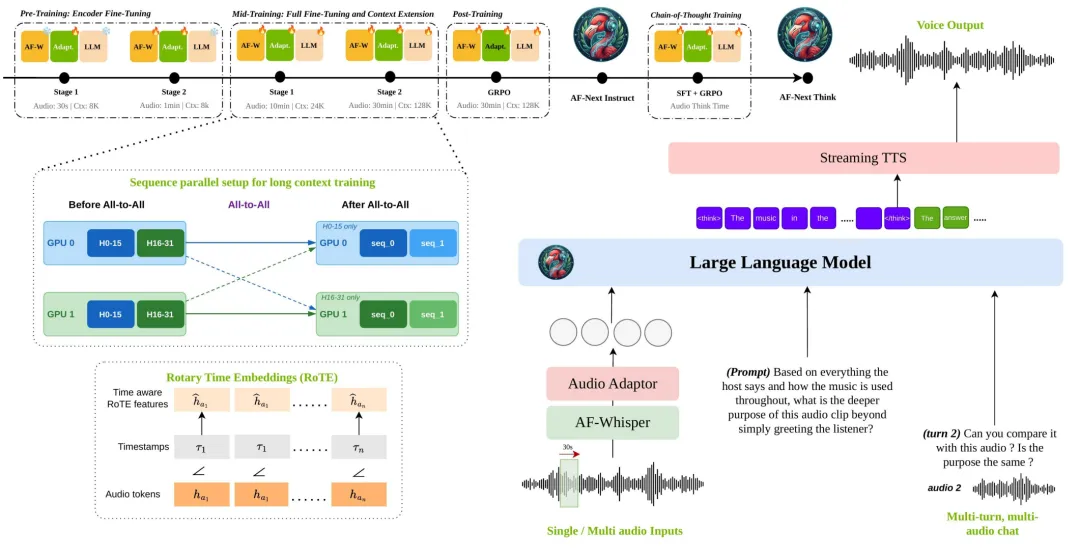
题注:AF-Next 整体架构,展示 AF-Whisper 编码器、音频适配器、LLM 骨干与 Streaming TTS 四组件的连接关系
AF-Whisper 音频编码器:基于 Whisper 架构的定制编码器,在更大、更多样化的语料(含多语种语音和多说话人 ASR 数据)上进一步预训练。输入音频重采样至 16 kHz 单声道,转换为 128 通道 log mel 频谱图(25 ms 窗口,10 ms 帧移),隐层维度为1280,输出特征帧率 50 Hz,经步长为 2 的池化层下采样。音频以非重叠 30 秒为单位分块处理。
音频适配器:2 层 MLP,将 AF-Whisper 的音频表示
LLM 骨干:Qwen-2.5-7B,解码器-only 因果语言模型,参数量 7B,36 层 Transformer,16 个注意力头。上下文长度通过额外的长上下文训练从 32K 扩展至128K tokens。原始 RoPE 被替换为RoTE(Rotary Time Embeddings)¹:旋转角定义为
Streaming TTS:基于解码器-only Transformer 的流式文字转语音模块,以 LLM 输出的 subword 文本 token 和已生成的音频 token 为条件逐步预测下一个音频 token,支持语音对语音交互。
训练策略
AF-Next 采用四阶段课程式训练。
预训练(2 个 Stage):Stage 1 仅训练音频适配器,AF-Whisper 和 LLM 均冻结,最大音频时长 30 秒,上下文上限 8K tokens;Stage 2 进一步解冻音频编码器和适配器,LLM 仍冻结,最大音频时长 1 分钟,上下文上限 8K tokens。两阶段均以分类、描述、ASR 等识别导向数据为主。
中训练(2 个 Stage):Stage 1 全参数微调,引入 AudioSkills-XL 和新采集数据集,最大音频时长 10 分钟,上下文上限 24K tokens;Stage 2 加入长音频描述与 QA 数据,Stage 1 数据的混合权重降至原来的一半,长音频数据集混合权重设为 1,最大音频时长30 分钟,上下文上限128K tokens。中训练结束后得到AF-Next-Captioner。
后训练(GRPO 强化学习):从中训练检查点出发,进行基于 GRPO 的强化学习,专注于多轮对话、安全性、指令遵循及 AudioSkills-XL 中的选定技能,得到AF-Next-Instruct。
CoT 训练:从 AF-Next-Instruct 出发,先对 AF-Think-Time 数据集做 SFT,再以后训练混合数据做 GRPO,得到AF-Next-Think。
Temporal Audio Chain-of-Thought
AF-Think-Time 是专门为时间锚定推理构建的新数据集,包含约 43K条训练样本。数据来源为预告片、电影摘要、悬疑故事、长时多方对话等难度较高的音频,配以需要深度时间推理的问答对。构建流程:先为每条音频生成时间戳标注 caption,再以 LLM 合成"问题–答案–推理链"三元组,推理链中的每个中间步骤均与时间戳绑定。推理链平均446.3 词。
长上下文训练工程
处理超长音频序列的技术挑战通过两项机制解决:
序列打包(Sequence Packing):三阶段策略——SP 感知采样确保同一 SP 组内所有 GPU 收到相同样本索引;数据整理器对批次内序列做填充和截断;音频 token 展开阶段将占位 token 替换为基于时长的实际音频嵌入 token 序列。
混合序列并行(Hybrid Sequence Parallelism):采用统一序列并行(USP),分解为 Ulysses 度
数据情况
AF-Next 的训练数据总规模约为108M 条样本,约1M 小时,来源涵盖公开学术数据集和互联网采集音频。各方向数据构成如下:
音乐理解:来自 Music Flamingo 的 MF-Skills 数据,以及扩充的多语种音乐歌词数据。 多说话人语音:包括说话人识别、打断识别、目标说话人 ASR 三类任务,共扩充约 45K条训练样本至 AF-Skills。 长音频描述(互联网采集):约200K 条来自互联网的 5–30 分钟长视频,每段生成视频描述、音频描述、语音转录、语言副语言描述四种 caption,再由 LLM 整合,并同步合成针中有 haystack 型 QA、时序 QA、子场景 QA 等类型的训练样本。 AudioSkills-XL 真实场景扩充:从上述长视频中采样 10–30 秒片段,以信息量评分筛选后生成覆盖 AudioSkills-XL 技能集的 QA 数据,共获得200 万+条新样本。 多音频推理:约1M 条交错式音频-文本指令遵循样本。 多轮对话:约30K 条多轮多音频对话样本。 安全与指令遵循:约386K 条样本,包含拒绝式回答数据,是 LALM 领域较少关注的方向。 多语种 ASR/AST:来自 Emilia、CoVoST、MUST、Amazon-SIFT、ALI meeting、aidatatang、aishell、Granary 等数据集。 纯文本 SFT:科学、数学、指令遵循、通用知识领域数据,用于维持模型文本推理能力。 AF-Think-Time(时间锚定 CoT):约43K 条问题–答案–推理链三元组,推理链平均 446.3 词。
实验与结果
AF-Next 在 128 块 NVIDIA H100 GPU 上完成全流程训练。评估涵盖 20+ 个基准,同时对比开源、开放权重及闭源模型。
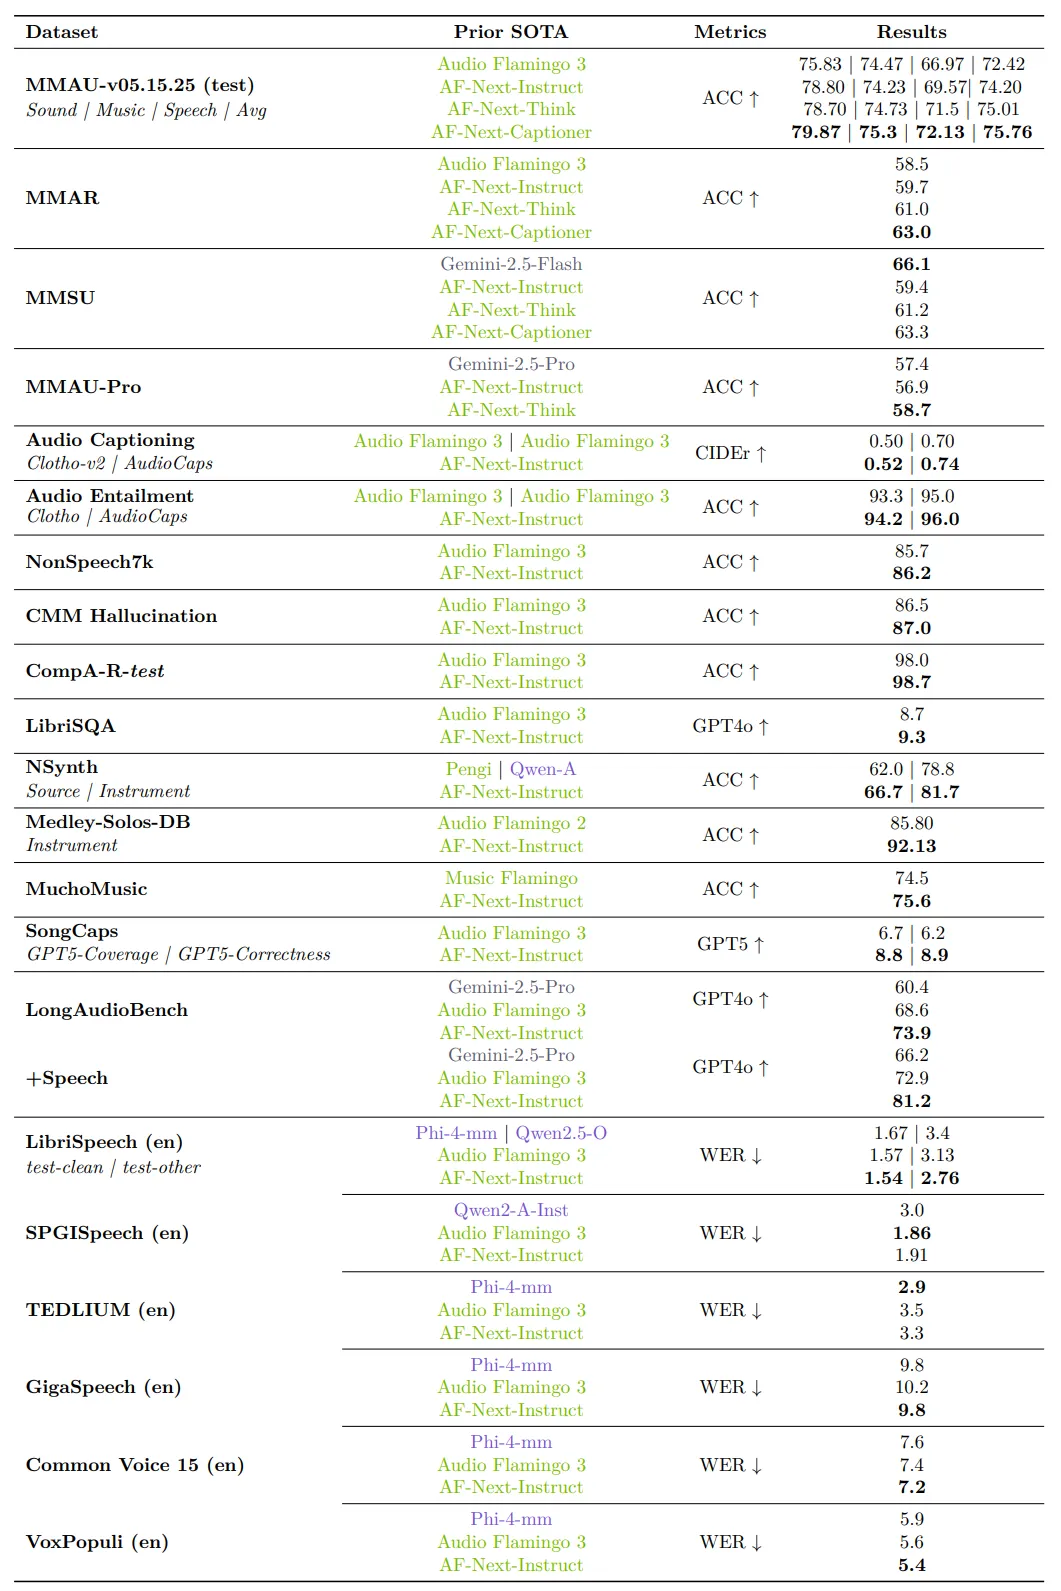
题注:AF-Next 三变体与各 SOTA 模型在音频理解、ASR、音乐等多基准上的综合对比
音频理解与推理
在 MMAU-v05.15.25 上,AF-Next-Instruct 取得平均准确率74.20(AF3 为 72.42),AF-Next-Think 进一步提升至 75.01,AF-Next-Captioner 达到75.76(Sound 79.87、Music 75.3、Speech 72.13)。在更具挑战性的 MMAU-Pro 上,AF-Next-Think(58.7)超过闭源 Gemini-2.5-Pro(57.4)。在 MMAR 上,AF-Next-Captioner 达到 63.0,相比 AF3 的 58.5 提升4.5 个百分点。
长音频理解
AF-Next 在长音频任务上的优势最为突出。在 LongAudioBench 上,AF-Next-Instruct 取得73.9分,超过 AF3(68.6)和闭源 Gemini 2.5 Pro(60.4)。在包含语音的更难变体(+Speech)上,AF-Next 达到81.2,远超 AF3(72.9)和 Gemini 2.5 Pro(66.2)。
自动语音识别
AF-Next-Instruct 在 LibriSpeech test-clean 上取得 WER1.54%,test-other 为2.76%,均优于 AF3 和 Phi-4-mm、Qwen2.5-Omni 等开放权重模型。在 Common Voice 15(WER 7.2%)、GigaSpeech(WER 9.8%)、VoxPopuli(WER 5.4%)上也达到最优或持平最优水平。
音乐理解
在 Medley-Solos-DB 乐器识别任务上,AF-Next 达到92.13%(AF2 为 85.80%)。在 SongCaps 音乐描述任务上,GPT5 覆盖率和正确率分别从 AF3 的 6.7 和 6.2 提升至8.8和8.9。
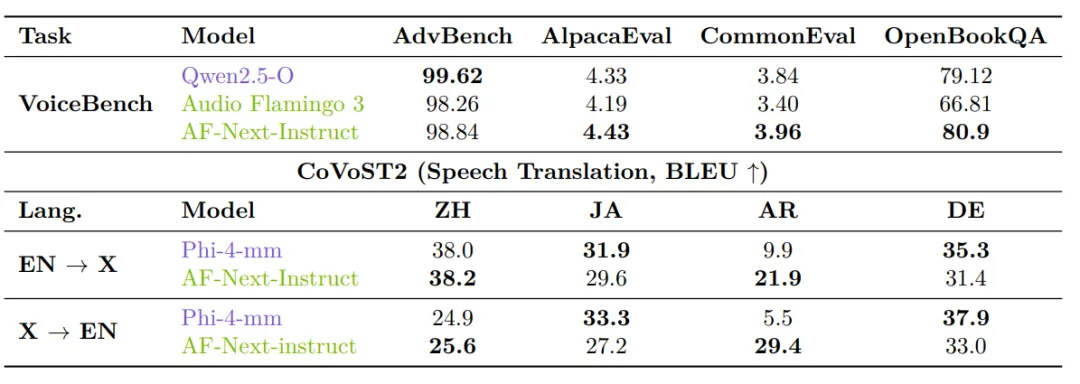
题注:AF-Next-Instruct 在 VoiceBench 及语音翻译(CoVoST2)基准上与其他开源 LALM 的对比
语音理解与翻译
在 VoiceBench 上,AF-Next-Instruct 在 AlpacaEval(4.43)、CommonEval(3.96)、OpenBookQA(80.9)三项均为最优,OpenBookQA 较 AF3 提升超过14 分。在 CoVoST2 EN→X 翻译中,阿拉伯语 BLEU 分数为21.9,比 Phi-4-mm 的 9.9 高出约 12 分。
文章小结
AF-Next 是 Audio Flamingo 系列迄今能力最强的模型,也是据论文所述第一个将音频理解扩展至互联网规模数据的全开源 LALM。其核心贡献在于:以有针对性的数据扩充策略弥补前代模型的能力短板;以 RoTE 替换标准 RoPE 提供时间语义感知;以 Temporal Audio CoT 将推理链锚定至时间戳,实现可解释的长音频推理;以四阶段课程训练和混合序列并行解决长上下文工程挑战。三个差异化检查点(Instruct / Think / Captioner)的同步发布也为不同应用场景提供了明确的选择依据。
参考链接
论文 arXiv 页面:https://arxiv.org/abs/2604.10905 GitHub 开源代码:https://github.com/NVIDIA/audio-flamingo 项目主页:https://afnext-umd-nvidia.github.io/ HuggingFace 模型(AF-Next-Instruct):https://huggingface.co/nvidia/audio-flamingo-next-hf
