
 语音小管家
本次分享由内蒙古大学24级博士生张锦华、内蒙古大学刘瑞教授与香港中文大学(深圳)/ 深圳河套学院 李海洲教授合作发表在IEEE Transactions on Audio, Speech and Language Processing 2026的音频深度伪造检测工作《Retrieval-Based Deep Difference Modeling for Audio Deepfake Detection》。
该工作提出了一个面向音频深度伪造检测的检索增强框架 RDD-ADD。与以往仅依赖真实语音参考库的方法不同,RDD-ADD 首次引入了双数据库检索策略,同时利用 bonafide(真实语音) 和 spoof(伪造语音) 数据库,为待测语音提供更完整的对比参考信息。此外,该方法进一步结合了基于锚点相似度的融合机制、GRU 上下文融合机制以及基于图的深层差异建模策略,能够更细粒度地建模待测语音与检索样本之间的差异,从而提升伪造语音检测性能。实验结果表明,该方法在 ASVspoof 2019 LA、ASVspoof 2021 LA 和 ASVspoof 2021 DF 三个基准数据集上均取得了优异表现,并优于 11 个先进基线方法。
0、Abstract
面对越来越逼真的音频深度伪造内容,如何精准识别“假声音”成为当前语音智能领域的重要问题。本文提出一种面向音频深度伪造检测的检索式深层差异建模方法 RDD-ADD,通过同时引入真实语音库和伪造语音库,为待测语音提供更丰富的参考信息,并结合动态特征融合与图差异建模策略,深入挖掘真实语音与伪造语音之间的细粒度差异。实验结果表明,所提出的方法在三个基准数据集上均取得了优于多种先进基线模型的性能,验证了其在音频深度伪造检测任务中的有效性与鲁棒性。
1、Introduction
随着生成式人工智能技术的快速发展,文本转语音(TTS)和声音转换(VC)等技术已经能够生成与真实语音在声学特征和语义表达上都十分接近的伪造语音,这使得音频深度伪造检测(ADD)成为保障语音通信安全与可信交互的重要研究问题。
现有ADD方法虽然在特征提取和模型设计方面已经取得了较好效果,例如利用WavLM等大规模语音模型提取高维细粒度表示,或结合高斯混合模型、卷积神经网络和深度神经网络等构建检测框架,但这类方法大多依赖固定参数和预训练数据,面对不断演化的伪造攻击时适应性仍然有限。为提升模型对外部知识的利用能力,检索增强方法被引入ADD任务中,但现有RAG式ADD方法仍存在明显不足,如图1所示。具体来说:第一,通常只构建真实语音数据库作为参考,缺少对伪造语音参考信息的显式利用,因此对真实—伪造差异的建模不够充分;第二,缺乏针对WavLM多层检索特征的有针对性的融合机制,导致检索特征的表示能力受限;第三,伪造语音中往往包含细微且局部的伪造痕迹,而现有方法多采用全局注意力分析差异特征,对局部变化的刻画不足,从而影响真实语音与伪造语音的精确区分。
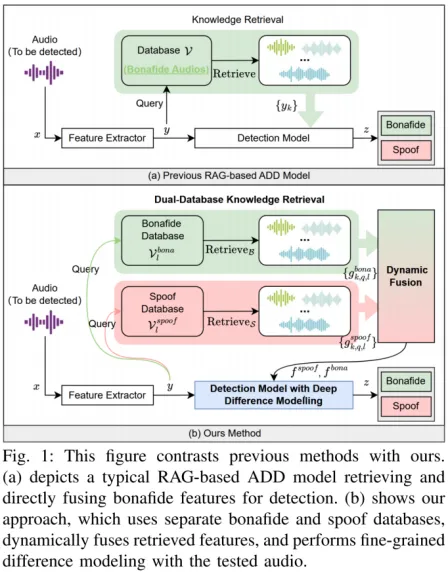
针对上述问题,本文提出了RDD-ADD方法。该方法首先构建真实语音库和伪造语音库组成的双数据库检索框架,使待测语音能够同时与真实参考和伪造参考进行对比;随后利用锚点机制和门控/上下文机制对多层检索特征进行动态融合;最后通过基于图的深层差异建模与关键特征提取策略,在细粒度层面建模待测语音与检索语音之间的差异关系,从而更充分地捕捉伪造痕迹。本文的主要贡献总结如下:
提出一种新的RAG式深层差异建模框架RDD-ADD;
首次将双数据库检索显式引入ADD任务,以增强对伪造特征的利用;并通过特征融合与细粒度差异建模提升检测性能。
实验结果表明,该方法在多个数据集上均优于现有方法。
2、Related works
2.1、Retrieval-Augmented Generation (RAG)
RAG通过结合检索与生成机制,能够有效增强对大规模知识依赖任务的处理能力。通过将外部知识检索与生成建模相结合,RAG可以同时利用训练数据和动态检索到的信息生成内容,从而提升模型的准确性与可靠性。在自然语言处理领域,RAG通常通过实时检索相关文档来提升文本生成质量。在语音领域,检索增强方法已被应用于文本到音频生成和对话语音风格增强等任务,表明外部参考信息能够有效提升语音建模效果。在音频深伪检测任务中,RAD是较具代表性的RAG框架,该方法通过引入参考语音来辅助伪造检测。然而,其检索存储仅包含真实语音,限制了引用的多样性,无法对测试真实性与测试欺骗差异进行显示建模,在分类过程中需隐式学习有关伪造的相关特征。
受此限制的启发,本文在基于RAG的音频深伪检测范式上进行了进一步拓展,提出了一种同时引入真实语音与伪造语音参考数据的双数据库检索策略。在此基础上,进一步设计了检索特征融合模块与基于图的建模模块,以增强双参考差异特征表示的稳定性及细粒度表征能力。据我们所知,这是首个显式利用双数据库检索来支持参考级差异建模的音频深伪检测框架,从而能够实现更加精准的音频深伪检测。
2.2、Difference Modeling Techniques in ADD
差异建模已成为音频深伪检测中的一种重要策略。MSCR-ADD 引入空间差异学习,通过不变通道与差异通道对双耳关系进行建模。另有研究探索了与攻击类型无关的差异建模,以提升模型对未知攻击的泛化能力。还有工作采用结合多帧强化的序列标注方法,用于检测帧级别的不一致性;也有方法将基于频谱图的特征与时序建模相结合,以增强对局部变化的表征能力。RAD 进一步利用检索增强的差异建模,并结合注意力机制提取待测语音与参考语音之间的差异。近年来的研究也进一步表明,差异感知表示对于音频深伪检测是有效的,例如自适应单类学习、真实语音—待测语音表示相似性建模,以及统一的真实—伪造联合学习框架等。
相比之下,本文提出了一种基于图的深层差异建模方法,用于开展细粒度时序分析。具体而言,该方法将差异特征中的每一个时间步视为时序图中的一个节点,并通过节点间的动态注意力机制捕捉局部相关性与时间变化。基于图驱动的这种建模方式,使得沿时间轴的结构化、细粒度差异建模成为可能,从而能够对伪造伪迹进行更深入、更精确的刻画。
3、RDD-ADD: Methodology
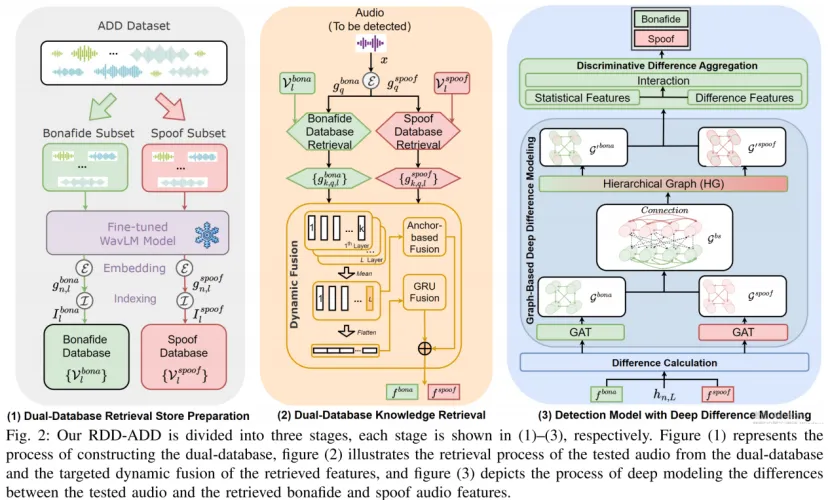
RDD-ADD 的整体流程分为三步:1. 分别构建 bonafide(真实语音)数据库 和 spoof(伪造语音)数据库;2. 给定一段待测语音,从两个数据库中分别检索最相似的多层特征,并通过动态融合模块生成高质量参考表示;3. 在待测语音与检索到的真实/伪造参考之间构建差异特征,再通过图建模实现细粒度伪造痕迹检测。
3.1、Dual-Database Retrieval Store Preparation
这一部分的目标是为后续检索和差异建模准备结构化参考空间。我们先用微调后的 WavLM 提取多层特征,再通过特征压缩得到适合检索与图建模的紧凑表示,最后分别为真实语音和伪造语音构建索引库。
(1) Dual-Database Retrieval Store Preparation:
给定输入语音 (x),通过 WavLM 提取出的多层特征表示为:
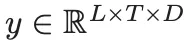
其中,(L) 表示 WavLM 的层数,(T) 表示时间步数,(D) 表示每个时间步的特征维度。
(2) Feature Compression:
由于 WavLM 特征维度较高,不利于高效检索与图建模,因此我们使用 RawNet2 风格的编码器对其进行压缩,得到:
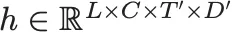
然后再通过池化进一步压缩,得到:
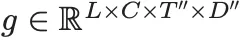
最终再展平为一维嵌入向量,供后续模块使用。这里的 (C) 表示滤波器数量。
(3) Index and Dual-Database Construction:
我们采用 FAISS 的 IndexFlatL2 建立索引。对于每一层,分别构建真实语音索引和伪造语音索引,并形成两类数据库:
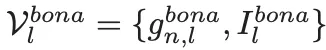
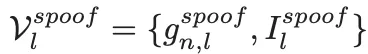
3.2、Dual-Database Knowledge Retrieval
这一部分的核心任务是:对待测语音分别从真实库和伪造库中检索相似样本,并通过动态融合生成更有判别力的参考特征。
(1) Dual-Database Retrieval:
对于查询特征 (g_q),从两个数据库中分别检索 Top-(K) 个最相似样本。对每一层,先计算检索样本的均值表示:
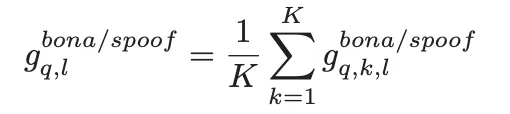
这里,q表示查询样。
(2) Dynamic Fusion:
为了建模不同层检索特征之间的上下文关系,我们将所有层特征堆叠后输入 GRU:
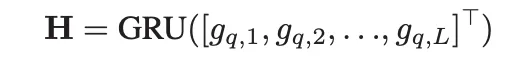
其中,H = [ h1, h2, ..., hL]T, 接着通过线性层和 Sigmoid 得到每层的上下文权重。我们将最深层特征作为锚点特征,因为它包含最抽象、最关键的信息。然后计算锚点与各层特征之间的余弦相似度。为了强化锚点层的重要性,还对最后一层的相似度进行放大。接着,将锚点相似度权重和 GRU 权重结合,得到每一层的最终权重。最后,对各层特征进行加权求和,得到融合后的参考表示:fbona/spoof。
3.3、Detection Model With Deep Difference Modelling
这一部分是全文最核心的模块。它不直接在原始语音特征上做分类,而是先构造“待测语音—检索参考”的差异,再在差异空间中通过 GAT、异构图和 DDA 模块进行深层建模。
(1) Difference Calculation:
设待测语音的关键表示为:
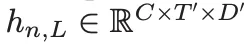
从真实库和伪造库动态融合后得到的参考特征分别为 (fbona) 和 (fspoof)。我们用绝对差构造两类差异特征:
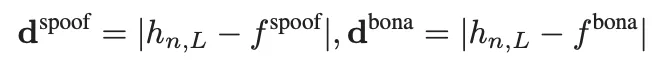
之后再对特征维 (D) 做加权汇聚,并交换时间维与通道维,得到:
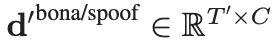
也就是说,此时每个时间步都成为后续图建模中的一个节点。
(2) Graph-Based Deep Difference Modeling
①GAT-Based Intra-Difference Modeling:
我们将每个时间步视为一个节点,并引入可学习位置编码,再通过 GAT 建模同一类差异特征内部的时序关系。进一步,图中节点更新公式写为:
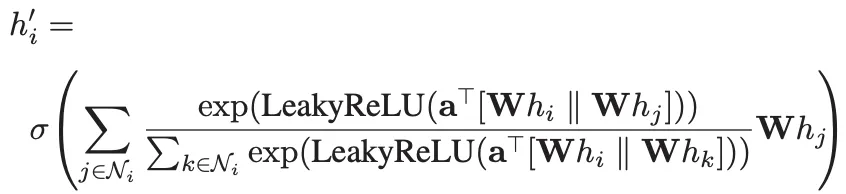
其中,(W) 为可训练权重矩阵,(a) 为注意力参数向量,(Ni) 表示节点 (i) 的邻居集合。这个过程的作用是:在真实差异图或伪造差异图内部,自适应建模不同时间片段之间的依赖关系。
②HG-Based Inter-Difference Modeling:
为了显式建模 bonafide 差异和 spoof 差异之间的对比关系,我们进一步引入异构图 HG。对于某个 bonafide 节点,其更新形式为:
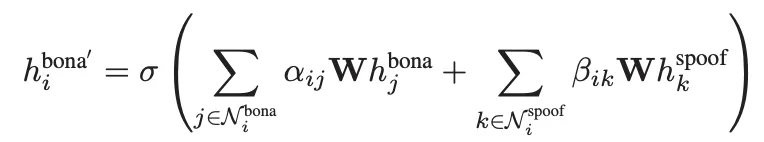
其中,(Nibona) 和 (Nispoof) 分别表示真实节点邻居和伪造节点邻居,(αij)、(βik) 表示通过图注意力机制学习到的权重。这样,每个节点不仅吸收同类信息,也吸收异类差异信息。
最后,通过对图中所有节点进行加权聚合,得到全局表示:
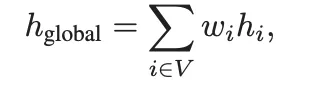
(3) Key features extraction and Classification:
为了进一步提取关键伪造痕迹,我们提出了 DDA(Discriminative Difference Aggregation)模块。其思想是:不仅看局部节点特征,还看局部统计量与全局表示之间的偏差。
先对每类差异图计算通道维上的最大值与均值,再将统计特征与全局表示比较,构造两类差异:
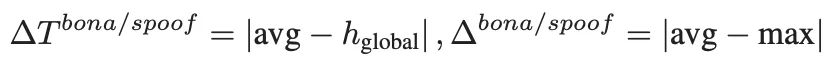
其中,前者描述“均值—全局”的偏差,后者描述“均值—最大值”的内部波动。为了增强统计特征与差异特征之间的信息交换,我们引入交叉注意力:
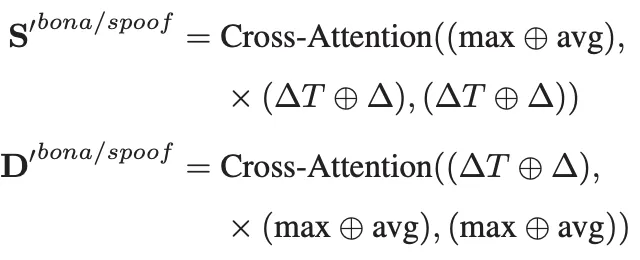
最后,将融合结果与全局表示拼接后送入双输出分类器,同时保留对 bonafide 和 spoof 两类的判别信息。
3.4、Loss Function
由于模型同时建模了两种深层差异表示,我们采用两个并行分类器,并设计了自适应加权损失函数:
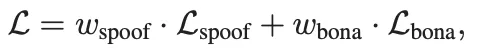
其中,Lspoof和 Lbona都是加权交叉熵损失,Wspoof和 Wbona是可学习权重。这样做的目的,是让模型能够分别从“偏伪造差异”和“偏真实差异”两个角度学习,并自动平衡二者对训练的贡献。
4、Experiments
4.1、Datasets
我们使用了三个公开基准数据集:ASVspoof2019-LA、ASVspoof2021-LA 和 ASVspoof2021-DF。其中,ASVspoof2019-LA 是主要训练与验证基础,训练集包含 2580 条真实语音和 22800 条由 6 种 TTS/VC 算法生成的伪造语音,评测集则包含 13 种未见攻击;ASVspoof2021-LA 在 2019-LA 的基础上进一步加入了信道与编解码扰动,更强调跨信道鲁棒性;ASVspoof2021-DF 则更聚焦“deepfake”场景,语音还经过了类似在线媒体传播的压缩处理,用于检验模型在更真实应用环境下的泛化能力。也就是说,这三套数据分别对应常规逻辑攻击检测、复杂传输条件下检测、以及真实深伪场景检测。
4.2、Implementation details
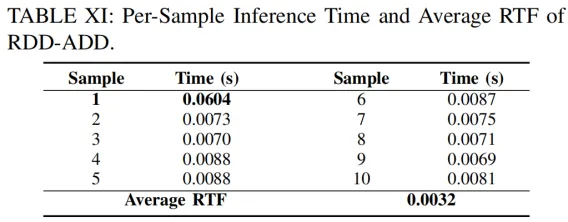
在实验实现上,我们为了增强真实语音参考库的多样性,额外引入了 VCTK 中的部分真实语音样本,并去除了与已有数据集重叠的部分,以避免数据泄漏。所有输入语音都被统一裁剪或补零到固定长度 64600;实验设置与直接检索基线保持一致,不做数据增强。推理阶段,对每个查询样本分别从真实库和伪造库中各检索 top-3 邻居。模型使用 Adam 优化器训练 60 个 epoch,运行平台为 A100 GPU。超参数在验证集上调优,最终结果报告为 3 个随机种子下的平均值。另外,为了降低检索开销,我们在首次运行后对 top-k 检索结果做缓存复用;文中还指出模型规模约为 0.43M 参数,平均实时因子 RTF = 0.0032,说明方法在部署层面也较轻量。
4.3、Baselines
我们将对比方法分成了六大类。第一类是时频卷积建模方法,如 FFT+SENet、DFSincNet、f0+Res2Net,主要从谱图中提取局部时频模式;第二类是传统/混合建模方法,如 DNN+ResNet、SAMO、UR-AIR,更偏向端到端卷积或多模块融合;第三类是图建模方法,如 RawGAT-ST、AASIST,强调捕捉时频结构关系;第四类是单声道到双耳建模方法,如 M2B-GAT、M2B-Spaces-Division、M2B+Mono,试图利用空间线索增强伪造检测;第五类是预训练语音模型增强方法,如 WavLM+MFA、WavLM+RAD-MFA、Wav2Vec2+ASP、Wav2Vec2+LGF,侧重挖掘大规模预训练表征;第六类是检索增强方法,其中最关键的代表是 RAD-MFA。这样的基线设计覆盖了当前 ADD 中几乎所有主流技术路线,因此能较全面地验证 RDD-ADD 的有效性。
4.4、Evaluation metrics
我们主要采用两个经典指标:min t-DCF 和 EER。其中,EER(Equal Error Rate)表示假阳性率和假阴性率相等时的错误率,是一个较常用的整体检测性能指标;min t-DCF 则是更贴近实际应用成本的代价敏感指标,能够反映不同错误类型带来的系统代价。文中还提到额外引入了一个同时综合考虑这两个指标的复合指标,用来更全面地评价模型性能。整体来看,这一节的评价体系兼顾了学术比较中的标准性和实际应用中的可靠性。
5、Results and Discussion
5.1、Main Results
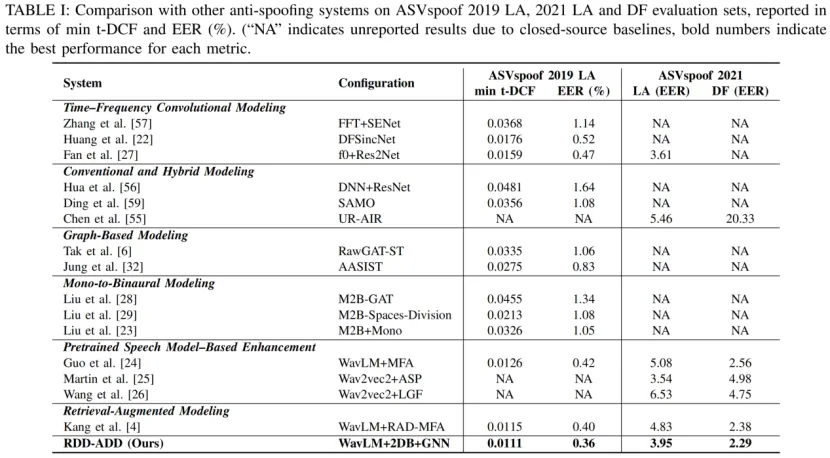
如表1所示,RDD-ADD 在三个基准数据集上都取得了最优或更优表现。在 ASVspoof2019 LA 上,RDD-ADD 取得了 min t-DCF = 0.0111、EER = 0.36% 的最佳结果,优于现有方法;相较于检索增强基线 WavLM+RAD-MFA,也同时提升了 EER 和 t-DCF。我们认为,这说明“双数据库检索 + 图式深层差异建模”确实能更细粒度地捕捉伪造痕迹。在更强调泛化能力的 ASVspoof2021 LA 和 DF 上,RDD-ADD 的 EER 分别达到 3.95% 和 2.29%,同样优于 WavLM+RAD-MFA 的 4.83% 和 2.38%,也优于多种基于预训练语音模型的方法。这说明该方法不仅在已知条件下有效,在未见攻击和跨条件场景下也有更好的鲁棒性。
5.2、Ablation study
The Impact of RAG Module
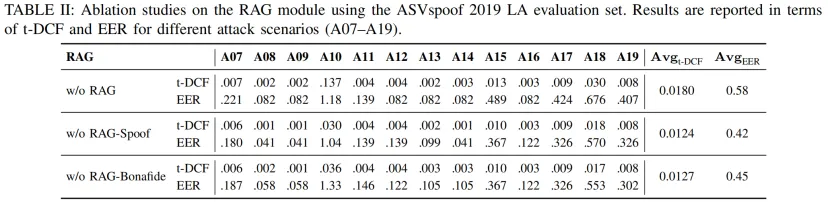
如表2所示,如果完全去掉检索增强,性能下降最明显,平均 t-DCF 升到 0.0180,EER 升到 0.58%,说明参考检索空间本身就是模型成功的基础。如果只去掉伪造库,EER 变为 0.42%;只去掉真实库,EER 变为 0.45%。这表明真实库和伪造库都重要,其中伪造库提供异常伪造模式的直接参照,真实库则提供稳定的自然语音参考边界,二者共同支撑差异建模。
The Impact of Dynamic Fusion Module
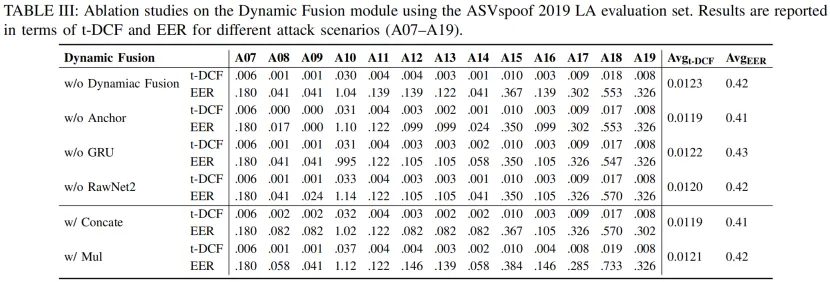
如表3所示,去掉整个动态融合模块后,EER 升至 0.42%;去掉 anchor 后为 0.41%;去掉 GRU 后为 0.43%;用浅层卷积替代 RawNet2 后也退化到 0.42% 左右。再进一步比较融合方式时,我们发现简单拼接和乘法融合都不如当前的加性融合稳定,说明该模块不仅要“融合”,还要有选择地融合、保持层间平衡,这正是 anchor、GRU 和 RawNet2 共同起作用的地方。
The Impact of Detection Module
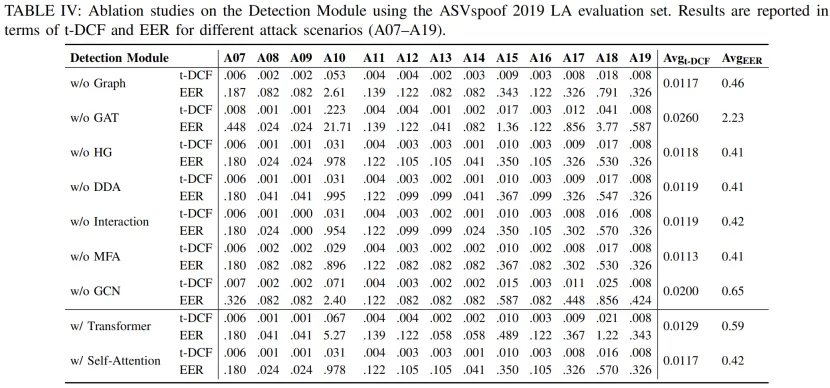
如表4所示,如果去掉整个图模块,EER 升到 0.46%;其中影响最大的是去掉 GAT,EER 会显著升到 2.23%,说明自适应邻居建模是核心。去掉 HG 后,EER 为 0.41%;去掉 DDA 后,EER 为 0.40%;去掉双差异交互机制后,EER 为 0.42%。此外,把图推理模块换成 MFA、GCN、Transformer 或普通 Self-Attention,性能都不如当前设计,说明我们提出的图式差异推理并不是普通注意力或简单聚合可以替代的,它更适合对局部、结构化、参考条件下的差异关系进行建模。
Parameter and Setting Analysis
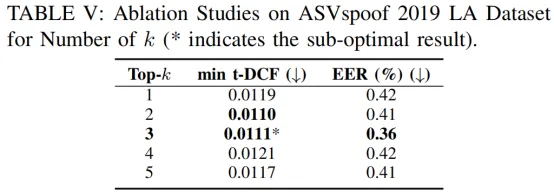
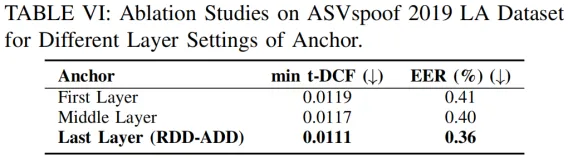
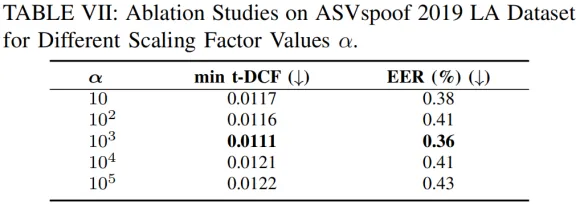
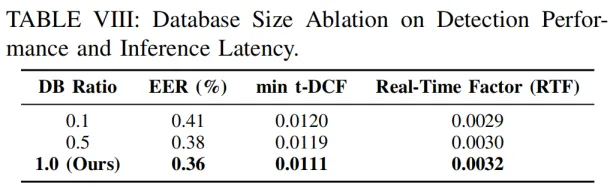
我们进一步分析了检索数目 (k)、anchor 层选择、缩放因子 (\alpha) 和参考数据库规模的影响。结果显示:当 k=3 时整体最优,说明检索样本过少会导致对比信息不足,过多又会引入冗余和噪声,如表5所示;在 anchor 选择上,使用最后一层作为 anchor 效果最好,优于浅层和中间层,说明深层特征更适合承担全局参照,如表6所示;在缩放因子上,(\alpha = 10^3) 最优,过小会削弱 anchor 作用,过大又会破坏与检索特征之间的平衡,如表7所示;在数据库规模上,随着参考数据库增大,EER 和 t-DCF 都持续改善,但 RTF 变化很小,说明更大的参考空间能带来更充分的对比证据,同时缓存机制控制住了额外开销。
5.3、Discussion of deepfake types
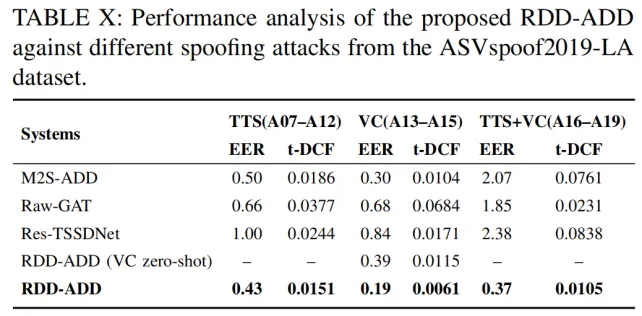
如表10所示,我们专门比较了 TTS、VC 以及混合型 TTS+VC 攻击。结果表明,RDD-ADD 在各类攻击场景下都保持最低的 EER 和 t-DCF。对 TTS 攻击(A07–A12),RDD-ADD 的 EER 为 0.43%,相比 M2S-ADD 的 0.50% 降低约 14%;对 VC 攻击(A13–A15),EER 从 0.30% 下降到 0.19%,降幅约 36%。更有意思的是,在 VC zero-shot 设置下,也就是训练和伪造检索库里完全去掉 VC 攻击类型时,模型仍保持 EER = 0.39%、t-DCF = 0.0115 的稳定结果。这说明 RDD-ADD 学到的并不是严格依赖某一攻击类别的模板匹配,而是更具普适性的攻击无关偏差模式。对于更复杂的混合 TTS+VC 场景,基线模型退化更明显,而 RDD-ADD 仍保持较稳定表现,说明其细粒度差异建模机制对复杂伪造机理更有适应性。
5.4、Discussion of Model Scale and Efficiency
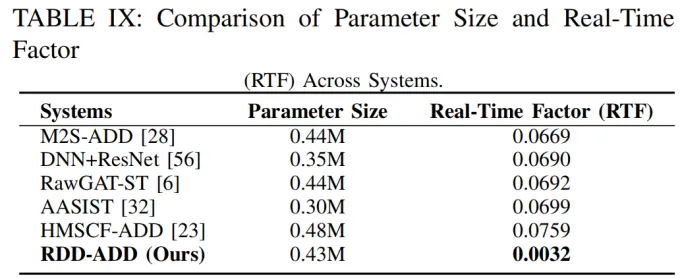
在效率分析部分,我们指出 RDD-ADD 只有 0.43M 参数,与一些轻量级方法如 M2S-ADD、RawGAT-ST 接近,甚至只是略高于 AASIST,但其 RTF 仅为 0.0032,说明推理效率很高。我们进一步解释,这得益于缓存机制:在第一次样本推理后,将特征库与 Top-k 检索结果缓存起来,后续无需重复检索,因此几乎不影响性能,却显著减少了重复开销。从整体上看,RDD-ADD 在准确率、效率和可部署性之间取得了较好的平衡。
5.5、Feature Separability Visualization
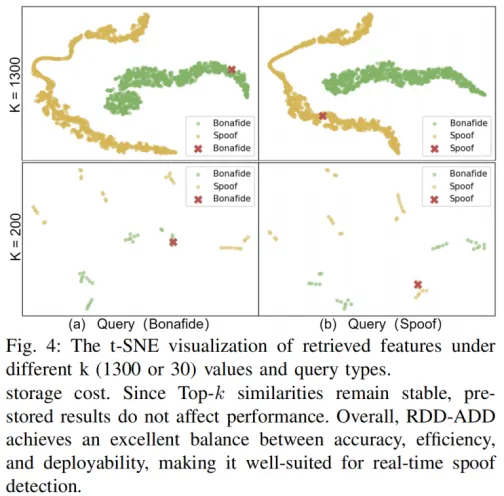
如图4所示,我们用 t-SNE 展示了双数据库检索特征分布。图中绿色和黄色分别表示真实与伪造样本,红色叉号表示查询样本。当参考规模较大时,真实与伪造特征形成更清晰的分离簇,说明双数据库检索能提供互补信息、增强全局判别性;当参考规模较小时,类间可分性减弱,特征更稀疏。我们据此强调:仅靠原始检索还不够,仍需要后续的深层差异建模来进一步拉开边界、强化模糊区域的区分能力。
6、Conclusion
总体而言,RDD-ADD集成了双重检索策略、动态特征融合和基于图的差异建模,以增强真实和虚假音频之间的细粒度区分。通过联合利用真实和虚假参考中的互补信息,该模型有效地捕获了有区别的差异线索,并在多个基准测试中实现了卓越的泛化。尽管其当前的设计依赖于固定长度的输入,这限制了对长或可变话语的适应性,但未来的工作将集中在动态长度和基于流的建模上。总体而言,这项工作为基于检索的音频深度伪造检测提供了一个有效和通用的框架,突出了深度差异学习和上下文参考整合的重要性。
排 版:贾真琦,责 编:张锦华,审 核:刘 瑞
