
 语音小管家
论文标题: Qwen3.5-Omni Technical Report
多模态大模型混战至今,真正的全模态原生统一体终于来了。阿里云通义千问发布 Qwen3.5-Omni,以 Hybrid Attention MoE + Thinker-Talker 全新架构,实现文本、图像、音频、视频端到端一体理解与生成。
它在 215 项音视频理解、推理、交互任务拿下 SOTA,音频能力超越 Gemini 3.1 Pro,音视频综合能力与之持平;支持10 小时超长音频、400 秒 720P 视频解析,更靠ARIA 动态对齐实现流式语音零卡顿、自然韵律拉满。
更重磅的是,它诞生了「视听直觉编程(Audio-Visual Vibe Coding)」新能力:看视频 + 听语音指令,直接写出可运行代码。这一次,全模态 AI 真正做到 “看、听、说、写、做” 合一。
⏩一、什么是原生全模态大模型?
在拆解 Qwen3.5-Omni 前,先把 3 个核心概念讲透,避免被术语绕晕:
1. 原生全模态(Native Omni-Modality)
不是 “文本模型 + 视觉模型 + 音频模型” 拼接,而是「一套编码器、一个主干、一套解码器」,从预训练阶段就统一建模文本、图像、音频、视频。
优势:模态间无信息损耗,理解更准、生成更同步、推理更快。
2. Thinker-Talker 双架构
「Thinker(思考中枢)」:负责所有输入理解、推理、规划、工具调用 「Talker(表达出口)」:专注于流式语音生成,低延迟、高自然度
两者完全解耦又深度协同,兼顾 “想清楚” 和 “说流畅”。
3. ARIA(自适应速率交错对齐)
解决流式语音最大痛点:「文本 token 与语音 token 编码速率不匹配」,导致吞字、破音、节奏怪异。
ARIA 动态对齐文本 - 语音单元,让流式语音像真人说话一样自然连贯。
⏩二、多模态模型一直没解决的 3 个死穴
当前 Sora、GPT-4o、Gemini 虽强,但在真实交互场景仍有硬伤:
「长上下文崩盘」:几分钟音频就漏记细节,无法处理长会议、长视频 「语音合成割裂」:流式生成卡顿、吞字、语调机械,不支持实时打断 「模态各自为战」:视频看画面、音频听声音,不做联合推理,音画不同步 「能力有边界」:只能理解生成,不能直接根据视听内容执行动作(如写代码)
Qwen3.5-Omni 从架构底层出手,一次性全部解决。
⏩三、Hybrid MoE+Thinker-Talker 双核驱动
Qwen3.5-Omni 完全重构上一代架构,「Thinker 与 Talker 均搭载 Hybrid Attention MoE」,实现性能与效率双巅峰。
3.1 整体架构:四大核心升级
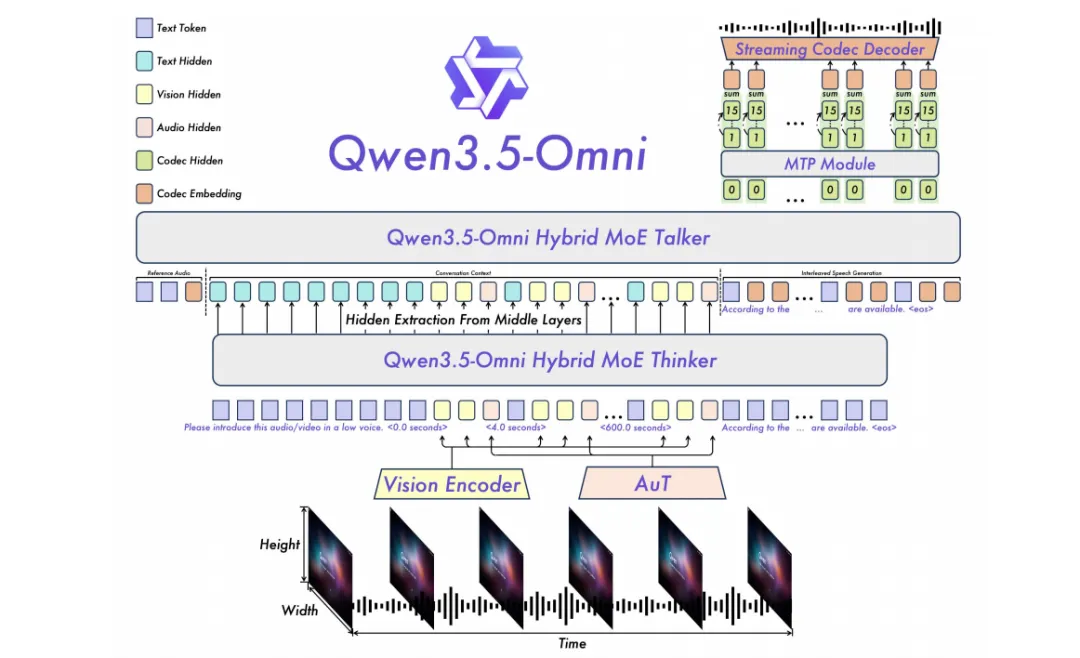
「混合注意力 MoE 主干」:稀疏激活,长序列推理效率暴增 「256k 超长上下文」:覆盖 10 小时音频 / 400 秒 720P 视频(1FPS) 「多码本 Codec 语音生成」:单帧即时合成,流式超低延迟 「ARIA 动态对齐」:文本 - 语音完美匹配,流畅不卡顿 「多语言支持」:113 种语言识别、36 种语言合成,覆盖多方言
3.2 第一层核心:Hybrid Attention MoE
这是 Qwen3.5-Omni 效率与性能的根基,也是它能跑 10 小时音频、400 秒视频的关键。
1. 什么是 Hybrid Attention MoE?
Hybrid Attention MoE = 两种注意力 + 稀疏 MoE 合体:
「GQA 标准注意力」:负责局部精细交互(短程、精准) 「Linear Attention / GDN(Gated Delta Net)」:负责超长序列建模(长程、高效) 「MoE 稀疏激活」:每 token 只激活少量专家,参数量大、算力小
2. 设计要点
「Thinker 与 Talker 均为 Hybrid MoE」:不是只给推理上 MoE,连语音生成都用上稀疏架构,并发与延迟双杀。 「GDN 门控增量网络」:专门加速长音视频序列,大幅降低 KV Cache 读写开销,长上下文几乎线性扩展。 「动态路由 + 共享专家」:兼顾稀疏效率与多模态泛化,不会因为 “路由跑偏” 导致音画不同步。 「推理激活参数极低」:总参数数百 B 级别,每步仅激活小部分专家,推理速度、显存占用接近小模型。
3. 为什么它能搞定长序列?
「传统稠密 Transformer」:
长度↑ → 计算量↑² → 显存爆炸 → 长视频必崩 「Hybrid MoE」:
注意力分长短程,Linear Attention 负责超长距离 MoE 只激活少量专家,计算不随长度平方暴涨 GDN 优化时序缓存,10 小时音频 / 400 秒视频不漂移
3.2 第二层核心:Thinker(全模态理解大脑)
1. 定位:只做 “最累的活”
Thinker = 全模态理解中枢 + 超长上下文记忆 + 逻辑推理机 + 时序管理器
不负责发声,只负责:
看图像 / 视频 听音频 / 语音 理解文本 跨模态推理 输出结构化语义 输出精确时间戳 输出可执行规划
2. 核心模块
「统一模态输入层」:
文本:Qwen3.5 Tokenizer(250k 词表,编码效率 + 10%~60%) 视觉:SigLIP2 视觉编码器,处理图像 + 视频 音频:AuT 音频 Transformer,4000 万小时音频训练,6.25Hz 输出 「显式时间戳建模」:放弃纯绝对位置编码,改用秒级文本时间戳,音频每 160ms 一个时间 ID,视频动态对齐,彻底解决长时序错位。
「Hybrid MoE 推理主干」:256k 上下文窗口,支持
10 + 小时音频 400 秒 720P 视频(1FPS) 「分块预填充 Streaming」:音视频按块编码,边输入边处理,首包延迟大幅降低。
3. Thinker 输出什么给 Talker?
语义文本 情绪 / 语速 / 音量控制信号 时序对齐信息 说话人特征提示(用于音色克隆)
3.3 第三层核心:Talker(流式语音生成引擎)
1. 定位:只做 “最快最稳的发声”
Talker = 专用流式语音生成器 + ARIA 对齐器 + 多码本合成器
完全解耦推理,专注三件事:
低延迟 不吞字、不破音 可打断、可控制、可克隆
2. 三大黑科技
「RVQ 多码本语音表征」
单帧即时合成 细粒度控制音色、韵律、情感 配合 MTP 多 token 预测,逐帧流式输出 「Code2Wav 因果卷积解码器」
轻量级、流式、可并行 边生成边播放,无等待缓存 「ARIA 自适应速率交错对齐」:这是 Talker 最关键的改进,「彻底解决流式语音灾难」
问题:文本 token 与语音 token 编码速率不一致 → 吞字、数字错读、语调断裂 方案:ARIA 把双路生成 → 单流交错生成 约束:任意前缀内,语音 / 文本 token 比例不超限 效果:动态对齐节奏,中英日韩都流畅,可实时打断
3. Talker 也是 Hybrid MoE
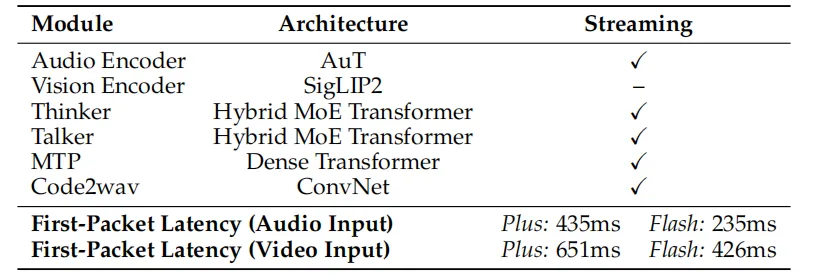
生成模型也上稀疏 MoE 高并发下显存更稳 多用户同时对话不拥堵 语音首包延迟 Flash 版 235ms
⏩四、三大独家秘术
Qwen3.5-Omni 之所以又强又稳、又快又自然,全靠下面三个独家技术。不用懂算法,看完就明白它厉害在哪。
4.1 显式时间戳建模:让 AI “会看钟表”,超长音视频不混乱
你有没有遇到过:AI 看几分钟视频就记混时间线、对话顺序错乱、音频和画面对不上?这是因为传统模型没有“时间观念”,只能靠猜。
Qwen3.5-Omni 直接给模型装上了「电子钟表」:
音频每 160 毫秒打一个时间戳 视频每一帧也打上对应的时间 所有信息按时间顺序排好,再送给模型理解
就像给视频和音频「自动加了字幕时间轴」,模型一眼就知道:
什么时间说了什么话 什么时间出现什么画面 谁在什么时候做了什么动作
效果:
10 小时音频、7 分钟视频,时间线一丝不乱 音画永远同步,不会出现 “动作还没做,声音先出来” 复杂剧情、长会议、多轮对话都能精准还原
4.2 ARIA 流式语音对齐:说话不卡顿、不吞字、像真人一样自然
之前的 AI 语音有个通病:读着读着「吞字、破音、断句奇怪、数字读错」,一快进就乱掉。
原因很简单:「文字的速度和语音的速度对不上」。
Qwen3.5-Omni 专门做了一个叫 ARIA 的 “语音节奏管家”:
它实时盯着文字和语音,「自动调整速度匹配」 不让文字跑太快,也不让语音跟不上 长句、数字、中英文混合都能稳稳读对
你可以把 ARIA 理解成:一个专业配音员 + 一个提词器,永远同步、不翻车。
效果:
流式语音边想边说,零延迟 不吞字、不破音、不断句 可以随时打断,AI 会立刻停下回答你 中文、英文、方言都自然流畅
4.3 三阶段预训练 + 四阶段后训练:全模态能力闭环
「预训练三阶段」
「编码器对齐」:冻结 LLM,训练视觉 / 音频编码器 「通用多模态」:4 万亿 token 多模态数据,全参数微调 「长上下文强化」:扩至 262k 序列,长音视频专项优化
「Thinker 后训练」
「专家蒸馏」:各模态专用教师模型知识注入 「在线蒸馏」:语音输入对齐文本输入高质量输出 「交互对齐 RL」:多轮对话稳定、人设一致、不跑偏
「Talker 后训练」
通用语音 → 长上下文 → DPO 偏好优化 → 说话人微调,最终实现零样本音色克隆、多语言情感韵律。
⏩五、不止理解,更能 “行动”
Qwen3.5-Omni 不只是 “问答机器”,而是原生全模态智能体,五大能力拉满:
5.1 超长视听理解
「音频」:「10 小时+」连续对话、讲座、播客 「视频」:400 秒 720P(1FPS),完整解析剧情、动作、对话 「输出」:剧本级结构化字幕,带时间戳、场景分割、人物关系
5.2 实时流式语音交互
「语义打断」:识别意图,自然插话不机械 「语音控参数」:音量、语速、情绪直接说就改 「零样本音色克隆」:3 秒样本,复刻说话人
5.3 多语言王者
「语音识别」:113 种语言 + 39 种中方言 「语音合成」:29 种语言 + 7 种中方言 「跨语言克隆」:保留音色,无缝切换语言
5.4 原生智能体能力
自主联网搜索、复杂函数调用 无需外部编排,端到端完成任务
5.5 涌现能力:视听直觉编程(Audio-Visual Vibe Coding)
「全球首创」:看视频 + 听语音指令 → 直接生成可运行代码,看演示、听需求,自动写出网页、脚本、工具函数,真正实现 “所见所听即所得”。
⏩六、权威实测
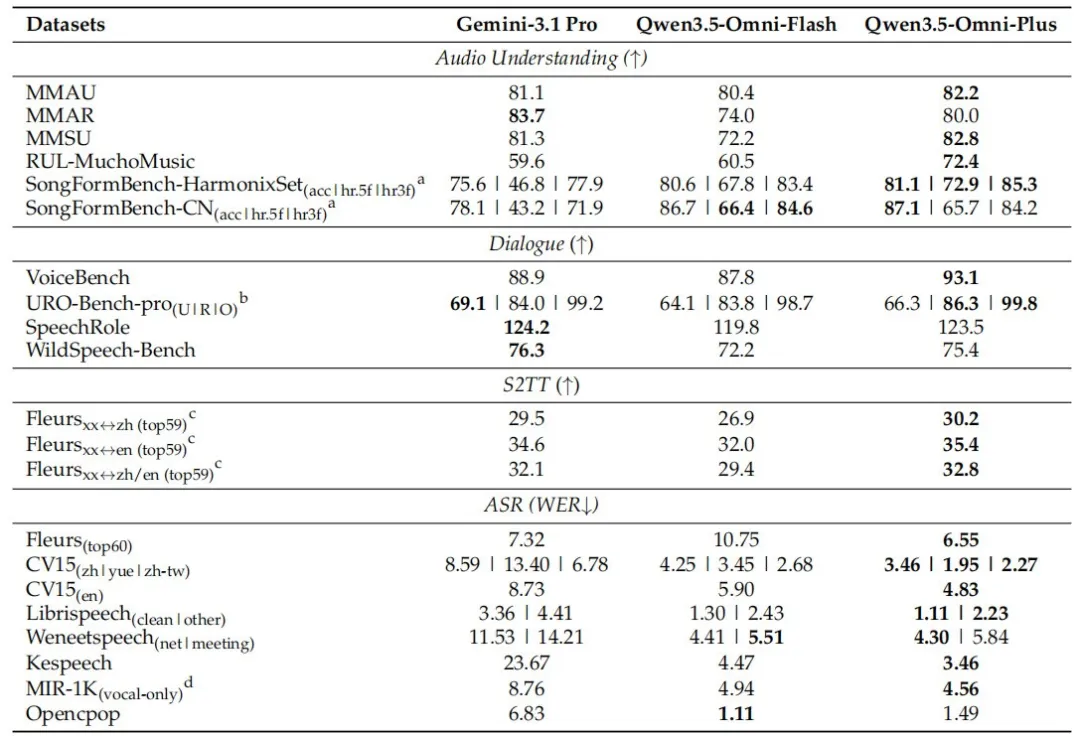
6.1 音频→文本关键对比
6.2 端到端延迟(流式交互核心)
6.3 多语言 ASR
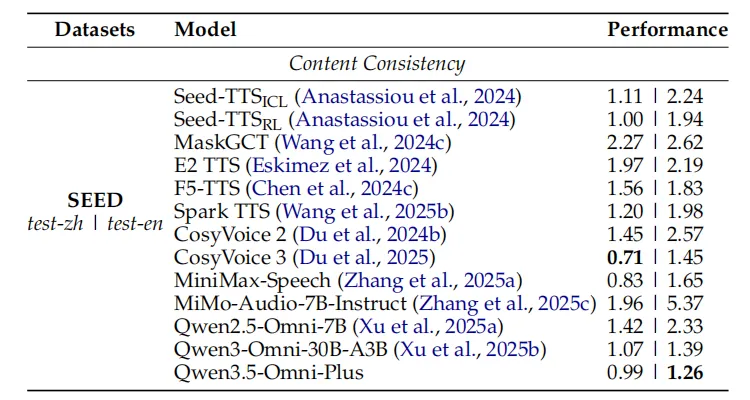
6.4 零样本语音合成
6.5 核心结论
215 项音视频任务 SOTA 音频理解 / 识别 / 翻译 / 对话 超越 Gemini 3.1 Pro 音视频综合理解 持平 Gemini 3.1 Pro 文本 & 视觉能力 持平同尺寸 Qwen3.5 多语言 ASR 平均 WER 6.6%,业界最低
⏩七、为什么它是全模态的 “iPhone 时刻”?
「统一架构终结拼接时代」:一套模型搞定文本、图像、音频、视频,不再需要多系统联动。 「长上下文真正可用」:10 小时音频、7 分钟视频,彻底覆盖会议、课程、影视解析。 「流式语音体验革命」:ARIA + 多码本合成,延迟低、可打断、音色自然,人机对话趋近真人。 「从感知到行动」:视听直觉编程,标志多模态模型从理解走向执行,打开工业级落地空间。 「多语言无短板」:中文、方言、小语种全面领先,真正全球化全模态模型。
⏩八、全模态 AI 的终极形态已来
Qwen3.5-Omni 的发布,意味着全模态大模型正式进入 “原生统一、超长上下文、实时交互、自主行动” 的新时代。
它不再是 “能看会听的文本模型”,而是像人一样感知世界、理解世界、表达世界、改变世界的统一智能体。
从视频自动转剧本,到实时多语言同声传译,到语音控制一切,再到看视频写代码。 未来,所有需要视听理解与创作的场景,都将被它重构。
