
 语音小管家
近期,浙江大学研究者提出了WavAlign: Enhancing Intelligence and Expressiveness in Spoken Dialogue Models via Adaptive Hybrid Post-Training。该工作聚焦于端到端语音对话模型后训练中的一个关键问题:如何在提升语义智能的同时,保持语音生成的自然度与表现力。围绕这一问题,论文从奖励建模、梯度分配和训练稳定性等角度分析了强化学习在语音对话场景中的局限,并据此提出了一种面向文本—语音混合输出的自适应混合后训练方法。
论文:WavAlign: Enhancing Intelligence and Expressiveness in Spoken Dialogue Models via Adaptive Hybrid Post-Training
项目主页:https://github.com/MM-Speech/WavAlign
论文地址:https://arxiv.org/pdf/2604.14932
⏩背景动机:端到端语音对话模型的后训练仍面临“智能—表现力”之间的张力
论文指出,端到端语音对话模型相较于级联系统,在统一建模语义内容与副语言信息方面具有更高潜力,但现有开源系统在语义能力、自然度和表现力上仍未达到理想水平。一个自然的思路是,将文本领域广泛采用的RLHF 或偏好优化方法直接迁移到语音对话模型中。然而,作者的经验观察表明,这类方法在混合文本—语音输出上往往只能带来局部收益:语义质量可能提升,但语音质量却容易下降,表现为声学漂移、自然度减弱以及表达稳定性受损。
论文分析的核心价值,在于它较系统地解释了上述失效现象的成因。
一、强化学习更新信号是局部的
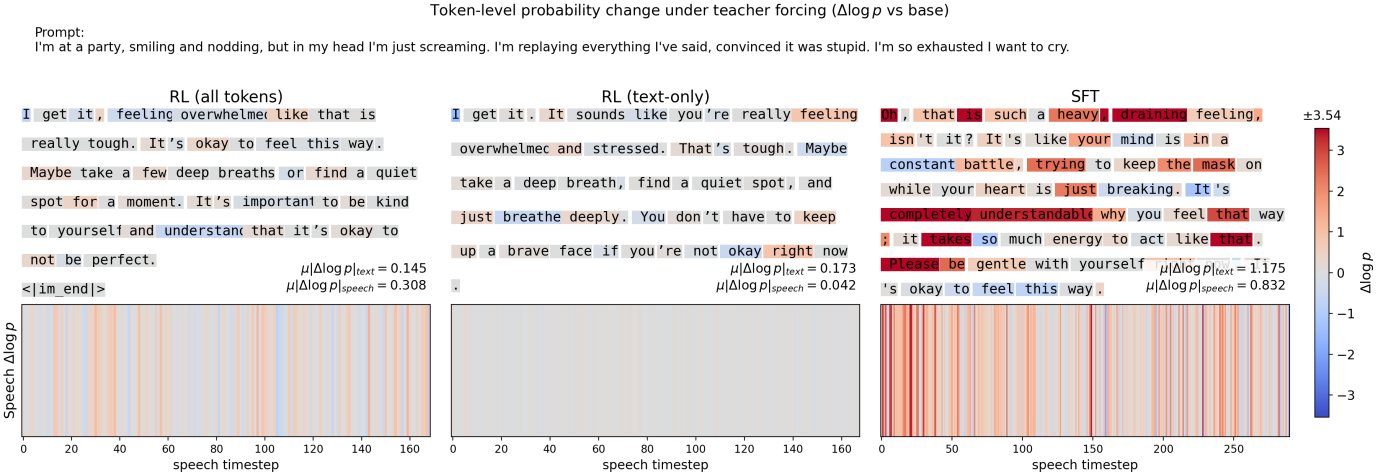
图1SFT和RL对模型分布的影响
首先,论文认为,SFT 与偏好优化在作用方式上并不相同。SFT 提供的是逐 token 的密集监督,更适合形成稳定且一致的分布迁移;而带有 clipping 或参考模型约束的偏好优化,本质上更接近局部修正,难以在训练信号不足时推动模型跳出原有次优区域。对于同时包含文本与语音生成的模型而言,这意味着单纯依赖偏好优化并不足以承担“整体能力重塑”的任务。
二、目前的奖励模型在声学评估上并不可靠
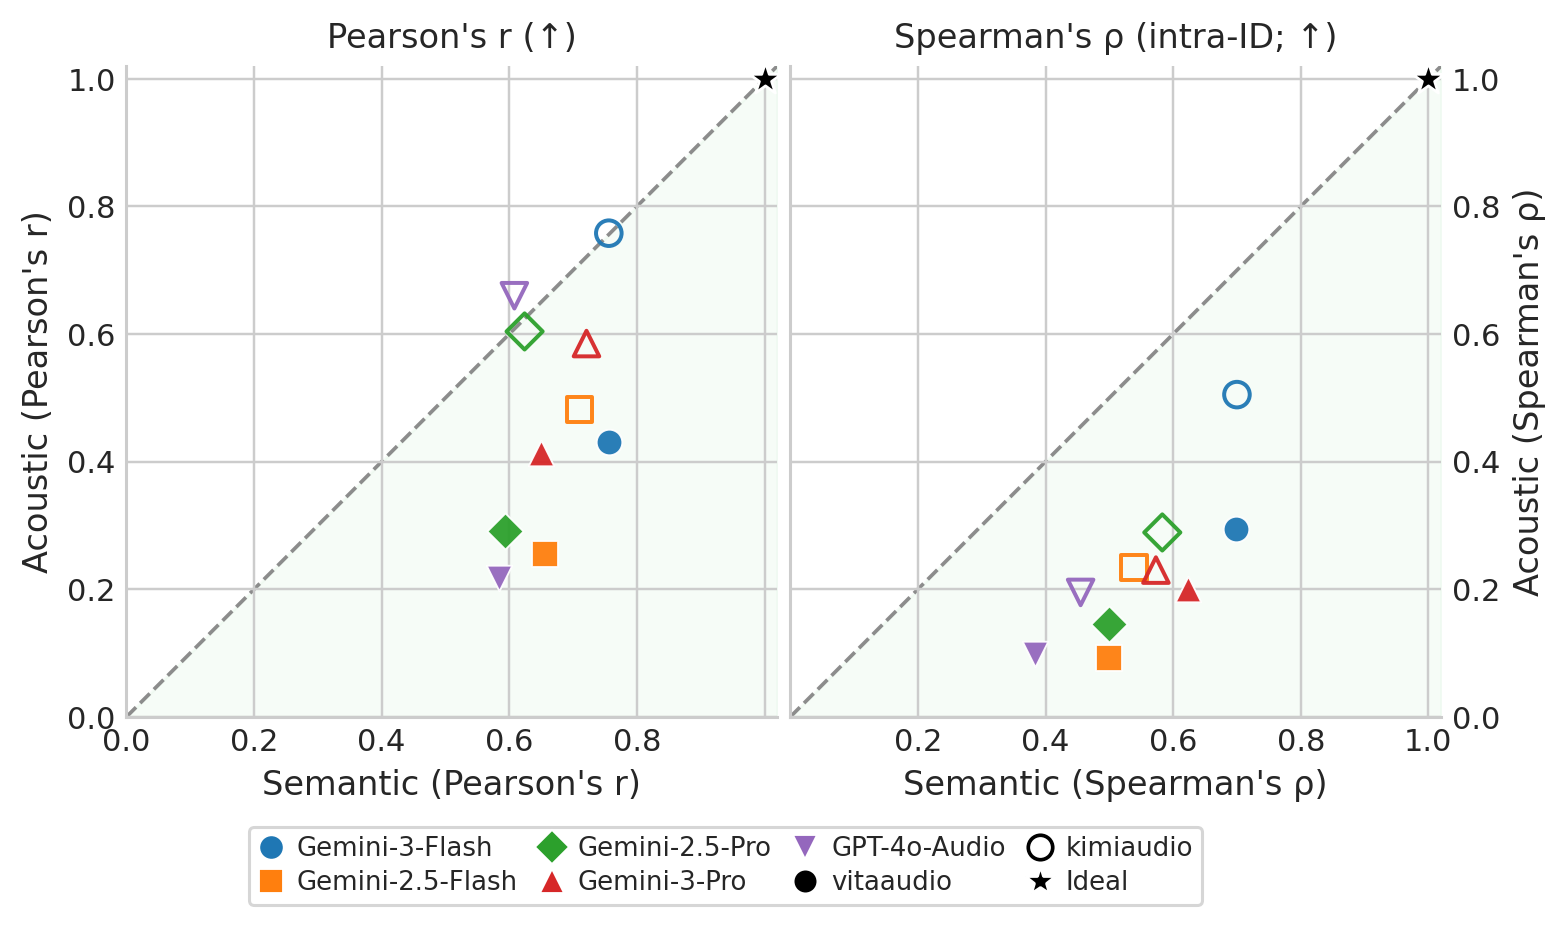
图2SOTA音频理解模型奖励信号可靠性评估
其次,论文强调,当前奖励模型或自动评估信号在语义维度上的可靠性,明显高于在声学维度上的可靠性。语义正确性通常更容易判断,而语音表现力、自然度和情感适配等属性则缺乏足够稳定的标量奖励。作者在分析中指出,当这类噪声较大的偏好信号被分摊到长序列的speech token 上时,信用分配会变得更加困难,也更容易诱发“分数提高但听感下降”的现象。
三、强化学习算法在多模态输出上存在梯度失衡的问题
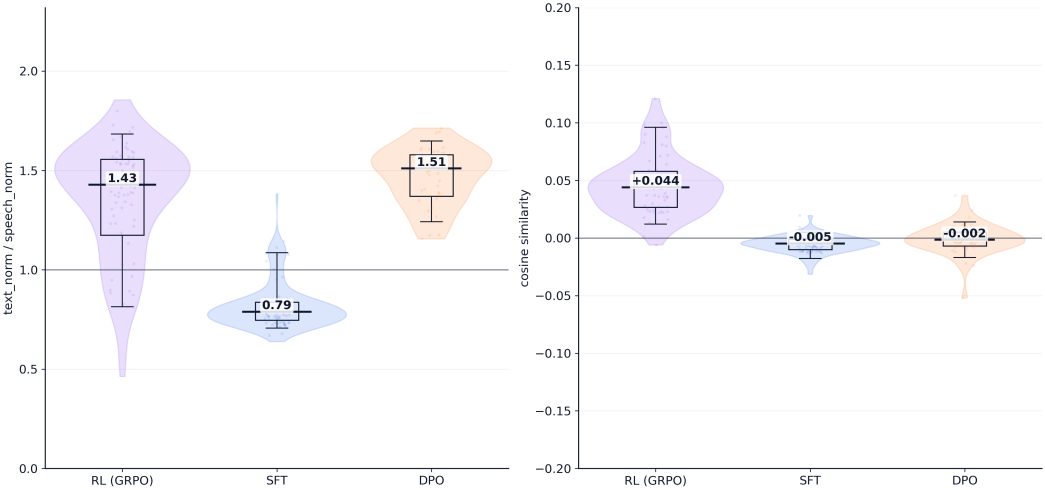
图3训练模态梯度统计
再次,从梯度层面看,论文给出的结论是:偏好梯度更倾向于集中在承载语义信息的文本部分,而语音部分在统一目标下往往接收到低信噪比、高方差的更新。由于speech token 数量密集、时序更长,如果仍将统一的序列级偏好目标直接施加到全部 token 上,噪声梯度会在语音通道中累积,从而影响韵律、音色和整体自然度。换言之,文本与语音虽然共享参数,但在后训练阶段并不适合接受完全同质的优化信号。
四、语音对话模型声学输出多样性有限
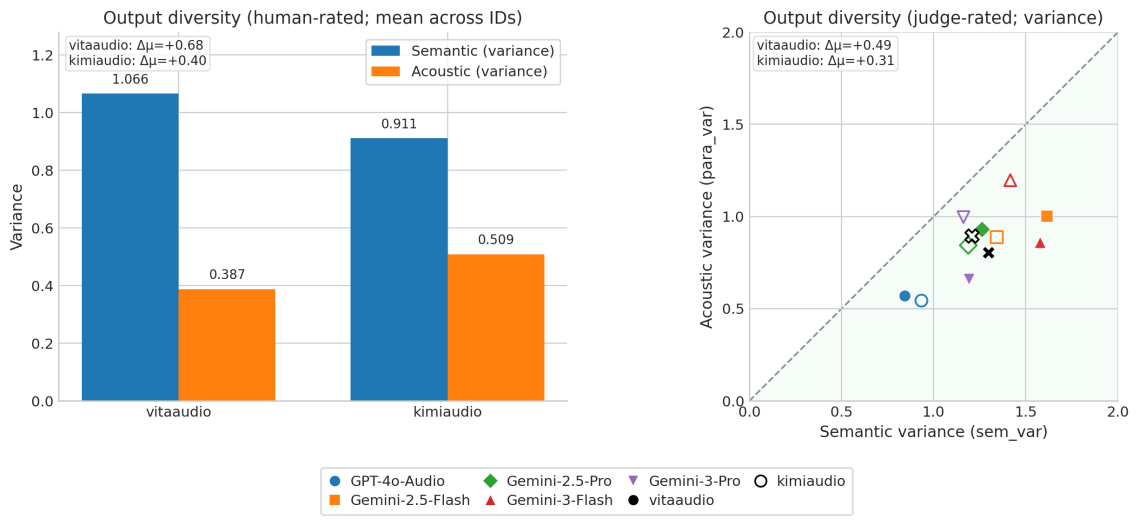
图4对话模型输出多样性评估
最后,论文还指出,rollout 质量和样本可区分性在训练过程中并不稳定,尤其对于能力较弱的基座模型而言,高质量的语音候选本就稀缺,奖励方差往往不足。在这种情况下,使用固定的 SFT/RL 混合比例,很容易出现两种问题:要么在信号不足时过度依赖偏好优化,带来训练不稳定;要么在有价值样本出现时又无法充分利用偏好信息。因此,训练权重应当能够随着 rollout 质量动态调整,而不是预先固定。
⏩方法细节:以“模态分工”替代“统一优化”
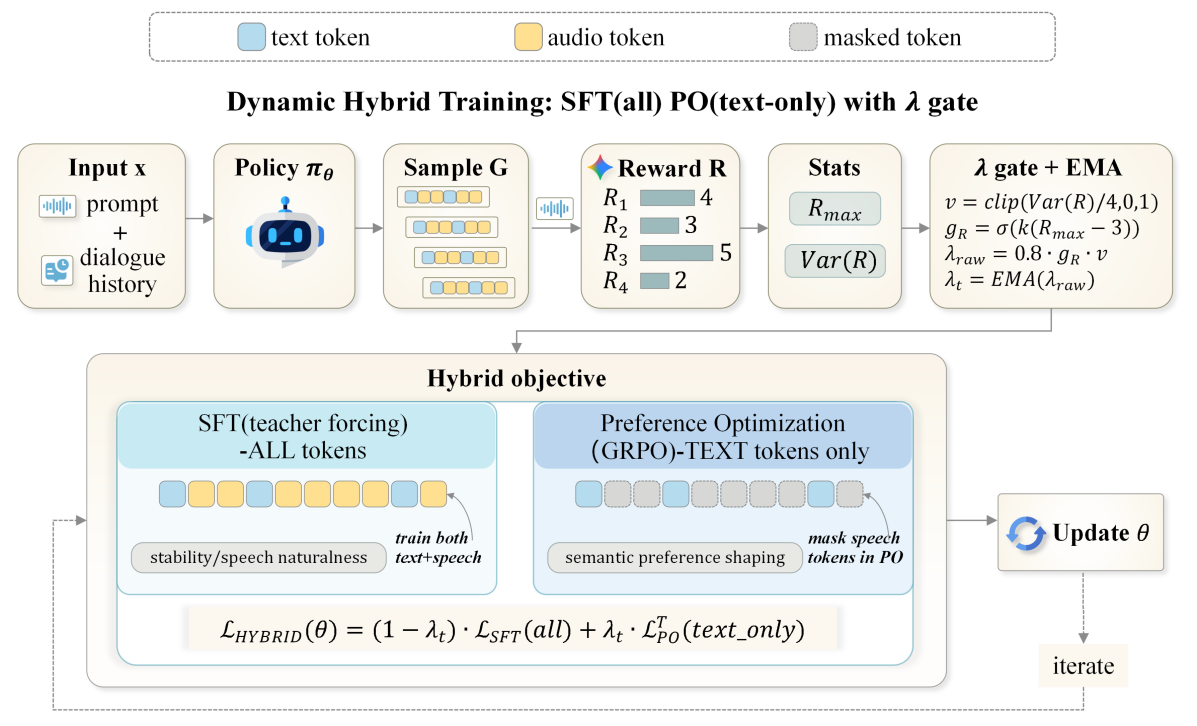
图5方法总览
基于以上分析,WavAlign 提出了一种单阶段的自适应混合后训练框架。其核心思想是,将偏好优化限制在文本token上,用于提升语义行为;同时保留对全部 token的 SFT 约束,尤其将其作为语音分布的稳定锚点,以维护自然度和表现力。论文将这一目标写为动态混合损失,其中 SFT 负责整体可行性与声学稳定性,GRPO 仅作用于文本区域,用于进行更可靠的语义偏好塑形。
在此基础上,作者进一步引入了一个轻量的动态门控机制来调节混合权重。该机制主要依据两类统计量:一是当前rollout 中是否存在足够可靠的高质量样本,二是候选样本之间是否具有足够区分度。只有当这两方面条件同时满足时,系统才提高偏好优化权重;否则,更大程度保留 SFT 的主导作用。论文同时采用 EMA 对权重进行平滑,以减少 on-policy 采样带来的波动。这个设计体现出较强的问题针对性:它并不假设偏好优化始终优于监督学习,而是将其视为一种需要在“信号可靠”前提下谨慎使用的局部增强手段。
⏩实验验证:动态混合训练在IQ 与 EQ 上取得更优平衡
论文在两种代表性端到端语音对话架构上进行了实验,分别是交错式的VITA-Audio 与并行式的 KimiAudio,并在 VoiceBench、OpenAudioBench 和 VStyle 三类基准上联合评估语义智能(IQ)与语音表现力(EQ)。结果表明,简单的 full-token 偏好优化并不是有效方案;将偏好更新限制在文本 token 上,能够带来更稳定的收益;在此基础上加入动态门控后,模型取得了更优的综合表现。
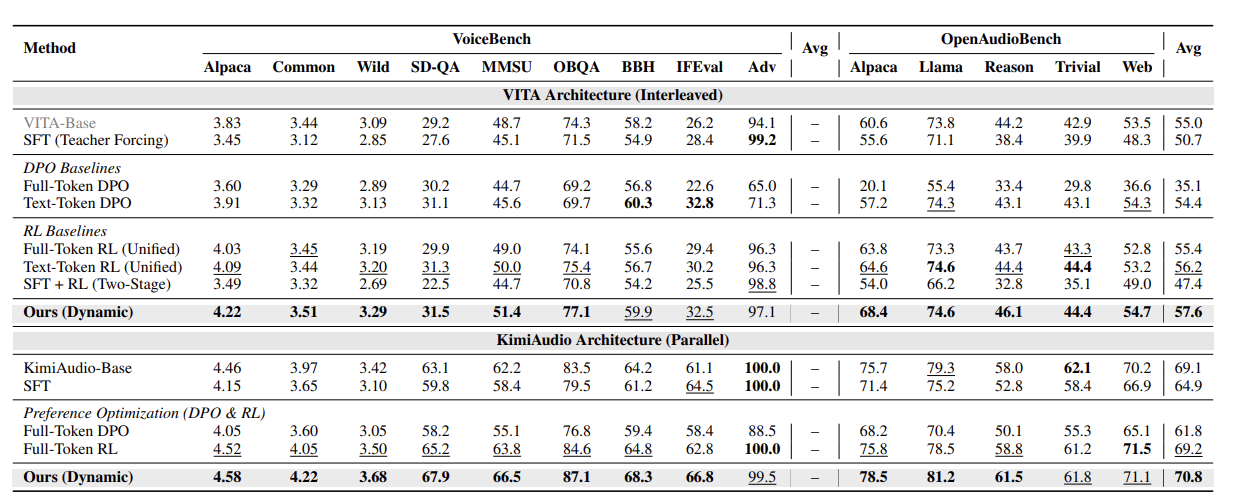
表1智力benchmark测评
这一点在消融实验中表现得尤为清楚。论文表明,在相同训练预算下,若采用固定0.5/0.5 的 SFT/RL 混合比例,all-token 方案的 IQ/EQ 为 48.70 / 2.48,而text-token 方案提升到 52.60 / 2.60;进一步加入动态权重与 EMA 平滑后,结果达到 55.24 / 2.92。这一结果说明,方法的有效性并非仅来自“混合训练”本身,而更关键地来自对优化范围和优化时机的重新设计。
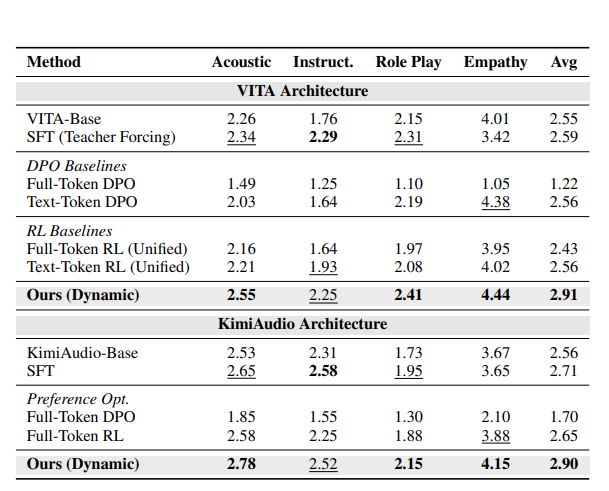
表2表现力benchmark测评
在主实验中,WavAlign 也展现出较好的跨架构一致性。以 OpenAudioBench 平均分为例,VITA-Audio 从 base 的 55.0 提升到 57.6,KimiAudio 从 69.1 提升到 70.8;在 VStyle 上,VITA-Audio 的平均 EQ 从 2.55 提升到 2.91,KimiAudio 从 2.56 提升到 2.90。这些结果表明,该方法并非单纯偏向语义质量或语音表现力中的某一侧,而是在两者之间取得了更平衡的改进。
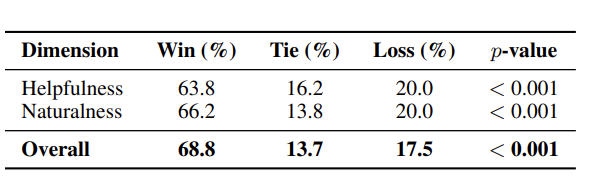
表3人类主观评测
此外,论文还报告了人工主观评测结果。在VITA-Audio 上,与原始模型相比,WavAlign 在 Helpfulness 上的胜率为 63.8%,在 Naturalness 上的胜率为 66.2%,总体胜率为 68.8%。这一结果从用户可感知的层面进一步支持了论文的主要判断:通过限制偏好优化对语音通道的直接扰动,并保留监督学习作为声学锚点,可以在提升任务完成度的同时,更好地维持自然听感。
⏩总 结
总体来看,WavAlign 的贡献不仅在于提出了一种新的后训练框架,更在于它较清晰地说明了:文本领域成功的偏好优化经验,不能不加区分地直接迁移到端到端语音对话模型上。语义优化与语音稳定并不是同一种学习信号能够同时高效解决的问题。WavAlign 通过“文本偏好优化、语音监督锚定、混合权重动态调节”的设计,为端到端语音对话模型提供了一条更稳健的后训练路径,也为后续研究如何同时提升模型的智能性与表现力提供了有价值的参考。
👓作者介绍
陈奕甫,浙江大学硕士生,研究方向:音频大模型,端到端语音模型,强化学习。其多项工作被ACL,EMNLP接收。
联系方式:Eve106298@163.com
