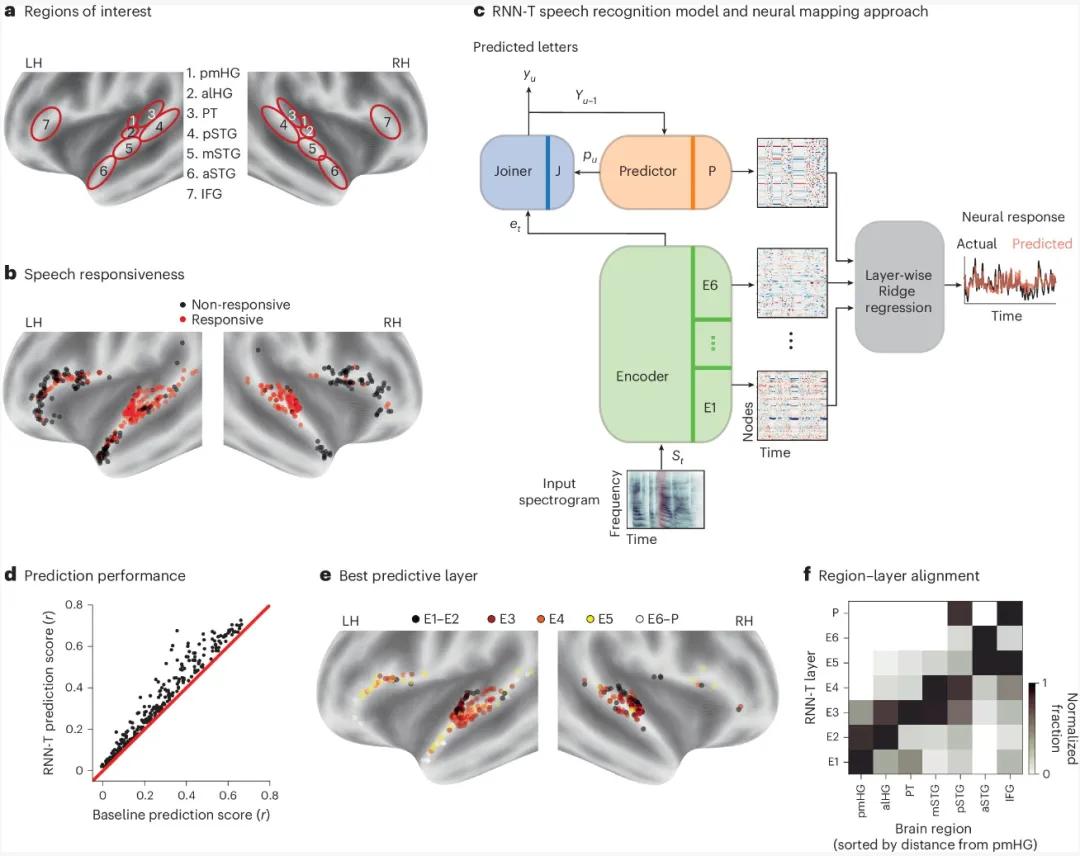
在过去几十年中,计算机科学家开发了许多能够处理不同语言的人类语音的人工智能(AI)系统。然而,这些模型在多大程度上复刻了人类理解口语时的大脑运作机制,目前尚无明确结论。哥伦比亚大学、IBM研究院和费恩斯坦医学研究所的研究人员最近开展了一项研究,旨在比较自动语音识别(ASR)系统与人类大脑在解码语音时的差异。这项研究成果发表在Nature Machine Intelligence上,研究显示,人类在理解口语时特定脑区的活动,与AI模型处理语音的特定阶段相对应。“我们想要解决的核心谜团是,人类大脑如何完成这一惊人的计算壮举 —— 将原始声波振动,也就是语音声音,转化为离散的语言语义,”论文的资深作者Nima Mesgarani表示,“现在我们已经有在语音转写方面表现与人类相当的 AI 系统,但我们还不清楚它们是独立实现这一效果,还是与人类生物机制形成了相同的处理策略。” 基于自动语音识别(ASR)建模的大脑语音处理阶段。图片来源:Nature Machine Intelligence(2026)。DOI:10.1038/s42256-026-01185-0 将脑活动与AI的语音处理过程相匹配论文作者Mesgarani、Menoua Keshishian及其同事表示,这项工作的主要目标,是探明 AI 模型与人类大脑是否通过相似的基础计算策略将声音转化为语义。为此,研究人员将经过训练用于语音识别的循环神经网络(RNN)的内部表征,与 15 名癫痫患者治疗监测期间记录的大脑活动进行了对比。“这些患者的听觉皮层中植入了高精度电极,用于定位异常脑活动,”Mesgarani 解释道,“在监测过程中,他们自愿参与实验,聆听了 30分钟的连续有声故事。”研究人员提取了受试者聆听故事时的大脑记录数据,并将其与处理相同故事音频的 AI 系统内部状态进行比对。本研究采用的 AI 系统为循环神经网络(RNN),这类计算模型的设计初衷是模拟生物神经网络的结构。Mesgarani说:“与许多常见的AI模型(如大语言模型中的transformer)不同,我们使用的RNN具有‘因果性’,也就是说它会像人类大脑一样,逐步实时处理语音。我们给 AI 播放了相同的故事,并观察其程序每一层的内部状态。通过回归分析方法,我们能够判断 AI 的特定‘层级’是否对应大脑特定区域的数字映射空间。我们测试了从原始音高到复杂语义的所有信息维度。”有趣的是,Mesgarani、Keshishian和他们的同事发现,人类受试者大脑处理有声故事的层级结构,与循环神经网络内部层级对语音的分步处理模式高度相似。简而言之,AI 模型与人类大脑似乎都会逐步解析口语,最终解码其语义。Mesgarani解释说:“这两个系统遵循几乎相同的顺序,从基本声学特征逐步发展到语音、词汇(单词),最后到语义信息。随着深入 AI 的更深层网络,其信息会在拓扑结构上与人类大脑皮层层级相对应,从初级听觉中枢向外延伸至更高级的语言脑区。这表明,这种特定的层级化转换模式,很可能是生物进化与任务优化型 AI 共同发现的一种稳定、高效的计算解决方案。”未来研究与AI开发的路径这项近期研究结果表明,ASR模型(特别是RNN)通过与人脑处理过程极为相似的计算策略来处理语音。未来,这项工作可能激发进一步的探索,更详细地比较人类大脑与特定AI模型在处理不同任务时的相似性。Mesgarani说:“借助这些性能已与人类相当的模型,我们可以将其视作‘透明化’的大脑,以此理解其计算原理。然而,这仅仅是个开始。我们的 AI 模型采用单一路径处理信息,而人类大脑具有显著的偏侧化特征:左半球在高级语言任务中占据绝对主导地位。我们仍需探究生物机制为何倾向于这种‘双侧’分化结构,以及构建‘双路径’AI 模型能否为人类处理复杂交流的方式带来新的认知。”值得注意的是,研究人员发现,只有当循环神经网络模型针对特定语言的语音进行训练时,才会呈现出这种类脑计算策略。在后续研究中,他们希望进一步探索这一现象,判断其是否能反映大脑处理母语与外语的差异。“我们不禁思考:掌握一种语言的大脑,在处理第二种语言时,是否使用相同的‘硬件’,却采用不同的‘软件’策略?”Mesgarani 补充道,“我们的最终目标不只是打造更优秀的 AI,而是将这些模型作为明确假说,探究大脑如何实现从声音到语义的转化。未来,我们有望模拟大脑的语言处理过程,精准揭示生物智能的独特性,以及这一过程出现功能障碍的原因。”论文信息:Menoua Keshishian et al, Parallel hierarchical encoding of linguistic representations in the human auditory cortex and recurrent automatic speech recognition systems,Nature Machine Intelligence(2026).DOI: 10.1038/s42256-026-01185-0本文源于:21db声学人
 语音小管家