
 语音小管家
本文来源:模型之声
标题:《Toward Fair Speech Technologies: A Comprehensive Survey of Bias and Fairness in Speech AI》
链接:https://arxiv.org/pdf/2605.01597
作者单位:National Taiwan University、University of Southern California、NTU AI-CoRE
发表日期:2026 年 05 月 02 日
作者简介:李宏毅(Hung-yi Lee)现任台湾大学电机工程学系副教授,同时在资讯工程学系兼任。他主导建立了 SUPERB(Speech Processing Universal PERformance Benchmark)自监督语音学习评测基准,吸引了微软、Meta 等全球 40 余家机构参与。他在 Google Scholar 上被引用超过 18000 次,同时运营着广受欢迎的深度学习中文教学频道。
值得参考的点
语音模态的独特公平性挑战:语音信号中敏感属性(口音、身份、情感)与语言内容在时间和频率维度上高度纠缠,无法像文本或图像那样通过离散替换或区域遮蔽来剥离敏感信息。这一物理特性使得语音公平性研究需要独立于 NLP 和计算机视觉领域的专门框架。
三范式演进视角:论文将语音公平性研究的发展归纳为 Robustness、Representation、Governance 三个逐步深化的范式,从关注性能差距到关注表征中的社会意义编码,再到关注数据治理和制度层面的权力不对称,为理解该领域的学术演进提供了清晰脉络。
从定义到度量的映射体系:论文形式化了 7 个公平性定义,推导出 6 个数学度量族,并提供了一棵决策树帮助从业者根据任务特征选择合适的评估指标,填补了语音领域缺乏系统性度量框架的空白。
Pipeline 视角的偏见诊断:论文将偏见来源按数据、模型、部署三个阶段展开,揭示了语音领域特有的偏见机制——如信道特征作为人口统计学代理变量、情感标注中的评注者主观性等,这些在通用机器学习公平性综述中通常被忽视。
背 景
语音处理技术(ASR、TTS、SER、SV、SpeechLLM 等)已从实验室环境走向高风险部署场景,包括医疗、司法、招聘和个人助理等领域。传统以 WER、RTF、MOS 等工程指标为核心的评估体系,已不足以衡量这些系统对不同社会群体的差异化影响。
现有公平性综述存在两方面不足:通用机器学习公平性综述未考虑语音信号的特殊性(声学纠缠、连续信号、交互特性),而语音领域的已有综述往往聚焦于单一任务(如 ASR 或 SV),缺少跨任务的共性分析。本文综合了 400 余项研究,覆盖语音生成与感知任务以及新兴的 Speech Language Model ,构建了一个从形式化定义、评估度量、偏见诊断到缓解策略的统一分析框架。
核心框架
本文作为综述类论文,其核心贡献在于提出一套完整的分析框架,包含四个层次:形式化定义、评估度量、偏见诊断、缓解策略。
公平性的形式化定义
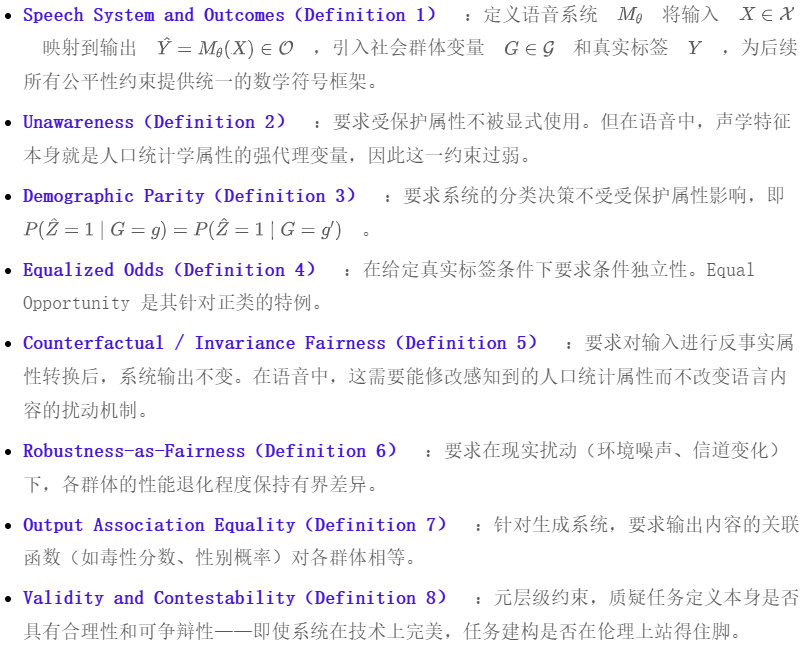
论文针对语音模态形式化了 7 个公平性定义(Definition 1-7),另有一个元定义(Definition 8)。Definition 1 为后续所有定义建立共享符号体系,Definition 2-7 按约束强度从弱到强排列,Definition 8 在元层级质疑任务本身的合理性:
三范式演进:Robustness、Representation、Governance
论文通过对文献的主题分析,识别出三个共存但逐步深化的公平性范式:
Robustness(约 2015-2020 年为主):将公平性操作化为 performance parity ,关注 ASR、SV 等判别任务中不同人口统计群体之间的错误率差距。这一阶段的核心假设是群体间差异属于分布失配,应通过扩充数据覆盖和模型适配来弥合。其局限在于将群体间变异视为需要消除的噪声,而非有意义的身份表达。
Representation:随着语音技术扩展到推断或生成说话人特征的任务(SER、TTS、VC),公平性关注点从"性能差距"转向"表征中的社会意义编码"。核心议题包括:profiling 中的本质主义假设(将声学特征到个人属性的映射视为固定和普遍的)、TTS/VC 系统中的刻板印象复制(如语音助手默认使用女性声音)、以及身份擦除(如性别识别系统强制二元分类)。
Governance:将公平性归因于社会技术系统中的权力不对称,关注三个层面——技术层面的级联管道效应(上游感知组件的微小偏见被下游 LLM 放大)、交互层面的数字权威性(用户对自动语音系统的过度信任)、制度层面的数据主权(边缘化社群对其语言数据的收集和使用缺乏控制权)。
评估度量的数学族分类
论文将现有评估度量按数学目标而非任务归纳为 6 个族:
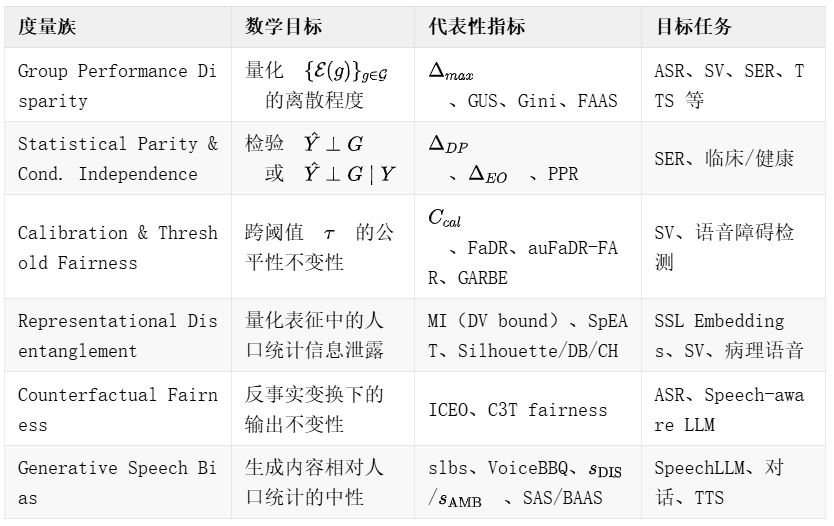
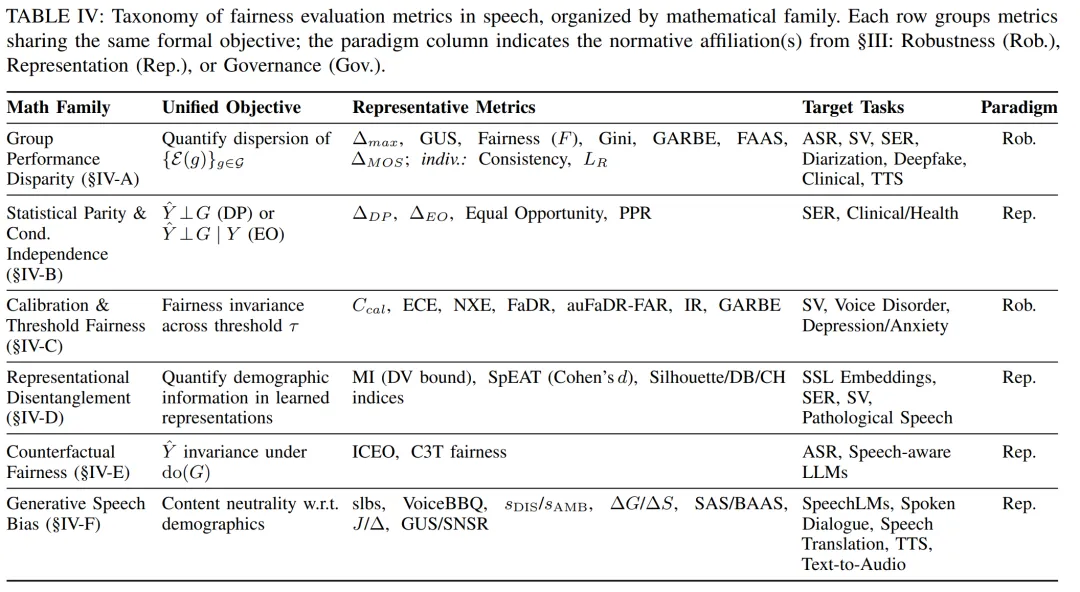
题注内容:语音公平性评估度量的数学族分类,按数学目标而非任务组织
论文同时建立了度量族与公平性定义之间的映射关系,明确了哪些度量直接操作化哪些定义。
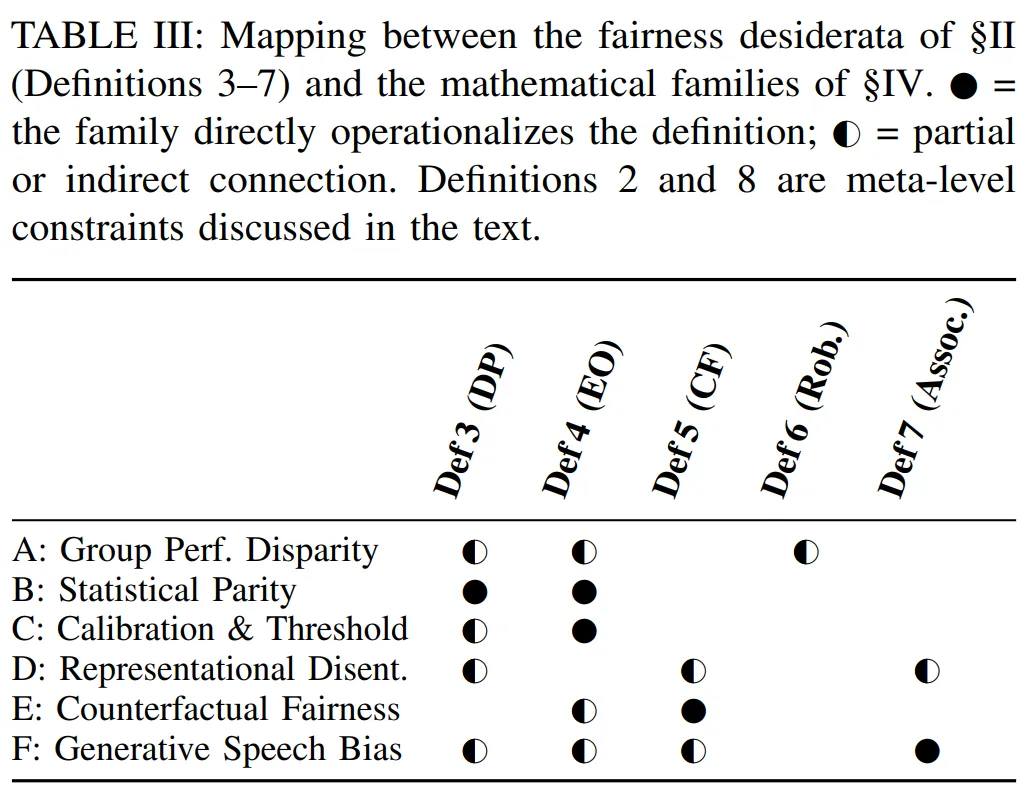
题注内容:公平性定义(Definition 3-7)与度量族之间的映射关系
偏见来源的 Pipeline 诊断
论文将偏见来源沿语音处理管道组织为三大类,并细分为 10 个子类:
数据相关偏见:
人口统计与语言表征偏差:标准数据集的人口构成反映社会等级而非实际人口分布,在性别、年龄、种族/民族、非典型语音等维度均存在严重不足。元数据缺失(如缺少非二元性别标签)进一步阻碍了公平性评估。 数据收集、质量与伪影:社会经济差异表现为 channel bias ——边缘化群体的数据不成比例地在高混响环境或低保真度设备上录制,模型可能将信道特征作为人口统计学代理变量。 标注与标签主观性:情感标注受评注者感知偏见和文化距离影响,产生系统性标签噪声。这些主观偏差被冻结为训练标签的一部分,被下游模型继承。
模型相关偏见:
架构局限与特征纠缠:说话人验证中的表征纠缠、端到端语音模型中 tokenizer 对低资源语言的不公平分割、以及模型压缩对边缘群体性能的不成比例降级。 解码与后处理假设:VAD 阈值误分类口吃停顿为静音,语言模型的流利度概率过度纠正重复语句。 生成模型特有偏见:TTS、VC、SpeechLLM 主动构建说话人身份,在未指定说话人时默认使用与主流社会群体对齐的声音。
部署失配:
基准与现实的差距(benchmark-reality gap)。 风格迁移与语境脆弱性:在朗读语音上训练的模型面对自发语音时性能崩溃。 环境与硬件变异性。
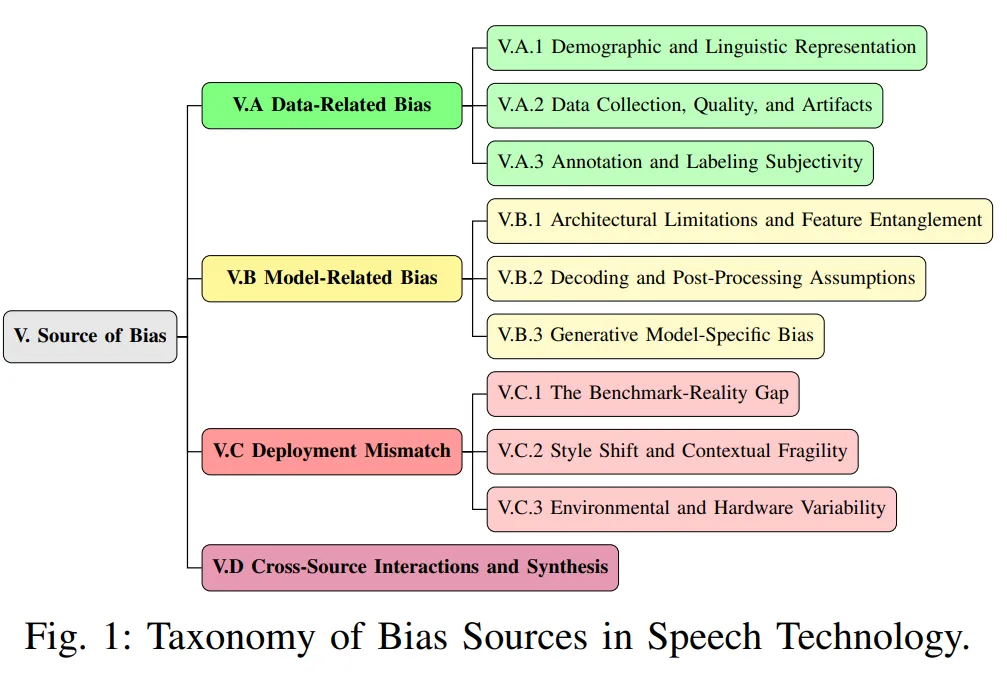
题注内容:语音技术中偏见来源的分类体系,涵盖数据、模型、部署三个层面及其交叉作用
缓解策略的四阶段体系
论文按干预在模型生产管道中的位置,将缓解策略分为四个阶段:
数据层干预(Data-centric):在模型训练之前作用于输入分布。包括:数据多样化与扩展(参与式数据收集让边缘化社群作为协作者而非被动对象)、战略性重采样与重平衡(上采样少数群体/下采样多数群体以平衡训练分布的影响)、数据选择与课程学习(基于难度/多样性/不确定性动态调整样本优先级)、反事实数据增强(合成"what-if"语音对以隔离敏感属性的因果效应)。
特征层方法(Feature-level):可回溯性地应用于已有预训练模型,不需要完整重训练。包括:几何子空间投影(通过线性代数操作从嵌入空间中去除敏感信息)、特征重加权(定位并衰减编码偏见的频谱-时间区域或特征子集)、模型压缩(剪枝/量化/蒸馏隐式正则化掉编码人口统计线索的虚假关联)。
训练层算法(Training-level):在优化过程中修改损失函数或梯度信号。包括:对抗性解纠缠(通过梯度反转层迫使表征对群体成员不变)、对比对齐(通过对比学习对齐跨群体的表征几何)、目标函数修改(向标准损失添加公平性惩罚项
推理与后处理(Inference and post-processing):部署后不修改数据或模型。包括:测试时输入适配(VC 实时预处理中和人口统计线索)、测试时表征干预(k-NN 增强解码、激活引导)、测试时参数适配(f-LHUC 等从少量测试数据估计子群体参数)、解码与重评分策略(交叉话语重评分、语速感知 beam search 惩罚项)、LLM 驱动纠错(利用冻结 LLM 的语义推理能力映射口音引起的语音错误)、阈值校准(拟合群体特定决策阈值以均衡错误率)、提示与上下文学习(离散提示、少样本示例注入唤醒少数语言模式的休眠能力)。
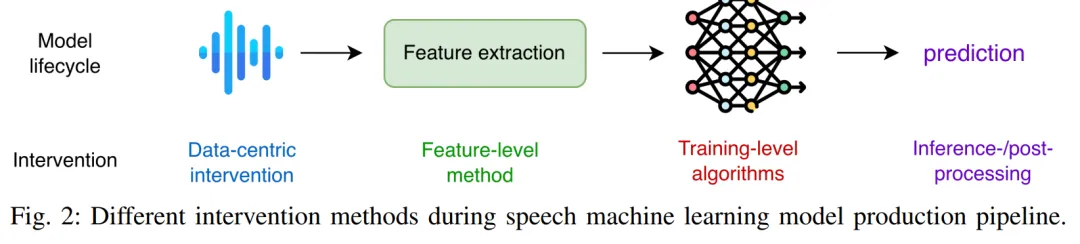
题注内容:模型生产管道中四个阶段的公平性干预方法
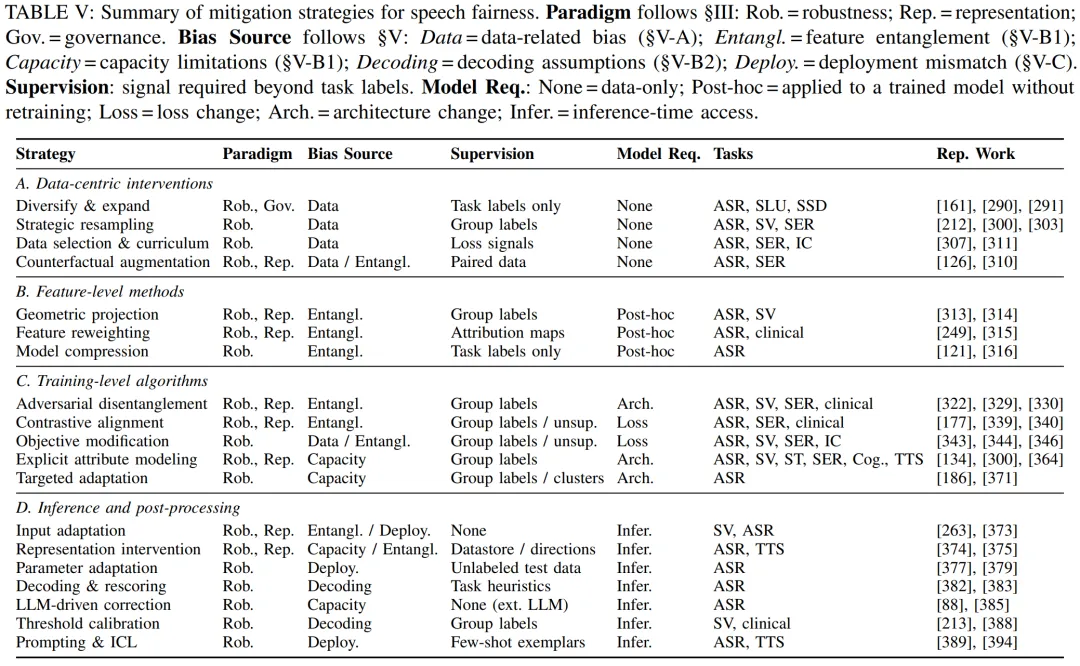
题注内容:缓解策略的全面总结,映射到范式、偏见来源、监督需求、模型要求和目标任务
伤害分类体系
论文针对语音领域构建了两套独立的伤害分类体系,区分了分配性伤害(Allocative Harms)和表征性伤害(Representational Harms),并为每类伤害提供了语音技术中的具体表现。
分配性伤害涉及资源和机会的不公平分配,包括:服务差异(ASR 对少数族裔说话人的高错误率)、机会丧失(自动化招聘面试中基于声音特征的不公平筛选)、经济损失(语音认证系统因年龄引起的声学变化而锁定用户银行账户)、物理风险(语音激活紧急系统无法识别带口音或受困的声音)。
表征性伤害涉及社会地位和身份的贬低,包括:刻板印象(语音助手将权威/财务建议合成为男性声音)、贬低(TTS 系统生成的"带口音"语音依赖冒犯性刻板印象)、擦除(性别识别系统强制二元分类,使非二元和跨性别身份不可见)、同质化(将尼日利亚、肯尼亚、印度英语等多样区域变体简单标记为"Non-Native")、规范偏见(将非标准口音定位为偏离假定规范的"有口音"语音)、毒性(毒性检测不成比例地标记含边缘化身份相关术语的中性语句)、文化挪用(TTS/VC 系统允许用户采用特定种族群体的声音特征)。
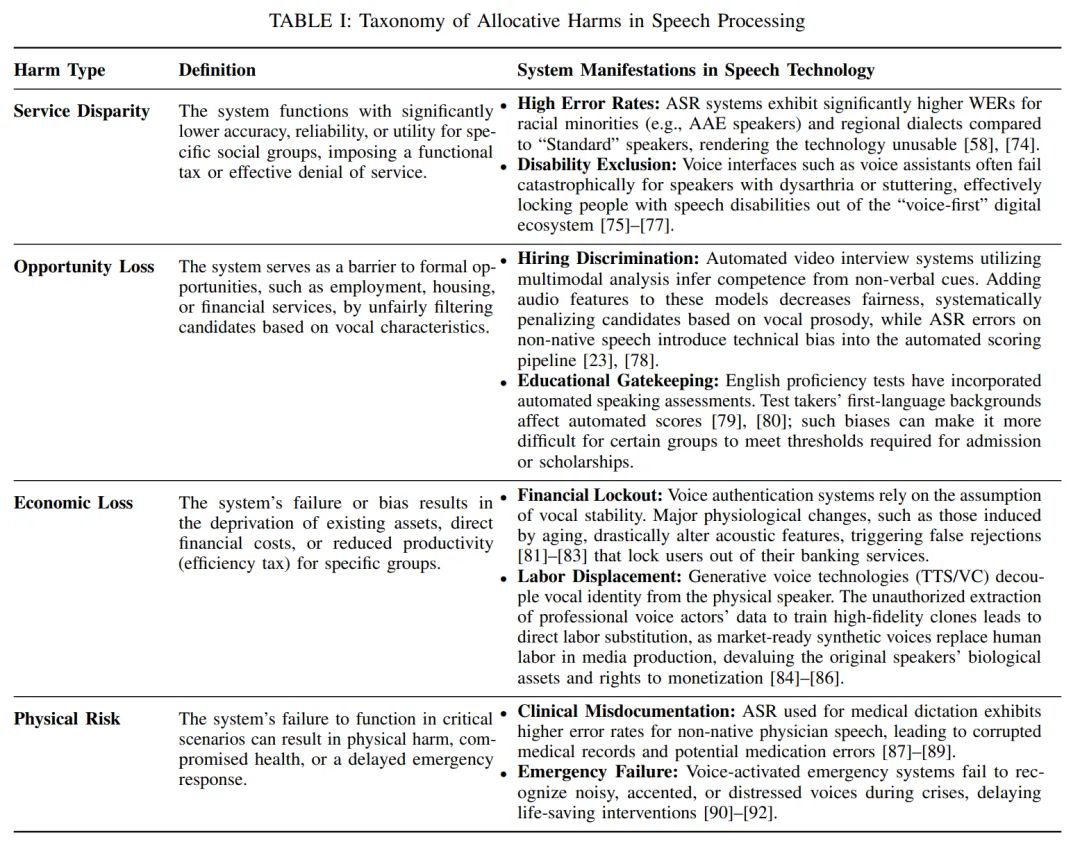
题注内容:语音处理中分配性伤害的分类体系
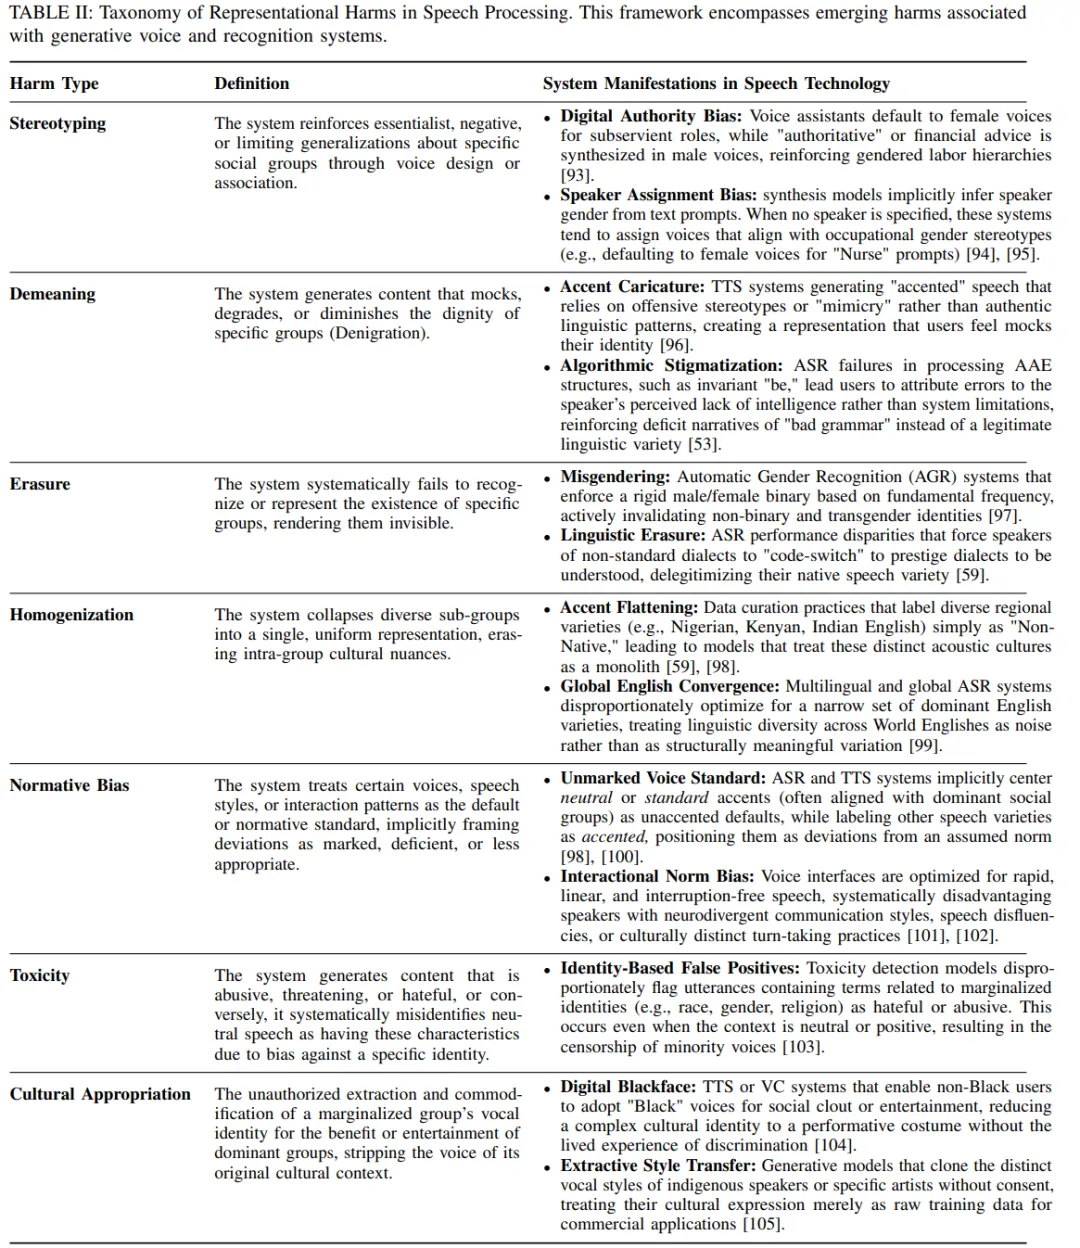
题注内容:语音处理中表征性伤害的分类体系,涵盖生成式语音和识别系统的新兴伤害
文献覆盖与分析发现
本文综合了 400 余项研究,覆盖范围包括 ASR、SV、SER、TTS、VC、Speaker Diarization、Deepfake Detection、SpeechLLM 等任务。论文从 Table V 的全局映射中得出三个核心发现:
发现一:Robustness 范式主导,Representation 和 Governance 范式严重不足。19 种缓解策略中,全部 19 种服务于 Robustness ,但仅 8 种同时涉及 Representational fairness ,仅 1 种触及 Governance 。这反映了该领域仍以性能差距均衡为主导关切。
发现二:特征纠缠是最广泛被干预的偏见来源。涵盖四个管道阶段的最多样化解决方案集中于特征纠缠问题,而部署失配(deployment mismatch)仅有推理时方法可用,缺乏系统性应对。
发现三:没有单一阶段的干预是充分的。数据干预无法阻止模型本身引入的偏见,训练层算法通常需要不一定可获得的人口统计标注,推理时方法只能部分补偿冻结模型已学习到的偏见。这些互补性缺口构成了开放挑战的动因。
开放挑战与未来方向
论文识别出七个关键挑战,并将它们组织为层次化的依赖关系:
标准化报告协议:需要系统记录录音语境、社会语言学特征和标注者人口统计,以支撑后续所有可复现的公平性审计。 伦理语料治理:从概念倡导转向技术和制度实现——数据信托、联邦评估协议、社群专属许可证、基于版税的价值再分配。 可扩展的多目标公平性优化:当前评估通常孤立优化单一公平性准则;需要构建多维基准,同时量化多个公平性指标和运营成本,导航 Pareto 前沿。 从数据稀缺到可控生成式合成:利用解纠缠表征学习合成保留隐私的多样化语音样本,同时需确保合成数据不过度简化边缘化语音的非线性声学特征。 偏见的机制可解释性:将因果追溯和激活修补等技术应用于语音模型,定位编码刻板关联的具体神经元或注意力头,实现"模型手术"式的精确去偏。 从静态训练到动态适配的测试时公平性:现有 TTA 框架(如 TENT)优化全局性能但不保证人口统计均衡;需要研究面向公平性的测试时目标函数。 生成式 AI 时代的公平性:涵盖三个子方向——对齐偏见与文化同质化(RLHF/DPO 是否系统性地惩罚方言韵律和代码切换)、生成式 SpeechLLM 中的分布性公平性(需要从样本级审计转向分布性分析)、多轮对话与智能体公平性(口音和感知性别在每个轮次持续暴露,对话内偏见是否随轮次递增)。
文章小结
本文是语音 AI 公平性领域迄今最为系统的综述,其核心价值在于构建了一个从形式化定义、数学度量、偏见诊断到缓解策略的完整分析管道。7 个公平性定义和 6 个度量族之间的显式映射,为从业者选择适合其任务场景的评估指标提供了决策依据。三范式(Robustness → Representation → Governance)的演进分析揭示了该领域从关注性能差距到关注社会意义编码、再到关注制度层面权力不对称的深化轨迹。论文同时揭示了当前研究的显著失衡——绝大多数工作集中于 Robustness 范式下的性能均衡,Representation 和 Governance 层面的研究仍有大量空白。
参考链接
论文 arXiv 页面:https://arxiv.org/abs/2605.01597 李宏毅教授主页:https://speech.ee.ntu.edu.tw/~tlkagk/
