
 语音小管家
在语音降噪风雨六十载(上)——传统信号处理黄金时代中介绍了传统信号处理算法在语音降噪中的应用,下面用一个视频总结下信号处理不同算法的优缺点。
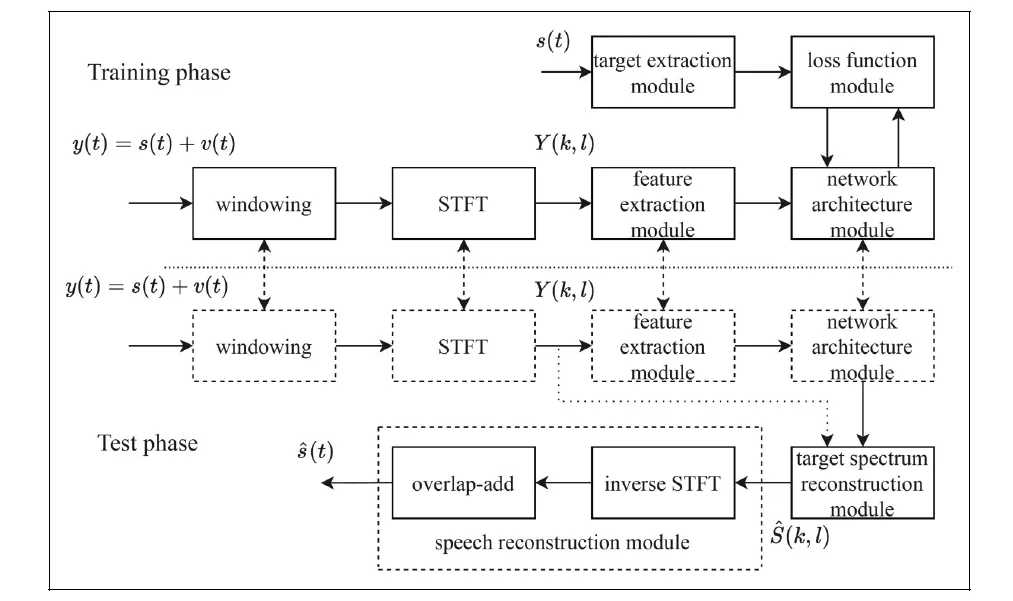
01 特征提取
基于基频(F0)的特征在计算听觉场景分析中被广泛应用于语音与多人混叠语音分离,但在低信噪比条件下,这类特征用于语音增强的效果较差,原因是基频特征的估计不够准确。值得一提的是,特征提取通常和网络结构绑定,在一个网络结构上有效的特征,换到另一个网络结构不一定有效。此外,对于幅度谱进行压缩可以限制动态范围让训练更容易并且压缩动态范围可以使用更小的比特数进行量化。
02 网络结构
正如在上一篇语音降噪风雨六十载(上)——传统信号处理黄金时代中提到的,人耳对相位不敏感这一假设在深度学习降噪中仍有应用。深度学习降噪初期的一些工作都是关注预测时频域的幅度谱,通过网络捕获时域和频域的相关性。比如最开始是将多帧输入在时间维度上concat起来然后送入全连接层,然而对于全连接层来说,它们并不能很好处理这种序列输入,因此循环神经网络(如LSTM,GRU)自然而然的被引入深度学习降噪的网络结构中。最近,卷积神经网络也被用于深度学习降噪用于提取局部特征与循环神经网络提取全局特征进行结合,进一步提升深度学习降噪的性能,这种卷积训练网络(Convolutional recurrent networks,CRN)结构已经成为深度学习降噪网络的主流范式。
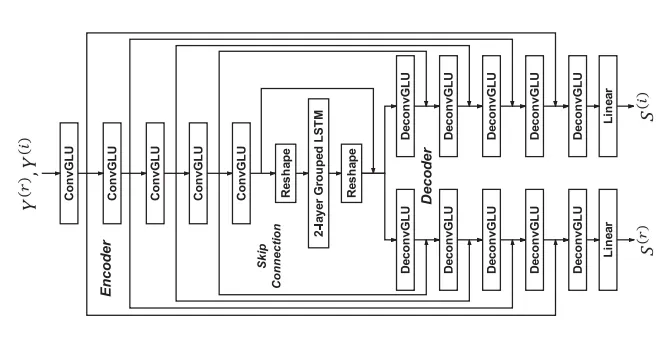
近些年来,学者们逐渐意识到相位对于语音降噪的重要性,因此一些工作不仅对幅度谱进行修改,也尝试预测干净语音的相位谱,比如Williamson提出网络预测复数mask(complex ideal ratio mask, cIRM),然后对频谱的实部和虚部进行修改提升语音质量。GCRN通过两组CRN网络结构分别估计干净语音频谱实部和虚部,并在encoder-decoder结构中引入门控单元,其结构如下所示
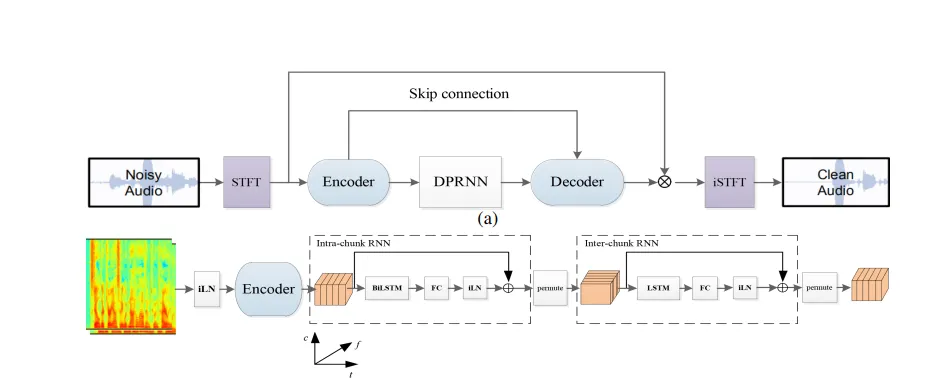
GCRN中使用的RNN不能很好处理长序列的梯度消失和梯度爆炸的问题。为了解决这一问题,DPCRN提出使用dual-path RNN,一组RNN用于学习chunk内部的信息,另一组RNN用于学习chunk之间的信息,其结构如下:
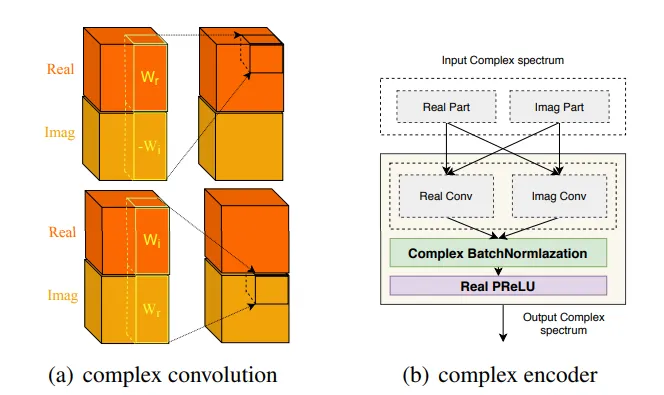
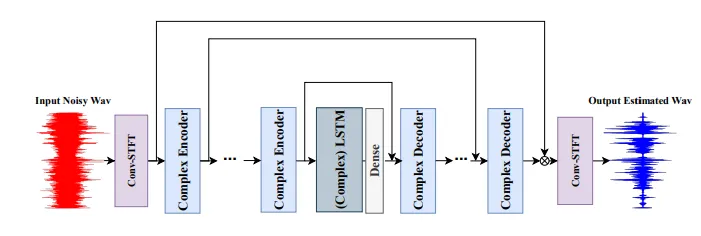
以上网络都是通过实数去计算cIRM,随后DCCRN提出复数卷积,结合U-net结构,进一步提升了深度学习降噪的性能,其结构如下所示
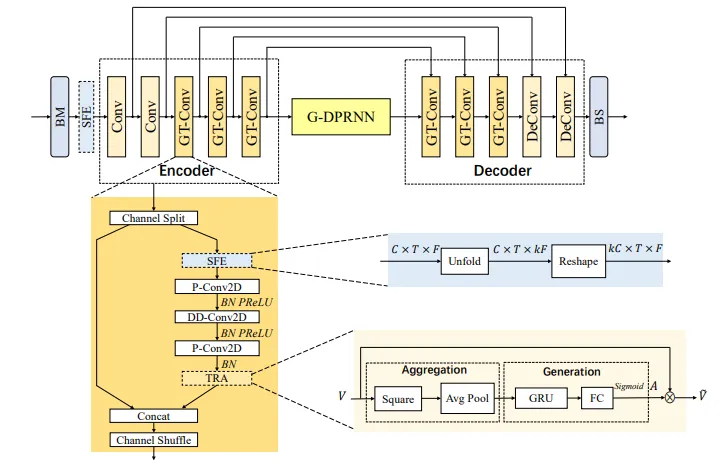
另外有一些工作把降噪与去混响结合起来,使用一个网络完成两个任务,比如SDDNet,其结构如下:
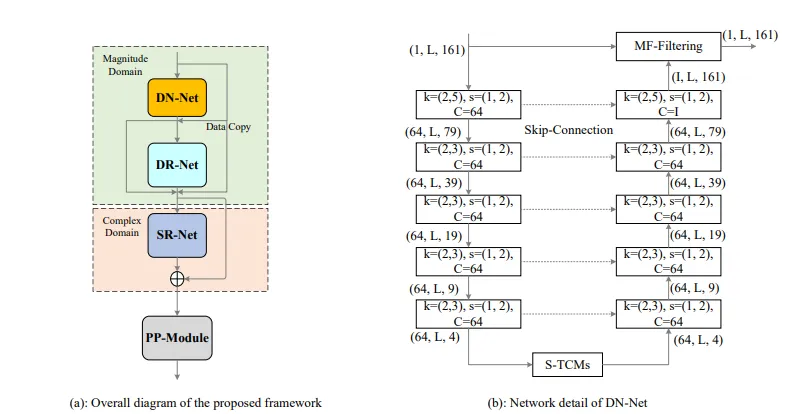
随着Transformer结构的兴起,也有人将其引入深度学习降噪,比如结合了U-net和Tranformer的Uformer,其结构如下:
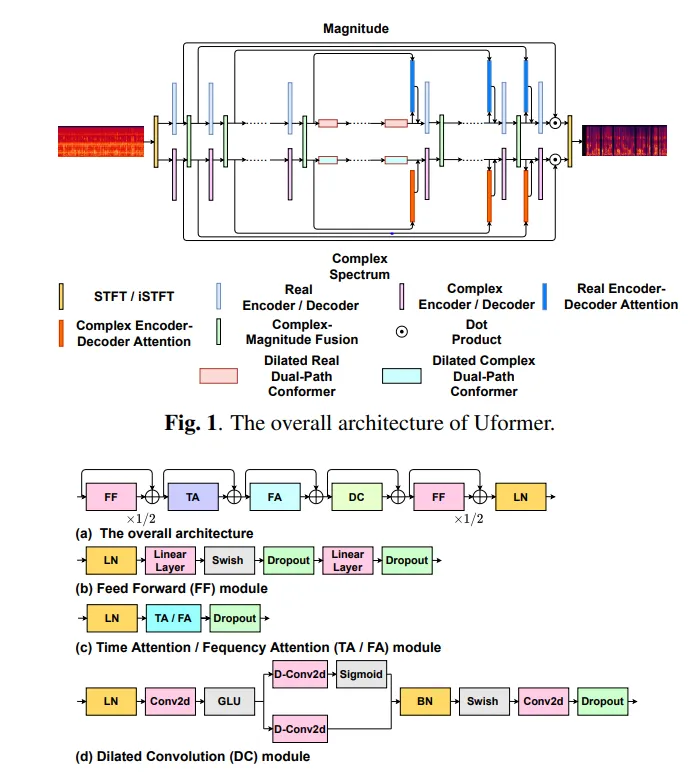
目前看来,深度学习降噪的网络结构范式如下:包含CRN的encoer-decoer与U-net结合的网络结构预测复数谱或者幅度谱的mask。
03 训练目标
训练目标在深度学习任务中起着至关重要的作用,好的训练目标可以获得高质量的语音和可懂度。深度学习降噪的学习目标可以分为基于mask的和基于mapping两大类。
理想二值掩码(ideal binary mask, IBM)是早期常用的学习目标,它对每个T-Fbin进行预测,计算公式为
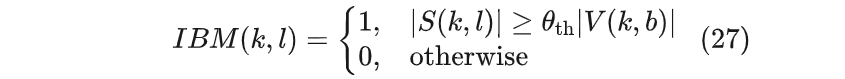
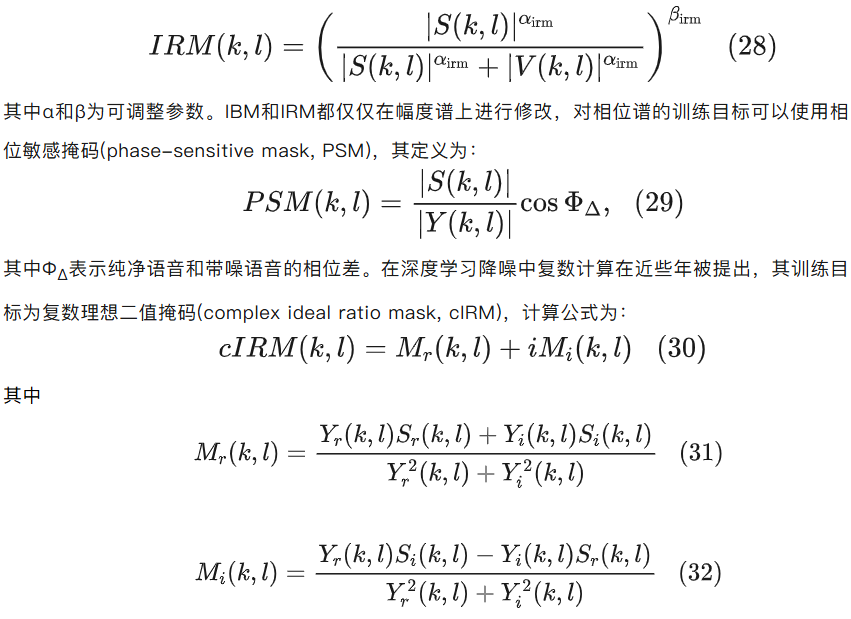
其中θth为阈值,其幅值通常取值范围为0.5~1对应−6dB~0dB。理想二值掩蔽将每个时频单元标记为目标主导或噪声主导,并将语音增强任务转化为有监督分类问题。采用 IBM 能获得较好的语音可懂度,但语音质量仅处于中等水平。与对每个时频单元使用硬阈值不同,Narayanan提出的理想比值掩码(ideal ratio mask,IRM)对每个时频频点施加衰减系数:该频点的估计信噪比越低,衰减量越大,可以表示为:
其中α和β为可调整参数。IBM和IRM都仅仅在幅度谱上进行修改,对相位谱的训练目标可以使用相位敏感掩码(phase-sensitive mask, PSM),其定义为:
04 损失函数
在深度学习中,损失函数用于评估一个模型的好坏,以及指导如何调试超参数。在早期的工作中,由于IBM的取值只有0和1,因此BCE作为损失函数再适合不过了。随着研究的进行,IRM逐渐成为主流,基于MSE的损失函数也层出不穷,对于幅度谱和复数谱它们对应的MSE损失函数可以分别表示为
值得注意的是在对复数谱计算MSE时,相位误差会减小但是幅度误差会增加,为了缓解这一问题,可以进行补偿,即
此外也有一些工作使用MAE作为损失函数。更多的损失函数介参考AI降噪的N种损失函数。
深度学习降噪直接影响人的听感,因此也有一些工作直接使用感知的评价指标直接作为损失函数,比如SI-SNR,PESQ,STOI等,由于这些指标是越大越好,不符合深度学习训练最小化损失函数的,因此在实际应用中会添加一个负号。目前主流的深度学习降噪算法很少使用单一的损失函数,一般都是使用多种损失函数进行组合,从而达到更好的降噪性能。
05 深度学习语音降噪总结
深度学习语音降噪借助于神经网络的强大能力,取得了让人难以忽视的效果,因此目前学术界和工业界已经全体转向深度学习降噪了。然而,深度学习的计算开销是不容忽视的一环,在一些算力功耗有限的场景,传统语音降噪仍将占有一席之地。此外,延迟也是深度学习降噪的另一个瓶颈,在一些要求低延迟的场景比如耳机、助听器等,如何部署轻量级低延迟模型也是需要关注的问题。不可否认的是,深度学习降噪目前已经在诸多场景落地,并且其还有强大的活力,可以结合其他深度学习算法,给用户提供全新的体验,比如个性化降噪等。随着算力的发展,深度学习降噪必将在更多场景落地,给用户带来更好的体验。
参考文献:
[1]. Sixty Years of Frequency-Domain Monaural Speech Enhancement: From Traditional to Deep Learning Methods
[2]. https://mp.weixin.qq.com/s/NhtVlhNHxbUoS1AcFNFtJw
[3]. Speech Enhancement Theory and Practice
[4].https://zhuanlan.zhihu.com/p/1942276940775010700
