
 语音小管家
本期分享杭州电子科技大学和上海交通大学近期被IEEE Transactions on Audio, Speech and Language Processing接收的语音增强方面的工作,论文链接、代码链接见文末。
SelfSE:Self-Supervised Speech Enhancement via Noisy Speech Refinement
【论文作者】江文斌,文飞,俞凯
【论文单位】杭州电子科技大学,上海交通大学
【作者邮箱】wbjiang@hdu.edu.cn; wenfei@sjtu.edu.cn; kai.yu@sjtu.edu.cn
论文亮点
提出一种无需纯净参考语音的SelfSE两阶段自监督语音增强框架,通过迭代优化的训练策略并结合尺度不变多分辨率损失函数,解决了传统基于含噪目标的自监督方法存在的信噪比相关的偏置问题,实现了在模拟数据上性能媲美有监督学习、在真实场景数据上(尤其是低信噪比条件下)显著超越有监督及其他自监督方法的效果,同时在语音增强和后续的语音识别任务中均展现出优异性能。
引 言
语音增强的核心目标是抑制观测语音信号中的背景噪声,提升语音的感知质量与可懂度,是语音识别、语音编码、智能语音助手等系统的关键前端预处理模块。传统基于统计信号处理的语音增强方法已发展数十年,在复杂非平稳噪声环境下性能存在明显局限,近年来基于深度神经网络的数据驱动语音增强方法凭借强大的特征学习与拟合能力成为领域主流,但当前主流深度学习语音增强模型均采用有监督训练模式,需要依赖大量带噪语音与干净语音构成的配对训练数据,模型以带噪语音为输入,以对应的干净语音为监督目标学习降噪映射。
这种有监督训练方式在实际应用中存在显著缺陷,真实场景中噪声分布、房间声学特性、麦克风采集特性与混响模式复杂多变,训练数据集与测试场景的声学不匹配会导致模型泛化性能大幅下降,同时现实环境中难以同步采集到高质量的真实干净语音作为标注标签,严重限制了有监督语音增强方法在实际场景中的部署与应用。
为有监督语音增强方法对纯净参考语音的依赖问题,本文提出SelfSE自监督语音增强框架,该框架无需任何干净语音,通过两阶段迭代优化训练策略与尺度不变多分辨率损失函数,解决现有自监督方法存在的固有偏置与训练稳定性问题,实现模拟数据集性能媲美有监督方法、真实场景数据性能超越有监督方法的效果。
研究背景
在现实应用场景中,语音信号极易受到环境噪声、人声干扰、设备底噪与房间混响等因素干扰,导致语音质量下降,进而影响语音识别准确率、通话清晰度与智能交互系统的使用体验。近年来,基于深度神经网络的语音增强方法凭借优异的降噪效果成为研究与工业应用的主流方案,但这类方法存在难以规避的核心问题,一是高度依赖大规模带噪-干净配对训练数据,模型训练必须以干净语音为监督信号,而真实环境中无法同步采集纯净干净语音,只能通过人工合成方式构建训练数据,合成数据与真实场景数据存在显著分布差异;二是域偏移问题导致模型泛化能力大幅降低,合成数据的噪声类型、混响程度、麦克风特性与真实场景不匹配,模型在低信噪比、复杂噪声等挑战性条件下性能衰减明显;三是真实场景无标注可用,助听器、电话录音、移动户外设备等场景无法获取真实干净语音标签,有监督模型难以直接部署应用。
为解决对纯净语音的依赖问题,学术界陆续提出无监督与自监督语音增强方法,包括Noise2Noise、NyTT、RemixIT、IDR-SE等代表性方案,其中Noise2Noise需要两组由独立噪声污染的带噪语音对,实际应用条件难以满足;NyTT采用更噪语音到带噪语音的训练方式,存在与信噪比相关的固有偏置,低信噪比下噪声保留效应显著;RemixIT基于师生自训练框架,需要预训练教师模型,流程复杂且灵活性不足;IDR-SE采用迭代数据精修思路,有效降低了偏置影响,但存在训练不稳定、低信噪比下迭代收缩特性失效、性能与有监督方法差距较大等问题。现有自监督方法普遍存在假设条件严苛、低信噪比性能差、训练过程不稳定等缺陷,无法在全信噪比区间稳定达到与有监督方法相当的性能水平,因此在完全不使用干净语音标签的前提下,实现稳定鲁棒、低信噪比友好且适配真实场景的自监督语音增强,成为该领域亟待解决的关键科学问题。
研究问题
本文围绕自监督语音增强的核心问题展开研究,具体需要解决的问题包括四个方面。本文提出的SelfSE方法旨在无任何纯净参考语音的条件下,实现媲美甚至超越有监督方法的语音增强效果,同时保证模型在全信噪比区间与真实复杂场景中的鲁棒性。
为了解决有监督语音增强方法无法脱离干净语音标签,真实场景中标注获取困难,模型泛化能力受限,本文提出无需纯净参考语音的自监督学习方案。
为了解决基于含噪目标的自监督学习方法存在固有的信噪比依赖偏置,随着信噪比降低,偏置强度不断增大,降噪能力显著衰减,本文从理论层面解析偏置成因并设计迭代优化机制以弱化偏置影响。
为了解决纯迭代优化类自监督方法训练稳定性不足,易出现误差漂移与模型崩溃问题,在低信噪比场景下失效明显,本文采用混合训练目标策略,引入原始带噪语音作为稳定锚点提升训练鲁棒性。
为了解决传统均方误差损失函数不适配在线加噪的迭代自监督训练模式,存在收敛速度慢、语音音质还原效果差等问题,本文设计融合频域特征、尺度不变信噪比与感知质量的尺度不变多分辨率损失函数,全面提升模型增强性能。
研究方法
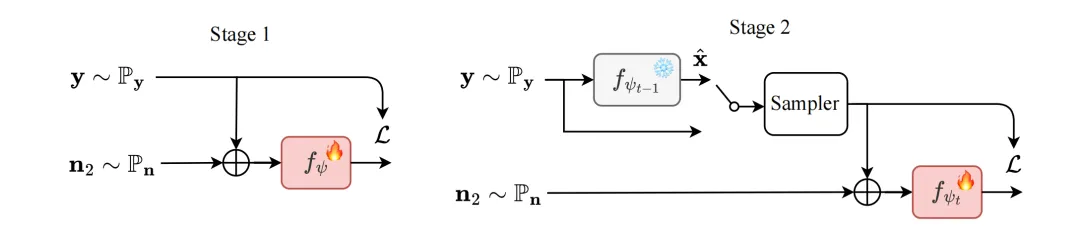
图1 算法总体框架图
本文图1为SelfSE方法整体流程示意图,该图直观展示了SelfSE两阶段迭代训练流程,以带噪语音y作为唯一输入,外部噪声库提供噪声 用于在线构建更嘈杂训练样本,
 为模型输出的增强语音,
 和
 分别代表第t-1轮与第t轮迭代模型,L为复合损失函数,第一阶段以更噪语音为输入、原始带噪语音为目标完成初始训练,第二阶段以估计语音与原始带噪语音按概率混合为训练目标,叠加新噪声构建训练对并迭代优化,清晰体现了不依赖干净语音、以带噪语音自身迭代优化的核心思想。针对迭代自监督训练特性,本文设计尺度不变多分辨率损失函数替代传统均方误差损失,包含多分辨率尺度不变短时傅里叶变换损失、尺度不变信噪比损失与可微分感知质量损失,其中多分辨率尺度不变短时傅里叶变换损失用于捕捉不同频域尺度的语音特征,提升频谱还原度;尺度不变信噪比损失适配在线加噪训练中语音幅度随机变化的问题,加速模型收敛;可微分感知质量损失贴合人耳听觉特性,提升语音主观音质。
网络架构方面采用卷积双路递归网络(CDPRN),如图2所示结构,该网络为编码器-解码器架构,由编码器、双路递归模块、解码器三部分组成,编码器由多层二维卷积、批归一化与激活函数构成,用于提取高维频域与时域特征,中间双路递归模块采用两个长短期记忆网络分别沿频率与时间维度建模序列依赖关系,解码器由多层转置卷积构成并与编码器对称,将高维特征还原为语音掩码输出,同时编码器与解码器之间采用卷积块注意力模块替代普通跳跃连接,强化关键特征传递并抑制噪声信息,该架构参数量约150万,兼顾轻量化与降噪性能。
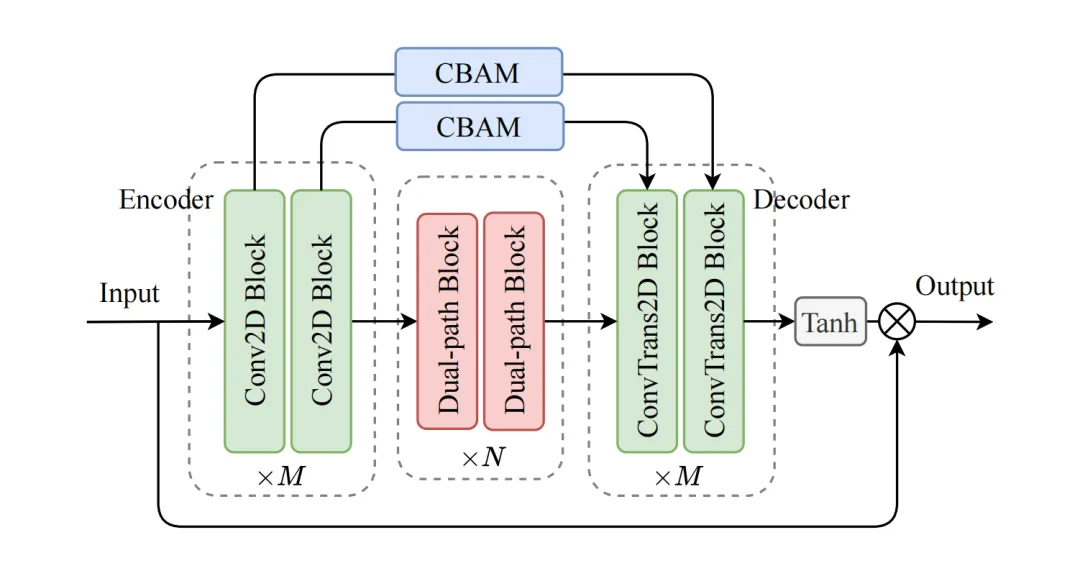
图2 语音增强模型(生成器)网络结构
本文首先从理论层面分析现有自监督语音增强方法的缺陷,进而提出两阶段SelfSE迭代优化框架与专用复合损失函数。在理论分析部分,本文证明NyTT方法存在噪声保留偏置,模型在学习更噪语音到带噪语音映射时,会同时产生降噪与保留原始噪声两种趋势,且偏置强度与信噪比成反比,低信噪比下噪声保留效应占据主导,导致降噪效果大幅下降;同时验证IDR-SE方法具有渐进无偏性,该方法通过上一轮模型输出的估计语音构建估计语音加噪声到估计语音的训练对,迭代过程可逐步降低噪声保留偏置,但在低信噪比下,估计语音与真实干净语音偏差过大,迭代收缩特性失效,性能难以提升。SelfSE框架融合了NyTT的训练稳定性与IDR-SE的迭代优化能力,采用两阶段训练策略,第一阶段为初始模型训练,利用原始带噪语音与噪声库中的噪声构建更噪语音到带噪语音的训练对,训练固定轮数得到初始降噪模型,完成基础降噪能力的初始化;第二阶段为迭代优化训练,以概率 采样上一轮模型输出的估计语音,以概率
 采样原始带噪语音作为训练目标,分别为目标语音添加噪声构建训练对,持续迭代优化模型,当
 时框架退化为NyTT,当
 时退化为IDR-SE,实验确定最优参数
 、初始训练轮数
 ,原始带噪语音作为稳定锚点避免迭代误差漂移,估计语音逐步消除偏置提升降噪效果。
实验结果
本文在VCTK+DEMAND、DNS Challenge 2021、CHiME-4三大主流基准数据集上开展全面实验,覆盖语音增强与语音识别两大任务,对比方法包括传统语音增强方法、有监督深度学习方法与多种主流自监督方法。
表1. 在VCTK + DEMAND数据集上的语音增强对比结果
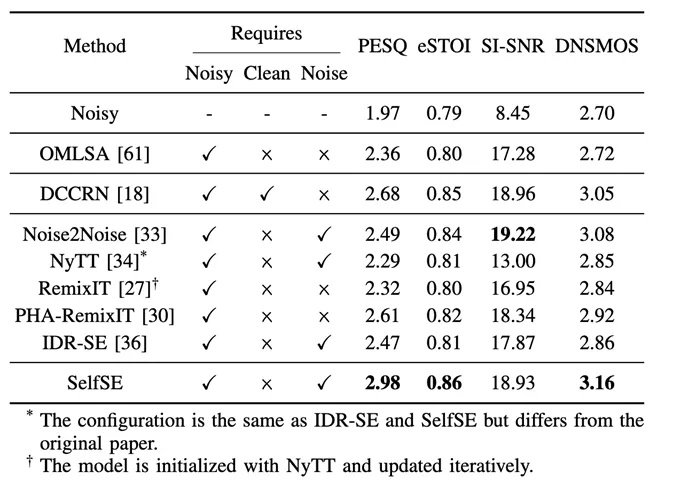
表2. 从VCTK + DEMAND测试集中选取的20个语音的主观MOS结果
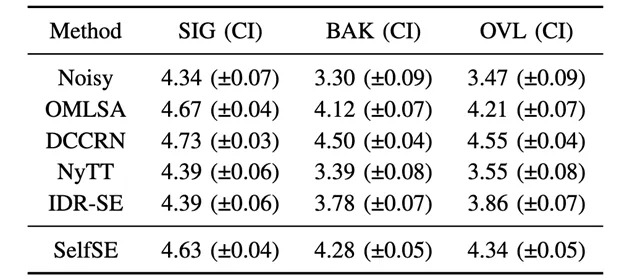
表1表2展示了在VCTK+DEMAND标准仿真数据集上DCCRN[1], Noise2Noise[2], NyTT[3], RemixIT[4], PHA-RemixIT[5], IDR-SE[6]的表现,SelfSE在全信噪比区间均超越NyTT、IDR-SE等自监督方法,低信噪比区间优势尤为显著,客观指标PESQ、eSTOI、SI-SNR、DNSMOS分别达到2.98、0.86、18.93dB、3.16,全面优于所有对比自监督方法,PESQ、eSTOI、DNSMOS指标超越有监督DCCRN方法,主观评测结果显示其SIG、BAK、OVL三项MOS得分接近有监督方法,大幅领先其他自监督方案。
表3. 在DNS Challenge 2021数据集上的实验结果
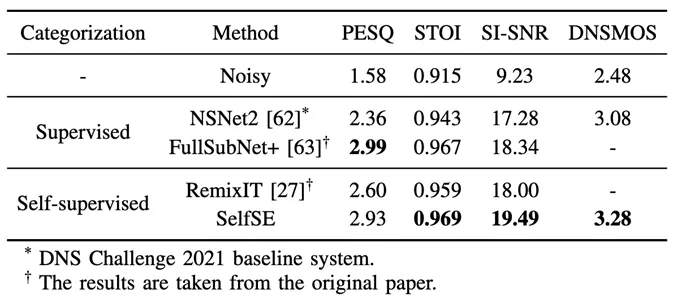
表3的结果显示在DNS Challenge 2021大规模仿真数据集上,SelfSE的各项指标与有监督FullSubNet +方法相当,显著优于自监督RemixIT方法。
表4. DNSMOS (OVL)在CHiME-4数据集上的结果
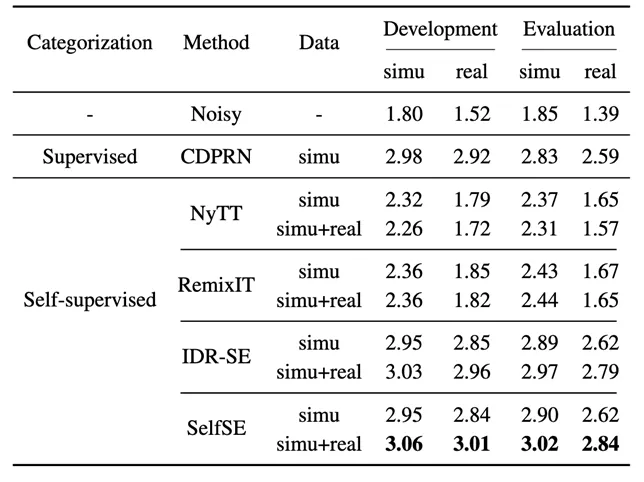
从表4的结果可以看出,在CHiME-4真实场景数据集上,该数据集包含无干净标注的真实环境录音,是检验模型实际泛化能力的核心基准,语音增强DNSMOS指标结果显示,加入真实数据训练后SelfSE超越有监督CDPRN方法,真实场景数据得分达到最优;语音识别词错误率结果表明,SelfSE作为语音识别前端预处理模块,在真实场景数据上的词错误率最低,有效缓解了有监督方法在真实场景下的性能衰退问题。
结 论
本文提出的SelfSE是一种无需纯净参考语音的自监督语音增强方法,通过两阶段迭代优化框架与尺度不变多分辨率损失函数,有效解决了传统含噪目标自监督方法存在的信噪比相关固有偏置与迭代训练不稳定问题。实验结果表明,SelfSE在模拟数据集上的性能与有监督方法相当,在真实场景数据集上显著超越有监督方法与其他自监督方法,同时在低信噪比条件下具备强鲁棒性,作为语音识别前端可有效降低真实场景词错误率,具备极高的实际应用价值。未来研究将聚焦于减少方法对外部噪声库的依赖,尝试直接从带噪语音中建模噪声分布,以提升模型在复杂真实场景下的鲁棒性。
【论文链接】:https://ieeexplore.ieee.org/document/11477113
【代码链接】:https://github.com/jiang-wenbin/SelfSE/tree/main/src
【Demo链接】:https://jiang-wenbin.github.io/SelfSE
【参考文献】:
[1]. Y. Hu, Y. Liu, S. Lv et al., “DCCRN: Deep complex convolution recurrent network for phase-aware speech enhancement,” in Proc. ISCA Interspeech, 2020, pp. 2472–2476.
[2]. M. M. Kashyap, A. Tambwekar, K. Manohara, and S. Natarajan, “Speech denoising without clean training data: A noise2noise approach,” in Proc. ISCA Interspeech, 2021, pp. 2716–2720.
[3]. T. Fujimura, Y. Koizumi, K. Yatabe, and R. Miyazaki, “Noisy-Target Training: A training strategy for dnn-based speech enhancement without clean speech,” in Proc. EUSIPCO, Aug. 2021, pp. 436–440.
[4]. E. Tzinis, Y. Adi, V. K. Ithapu, B. Xu, and A. Kumar, “Continual selftraining with bootstrapped remixing for speech enhancement,” in Proc. IEEE ICASSP, 2022, pp. 6947–6951.
[5]. Y. Liao, Y. Koizumi, D. Takeuchi et al., “Leveraging out-of-domain noise for unsupervised domain adaptation in speech enhancement,” in Proc. IEEE ICASSP, 2025, pp. 1–5.
[6]. Y. Zhang, W. Jiang, Q. Zhuo, and K. Yu, “Iterative noisy-target approach: Speech enhancement without clean speech,” in National Conference on Man-Machine Speech Communication 2023. Springer, 2024, pp. 256–264.
初审:吴锡欣,复审:朱璇,终审:凌震华
