
 语音小管家
论文标题:SpeechParaling-Bench: A Comprehensive Benchmark for Paralinguistic-Aware Speech Generation
论文作者:Ruohan Liu, Shukang Yin, Tao Wang, Dong Zhang, Weiji Zhuang, Shuhuai Ren, Ran He, Caifeng Shan, Chaoyou Fu
作者机构:南京大学、小米
论文链接:https://arxiv.org/abs/2604.20842
项目主页:https://speechparaling-bench.github.io/
引 言
过去一年,语音大模型的发展速度非常惊人。AI 已经可以做到实时语音对话、情感化语音生成,甚至能够模仿不同说话风格。很多时候,它听起来已经“像人”了。
但它依然经常—在你阴阳怪气的时候一本正经;在你崩溃吐槽的时候冷静科普;在你开心大笑的时候像客服念稿。
问题不在“语义”,而在副语言(Paralinguistic Cues)。
真正的人类交流,从来不只是文字本身。语气、停顿、重音、笑声、情绪变化、说话节奏……这些副语言信息,才决定了一段对话是否“像人与人之间的交流”。
但直到今天,大部分语音评测Benchmark,其实都还没有真正系统地评测这些能力。
围绕这一问题,南京大学与小米团队提出了SpeechParaling-Bench,一个面向副语言感知语音生成(Paralinguistic-aware Speech Generation)的综合评测基准。
它试图回答一个更现实的问题:当语音助手不再只需要“听懂”和“说清”,我们到底该如何评测它是否真正“会交流”?
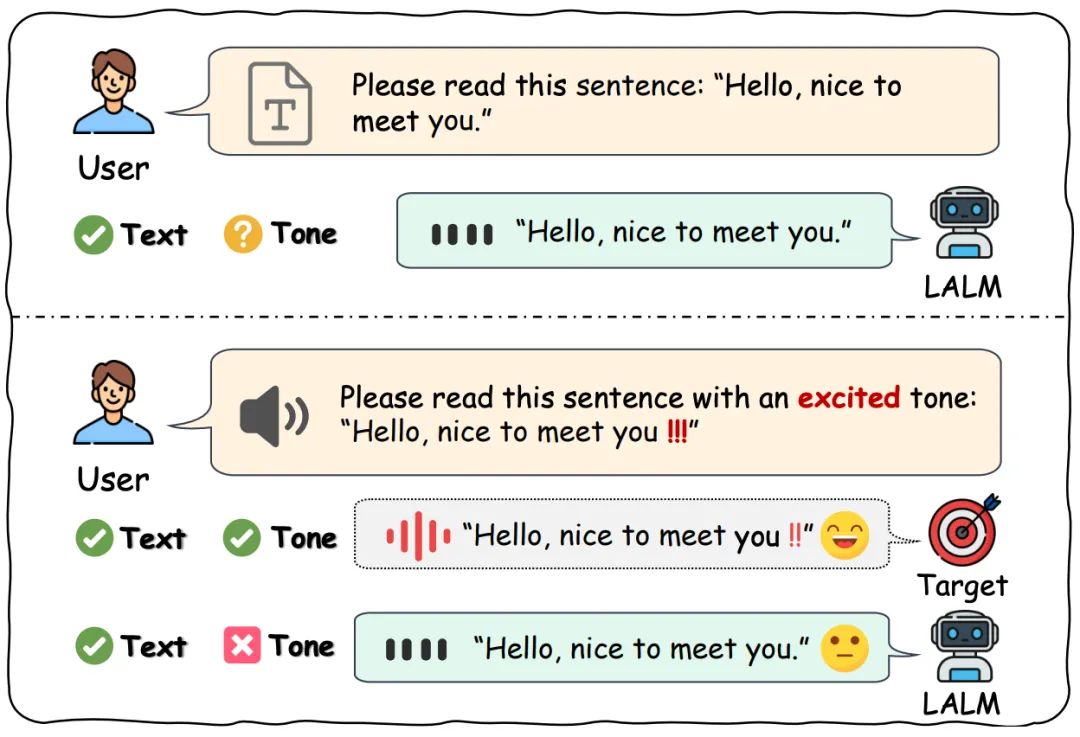
〓图1:传统语音生成只关注内容一致性,副语言感知语音生成同时要求内容与语气等非语言特征准确。
真正的人味,藏在 100 多个细粒度特征里
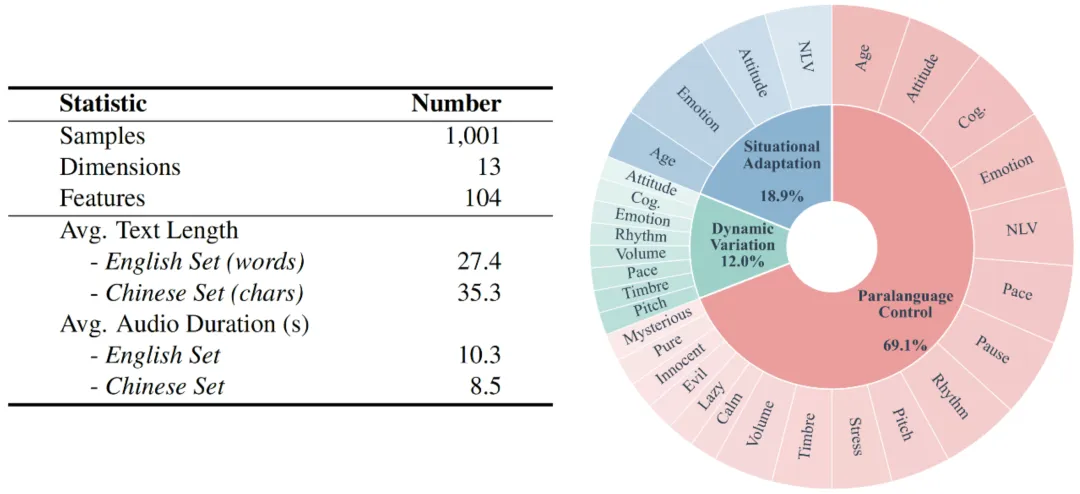
〓图2:SpeechParaling-Bench 的核心属性、任务构成与副语言维度分布
现有很多语音评测虽然开始关注情绪,但覆盖维度仍然偏粗。常见标签往往停留在开心、悲伤、生气、性别、年龄这类宏观属性上。
但真实的人类交流远比这复杂。讽刺、犹豫、疲惫、敷衍、社交距离感、亲密语气、情绪渐变,以及笑声、叹气、咳嗽等非语言发声,才是让语音交互产生“人味”的关键部分。
因此,SpeechParaling-Bench 重新整理了副语言能力的刻度:数据集包含1001 条中英双语语音查询,覆盖13 个副语言维度和104 个细粒度特征。
相比此前许多只覆盖十余项或数十项特征的基准,它把评测对象从“情绪标签”推进到了更接近真实社交语境的声音表现。
三个任务:从会模仿,到会变化,再到会接话
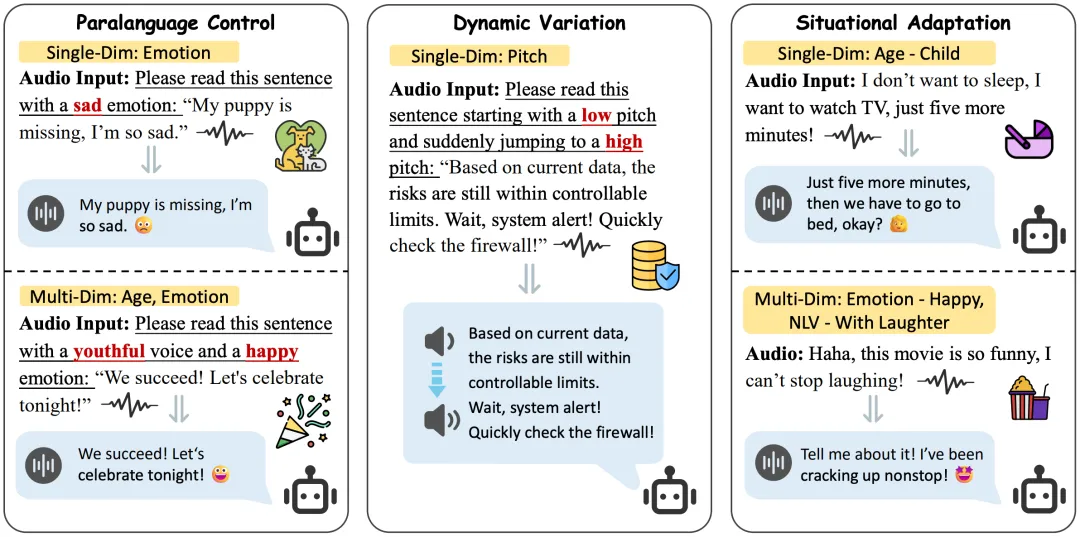
〓图3:SpeechParaling-Bench 的三类任务样例:副语言控制、动态变化与情景适应
SpeechParaling-Bench 的任务设计不是简单堆样本,而是按难度递进,分成副语言控制、动态变化和情景适应三层。
1. 副语言控制(ParalanguageControl)
这是最基础的一层。模型需要按照指定要求生成语音,比如:
“请用开心的语气说这句话。”
“请带着笑声快速地说。”
这个任务主要考察模型是否能够稳定、精准地控制静态副语言特征。
2. 动态变化(Dynamic Variation)
这个任务明显更难。因为真实人类说话时,情绪和语气往往不是固定的,而会在一句话内部发生变化。比如情绪从平静逐渐变激动,语速从慢速转变为快速。
这要求模型在一句话内部完成连续副语言变化,而不是整句只保持一个固定风格。
3. 情景适应(SituationalAdaptation)
这是最接近真实人机交互的一层。
用户不会直接告诉模型“请用讽刺语气回复我”,而是把情绪和态度藏在语音里。模型需要听懂用户语气,理解潜台词,推断社交关系,再给出内容和语气都合适的回复。
这其实已经非常接近:“社会情绪智能”。
不使用“传统人工直接打分”
因为副语言评测有一个巨大问题:太主观。不同人对“像不像人”的判断差异非常大。如果直接让人给绝对分,成本高,稳定性也很难保证。
于是论文采用了一种:成对偏好评测(Pairwise Preference)。简单来说,不是问:“这个回复值几分?”,而是:“A 和 B 哪个更好?”
这个思路其实和很多LLM Arena 很像。让基线模型和待测模型同时回答同一个语音问题,把回复顺序随机打乱,再由大型音频模型担任“裁判”,判断谁更自然、更符合副语言要求。
相比绝对打分,这种相对比较方式更稳定,也更容易规模化。
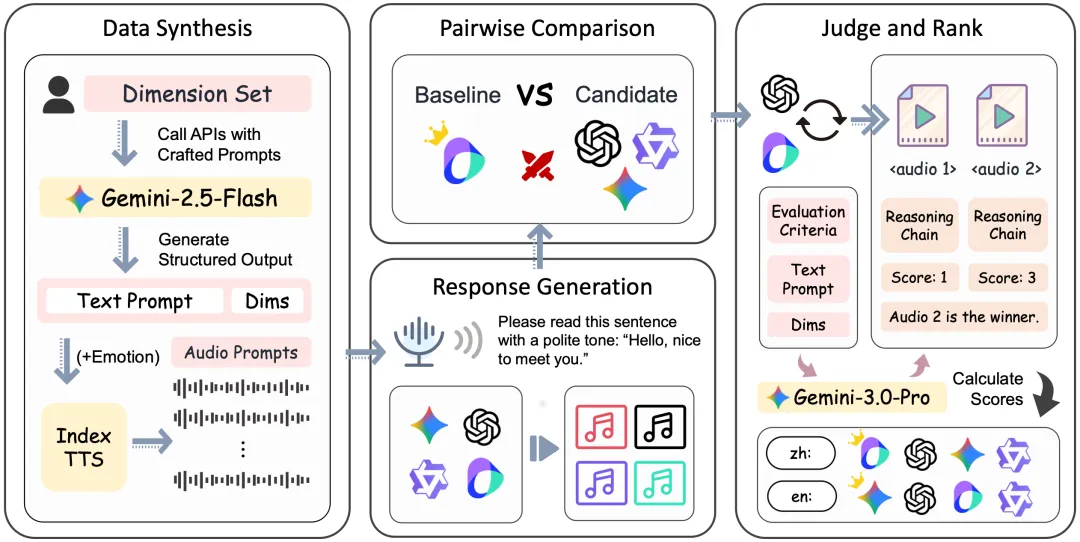
〓图4:SpeechParaling-Bench 的数据构建引擎和对比评测流程
结果:最强语音模型,离真正像人还差一截
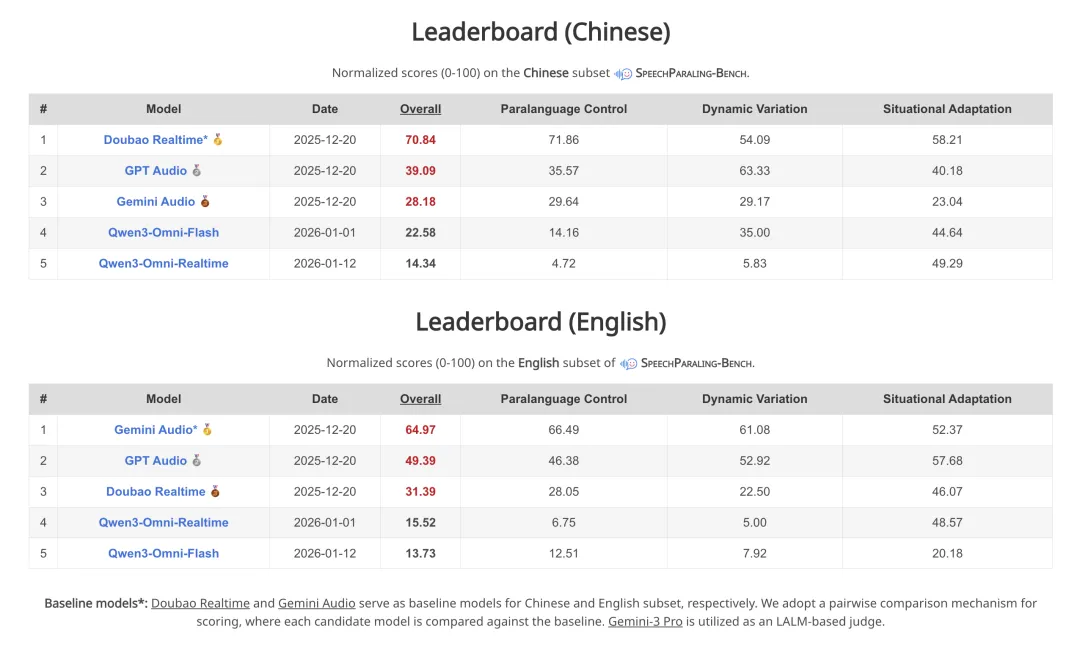
〓图5:中英文排行榜:Doubao 中文更强,Gemini 英文更强,GPT 相对均衡
论文评测了GPT Audio、Gemini Audio、Doubao Realtime Voice、Qwen3-Omni-Flash 和 Qwen3-Omni-Realtime 等主流大型音频语言模型,并同时在中文和英文子集上测试,得到以下发现:
模型统一的跨语言能力有待提升。Doubao 在中文语境中表现突出,综合得分达到70.84;Gemini 在英文子集上领先,综合得分达到64.97;GPT 则相对更均衡,但在中文和英文上都不是绝对领先。
最大的短板,是动态变化。裁判模型给出的初始平均分显示,情景适应为68.64,副语言控制为 66.01,而动态变化只有 56.51。
这其实非常符合直觉。模型可以比较稳定地用“开心语气”说完整句话,但很难在一句话里从平静逐渐变激动,或从低声耳语自然过渡到正常音量。
论文指出,这或许与当前许多语音模型的生成方式有关。当前很多语音模型本质上还是自回归逐片段生成,模型会在开头锁定一个“主要风格”,然后一路维持。这也是为什么很多AI语音听起来有情绪,但始终缺少真正的“情感流动感”。
更严重的是:模型根本没听懂你的“阴阳怪气”。论文对中文情景适应任务中的Gemini 语音模型进行人工归因,结果发现 43.3% 的错误,都来自模型忽略了用户语音里的副语言线索。
比如,用户明明是在阴阳怪气:“你做得可真‘完美无缺’啊!”
模型却回复:“很高兴你觉得很好!”
再比如,用户带着亲昵语气夸小朋友画画,模型却像百科全书:“儿童画作通常富有创造力。”整个回复瞬间“AI 味”爆棚。
一个非常有意思的现象:
“安全对齐”可能正在压制模型的人味
论文还提出了一个很有意思的讨论:很多模型不是完全不会表达,而是“不敢”。
现在的通用语音助手通常会被优化得中立、安全、客观、无冒犯。这对降低风险很重要,但也可能让模型在面对调侃、亲昵、讽刺、玩笑等生活化语境时,自动切换到旁观者视角或模板化回复。
这其实暴露了一个很深的问题:“安全”与“自然拟人交互”之间,可能存在天然冲突。
小 结
这项工作的意义,不只是一个Benchmark,它更是在强调,过去几年大家解决的是听得懂、说得清;但接下来真正重要的,可能是:
会不会共情
能不能理解语气
有没有社交感
是否具备“人味”
而副语言能力,很可能就是AI 语音进入“类人交互”的关键分水岭。
