
 语音小管家
空间音频生成要求模型同时处理声源语义、时间同步和三维方位关系。现有方法通常在生成质量、推理延迟和空间条件建模之间存在取舍:非流式扩散模型依赖较长上下文,难以用于实时场景;通用视频编码器主要关注语义内容,对全景视频中的朝向、运动轨迹和声源位置不够敏感。
来自浙江大学的学者提出SwanSphere,一个统一支持全景视频条件和文本条件的流式空间音频生成框架。模型采用因果自回归扩散 Transformer。结果显示 SwanSphere 在空间精度、语义一致性、音质和流式延迟上都有稳定收益。
论文题目:Towards Streaming Synchronized Spatial Audio Generation via Autoregressive Diffusion Transformer
论文链接:https://arxiv.org/abs/2605.30940
Demo:https://swanaigc.github.io/#swansphere
空间音频生成的目标是在视觉、文本或其他条件下生成包含方向、距离和场景结构的音频。对VR/AR、全景视频、游戏和沉浸式影视内容而言,核心问题不是单纯生成“合适的声音”,而是让声音的出现时间、声源方位和运动轨迹与画面保持一致。
现有方法主要有四个限制:
1.生成质量与延迟的取舍:非流式扩散模型可以利用完整上下文提升音质,但first-frame latency 较高,不适合在线生成。
2.空间表征不足:通用视频编码器偏向语义分类与全局匹配,对全景视频的方位结构、视角旋转和声源运动不够敏感。
3.多模态对齐复杂:视频、文本和FOA 音频之间需要同时满足语义、时间和方向对齐,简单条件注入容易产生声画错位或空间漂移。
4.空间标注不足:高质量FOA 视频-音频数据有限,带有细粒度方位和距离描述的 caption 更少,限制了 text-to-spatial audio 训练。
SwanSphere 的设计目标是同时满足三点:保持扩散模型的连续空间声场质量;用因果自回归结构支持流式推理;通过专门的空间对齐训练增强全景视频条件建模。
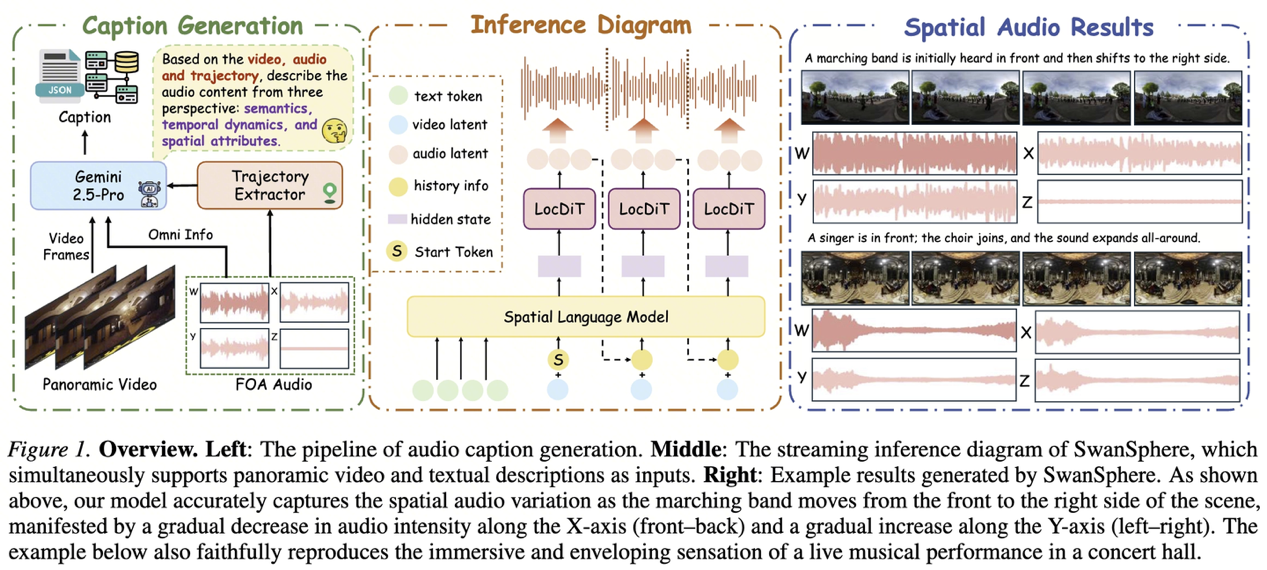
图1:Caption 数据生产流程、流式推理路径与生成结果示例
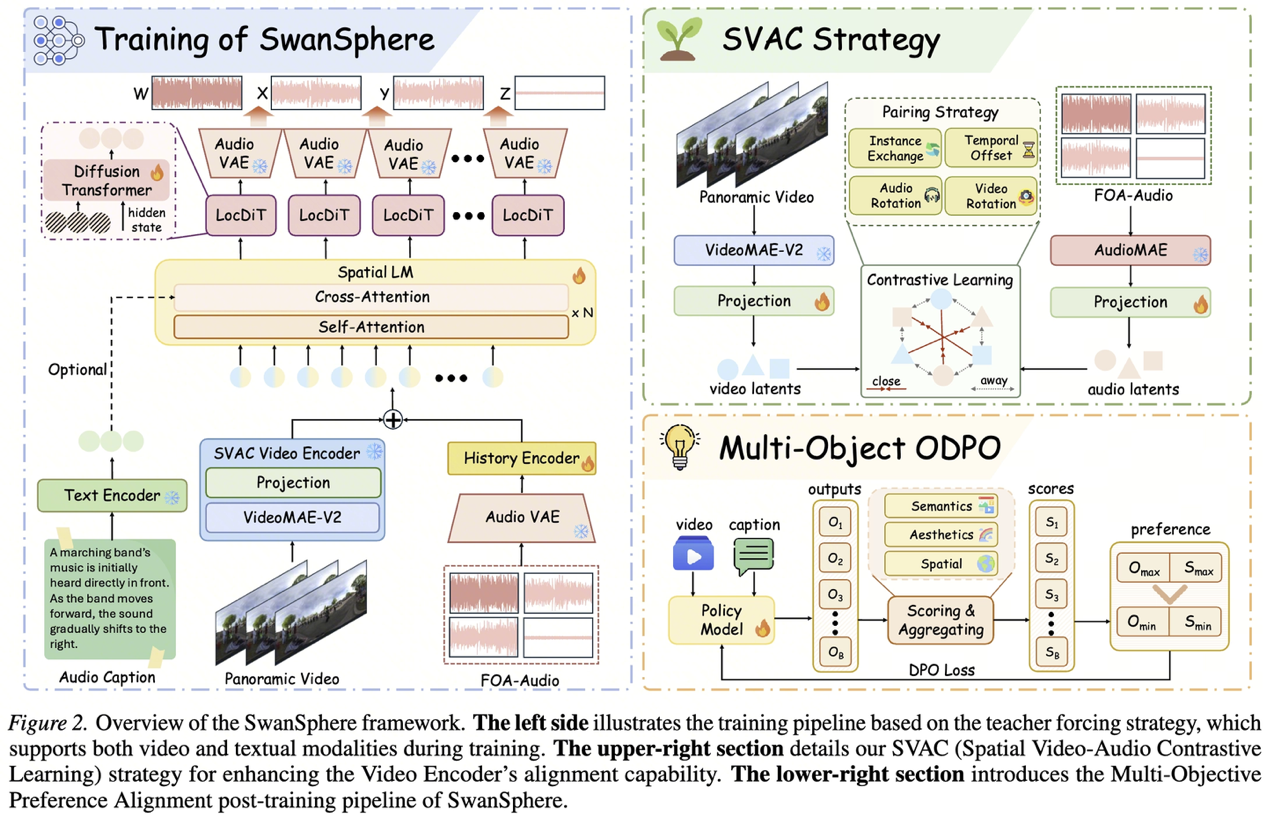
图2:SwanSphere 方法概览
⏩方法主线
SwanSphere 将生成过程拆成跨块规划和块内生成两级。Spatial LM 在因果约束下聚合历史音频块与当前条件,输出当前块的条件表示;LocDiT 在该条件下用 flow matching 生成连续 FOA latent。这样的分工保留了扩散模型的局部音质,同时避免全局扩散等待完整序列。
⏩FOA表示与连续潜空间
模型输出First-Order Ambisonics(FOA),而不是普通 stereo。FOA 包含 W/X/Y/Z 四个通道:W 表示全向声压,X/Y/Z 表示三轴方向分量。该表示直接携带声场方向信息,因此生成、对齐和评估都围绕 FOA latent 展开,避免了先生成 mono 再外接 spatializer 的信息瓶颈。
论文将Stable Audio VAE 扩展为四通道 FOA-VAE,把音频编码为连续 latent,帧率约 21.5 FPS,每帧维度 d=128。作者没有使用 DAC 一类离散 codebook,主要原因是空间音频对跨通道相位关系敏感;离散量化可能引入相位误差,从而影响定位稳定性。
⏩SVAC:把视频编码器推向声学空间
通用CLIP 类视频特征主要优化语义匹配,global pooling 还会削弱全景视频中的方位结构。SwanSphere 使用 VideoMAE-V2 编码 panoramic video,用 AudioMAE 编码 FOA audio,并通过投影层对齐到共享 video-audio 空间。由于视频帧率低于音频 latent 序列,作者采用 nearest-neighbor replication 将每个 audio timestep 对齐到最近的视频帧,避免插值破坏几何结构。
SVAC 的重点在 hard negative 设计。正样本是同一片段的视频和 FOA;负样本包括 batch 内其他样本、同一音频的 circular shift、旋转后的 FOA,以及水平旋转后的 panoramic video。训练目标采用对称 InfoNCE,同时约束 video-to-audio 和 audio-to-video。这个设计让视频特征不仅区分语义,还对声音出现时间、声场方向和画面旋转更敏感。
⏩自回归扩散生成:Spatial LM + LocDiT
核心结构是“跨块自回归 + 块内扩散”。Spatial LM 只使用历史和当前条件,预测当前块的条件表示 h_t;LocDiT 以 h_t 为条件,通过 flow matching 从高斯噪声恢复当前块的 FOA latent。
视频条件下,SVAC video encoder 输出空间感知特征 C_v。History encoder 将前一音频块压成历史表示,再与对齐后的视频 token 一起输入 Spatial LM,使当前块同时接收画面条件和已生成上下文。文本条件下,FLAN-T5 提取 caption embedding,并通过 cross-attention 注入 Spatial LM;缺失模态由 learnable null embedding 表示,因此 video-to-spatial audio 和 text-to-spatial audio 可以共享模型。生成停止条件直接跟随视频特征序列,减少模型自行预测结束带来的不稳定。
LocDiT 只负责局部块内生成,因此可以使用 bidirectional attention 修复细节,同时不破坏整体流式因果性。为降低块间断裂,LocDiT 额外接收前两个块作为 boundary context。整体思路是:LM 处理长程结构与流式状态,diffusion/flow 处理局部音质和连续空间声场。
⏩多目标ODPO微调
ODPO 用于后训练偏好校准。每个 video/text 条件并行采样 8 个候选音频,随后根据加权 reward 排序,构造 y_w/y_l 偏好对并执行 DPO 更新。
Reward 包含三项:空间项评估 azimuth、elevation 和 angular error;语义项用 ImageBind 计算 audio 与 video/text embedding 相似度;音质项用 Audiobox Aesthetics 比较生成音频与真实音频的感知特征距离。权重设置为 spatial=0.4、semantic=0.4、fidelity=0.2。这里采用 DPO 而不是在线 RL,优势是训练过程更简单,且候选排序天然提供偏好监督。
⏩空间Caption与训练数据
数据侧包含约165k 个 video-FOA pairs,总计 458h。所有片段被统一到 10 秒,视频降采样到 4 fps,FOA 音频重采样到 44.1 kHz。作者还引入约 1M 条非空间音频做 curriculum learning:将 stereo 转为 pseudo-FOA,W 通道使用左右声道和,X/Y/Z 中随机一个通道使用左右差分,其余置零,使 LocDiT 先学习通用音频生成,再迁移到真实 FOA。
自动caption 流程先做 DSP 空间解析,而不是直接让 MLLM 从视频中猜测空间关系。具体做法是:对 W/X/Y/Z 做 STFT,取 500Hz-8000Hz 频段,用 W 与 X/Y/Z 的 cross-power 估计 acoustic intensity vector;再按 1 秒粒度计算 azimuth/elevation,将角度轨迹转成单位向量后用窗口 3 的 moving average 平滑;距离感结合 inverse-square law 和 diffuseness 估计。最后将结构化轨迹、全景视频和 downmixed audio 输入 Gemini 2.5 Pro,生成包含语义、时间顺序和空间运动的 caption。最终得到约 3,100 条有效 spatial caption,其中 300 条用于评估。
论文从两类任务验证SwanSphere:
1.Video-to-spatial audio:根据全景视频生成空间音频,重点考察声画同步、空间定位和音质。
2.Text-to-spatial audio:根据文本prompt 生成空间音频,重点考察语义可控性和空间描述遵循能力。
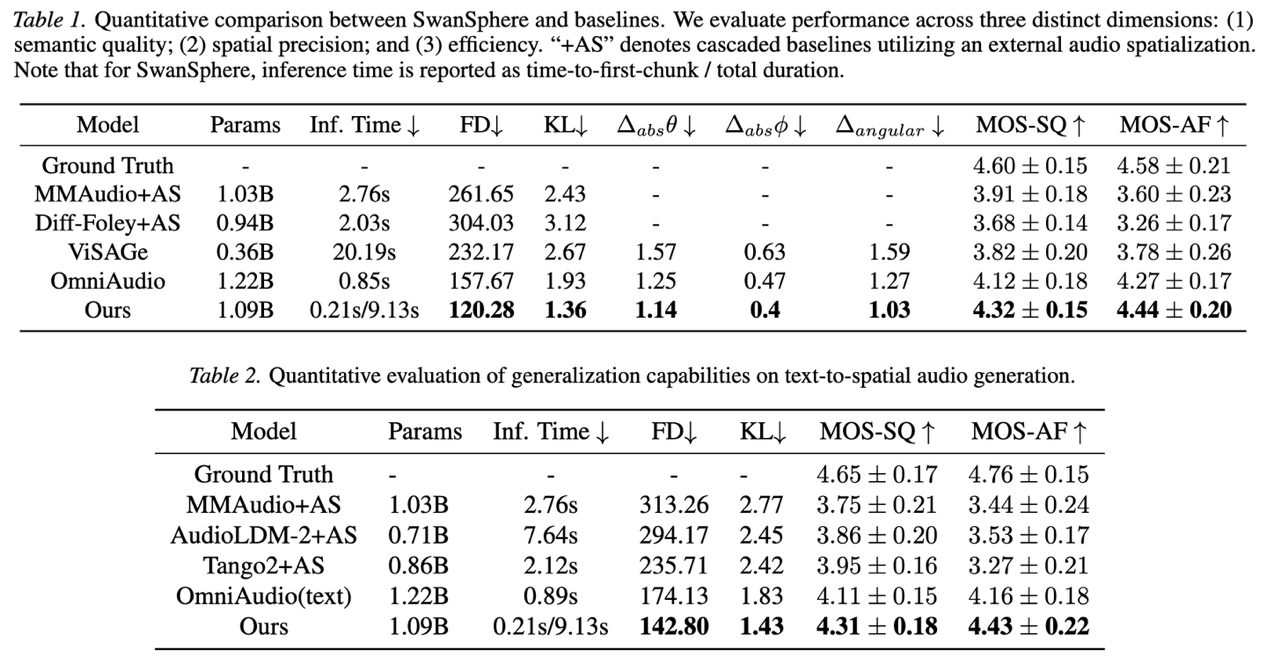
表1/2:两个任务的评测结果
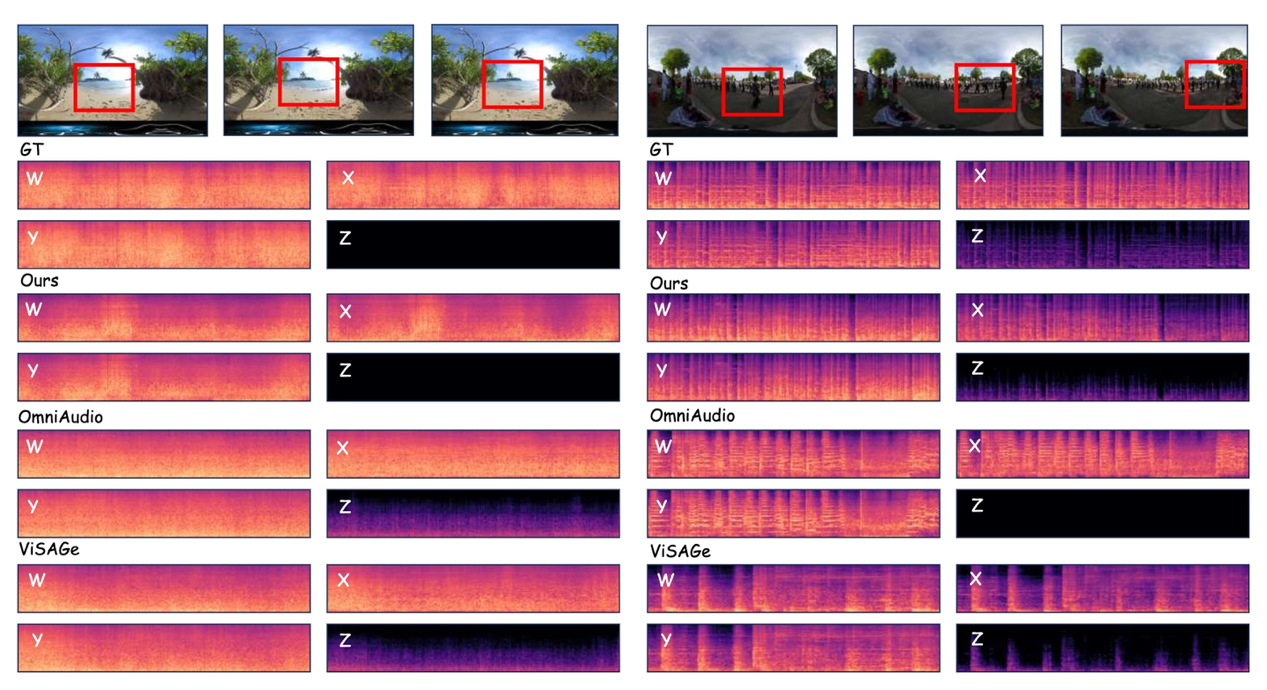
图3:定性比较,左列描绘了正前方的海浪;我们的模型生成了清晰且有节奏的海浪声。右列展示了一个行进乐队从前方朝右侧移动,X通道的信号强度逐渐减弱,而Y通道的强度相应增加。
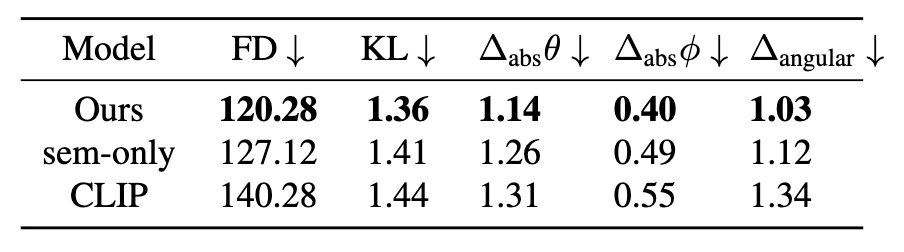
表3:空间视音频对比学习的消融实验
实验结果显示,SwanSphere相比级联式和统一式基线,在语义保真、空间精度、感知质量和推理效率上取得更高综合表现。消融实验进一步说明,SVAC对空间感知表征贡献明显,ODPO有助于减少伪影并提升偏好一致性,因果自回归扩散结构则是实现低first-frame latency的关键。
从技术路线看,SwanSphere 把流式推理、空间视频-音频对齐和文本条件空间音频生成放在同一个框架内处理。它用因果自回归结构控制在线生成延迟,用 SVAC 强化全景视频的空间声学表征,再通过自动空间 caption 扩展 text-to-spatial audio 的训练与评估覆盖。该框架适用于全景视频、VR/AR、游戏和沉浸式内容生成等需要声画空间同步的场景。局限主要在复杂多声源场景。当前 caption 更偏向描述主导声源;在音乐会、群体对话、复杂街景等场景中,声源分离、轨迹建模和多对象空间解耦仍不充分。后续可以继续加强多声源空间建模、长时间一致性,以及面向 binaural rendering 或个性化 HRTF 的下游适配。
