
 语音小管家
近年来,音频大语言模型(Audio Language Models, ALMs)的出现极大地推动了自然语音对话交互的发展[1][2]。然而,在面对真实场景中强烈的情感陪伴需求时,现有的 ALMs 依然面临深层情感交互的瓶颈。具体而言,模型普遍存在“文本语义主导(Semantic Dominance)”偏见,导致其在声学特征与字面语义冲突时产生模态鸿沟;同时,由于缺乏“认知深度(Cognitive Depth)”,模型往往只能生成机械、通用的安全共情模板。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)题为“Beyond Semantic Dominance: Cognitive Affective Reasoning and Empathetic Response Alignment in Audio Language Models”的论文被语音旗舰会议Interspeech 2026接收。该论文提出了CogAudio-LLM,这是一个面向语音交互的认知情感推理框架。该研究的核心贡献包括:构建了用于声学-语义解耦的大规模数据集LIME-440K,提出了包含四阶段心理学推理的思维链机制EIPS,并设计了“显式指导与隐式内化”的多阶段训练范式及双路线强化学习算法DR-SAPO,在细粒度情感识别和共情对齐质量上显著超越了现有基线模型。
论文题目:Beyond Semantic Dominance: Cognitive Affective Reasoning and Empathetic Response Alignment in Audio Language Models
作者列表:赵致闲、王水源、田文杰,胡景斌,张子萸,谢磊
论文预印版:https://arxiv.org/abs/2606.06940
开源代码与数据集:https://github.com/zxzhao0/CogAudio-LLM
研究背景与动机
实现真正的共情,要求模型不仅能够精准感知细粒度的副语言线索,还必须给出恰当的共情对齐回复。当前 ALMs 在此任务上面临两大核心阻碍:
文本语义主导(Semantic Dominance):绝大多数 ALMs 建立在原生文本大模型基础之上。由于文本预训练数据量级巨大,模型的隐表示空间先天偏向于离散的文本语义。在多模态处理时,文本表示往往会掩盖声学细节。当声学线索与字面文本矛盾时(如反讽或强颜欢笑场景),模型会过度依赖文本,从而误判用户的真实情感状态[3](如图 1 所示)。
认知深度不足(Lack of Cognitive Depth):即使模型正确识别了情感,标准 ALMs 也倾向于生成脱离语境的通用回复。尽管近期有研究尝试将思维链(CoT)引入 ALMs 以提示模型在预测情感前先描述音高、语速等声学特征[4],但这种“声学描述性推理”依然难以在复杂交互中可靠地推断用户潜在的意图与真实心理状态。
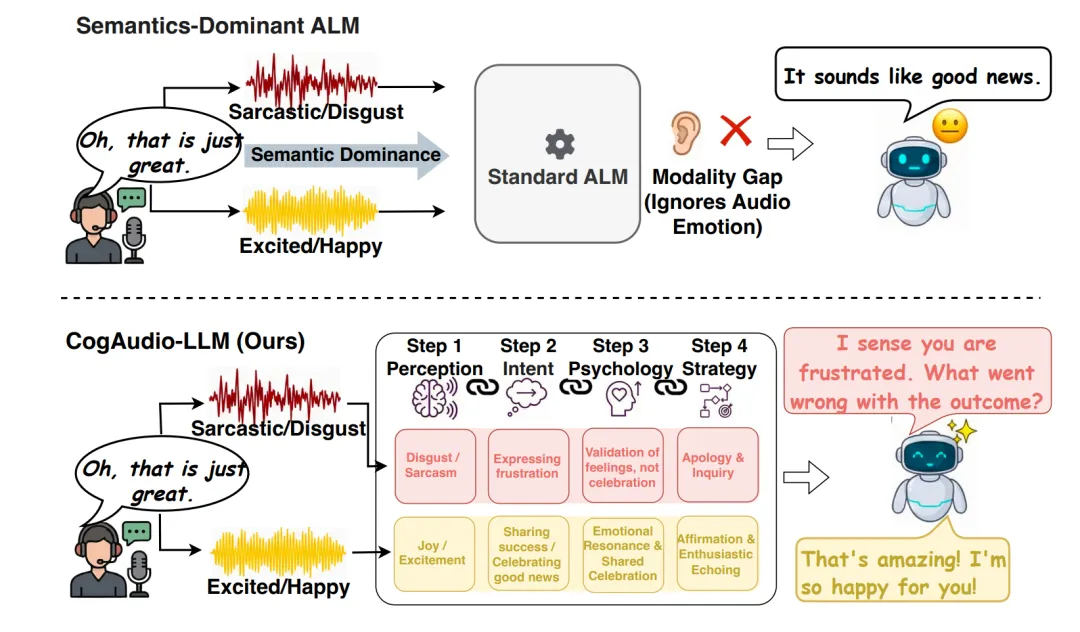
图1 基线ALM与所提 CogAudio-LLM 在语义-声学冲突场景下的表现对比。
传统 ALM 受文本语义主导产生模态鸿沟并忽略音频情感 ;CogAudio-LLM 通过 4 阶段 EIPS 认知框架确保精准的共情对齐 。
CogAudio-LLM框架
为了平衡细致的情感推理与流畅的对话交互,CogAudio-LLM 从数据解耦、心理学思维链到多阶段对齐训练进行了系统性设计:
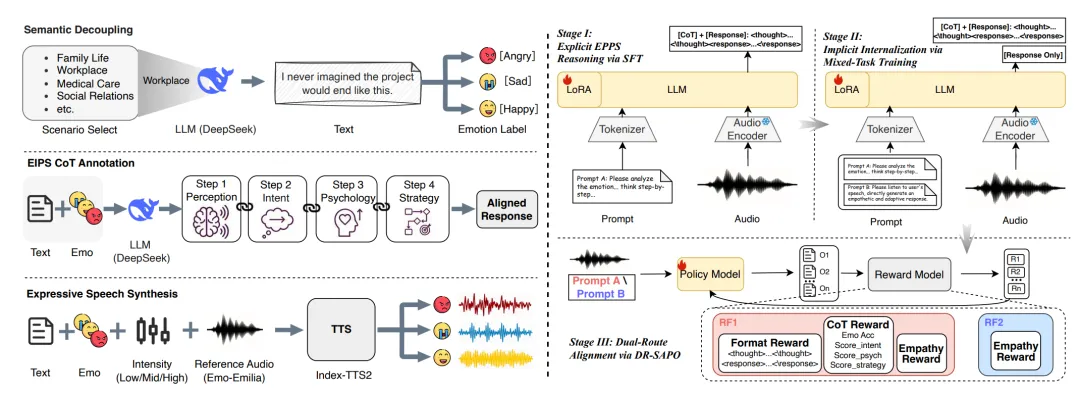
图2 CogAudio-LLM 的数据生成与模型训练pipline
语义-声学解耦数据集 LIME-440K
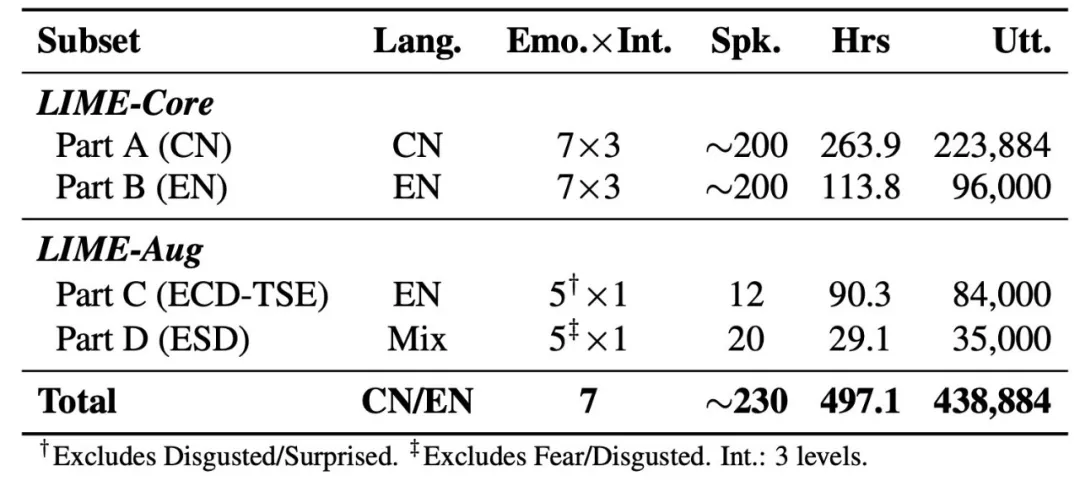
该论文构建并开源了大型双语数据集 LIME-440K(总计约 44 万句,时长约 497.1 小时,数据集统计信息如表1所示)。该数据集的核心在于其语义-声学解耦策略:
论文预定义了 20 个核心交互场景,利用 DeepSeek-V3 模型[5]生成具备高度语义歧义性的文本,强制要求同一段文本必须适应至少三种截然不同的情感标签(如“我从未想过项目会这样结束”需同时适配[开心]、[悲伤]和[愤怒]的语境)。该设计阻断了“文本->情感”的捷径,迫使模型严格通过副语言线索进行消歧。
以数据集中一句极其日常的文本为例(文本:“这盘青椒肉丝是我做的”):
在合成阶段,采用 Index-TTS2 模型,为了弥合合成语音与真实场景之间的声学鸿沟、打破单一音色的局限,该工作特别引入了包含真实环境噪声的大规模开源数据集 Emo-Emilia [4] 作为参考音频(Reference Audio)。通过这种方式,LIME-440K 成功覆盖了约 230 名不同的发音人,极大保证了说话人和声学环境的多样性。同时,该工作还将“情感强度(低/中/高)”作为独立的控制变量引入,以捕获同类情感下的声学方差,彻底避免了模型形成单一的声学映射。 数据集的详细统计信息如表 1 所示。

心理学认知思维链 EIPS
借助 DeepSeek-R1 [6]蒸馏出了一套结构化的心理学推理路径,即EIPS 四步思维链:
情绪感知(Emotion Perception):解析显式/隐式情感元素,评估情感强度,定位触发点。
意图提取(Intent Extraction):剥离表层话语,挖掘用户未被满足的深层心理需求。
心理建模(Psychological Modeling):预判交谈者的认知偏差与防御机制,规划情感落脚点。
策略制定(Strategy Formulation):设计符合情感发展规律的对话路径及适应文化语境的回复方案。
三阶段“隐式内化”训练与 DR-SAPO 对齐
CogAudio-LLM 以 Qwen2.5-omni [7]为基础模型,设计了三阶段训练架构:
阶段一(显式推理 SFT):利用包含完整 EIPS 标注的数据,训练模型在输出最终回复前,自回归地生成完整的 4 步思维链。
阶段二(隐式内化混合训练):在日常对话中要求模型每次都输出思维链违背了人类直觉。因此,该阶段将显式推理数据与纯回复数据按 1:1 比例混合训练,促使模型在执行纯回复任务时,能够隐式地激活阶段一中学到的 EIPS 认知回路。
阶段三(DR-SAPO 双路线强化学习):引入软自适应策略优化(SAPO)算法以稳定长序列 CoT 的训练,并提出DR-SAPO机制。当触发显式推理路径时,系统综合奖励其格式规范、思维链逻辑(感知/意图/心理/策略得分)及最终回复的共情度;当触发直接回复路径时,仅对回复的共情度进行奖励优化。
实验结果与分析
共情质量评估
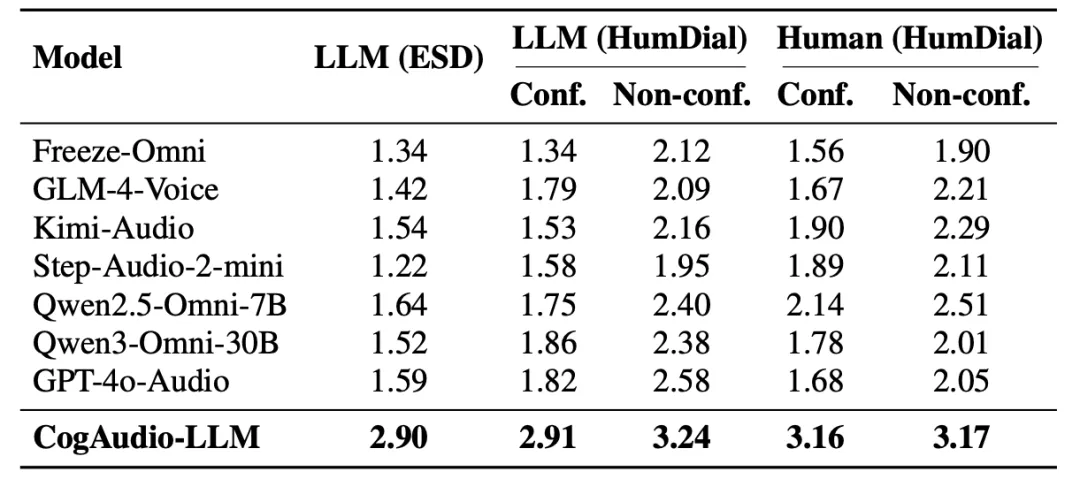
如表 2 所示,在隐式直接回复模式下,无论是大模型评委(LLM)还是人类专家评估(Human),CogAudio-LLM 在各项基准测试上均显著超越了当前主流的开源与闭源音频大模型。特别是在字面文本与声学情绪相悖的“冲突(Conf.)”场景下,现有模型共情得分普遍跌至 2.0 以下,而 CogAudio-LLM 依然能保持高水平的共情对齐。
表2 不同模型在各测试集上的共情质量主客观评分对比(1-4分制)。
消融实验
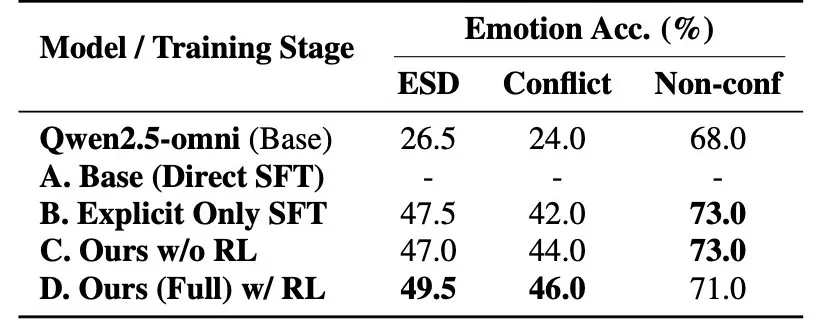
针对不同训练阶段对模型表现的提升进行了消融分析。如表 3 所示,基础模型在冲突集上的情感识别准确率(Emotion Acc.)仅为 24.0%。在引入声学-语义解耦数据集 LIME-440K 进行显式微调后,准确率大幅提升至 46.0%,有力证明了该范式成功打破了传统的文本语义依赖捷径。
表3 情感感知准确率(Emotion Accuracy, %)消融实验结果。
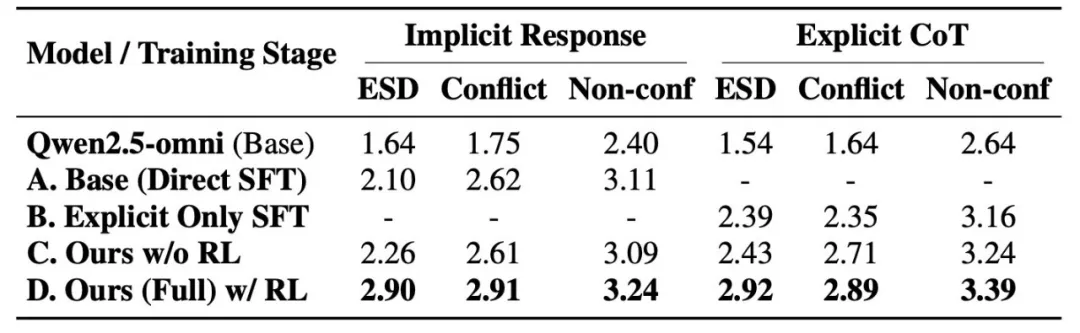
此外,从表 4 的共情质量消融结果可以看出,阶段二的混合任务训练成功让模型的隐式直接回复得分(2.61)媲美其显式推理得分(2.71),实现了能力的有效内化。最终在 DR-SAPO 强化学习(Model D)的优化下,模型在隐式和显式路径下的共情表现均达到了最优状态。
表4 共情质量(1-4分制)在隐式/显式双路线下的消融实验结果。
总 结
CogAudio-LLM 通过引入声学-语义解耦的数据集、结构化的 EIPS 心理思维链以及双路线隐式对齐强化学习,为语音大语言模型注入了真正的认知深度与情感洞察力。目前该论文的相关代码与 LIME-440K 数据集均已向社区开放,以助力下一代具备高度情商的上下文感知语音对话系统的研究。
参考文献
[1] X. Geng, Q. Shao, H. Xue, S. Wang, L. Xie et al., "Osum-echat: Enhancing end-to-end empathetic spoken chatbot via understanding-driven spoken dialogue," arXiv preprint arXiv:2508.09600, 2025.
[2] W. Tian, Z. Zhao, J. Hu, H. Chen, L. Xie et al., "EmoOmni: Bridging emotional understanding and expression in omni-modal LLMs," arXiv preprint arXiv:2602.21900, 2026.
[3] D. Huang, Y. Lv, R. Xiong, C. Jin, and X. Peng, "When tone and words disagree: Towards robust speech emotion recognition under acoustic-semantic conflict," arXiv preprint arXiv:2601.04564, 2026.
[4] Z. Zhao, X. Zhu, X. Wang, S. Wang, W. Tian, and L. Xie, "Steering language model to stable speech emotion recognition via contextual perception and chain of thought," IEEE Transactions on Audio, Speech and Language Processing, vol. 34, pp. 415-426, 2025.
[5] DeepSeek-AI, "DeepSeek-V3 technical report," arXiv preprint arXiv:2412.19437, 2024.
[6] DeepSeek-AI, "DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning," arXiv preprint arXiv:2501.12948, 2025.
[7] J. Xu, Z. Guo, J. He, H. Hu, T. He et al., "Qwen2.5-omni technical report," arXiv preprint arXiv:2503.20215, 2025.
[8] S. Wang, Z. Zhao, H. Xue, C. Wang, S. Wang, and L. Xie, "Humdial-eibench: A human-recorded multi-turn emotional intelligence benchmark for audio language models," arXiv preprint arXiv:2604.11594, 2026.
