
 语音小管家
以下文章来源于AI语音AI思考
今天 OpenAI 发布了 GPT-Live,展示了令人惊艳的实时语音交互能力。4月份,在豆包发布全双工语音对话模型时,我也曾写过一篇文章,探讨了端到端全双工语音交互背后的技术门槛,以及如何构建一个真正的语音智能体。
今天结合 GPT-Live 的发布,我发现我之前的核心观点并没有变,反而被 OpenAI 的这次发布进一步印证了。
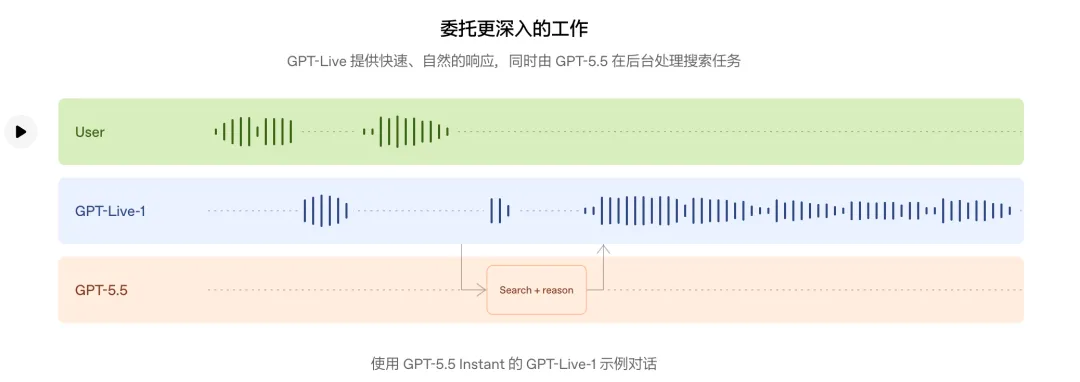
GPT-Live 无疑把“端到端全双工(Full-duplex)”和“语音智能体”的行业天花板推向了一个新的高度。普通用户不需要懂这些拗口的名词,哪怕技术已经达到了这个水平,在普通用户眼里也只能算是一个正常表现,因为用户的对标对象始终是真人。
交互与执行的解耦
在我之前的文章中就提到,一个语音智能体的交互和执行应该是解耦的,这一点在语音智能体的体验中特别重要。与文本交互可能还不太相同,在文本交互中人们习惯于等待,因为交互感并没有那么强烈。
比如我们在使用 AI 编程助手时,我们会看着 AI 完成思考、编写代码(Coding)的整个过程,但是在语音交互过程中,是没有人有这个耐心的。
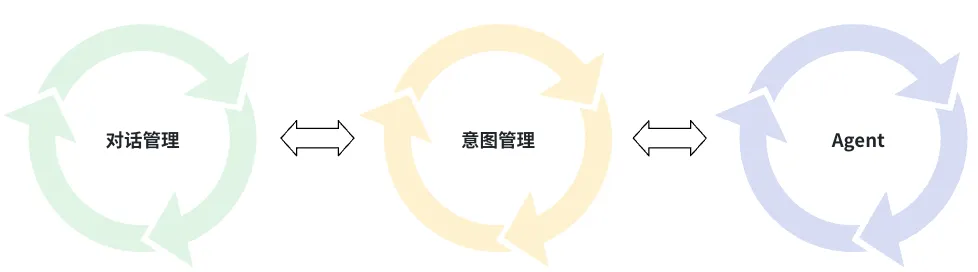
因此,对于复杂的任务,我们不能让执行阻塞住交互的过程。所以我提出了交互、意图和执行三个模块之间的解耦。我们看到 GPT-Live 实际上也是这样做的。
交互的端到端不代表 Agent 的端到端
我们从这个架构上可以看到,无论你的交互使用端到端还是级联系统,其实都不影响 Voice Agent 整体的架构。只不过随着数据量的增大,语音端到端模型在交互的自然度上,会比级联的方式好很多。
但这种能力的提升,意味着更高的算力需求、更多的数据以及更精细化的标注。对于一般的小公司来说,是很难具备这种能力的;即使对于大厂来讲,这也不是一件非常容易的事情。技术发展到今天,大家肯定也都在诟病级联系统的问题。
但级联系统当然有自己的好处,它能够让任何一个人都轻松地搭建一个语音对话系统,这也是目前对于大部分公司来说最方便的方案。
只要用 API 就难免有延迟
大家诟病最多的一个问题是级联方案的延迟。的确,因为级联方案需要多次调用不同模型,每一个模型都会增加延迟。特别是当我们使用 API 时,无论底层是端到端还是级联,API 调用的延迟都会是一个痛点。
举一个很简单的例子,同样是调用千帆 DeepSeek 模型,在调试平台上调用,首 Token 的延迟通常在 500ms 左右;但如果是正常的 API 调用,波动会很大,1-2s 都有可能。这是因为调试平台用户少,无需经历 API 排队等待和调度的过程。
语音端到端模型的推理成本要比文本大很多,如果将来大家都用端到端的 API,算力成本会更高,一样会存在 API 的调度问题。
级联系统做好的关键:实时对话管理
我一直认为级联系统也是可以做好全双工语音对话的,那为什么现在普遍做不好呢?因为大部分的对话管理都是基于 API 的文本大模型来做的。
所谓的对话管理,实际上就是去决策 AI 什么时候该说,什么时候不该说。
对话管理需要极其硬核的实时判定,比如每间隔 200ms 就要推理一次。基于文本大模型,特别是依赖 API 调用的文本大模型来做这种高频推理,显然是不现实的。那怎么办呢?我们完全可以自己训练和本地部署轻量级的模型来解决这个问题。特别是这两年,类似的实践越来越多,实际落地时只需要投入更多高质量的数据去进行模型训练即可。
总结
总而言之,GPT-Live 的发布不仅验证了语音交互追求极致自然体验的趋势,也进一步证明了在复杂业务场景下,语音智能体“交互、意图、执行”解耦架构的必要性。端到端模型虽然在拟真度和流畅度上具备压倒性优势,但其高昂的算力成本与 API 调度的天然延迟,意味着它难以在短期内完全取代级联系统。对于广大开发者而言,与其盲目追逐大厂的端到端 API,不如在级联架构下,通过自建轻量级的本地实时对话管理模型,在成本、延迟与体验之间找到最佳平衡。语音 Agent 的未来,不止于模型本身的强大,更在于系统架构的巧妙设计与落地。
