
 语音小管家
本期分享由国防科技大学、西安邮电大学、北京声学研究所联合编撰的英文学术专著 General Audio Signal Processing with Deep Learning,全书由 Springer 出版社正式出版。
本书以深度学习赋能通用音频信号处理为核心主线,完整梳理该领域的理论方法、典型任务与工程应用,覆盖音频特征表征、传统机器学习与深度神经网络、自监督学习、小样本音频学习、音频分类、声源定位、音频生成、语音降噪、音频语言建模等基础方向;同时拓展水声信号、城市环境声、工业声学监测、医疗声学诊断及多模态音频融合学习等交叉研究内容。
【书名】General Audio Signal Processing with Deep Learning。
【出版信息】Springer Nature,2026 年出版。
【本书编辑】Kele Xu、Jisheng Bai、Boqing Zhu、Qisheng Xu、Yi Su、Mou Wang。
【编辑单位】本书编者主要来自国防科技大学、西安邮电大学、北京声学研究所。
【作者邮箱】kele.xu@ieee.org。
【本书亮点】
本书的第一大亮点在于,它有意识地将研究视野从传统“语音中心”的音频处理扩展到更广义的音频信号处理场景,包括音乐分析、环境声分类、生物声学、医疗声学和工业监测等方向,强调深度学习在非语音音频领域中的系统性应用价值。本书希望突出 spoken language 之外更丰富、但常被低估的 general audio 任务。
第二大亮点是构建了从传统信号处理到现代深度学习的完整知识框架。书中不仅介绍时间域、频域、时频域、听觉感知启发表示等传统音频表征方法,还系统梳理 CNN、RNN、Transformer、自编码器、GAN、图神经网络、扩散模型、状态空间模型等深度模型,并进一步覆盖自监督、半监督、主动学习、少样本学习、增量学习和数据增强等前沿训练范式。
第三大亮点是“任务—应用”覆盖面较完整。任务层面,本书涵盖音频分类、声源定位、异常声音检测、音频源分离、音频生成、音频—语言学习和音频去噪;应用层面,则进一步延伸到水声、城市声音、工业声音、医疗声音和音频相关多模态学习等垂直领域。
第四大亮点是面向真实部署与未来发展。全书不仅讨论模型能力,也强调数据预处理、评估协议、模型部署、可解释性、计算效率和可扩展性等实践问题;未来趋势部分进一步聚焦自监督/无监督学习、Transformer 架构、多模态融合、生成式模型、实时音频处理、低资源部署、跨域跨语言泛化、可解释性和绿色高效训练等方向。
【引言】
音频信号处理是连接声音采集、表示、分析、增强、生成与理解的核心技术领域。传统音频信号处理依赖滤波、傅里叶分析、频谱分析、卷积、互相关等数学工具,用于提取有意义的声学特征、改善感知质量或服务特定工程目标。随着机器学习和深度学习的发展,音频处理从依赖人工设计特征的范式,逐步转向由模型直接从原始波形或低级特征中学习层次化、任务自适应表示的范式。
本书正是在这一技术转变背景下展开。它定位为一本面向研究者、学生和工程实践者的综合性指南,旨在弥合传统音频信号处理与现代深度学习方法之间的断层,帮助读者理解如何将深度神经网络、自监督学习、多模态学习和生成式模型应用到复杂音频任务中。书中强调,深度学习不仅提升了噪声鲁棒性、时序建模能力、可扩展性和任务适应能力,也打开了许多传统方法难以实现的新应用空间。
【研究背景】
音频信号处理的发展大致经历了模拟信号处理、数字信号处理、特征工程、深度学习和端到端学习等阶段。20 世纪中期的模拟音频处理主要依赖滤波器、放大器和调制技术;20 世纪 70 年代以后,DSP 与 FFT 推动频域分析、降噪、压缩和实时音频效果发展;90 年代到 2000 年代,MFCC、倒谱分析等人工特征成为语音识别、音乐信息检索和音频分类的重要基础;2010 年代以后,CNN、RNN 等深度网络在音频分类、语音识别、音乐生成和环境声识别中取得显著进展,并进一步推动端到端波形建模。
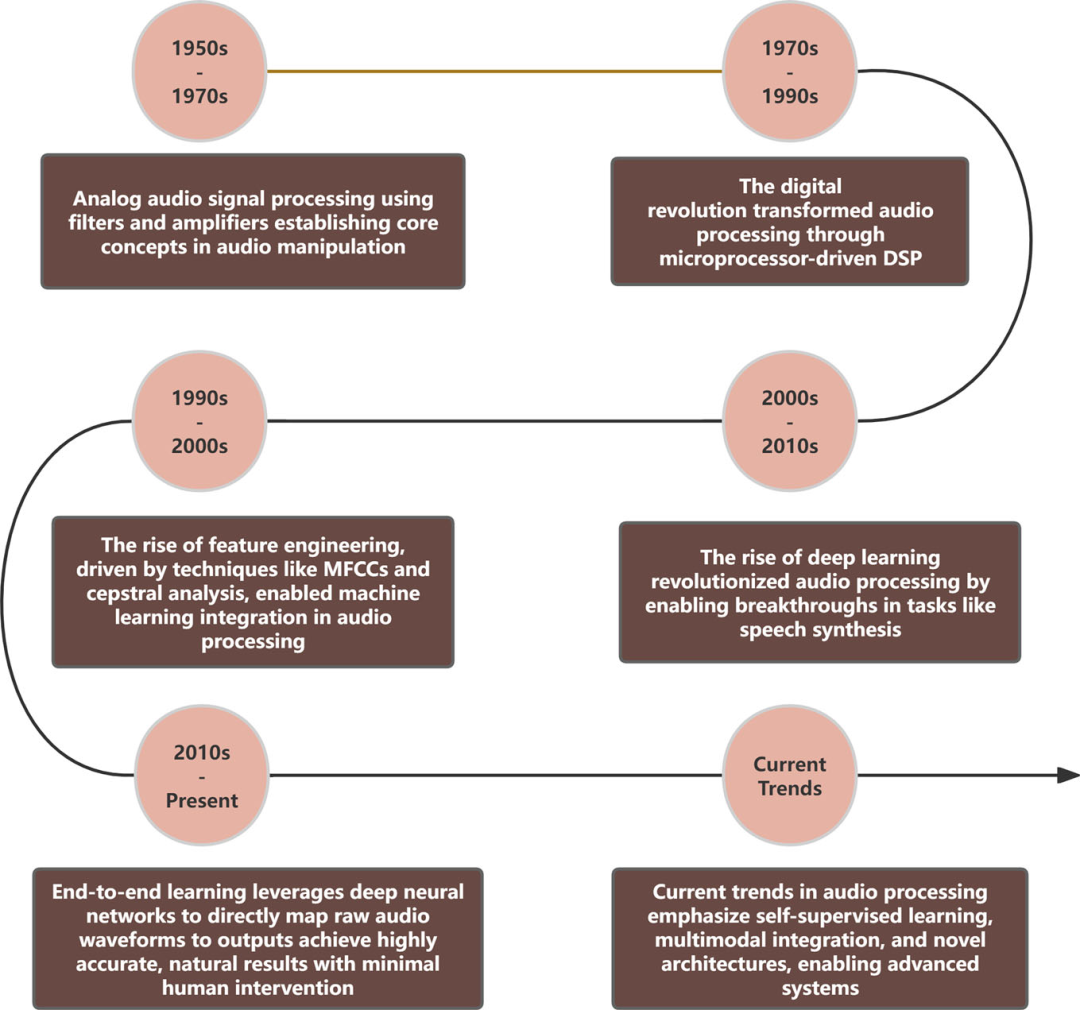
图1 音频信号处理的发展历程
与此同时,音频数据本身具有高度多样性。书中将音频信号划分为语音、音乐、环境声、双耳与三维音频、电信音频、医疗声音、水声、生物声学信号以及合成/生成音频等类型,不同类型对应不同的物理特性、应用目标和处理技术。正因如此,通用音频信号处理不应只围绕自动语音识别或语音增强展开,而需要面向更广泛的真实声学环境和跨领域应用。
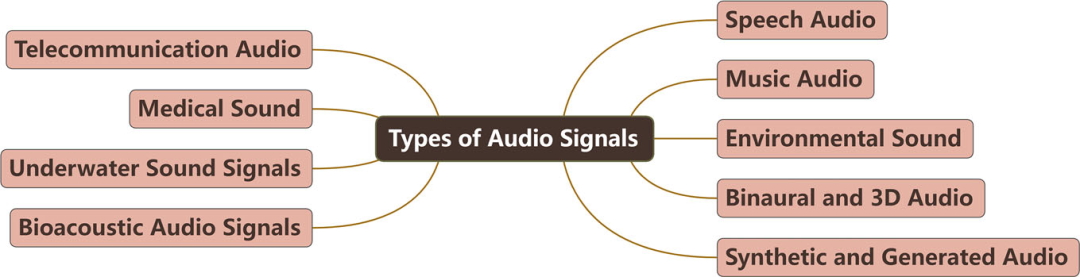
图2 音频信号类型
本书还将音频处理与计算听觉、计算机视觉和多模态 AI 联系起来。音频标签、声音事件检测、源分离等任务与图像分类、定位、分割之间存在方法论对应关系;音频的谱图可以像图像一样被 CNN 等深度模型处理,而音频—视觉—文本的融合又推动了更接近人类多感官感知的智能系统。
【研究方法】
作为一部综述性与教材性兼具的图书,本书采用“基础概念—核心方法—典型任务—垂直应用—未来趋势”的组织路线。第一部分介绍音频信号基础、音频信号处理历史、音频类型以及计算听觉与计算机视觉的关系,为后续方法与任务章节奠定背景。
第二部分聚焦核心方法。首先从连续时间信号、离散时间信号、时域表示、频域表示、时频表示、听觉感知启发表示和图像启发特征等角度介绍传统音频表征;随后介绍监督学习、无监督学习、半监督学习、自监督学习、生成式学习等机器学习范式,以及 CNN、RNN、CRNN、U-Net、GAN、Transformer、自编码器、GNN、扩散模型、选择性状态空间模型和深度强化学习等模型。
在此基础上,本书进一步讨论适合音频场景的高级学习策略,包括自监督学习、半监督学习、主动学习、少样本学习、增量学习和数据增强。这些章节共同回答了音频深度学习中常见的关键问题:标注数据不足时如何训练模型,跨任务泛化如何提升,新类别或新环境出现时如何持续学习,以及如何通过增强与预训练提升鲁棒性。
第三部分进入具体任务,包括音频分类、声源定位、异常声音检测、音频源分离、音频生成、音频—语言学习和音频去噪。第四部分则将这些方法迁移到水声、城市声音、工业声音、医疗声音和音频相关多模态学习等实际场景中,形成从基础算法到行业应用的完整链条。
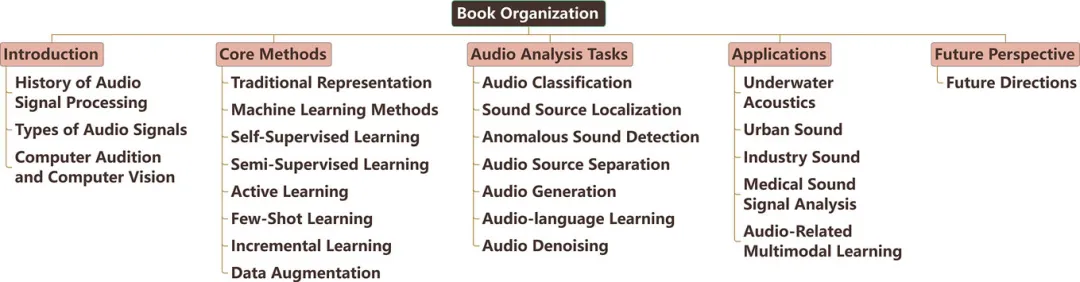
图3 本书组织架构
【结论】
本书系统梳理了深度学习与通用音频信号处理的交叉领域,核心思想是:音频智能正在从传统的手工特征、任务专用模型和单一语音场景,转向更通用、更可迁移、更具语义理解能力的深度音频系统。全书以传统音频表征为基础,以深度模型和先进学习范式为核心,以音频分类、定位、分离、生成、去噪和音频—语言学习为主要任务,并通过水声、城市声、工业声、医疗声和多模态学习展示其应用价值。
总体而言,本书适合作为深度学习音频方向的入门教材、研究综述和工程参考资料。它的主要贡献不在于提出某一个单独算法,而在于建立了一套较完整的知识地图:从音频信号是什么,到如何表示音频、如何训练模型、如何评价任务、如何落地应用,以及未来音频 AI 将向自监督、Transformer、多模态、生成式、实时化、低资源化、可解释和跨学科融合方向发展。
【图书链接】https://link.springer.com/book/10.1007/978-981-95-0836-5
