
 语音小管家
来源丨SV4Good AI Lab
论文:https://arxiv.org/abs/2512.23994 主页: https://phyavbench.pages.dev/ 代码:https://github.com/imxtx/PhyAVBench
行业痛点:音画生成只「同步」,不「物理」
画面流畅、音画对齐、语义匹配 能做电影剪辑、广告、虚拟世界建模
敲不同材质,声音应该不一样,但模型常给「通用撞击声」 吹空瓶 / 装水瓶,共振频率不同,模型却生成一样的声音 声音传播衰减、遮挡隔音,几乎全军覆没
只测音画同步、语义一致 完全不评估声音是否符合物理 复用旧数据集,变量不可控,有数据泄露
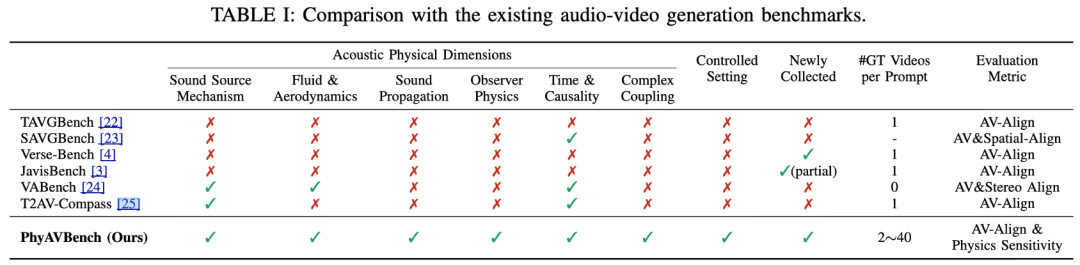
PhyAVBench 是什么?
1. 全新数据集:PhyAV-Sound-11K(零泄露)
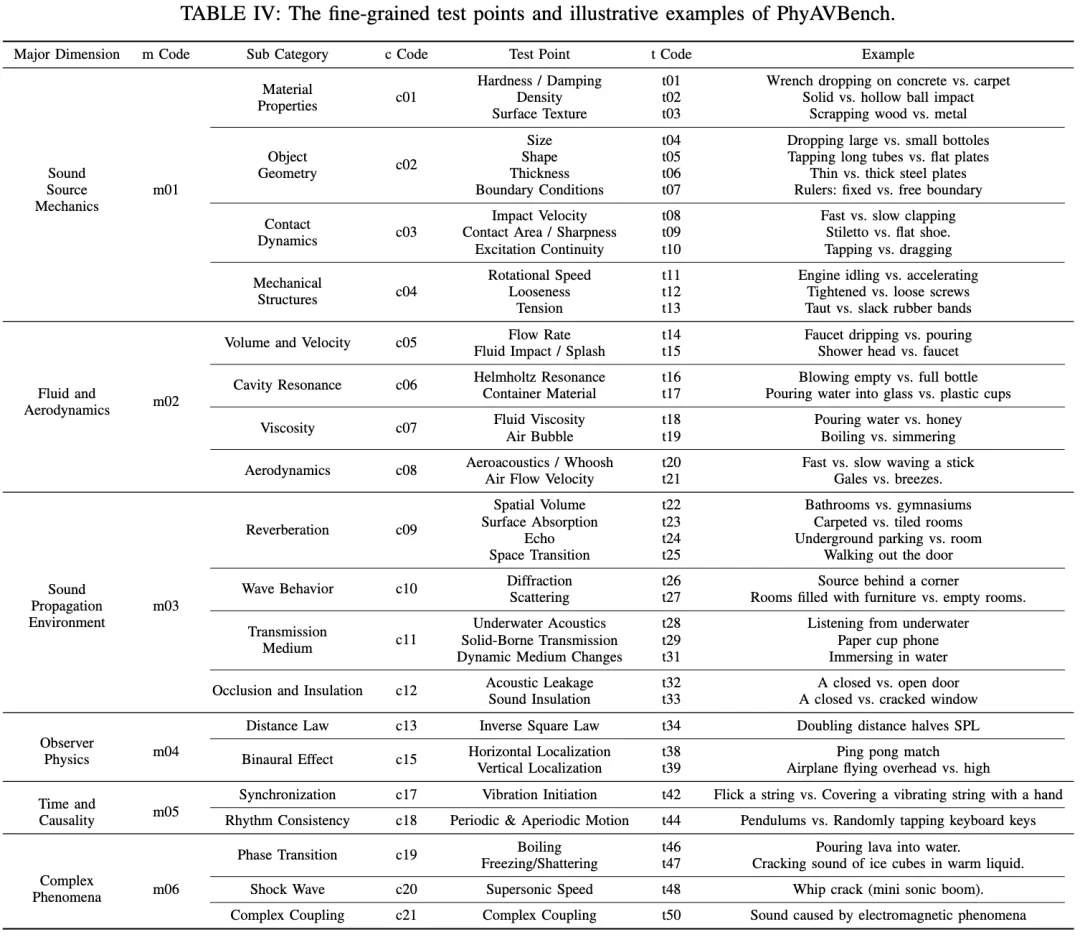
时长:25.5 小时 视频:11,605 条,全新实拍,杜绝训练集泄露 参与者:184 人录制,场景多样 提示词:337 组对比提示对,每组只变一个物理变量 覆盖:6 大物理维度、41 个细粒度测试点 标注:带逐步骤声学物理推理,标注清楚「为什么是这个声音」
2. 全新评估范式:APST(音频物理敏感度测试)
看整体像不像、同步不同步 无法测:物理条件变了,声音对不对
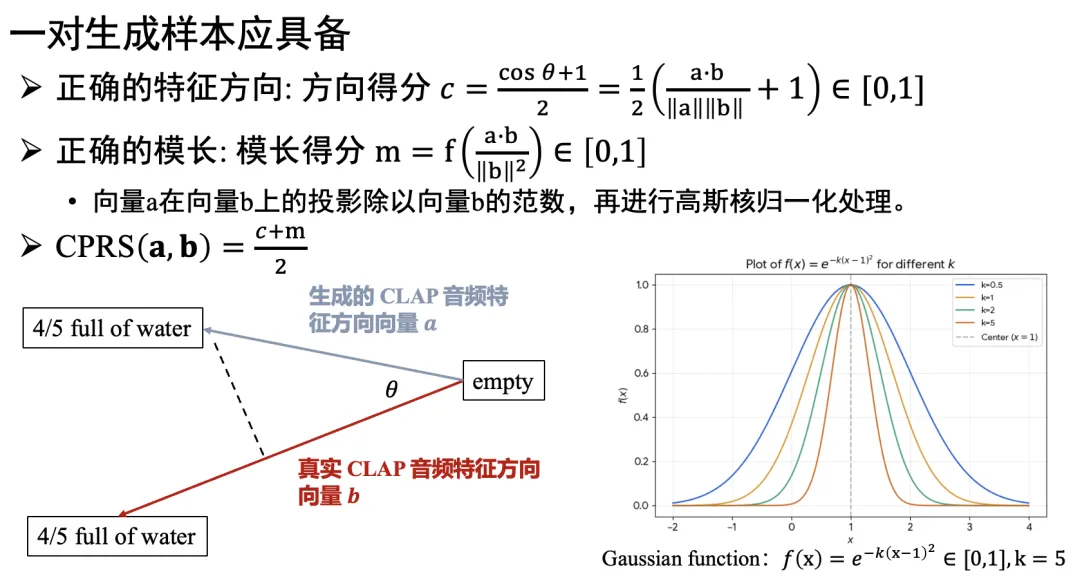
用成对提示词,仅控制一个物理变量不同 看模型生成的声音,方向是否对、幅度是否准 比如:空瓶 vs 4/5 水的瓶子,吹气声音差异
3. 全新指标:CPRS(对比物理响应得分)
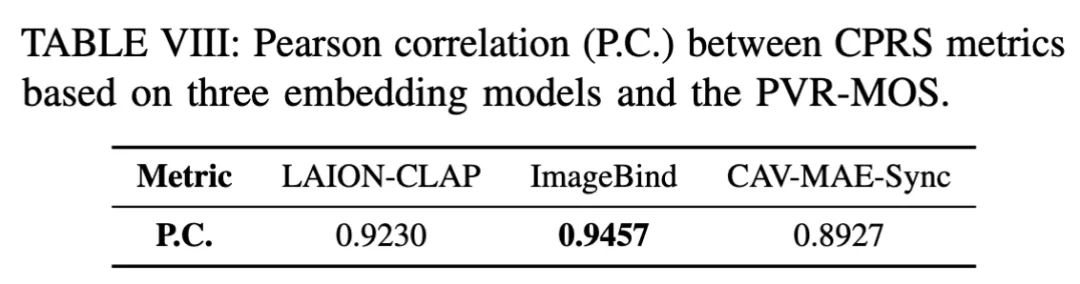
用 CLAP 提取真实音频的特征,算出真实物理变化方向 提取模型生成音频的特征,得到生成变化方向 用余弦相似度算方向对齐 通过将生成的变化方向投影到真实方向,经高斯核正则化计算幅度匹配 平均得到最终 CPRS
6 大物理维度,41 个细粒度考点
数据集构建流程
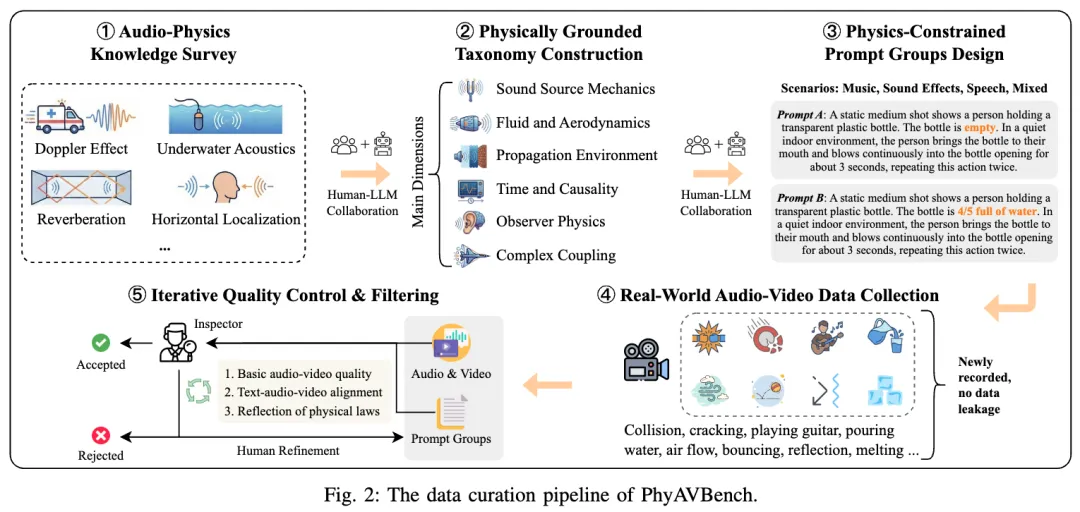
音频物理知识调研专家 + LLM 梳理声学物理原理,确定声音产生、传播等核心机制。 物理导向分类体系构建按声源机制、流体气动、传播环境等 6 大维度,拆解出 41 个细粒度测试点。 物理约束提示词组设计LLM 生成单变量控制的成对提示词,人工精修,确保仅一个物理因素不同。 真实音视频采集184 名参与者在可控环境全新录制,共 11605 条、25.5 小时视频,无复用数据、无训练集泄露。 迭代质控与过滤LLM 初筛 + 专家核验,保证音视频质量、文本对齐与物理规律一致性,不合格样本剔除 / 重录。
实测结果:Sora 2 也不及格,行业差距巨大
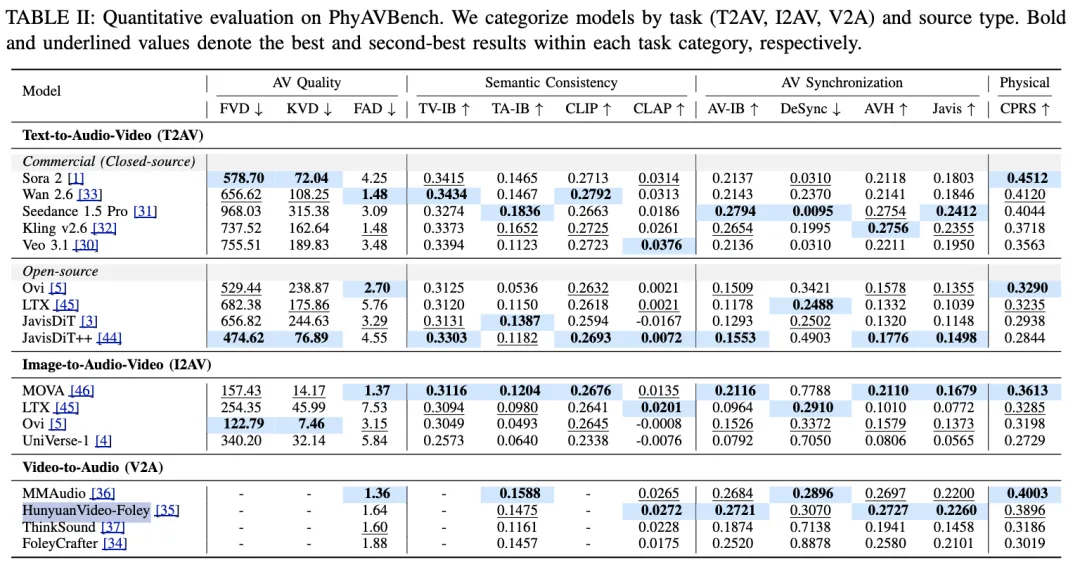
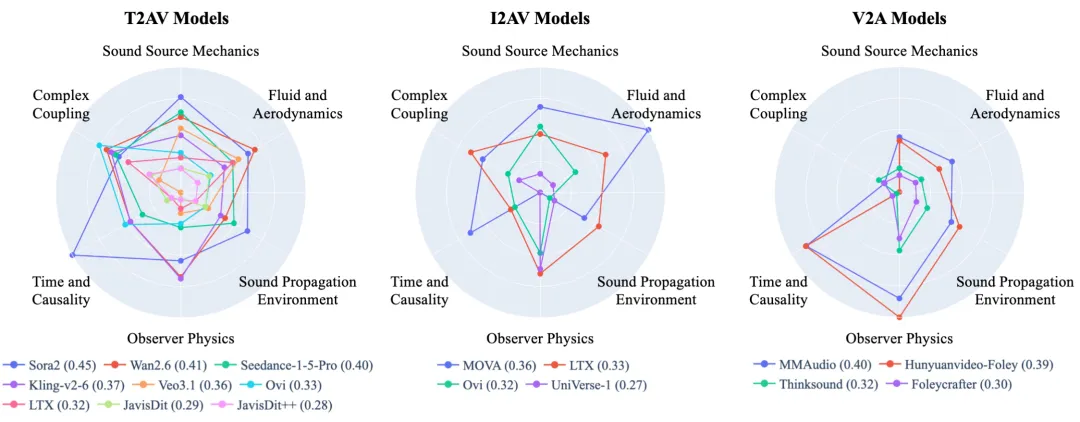
T2AV 第一:Sora 2 → 0.4512 第二:Wan 2.6 → 0.4120 V2A 第一:MMAudio → 0.4003 第二:HunyuanVideo-Foley → 0.3896
而开源模型普遍:0.28~0.33
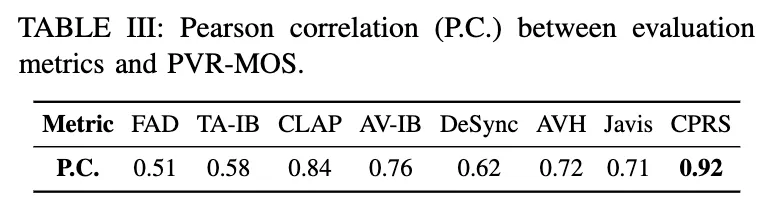
模型 PVR-MOS(物理变化响应)远低于真实视频 CPRS 与人类评分高度一致,证明指标有效
PhyAVBench 的重要性
填补空白:第一个专门评估音频物理合理性的基准 可控可复现:对比提示 + 全新实拍,无泄露、无干扰 细粒度可诊断:知道模型哪类物理现象不行 指标靠谱:CPRS 强相关人类判断,可自动化评测 指明方向:未来音视频生成必须走物理感知路线,而不是纯对齐
总 结
覆盖范围更广 音频类型:音效、音乐、语音及其混合音频 应用场景:受控实验室环境、拥挤城市空间、自然环境等 评判&奖励模型 训练专用的音频物理评判模型,可作为可靠评估工具,用于判别生成音频的物理合理性与保真度。
融入显性物理规律 未来研究需将显性物理规律与解析公式融入音频生成流程,例如振动、冲击动力学、共振、阻尼以及波传播相关方程。 物理感知可控生成 不仅依托视觉/文本输入实现条件生成,还可基于材质类型、作用力大小、物体质量、弹性、接触几何形态等显性物理变量完成生成。 结合仿真的合成方案 将生成模型与物理仿真器相结合。 融合可微仿真、近似物理求解器或经典声学结构化先验的混合系统,能够实现更贴合真实效果的音频合成。
