
 语音小管家
良好的音频生成范式大概的确需要 latent。待压缩的音频无论取 patch 还是 STFT,从无到有的新 dim,本质上都承担着时域压缩的功能;但音频在不同时间尺度下有无法归纳的 semantic 周期,在频域做 polar 或原始 complex 的各种变换,也始终找不到 RGB 那样轮换对称的、优雅的信息形式。
既然压缩范式趋于稳定,那么在等效的权重大小和正则化手段下,acoustic 质量或许只能从"监督"的视角抠一点信息余量出来。这是我们工作的出发点:我们希望音频的编解码是压缩毛巾,而不是压缩饼干——水分挤得出去,还要还原得回来。
具体而言,现有开源模型的训练目标在三个地方与听觉感知脱节。一是感知加权缺席:人耳对中高频敏感、对低频迟钝,逐频带等权的误差对二者一视同仁,模型容量被浪费在耳朵并不在意的细节上。二是相位无人监督:瞬态与清晰度写在相位随时间与频率的变化里,缺乏约束就出现瞬态涂抹与"电流声"。三是空间信息被压扁:左右声道间的相位差(IPD)是中低频声像定位的物理依据,缺少监督,声场扁平、声像漂移。εar-VAE 围绕这三点设计:44.1 kHz 立体声,1024 倍压缩,141M 参数。本文先讲各处设计的动机,定量结果统一放在第四部分。
⏩一、架构:非对称生成器与判别器的减法
1.1 生成器:两处关键的取舍
生成器采用编码器-解码器结构,骨架沿用 Stable-Audio-Open 的 VAE:编码器用 5 层步幅卷积逐级下采样(strides 为 [2,4,4,4,8],总压缩率 1024 倍)。激活函数选 SnakeBeta——它给网络注入周期归纳偏置,我们的实验里优于 ELU 和 LeakyReLU。
第一处取舍在上采样方式。转置卷积和"上采样+卷积"都能完成放大:后者的高频略精细,但整体响度和能量掉得明显;前者牺牲少量高频分辨率,换来充沛得多的能量。音乐重建里响度一掉耳朵立刻知道,我们选了转置卷积。所有卷积层做权重归一化,解码器输出沿用 SAO 的做法不接 tanh,它会引入谐波失真。
第二处取舍在 Transformer 的位置。Mimi 等模型在编码器和解码器两端都插入 Transformer,横跨整个瓶颈;我们在音乐信号上的实验发现,把 Transformer 全部集中在解码端效果最好。解释也直接:编码端的卷积先把局部时频特征提炼成鲁棒的表示,解码端的 self-attention 再在合成阶段建模跨频带的长程和声依赖。瓶颈处共两层带 RoPE 位置编码的 Transformer。
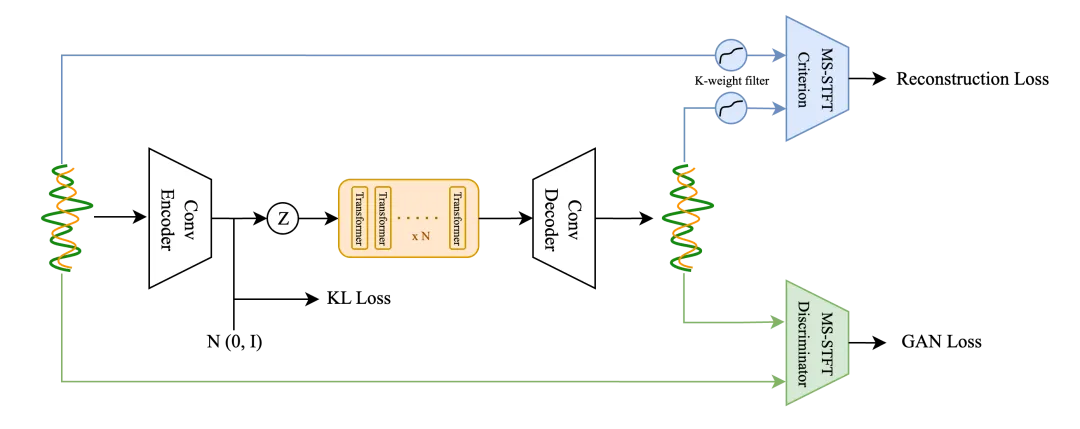
εar-VAE 总体架构
图 1:εar-VAE 总体架构:卷积编解码器、Transformer 瓶颈与 MS-STFT 判别器;重建损失经 K-weight 滤波后在感知域计算。
1.2 判别器:两处减法及其依据
判别器只保留多分辨率 STFT 判别器(窗长 [2048,1024,512,256,128],hop 为窗长的四分之一),做了两处减法。
弃用 MPD。MPD 为语音里稳定的周期模式设计;但音乐的速度与节奏型千变万化,MPD 对 period 参数高度敏感,没法在所有速度的乐曲上给出稳定判别。更要紧的是,实验发现它会在立体声声场中引发乐器定位的混乱。多尺度 STFT 判别器本身已经足够鲁棒,MPD 在这里是多余的。
弃用 CQT 判别器。BigVGAN-v2 等工作用 CQT 做补充判别,但 CQT 的对数频率刻度带来强烈的旋律归纳偏置,使判别器成了事实上的"旋律专家"。训练前中期,生成器确实更快学会旋律线条;代价是过多容量被分给旋律,而打击乐瞬态、混响尾音、空间信息这些在 CQT 域里不显著的成分被系统性忽视,模型最终收敛到更低的上限。STFT 的频响更均匀、没有音乐偏好,逼着生成器均衡地重建信号的所有成分。
⏩二、损失函数:把感知写进优化目标
2.1 K-weighting:一条老生不常谈的曲线
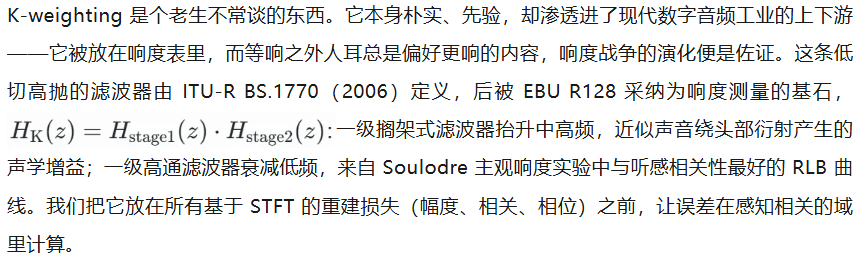
A-weighting 则大不一样——它之前活跃在 stable-audio-tools 的训练 recipe 里。可以清晰地观察到,它几乎只留下保守的中低频和保守的中高频(尽管低和高没有统一的定义),因为它设计之初服务于"噪声"的量级计算,而不是"扩声"。而高频恰是重建最困难、最需要误差信号引导的频段:用 A-weighting,模型在最难的地方只能拿到最弱的监督。
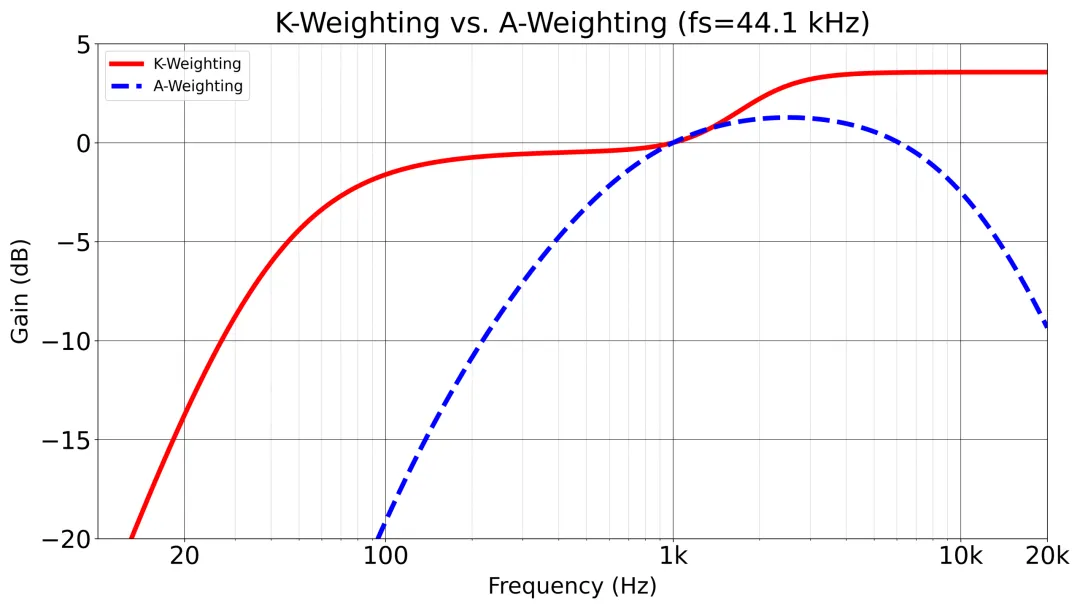
K-weighting 与 A-weighting 曲线
图 3:K-weighting 与 A-weighting 曲线。A 曲线在 10 kHz 以上衰减,K 曲线为搁架式抬升。
这条曲线的每一级都有可解释的来源,但"为什么它适合作为重建损失的加权"并没有现成答案——它为响度测量而生,不为监督深度模型而生。我们的信心来自结果论:数字音频走进人耳数十年,听音习惯已经某种程度上天然拟合了这条曲线;直到今天,听觉消费对应的生产者们依然离不开响度表,以及数字背后的这条曲线,作为工程质量的参考。把误差搬进它定义的感知域,是风险最小的先验。
另一个设计点是:K-weighting 只加在重建损失上,不加在判别器路径上。原因有二。其一,VAE 重参数化引入的噪声是全频段覆盖的,如果所有损失都感知不到低频,低频段的输出会停留在噪声状态——低频可以少管,不能不管。其二,重建损失是直接的样本级监督,判别器的 GAN 损失和 feature-map 损失的引导相对间接;加权要放在监督最直接的位置。
2.2 相位:另一个重灾区
相位是另一个重灾区。对深度学习模型的监督范式而言,信息向 stable-to-noise 收敛的痕迹在各方各面都有,相位在这样的环境下尤其令人痛苦。从时间尺度看,自然音频的相位在角度上具有连续性——30 度的上一刻不会和 90 度的下一刻接轨;但时域上的震荡频率,以 44.1 kHz 为例,其速率对目前 1d 卷积的特征捕捉造成了巨大压力。从频率尺度看,随着频率升高,单位时间尺度下相位的震荡速率也在上升。时域变化剧烈,频域变化不一,直接对相位用 L1/L2 或余弦相似度,是一个 ill-posed 的优化问题:模型会优先拟合变化慢的中低频相位,把高频相位整个放弃。
我们寄希望于端到端的监督能强迫模型学到它尽力的部分,于是不监督相位本身,改为监督相位的两个一阶偏导:
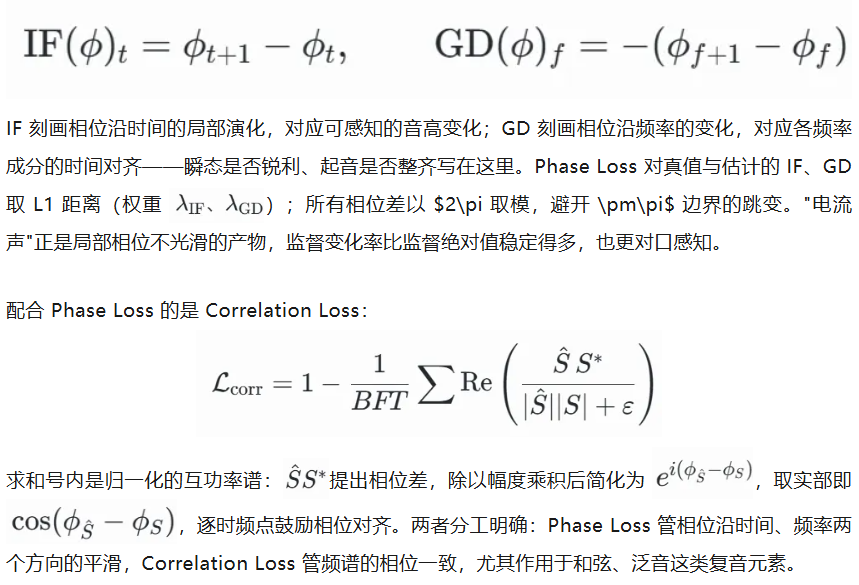
2.3 MSLR:幅度四路,相位两路
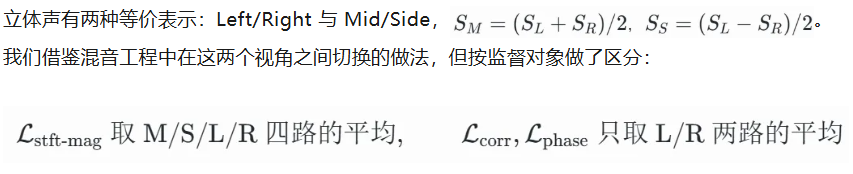
这一区分的依据来自心理声学。双工理论(duplex theory)告诉我们,中低频的声像定位主要靠相位与时间差,高频则靠强度差;立体声音乐的空间信息大量写在前者里,落到信号上就是声道间相位差(IPD)。M/S 变换对复数谱是线性操作,但落到幅度与相位上就不再简单:M/S 幅度仍有明确的感知含义——Mid 对应相关能量,Side 对应声像宽度,混音工程的相关表正建立在这之上;M/S 相位却是 L/R 幅度与相位的耦合函数,IPD 这一有明确物理意义的量被打乱重编码。监督 M/S 相位,等于让模型拟合一个高度耦合的非线性目标。实验结果与之吻合:在相位损失中引入 M/S 分量会带来可闻伪影,高频频谱发糊。幅度监督则相反,M/S/L/R 四路能给出关于能量与声像最完整的引导。需要指出,这一策略与 Stable-Audio-Open 不同,是我们自己的实验结论。
2.4 其余组件:各自存在的理由
多尺度对数幅度损失。取对数有两个作用:顺应人耳的对数感知特性;压缩动态范围,防止高能量成分主导计算,让低能量细节拿到应有的权重。距离度量选 L1 而非谱收敛(SC)损失——后者是相对误差,对幅度快速变化的信号过于敏感,L1 对动态复杂的音乐更稳定。
Feature-map 损失。取判别器各子尺度的中间卷积层特征做 L1,提供比标量判决稠密得多的监督信号,直接作用于音色、瞬态与和声内容的重建。
对抗损失。沿用最小二乘 GAN 目标,生成器与判别器交替优化。
⏩三、数据与训练
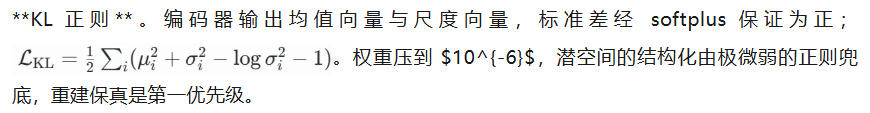
训练分两个阶段的数据:公开数据集(FSD50K、FMA、DISCO-10M)预训练,约一万小时专业制作音乐的内部数据集继续训练。筛选规则按重建目标设计,逐级递进。
第一级做格式统一:只收原生采样率 44.1 kHz 及以上的立体声,更高采样率的向下采到 44.1 k——不做向上采样,因为插值补不出原始奈奎斯特频率以上的真实内容,只会留下一段空白频谱(劣质插值器还会引入镜像伪影),要从源头保证奈奎斯特频率附近存在真实能量。第二级按感知响度筛选:以 EBU R128 标准的 LUFS-I 积分响度只保留 [-22,-5] LUFS 的曲目,剔除过响或过轻的极端样本。第三级只作用于内部数据集,处理削波:不同于凡削波皆弃的保守策略,我们刻意放宽——true peak 不超过 +1.0 dBTP 的一律保留。理由是适度削波在现代母带环节几乎必然存在,全部剔除会让训练数据与现代音乐工程的实际水平脱节。
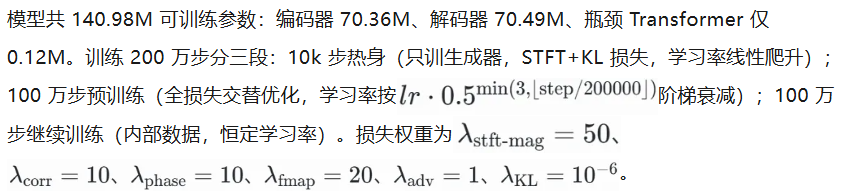
另有一项未成功的尝试值得记录。我们曾把重参数化的采样噪声从白噪声换成粉红噪声——$1/f$ 谱,通常被认为更接近自然信号。结果是宽声像乐器的细节确有改善,但整体频率能量关系被打破,低频能量缺失。症结在于先验假设的自洽性:KL 项要求后验向独立同分布的标准高斯收敛,采样过程却注入时间相关的粉噪声,二者相互矛盾;模型只学会了匹配粉噪声逐点的均值与方差,并未捕捉到它作为时间序列的长程相关特性。最终我们回到白噪声。
⏩四、评测与结果
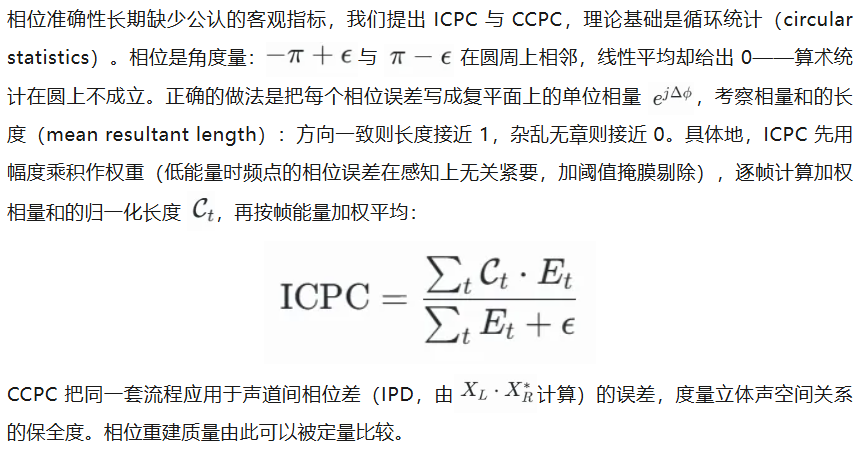
4.1 指标设计:相位准确性的量化
4.2 主结果
基线包括 DAC、Encodec、AudioGen(AGC)、Stable-Audio-Open,以及声码器 BigVGAN。MuChin 与内部验证集的结果如下(每格为 MuChin / 内部集):
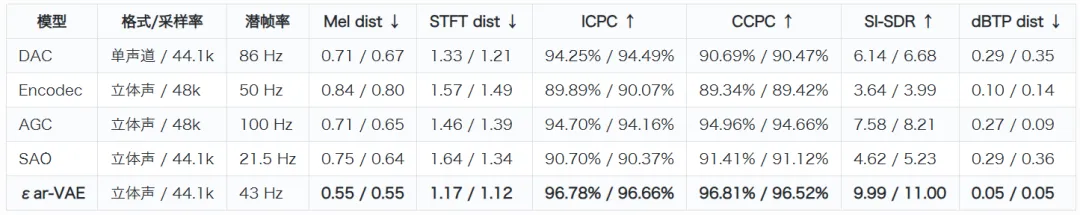
六项指标全面领先。单声道的 MusicCaps 上结论一致(SI-SDR 12.29,次优 DAC 为 9.94)。
BigVGAN 是个很好的对照组:它的 Mel 距离在多个数据集上最低,SI-SDR 却崩到 -16 甚至 -34——频谱距离很小,波形完全对不上。这提醒两件事:指标要成套地看,单一指标会说谎;相位管不好,频谱再像,还原出来的也不是原来的声音。
信号层面的另一项佐证是 THD+N(AES17 标准的总谐波失真加噪声):
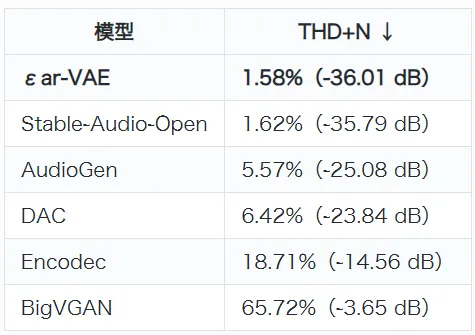
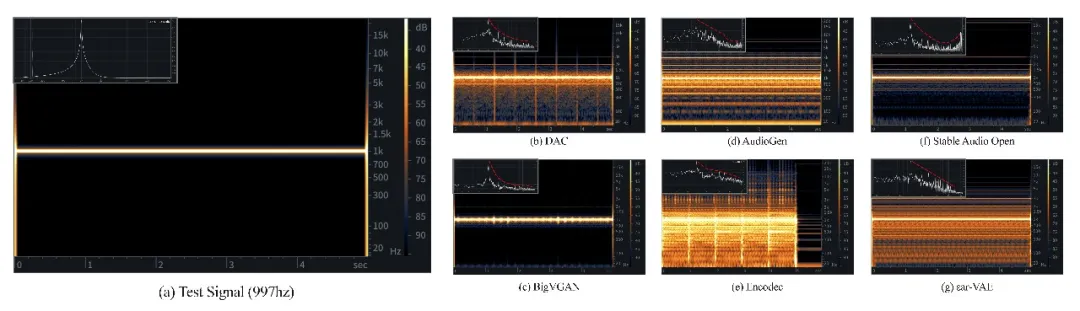
THD+N 与频响对比
图 4:各模型重建结果的 THD+N 与频率响应对比。εar-VAE 的谐波分布与衰减模式最接近自然信号。
频响分析还显示,εar-VAE 的谐波分布与谐波衰减模式最接近自然——面对训练中未见过的复杂信号,模型预测出的泛音结构更符合物理规律。
4.3 消融:逐项验证设计选择
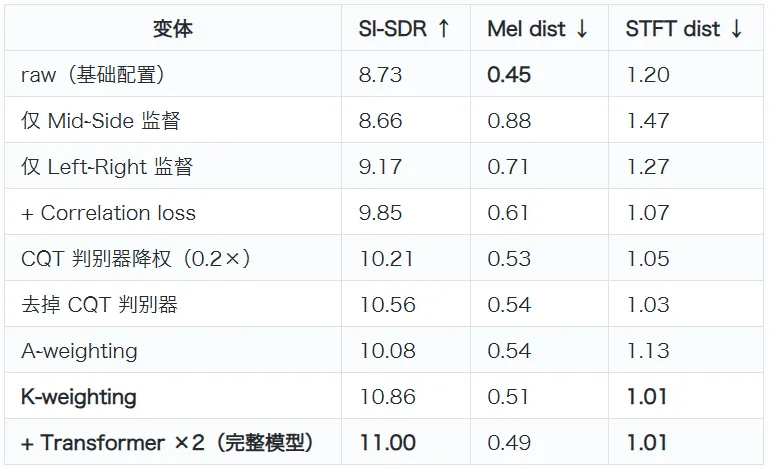
逐项分析:仅 M/S 或仅 L/R 的空间监督都不够(8.66 / 9.17),印证 MSLR 分治的必要;Correlation loss 带来 0.7 个 SI-SDR 点的提升(9.17 → 9.85),对应复音元素的相位一致;CQT 降权有效、去掉更好(10.21 → 10.56),与"旋律专家"的分析相互印证;K-weighting 优于 A-weighting(10.86 对 10.08),感知加权方向选对的收益明显;Transformer 两层补齐最后的全局建模(11.00),可视化消融还显示没有它,10 kHz 以上的泛音结构无法重建。前文的定性分析与这里的定量结果相互一致。
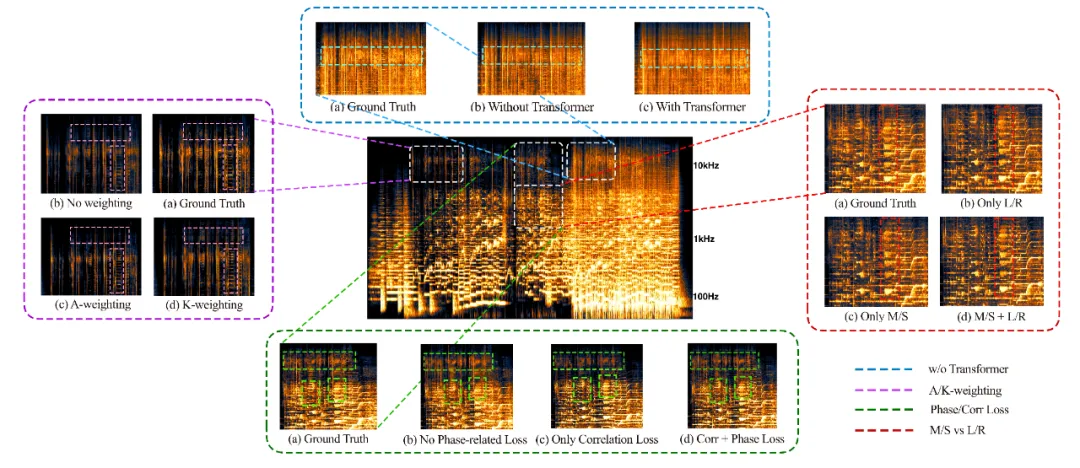
消融实验的频谱对比
图 5:消融实验的频谱对比,自上而下分别为:Transformer 瓶颈、加权曲线、相位相关损失、M/S 与 L/R 表示的影响。
⏩五、局限与展望
我们的工作仍存在两方面局限。其一,当前的潜表示停留在声学层面,难以直接对齐语义空间——要实现风格、情绪条件化的下游生成,潜空间还需要语义化改造。其二,模型接近收敛时,倾向于把混响、延迟、回声这类细微的空间效果当作低能量成分衰减,而这些恰恰是感知上重要的部分;设计针对性的损失函数以保全空间效果,是明确的下一步。更长远的方向是在此基础上做可控的条件合成:显式控制流派、情绪,甚至以全新的频响和动态范围重混一首曲子。
⏩六、结语
既然重建的终点是听觉,那么从加权曲线的选择、相位监督的对象,到判别器的取舍、数据筛选的标准,都先回答同一个问题——耳朵到底在意什么?
本文的一些技巧已被 Stable Audio 3 用于训练他们使用的 SAME codec,很感谢他们的认可与改进。模型代码、权重与音频示例已全部开源:https://eps-acoustic-revolution-lab.github.io/EAR_VAE/,欢迎直接试听验证,也希望这些工作经验能收获更多社区反馈。
此工作完成于自由量级(initi:AI)公司,阶段性服务于旗下产品“音潮涌现”的音乐生成效果,更多信息可查看:https://web.yinchaoyongxian.com/studio/about-us
本组织专注与音频相关的研究与工程, 静候各位合作:https://github.com/Eps-Acoustic-Revolution-Lab
