
 语音小管家
近日,IIP-HCI实验室关于全类型音频深度伪造检测的最新研究成果被多媒体领域顶级国际会议 ACM MM 2026 接收。会议全称为 ACM International Conference on Multimedia,自1993年创办以来持续推动多媒体内容理解、分析、生成与应用等方向的发展,是全球多媒体领域最具影响力的旗舰学术会议之一,同时被中国计算机学会列为计算机图形学与多媒体方向A类国际学术会议。
Beyond Speech: Dual-Domain SSL Fusion for Unified All-Type Audio Deepfake Detection
合作单位:长三角安全人工智能安徽省实验室、武汉大学、中国科学技术大学
论文介绍
近年来,语音合成、环境声音生成、歌声合成和音乐生成快速发展,音频深度伪造检测也由单一语音场景扩展到多种异构音频。现有方法通常为不同音频类型分别设计检测器,或先判断音频类型再选择对应模型。这类方案依赖准确的类型识别,容易将中间判断误差传递到最终结果。因而,该任务的核心并不是分别检测四类音频,而是如何在不同声学结构之间建立稳定、共享的真伪判别边界。
方法介绍
针对音频类型未知的检测场景,本文提出一种双域自监督特征融合框架。无论输入是语音、环境声音、歌声还是音乐,均经过同一条检测路径,并最终输出统一的真实或伪造判断,而不依赖“先识别类型、再选择检测器”的级联流程。
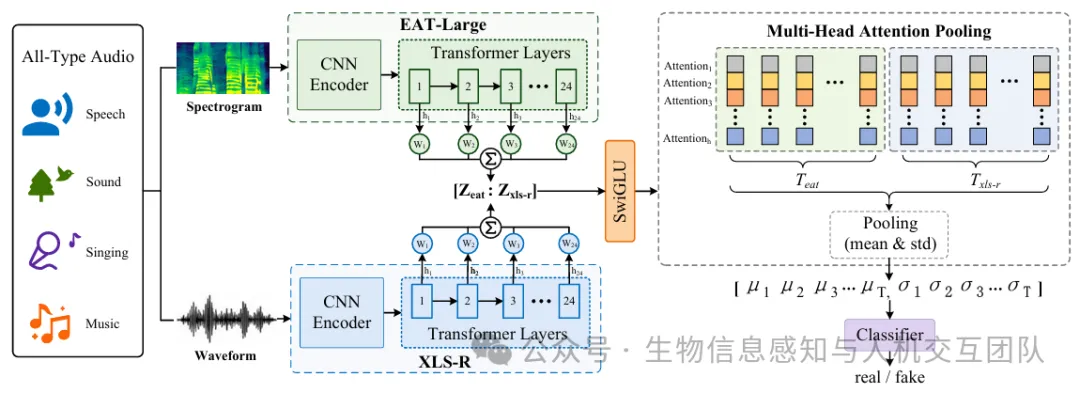
图 1 所提出方法的总体框架
1.双域互补表征:从时频结构与原始波形中寻找伪造线索,模型并行引入EAT-large与 XLSR-300M 两类自监督前端。EAT-large 从时频谱出发,擅长刻画声学事件、环境场景与音色结构;XLSR-300M 则直接处理原始波形,更关注语音、人声及局部波形变化。
2.跨层表征聚合:在无需帧级对齐的条件下融合双路特征,伪造痕迹可能存在于不同抽象层次:低层保留局部声学细节,中间层描述发音与声音事件结构,高层则包含更抽象的内容信息。为充分利用这些多层次线索,模型分别学习两个前端24层 Transformer 的融合权重,自适应选择更具判别力的层级表示。
3.注意力统计聚合:同时刻画关键线索及其动态变化,融合特征经过 SwiGLU 投影后,由多头注意力统计池化模块完成语句级聚合。不同注意力头可分别关注不同时间区域、特征来源和伪造模式,从统一特征池中筛选关键检测证据。
结果介绍
本文在全类型音频伪造检测数据集 AT-ADD上开展实验,该数据集覆盖语音、环境声音、歌声和音乐四类音频,并采用四类音频真假检测结果的平均 Macro-F1 作为综合评价指标。实验结果表明,单独采用 EAT-large 时,模型取得92.31%的性能;融合 XLSR-300M 后,性能进一步提升至94.55%,说明通用声学表征与语音敏感表征具有明显的互补性。相比之下,先预测音频类型、再选择专用检测器的方案仅取得91.46%,验证了统一检测框架在类型未知场景下的优势。在最终评测集上,所提出系统取得95.58%,相比基线的75.28%提升20.30个百分点。其中,语音、环境声音、歌声和音乐的F1分别达到85.23%、98.90%、99.47%和98.74%,表明该方法能够在不同声学结构之间保持稳定的真假判别能力。
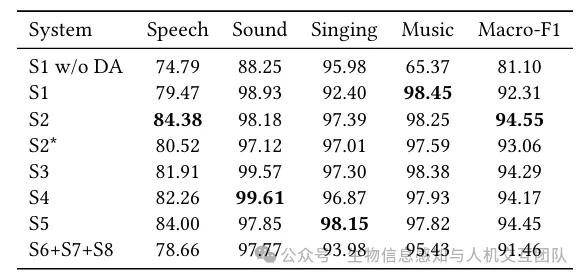
表1 不同系统在进展集上的实验结果
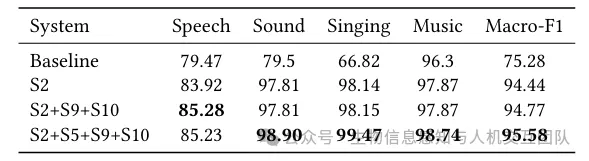
表2 最终系统在测试集上的实验结果
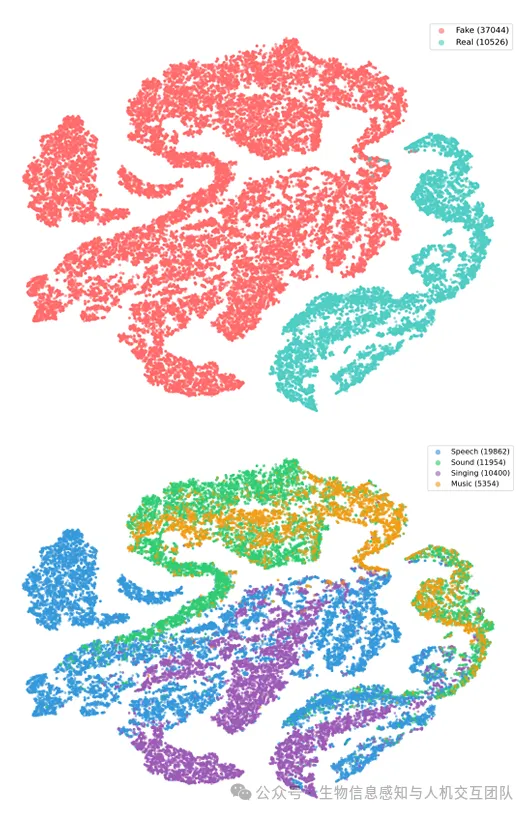
图1 真实/伪造及不同音频类型的特征分布
结 论
本文提出了一种面向语音、环境声音、歌声和音乐的统一音频深度伪造检测方法。通过融合 EAT-large 与 XLSR-300M 的互补表征,并结合多层特征聚合与注意力统计池化,模型能够在音频类型未知的情况下完成稳定的真假判断。所提出的统一检测模型能够有效处理不同类型音频之间显著的结构差异。并在 AT-ADD比赛中获得最佳方案,验证了统一双域特征融合策略的有效性。
