首页
声浪
活动
AI科普
学堂
SOTA
分享
热聘
会员服务
登录
注册
语音对话里的轮次判断:从级联到统一
语音小管家
2026-07-29
阅读 45
转载
语音对话
0
0
分享
本文来源:听见未来Tech
全双工(full-duplex)语音交互要求系统在用户说话的同时并行完成识别、理解与响应决策,其核心难点在于判断当前话轮是否结束——决定何时接话、何时继续等待。传统 VAD(Voice Activity Detection)仅依据声学特征区分有声与静音,无法辨别"停顿思考"与"话轮完成",易在用户换气时误触发、造成抢答。
目前除了端到端对话系统之外,业界普遍在语音链路上外挂一个独立的轮次判断(turn detection)模型,充当"语义级 VAD";该方案不侵入对话主干、工程可控且便于替换,已成为落地全双工系统的主流路线之一。下面选取五个代表性公开工作,按统一结构梳理其输入输出、模型架构与设计取舍。
Smart Turn
定位
:
Pipecat 团队开源、面向 CPU 部署的极轻量音频端点检测模型,主打"小而快",与 VAD 配合使用。
输入输出:
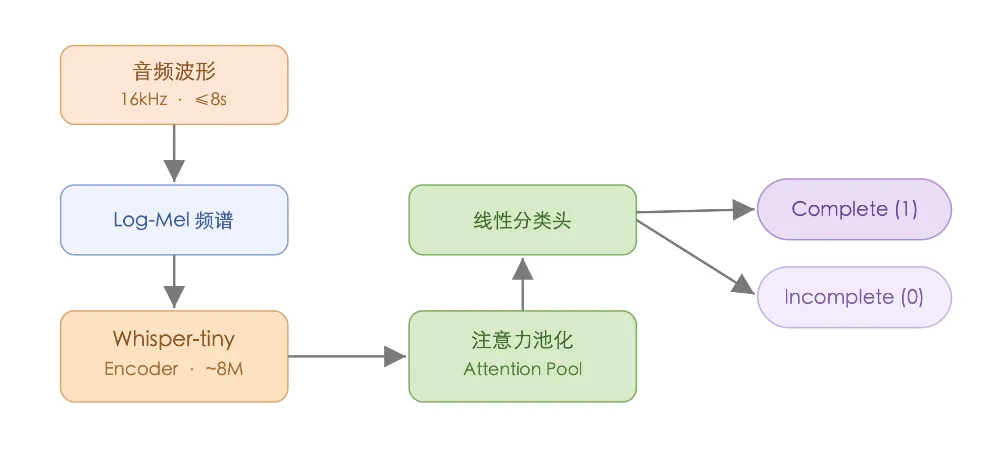
输入 16kHz 原始波形(最长 8 秒窗口,不足则补零),输出二分类——1 = Complete(说完)/ 0 = Incomplete(没说完)。运行时机由 VAD 触发:检测到停顿即调用它复判该轮是否真正结束。
架构:
v3 模型以 Whisper-tiny 的 encoder 为骨干,其上接注意力池化(attention pooling)与一个浅层线性分类头,全模型约 8M 参数,导出为 ONNX,int8 量化后仅约 8MB。相比 v1 的 wav2vec2-BERT(2.3GB)、v2 的 wav2vec2(约 360MB),v3 体积缩小了近两个数量级。
图 1 Smart Turn v3 架构示意(依据官方说明自绘)
特点:
极致轻量与低延迟是核心卖点。现代 CPU 上约 12ms、GPU 上 3–6ms 即可完成一次判断;v3 支持 23 种语言,权重、训练脚本与数据集全部开源。局限在于仅支持二分类、需要足够长的上下文、且必须由外部 VAD 触发;部分语言(如中文、越南语)准确率明显低于英、日、韩。
TEN Turn
定位:
TEN Framework 生态中的语义轮次检测器,直接借助大语言模型对文本做判断,是"用大模型理解语义"路线的代表。
输入输出:
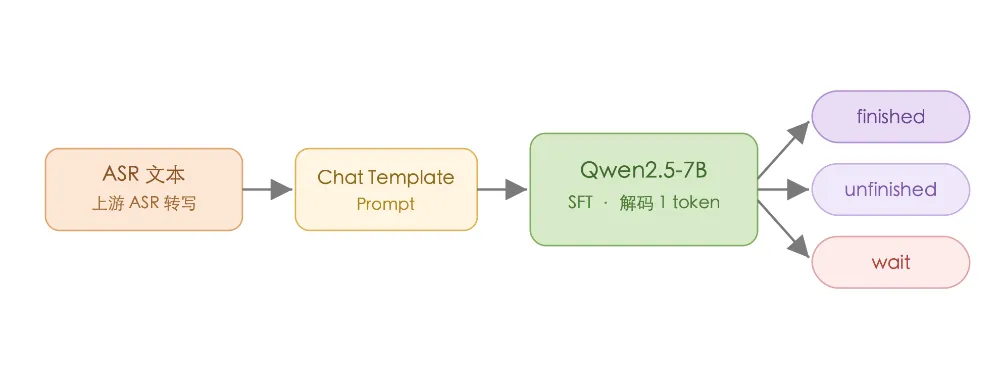
输入为 ASR 转写文本(语音场景下需上游 ASR),输出三类状态——finished(表达完整、期待回应)、unfinished(只是短暂停顿、话没说完)、wait(用户明确要求 AI 停下,如"闭嘴""稍等")。
架构:
以 Qwen2.5-7B 为底座,套用 chat template 构造 prompt,推理时仅解码 1 个 token(max_new_tokens=1,配合低温近贪心采样),使输出稳定落在三个状态词之一。本质是"生成式分类"——依靠微调后模型的强输出倾向来锁定这三类状态。
图 2 TEN Turn Detection 架构示意(依据仓库说明自绘)
特点:
相比 Smart Turn 增加 wait 状态,可处理"显式打断"这类纯声学难以判断的语义信号;原生支持中英双语,在其公开测试集上三类状态准确率均领先被对比基线。代价是 7B 体量偏重、需要 GPU(提供量化版本),且纯文本输入强依赖 ASR,既丢失了韵律信息,又会叠加 ASR 的识别误差与转写延迟。
Easy Turn
定位:
西工大 ASLP 与华为提出的开源、模块化双模态轮次检测模型,并配套开源了 1145 小时的训练集,意在推动该方向的可复现研究。
输入输出:
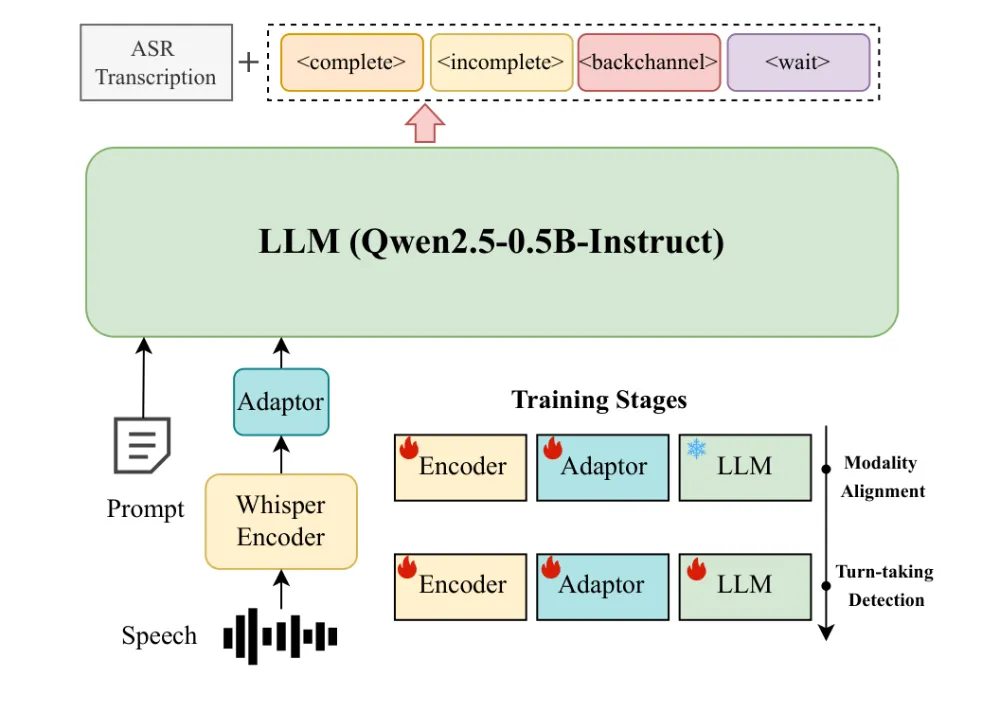
输入用户语音,输出"ASR 转写 + 轮次状态",支持四类状态——complete(语义完整)、incomplete(语义未完)、backchannel(简短附和,如"嗯嗯")、wait(请求暂停或终止)。
架构:
借鉴 Qwen-Audio,由 Whisper-Medium 音频编码器、音频 adaptor(3 层卷积 + 4 层 Transformer)与轻量的 Qwen2.5-0.5B-Instruct 组成,全模型约 850MB。关键在 "ASR+Turn-Detection" 范式:让 LLM 先生成 ASR 文本、再融合声学特征顺序预测状态标签,从而把声学与语言两种模态显式结合。训练分两阶段——先冻结 LLM 做模态对齐,再全参微调专攻轮次检测。
图 3 Easy Turn 架构与训练阶段(论文原图,arXiv:2509.23938 Fig.2)
特点:
在自建 Easy Turn testset 上,四类状态准确率全面领先 TEN Turn 与 Smart Turn V2(平均 95.75%),且参数与显存远低于 7B 的 TEN 方案。消融实验显示,去掉 ASR 中间步骤、或只用单一模态,都会显著掉点,验证了"先转写、再判断"这一双模态融合思路的价值。局限是仍需外部 VAD 切分音频、且为非流式判断。
Fast Turn
定位:
ASLP 联合声网、QualiaLabs 提出,面向低延迟与噪声/重叠鲁棒性的统一框架;模型权重未开源,仅开源了配套测试集。
输入输出:
输入语音,输出四类状态(complete / incomplete / backchannel / wait)。与 Easy Turn 不同,它借助流式 CTC,从"部分观测"就能提前决策,规避了"必须等完整 ASR 输出"带来的延迟累积。
架构:
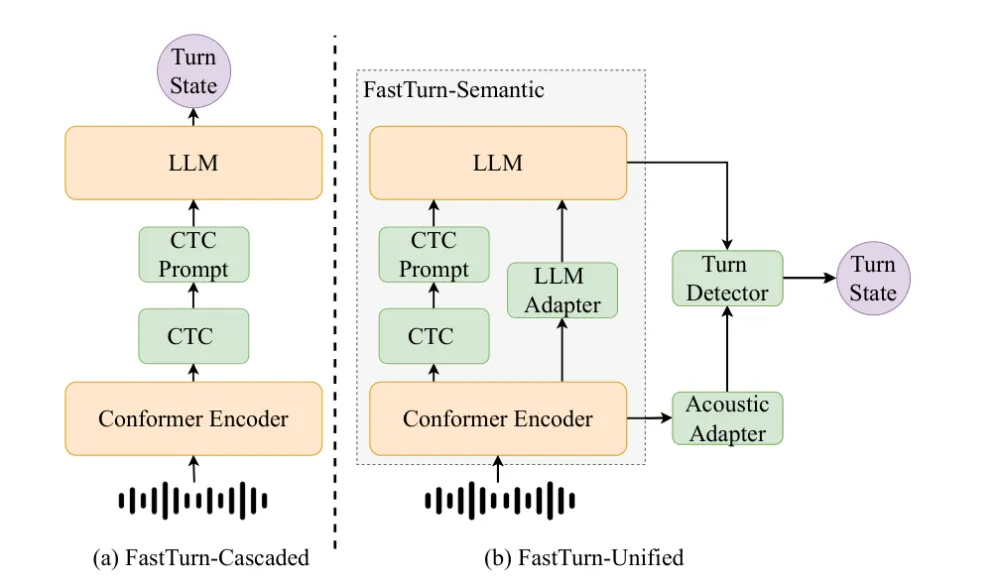
采用三段递进设计:Cascaded(Conformer + 流式 CTC 转写 → 作为 prompt 喂给 Qwen3-0.6B 判断)、Semantic(再引入 LLM adapter 把 Conformer 声学表征投影进 LLM 输入空间)、Unified(最终把 Conformer 中间层的细粒度声学特征经 acoustic adapter,与 LLM 隐状态融合,送入 3 层 MLP 的 turn detector 出决策)。即从 encoder 与 LLM 分别引出声学与语义 embedding,再由 MLP 分类头融合。配合四阶段训练与 prompt dropout,避免模型过度依赖 CTC 文本。
图 4 FastTurn 三段式架构(论文原图,arXiv:2604.01897 Fig.1)
特点:
"CTC 辅助决策 + 声学-语义深度融合"使其在含回声、重叠、噪声的真实对话上,比"Paraformer+TEN"与"仅级联 CTC"都更准,且中断延迟更低(Unified 约 120ms);作者同时开源了带重叠、附和、停顿标注的真实双通道对话测试集。
SoulX-Duplug
定位:
上海交大 X-LANCE 与 Soul AI Lab 提出的即插即用流式状态预测模块,可在不改动主干的前提下,为任意半双工对话模型外挂全双工能力,已开源。
输入输出:
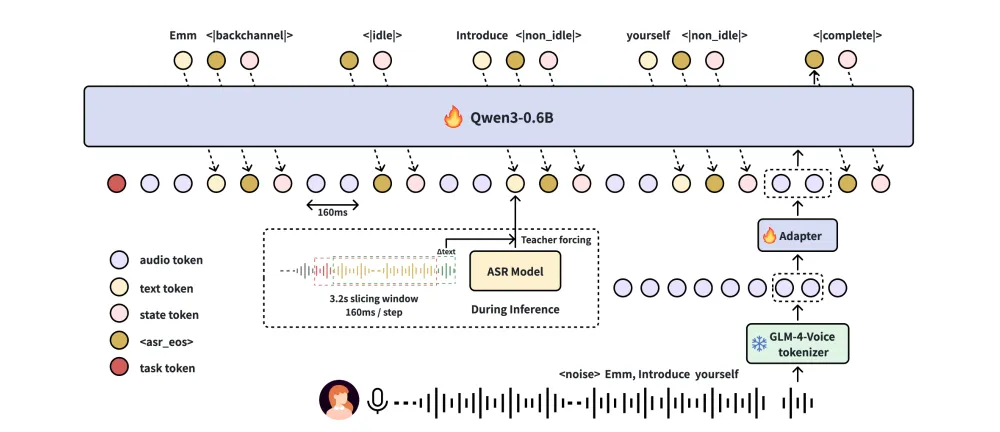
流式音频输入,以 chunk(160ms)为单位交错输出"音频 token / ASR 文本 token / 状态 token",支持五类状态——user_idle(静音或噪声)、user_nonidle(有语义语音)、user_backchannel(附和)、user_complete(语义完整、可接话)、user_incomplete(停顿但未说完)。
架构:
用冻结的 GLM-4-Voice tokenizer 把音频编码为 12.5Hz 离散 token,经 linear projector 送入 Qwen3-0.6B。训练时以 {A
t
, T
t
, S
t
} 交错序列联合优化 VAD/ASR/状态预测:先预测本 chunk 的 ASR 文本,再据此预测状态 token,保证预测状态时文本语义始终可见。三阶段训练(非流式 ASR 预训练 → 流式 ASR 适配 → 状态预测 SFT);推理时可改用外挂 SenseVoice-Small 以 teacher forcing 形式注入每个 chunk 的流式 ASR,兼顾精度与效率。
图 5 SoulX-Duplug 交错 token 流式架构(论文原图,arXiv:2603.14877 Fig.4)
特点:
把 VAD、ASR、turn detection 统一进单一流式架构,是首个"ASR 辅助的流式状态预测"外挂模块;chunk 化流式使理论平均延迟仅约 240ms,状态粒度也最细(五类状态覆盖 idle 与 backchannel)。配套开源了双语评测基准 SoulX-Duplug-Eval。即插即用、不动主干的设计,让下游对话模型可以独立扩展与放大。
横向对比
把五个工作的关键属性并排列出,取舍差异一目了然(延迟为各自论文/文档口径的参考值,测试条件不一,仅供横向感知):
模型
开源
输入模态
骨干架构
参数量
状态数
流式
语言
延迟(参考)
Smart Turn v3
是
音频
Whisper-tiny enc + 注意力池化 + 线性头
~8M
2 类
否(配 VAD)
23 种
CPU~12ms / GPU 3–6ms
TEN Turn
是
文本(需 ASR)
Qwen2.5-7B,解码 1 token
~7B
3 类
否
中/英
未公布(级联约 200ms)
Easy Turn
是
音频→ASR+判断
Whisper-Medium + adaptor + Qwen2.5-0.5B
~850MB
4 类
否(需 VAD)
中(英可扩)
~263ms
FastTurn
仅测试集
音频
Conformer + CTC + Qwen3-0.6B + MLP 检测头
~0.7B
4 类
是(流式 CTC)
中/英
~120ms(Unified)
SoulX-Duplug
是
流式音频
GLM-4-Voice tokenizer + Qwen3-0.6B(交错 token)
~0.6B
5 类
是(chunk 160ms)
中/英
~240ms
趋势与选型
纵观五者,可看到一条清晰的演进脉络:从 Smart Turn 纯声学二分类的极简轻量,到 TEN Turn 借大模型语义理解引入 wait 状态,到 Easy Turn用 "ASR+判断" 范式把声学与语言显式融合并扩展到四类状态,再到 FastTurn 以流式 CTC 与声学-语义融合追求低延迟与噪声鲁棒,最后 SoulX-Duplug 把 VAD、ASR、状态预测统一为单一流式模块、状态粒度做到最细。
落到选型上:资源极受限、只需粗粒度端点判断,Smart Turn 足够;已有稳定 ASR、看重语义理解与显式打断处理,可选 TEN Turn;需要细分状态,Easy Turn 是均衡之选;追求低延迟与噪声鲁棒,可借鉴 FastTurn 的流式融合思路;而要最简洁架构与流式低延迟,SoulX-Duplug 更为合适。外挂轮次判断模型的主线概括:
从声学到语义、从粗到细、从非流式到流式、从多模块级联到单一模型统一。
参考来源
Smart Turn|github.com/pipecat-ai/smart-turn
TEN Turn Detection|github.com/TEN-framework/ten-turn-detection
Easy Turn|arXiv:2509.23938 | github.com/ASLP-lab/Easy-Turn
FastTurn|arXiv:2604.01897
SoulX-Duplug|arXiv:2603.14877 | github.com/Soul-AILab/SoulX-Duplug
评论 0
文明发言,友善讨论
发表评论
还没有评论,发表你的看法,来抢沙发~
 语音小管家