
 语音小管家
本文来源:Amphion
如果把语音识别比作一场"听力考试",传统的ASR模型就像只准备了"标准普通话朗读"这一道题的考生。而现实中的语音场景远比“听写”复杂:会议室里多人同时发言、街头嘈杂环境中的通话、医生在病房里的低声交流、客服电话中的专有名词……
这些时候,语音识别需要解决的已经不只是“听见了什么”,还包括:哪些词需要重点关注?应该听哪一个人?在复杂声学场景下,能不能继续听得准?
安菲翁科技团队发布的AmphionASR就是这样一个“懂”场景的,基于大语言模型的个性化语音识别系统。它在垂直领域热词增强识别、目标说话人语音识别、强噪声下语音识别、耳语识别等场景下有优异的表现。
核心能力
AmphionASR 将四类能力融合至同一套系统框架,让语音识别轻松应对不同应用场景。
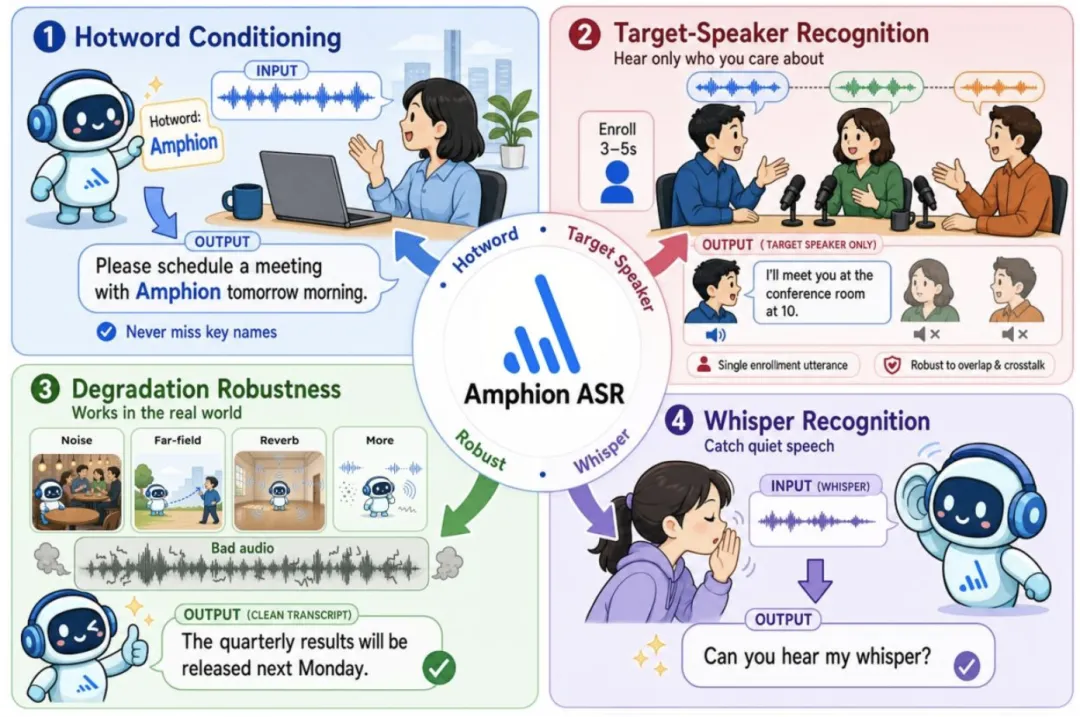
▲AmphionASR 的四种识别能力
1. 行业热词:让生僻名称不再“音对字错”
在医疗、金融、法律、电商等行业中,经常出现人名、品牌名、产品名和专业术语。这些词在通用训练数据中出现频率较低,即使模型听对了发音,也可能选择错误的汉字或英文单词。
AmphionASR可以接收热词列表,并从大规模候选词库中自动筛选与当前语音最相关的词汇。不是把整个词库都塞给模型,而是先挑出最值得关注的候选词。
2. 指定说话人:多人同时讲话,也能只听目标对象
在会议、客服和车载场景中,经常会出现多人同时讲话、相互插话甚至声音重叠的情况。使用AmphionASR时,可以先提供一段 3至5秒的参考声音。系统会根据这段声音识别目标对象,并在混合音频中只转录该说话人的内容。这相当于提前告诉模型:“接下来,请只听这个人。”
3. 退化音频:噪声、远场和混响下继续工作
真实音频往往没有录音棚那么干净。环境噪声、远场拾音、房间混响、设备差异、声音遮挡和传输丢包,都可能破坏关键语音信息。AmphionASR针对多种真实与模拟音频劣化条件进行训练,让模型在复杂声音环境中仍能保持较稳定的识别表现。
4. 耳语识别:声音再轻,也尽量听清
耳语并不是普通语音简单地“调低音量”。耳语通常缺少稳定的声带周期振动,声音较弱,音素边界也更加模糊。主要使用正常语音训练的模型,往往难以准确识别。AmphionASR专门学习了耳语的声学特征,并同时支持中文和英文耳语识别。
模型框架
AmphionASR模型包含了音频编码器(Audio Encoder)、大语言模型内核(Large Language Model,LLM)、检索增强(Retrieval-augmented generation)等模块。
待转录音频首先通过音频编码器编码为embedding,映射到大语言模型的嵌入空间中,同时文本分支对输入指令进行分词处理;在目标说话人识别任务中,可选的注册语音(enrollment speech)会经过同一个音频编码器进行特征提取。随后,LLM 接收由音频表示、文本指令拼接形成的前缀序列,并以自回归方式逐步生成语音转录结果,每个生成的 token 都会作为下一步预测的输入。
此外,AmphionASR还包含一个检索增强模块,该模块利用编码后的语音特征查询热词数据库(hotword database),从大规模候选词汇表中选择 Top-K 个相关热词,并将其作为上下文偏置(Contextual biasing)插入到输入序列中,以提升关键词识别能力。下图中的虚线框和虚线箭头表示在推理阶段的可选模块和路径。
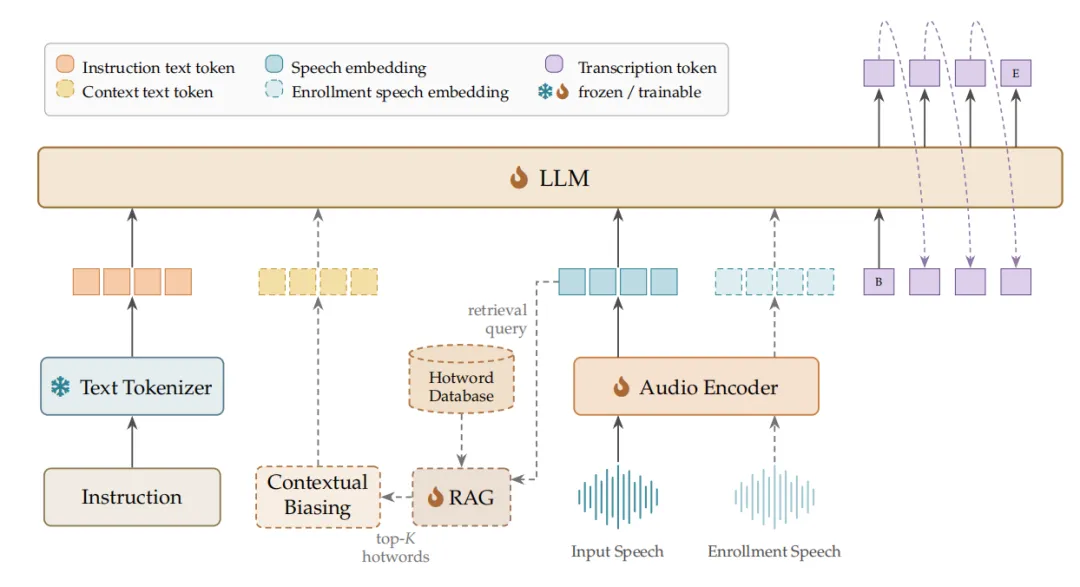
▲AmphionASR 的架构
技术亮点
1.分三阶段训练,让模型“由浅入深”
AmphionASR不是一次性学习所有任务,而是分三个阶段逐步训练:
第一阶段,模型先学习噪声、远场、音频劣化和耳语等非常规声音。
第二阶段,模型加入热词和多人混合语音,学习“应该关注什么词”和“应该听哪一个人”。
第三阶段,再混入通用语音数据,让模型在扩展场景能力的同时,继续保持基础语音识别能力。
2.万级词库中,快速挑出最相关的50个
面对上万个行业热词,全部交给模型既低效,也可能带来干扰。AmphionASR会先对语音和候选词进行匹配,从约一万个词中筛选出最相关的50个,再将它们提供给识别模型。
在中英文大规模热词池测试中,前50个候选词对正确热词的覆盖率均超过94%。相关在线检索实验的额外耗时为毫秒级,让大规模热词检索能够兼顾准确度和处理效率。
3.强化学习“再加练”,专门盯住热词
完成三阶段训练后,AmphionASR还会进行一轮强化学习,模型获得的奖励同时关注两件事:
整句话转录得是否准确
候选热词是否在正确位置出现
这相当于在一般语音识别训练之外,再增加一名专门检查行业术语的“阅卷老师”。
实验结果
1.热词识别:中文实体词错误率相对下降55%
在GigaSpeechBench的12个中文垂直领域和12个英文垂直领域中,加入热词增强后:
中文关键实体词错误率从 23.18%降至10.39%,相对下降 55%
英文关键实体词错误率从 14.78%降至9.35%,相对下降 37%
这里的“关键实体词错误率”,可以简单理解为行业名称、专有名词和重要实体被识别错误的比例,越低越好。
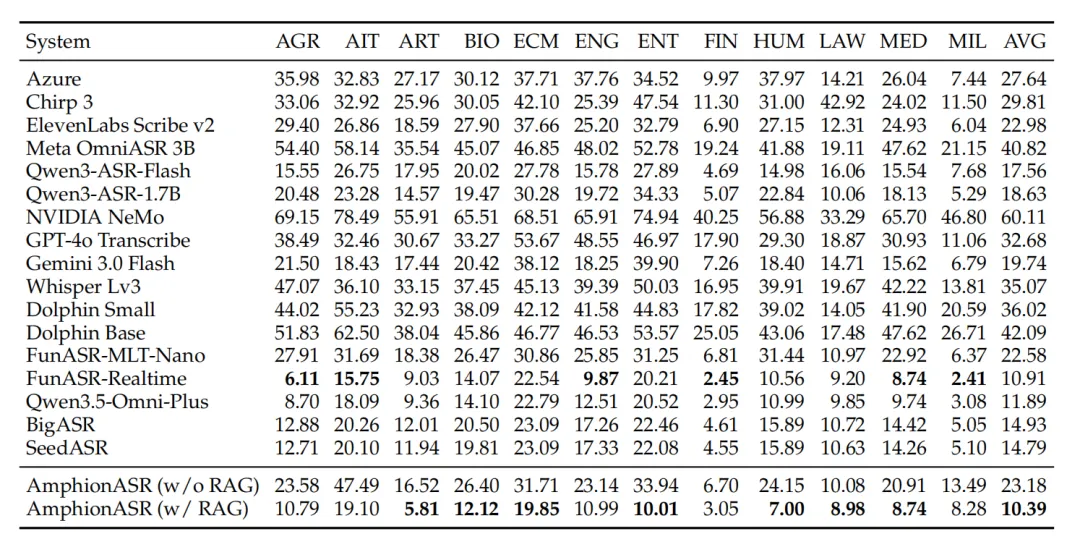
▲GigaSpeechBench垂直领域子集关键实体词错误率(中文)
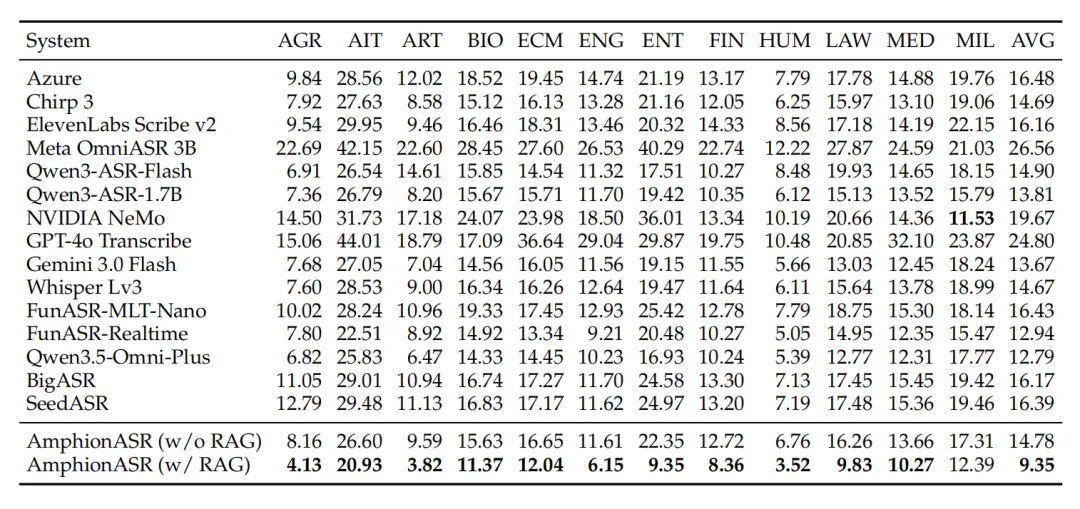
▲GigaSpeechBench垂直领域子集关键实体词错误率(英文)
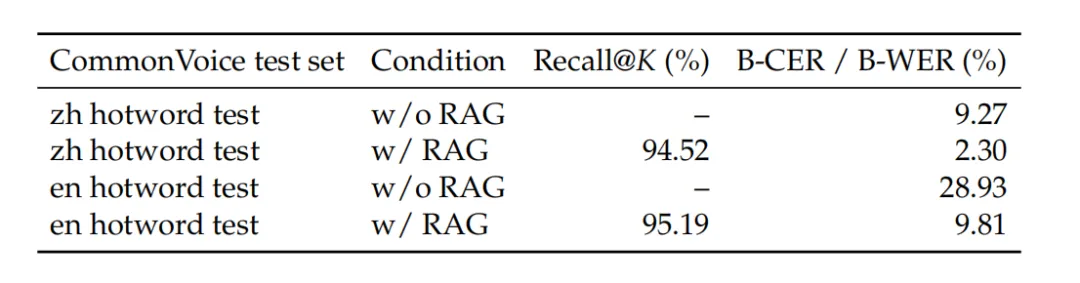
在约一万个候选热词组成的CommonVoice测试词库中,系统对正确热词的前50名覆盖率同样超过94%。中文关键实体错误率从9.27%降至2.30%,英文则从28.93%降至9.81%。
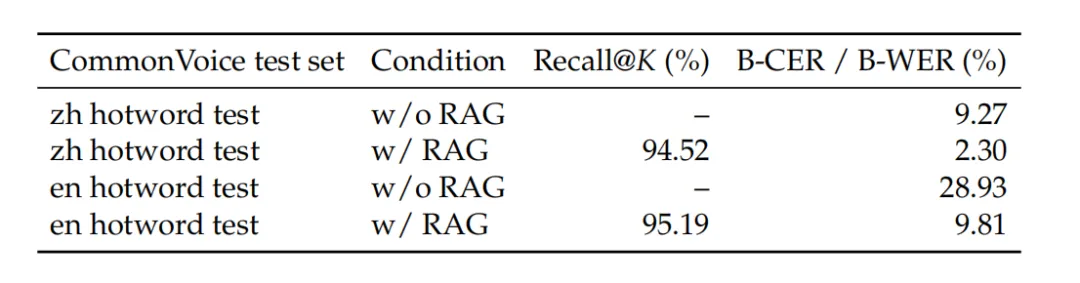
▲CommonVoice热词标注测试集
2.指定说话人:词错误率降至13.02%
在自建的多人重叠语音测试集上,AmphionASR取得 13.02%的词错误率。
作为对比:
Qwen3-Omni:31.91%
Qwen3-ASR-0.6B:84.97%
AmphionASR:13.02%
在目标说话人没有出现、输入内容完全静音的测试条件下,AmphionASR有 93.9%的样本能够正确保持静默,没有强行生成不存在的转录内容。
▲In-house多说话人重叠测试集
3.退化音频:16个子集中拿下8个最优
Voice-in-the-Wild-Bench覆盖噪声、远场、混响、声音遮挡、设备失真和传输丢包等复杂音频条件。在该基准的16个真实与模拟子集中,AmphionASR取得了 4个真实场景最优和4个模拟场景最优。在模拟混合场景中排名第一,在真实混合场景中排名第二。
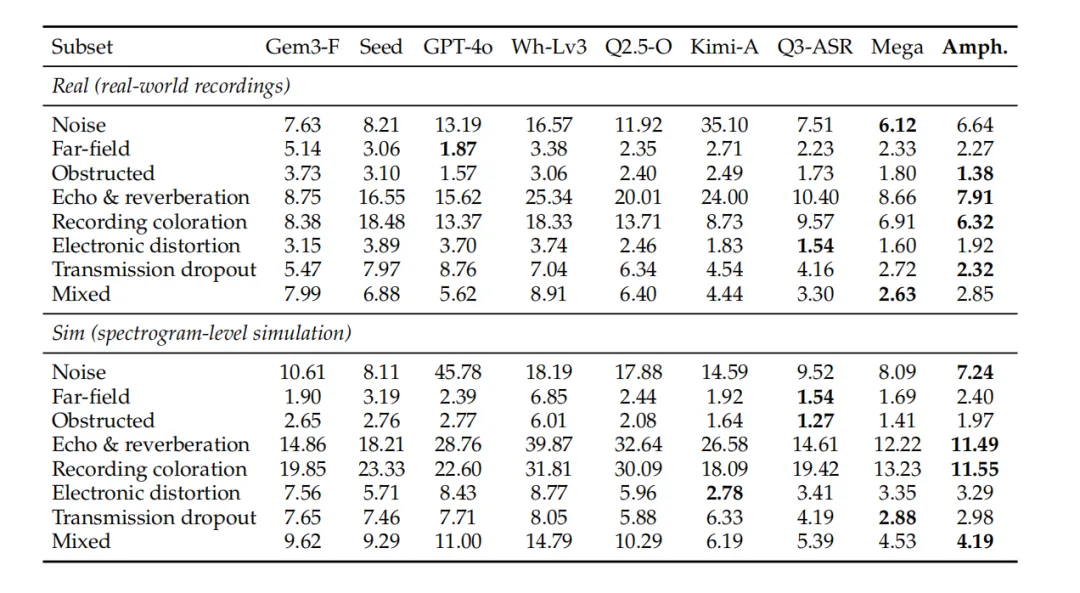
▲Voice-in-the-Wild-Bench测试集
4.耳语识别:中英文两项结果均为最低
在中文耳语测试集wEar上,AmphionASR取得 0.58%字错误率。在英文耳语测试集WTIMIT上,取得 6.11%词错误率。在本文比较的系统中,两项结果均为最低,超过Whisper-large-v3、Kimi-Audio、FireRed-ASR2等模型。
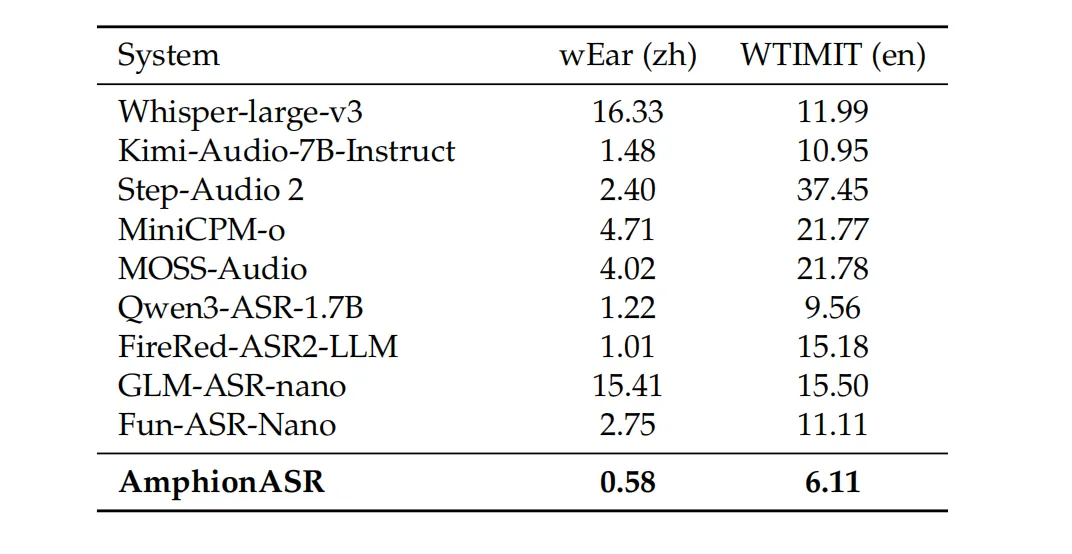
▲wEar和WTIMIT测试集
总 结
AmphionASR希望解决的,不只是一段干净录音的文字转写。它尝试通过同一个模型,统一应对行业热词、多人重叠、复杂声音和耳语等真实场景。这套系统提供了三条新的语音识别思路:
通过条件输入适配不同任务:使用热词列表、参考声音和差异化指令,告诉模型“这一次应该听什么”。
通过检索增强处理万级词库:先从大规模候选词中筛选最相关的热词,再交给识别模型重点关注。
通过分阶段训练扩展场景能力:依次学习复杂声音、任务条件和通用转录,让一个模型承担更多任务。
从行业会议里的专有名词,到多人交谈中的指定对象,再到噪声、远场和耳语:AmphionASR正在让语音识别从“听得清”,继续走向“听得懂、用得稳”。
