
 语音小管家
论文标题:SALMONN-2: Advancing General-Purpose Hearing Abilities with Self-Supervised Representations
作者:Xiaoyu Yang\*, Xuenan Xu\*, Wenyi Yu, Siyin Wang, Changli Tang, Terumi Chiba, Siyuan Hou, Ziyang Zhang, Wen Wu, Baoxiang Li, Guangzhi Sun, Chao Zhang, Philip Woodland (\* 为共同第一作者)
主要单位:清华大学、上海人工智能实验室、剑桥大学
论文链接:https://arxiv.org/abs/2607.17079
开源地址:https://github.com/bytedance/SALMONN/tree/salmonn2
一段声音里,藏着多少信息?除了“说了什么”,我们还能听出是谁在说、情绪如何、周围发生了什么,甚至判断录音是否经过剪辑或伪造。然而,传统人工智能往往让不同模型分别处理语音、环境声音和音乐等元素,难以像人类一样整体理解真实世界中的复杂声音。2023年8月,团队开源首个面向通用音频理解的音频大语言模型 SALMONN(Speech Audio Language Music Open Neural Network),让人工智能从识别某种声音迈向全元素通用音频理解。如今,新一代 SALMONN-2 正式开源,通过全新的通用自监督音频编码器,更完整地捕捉复合音频中的各类元素及其细微线索,进一步拓展了机器理解声音世界的边界。
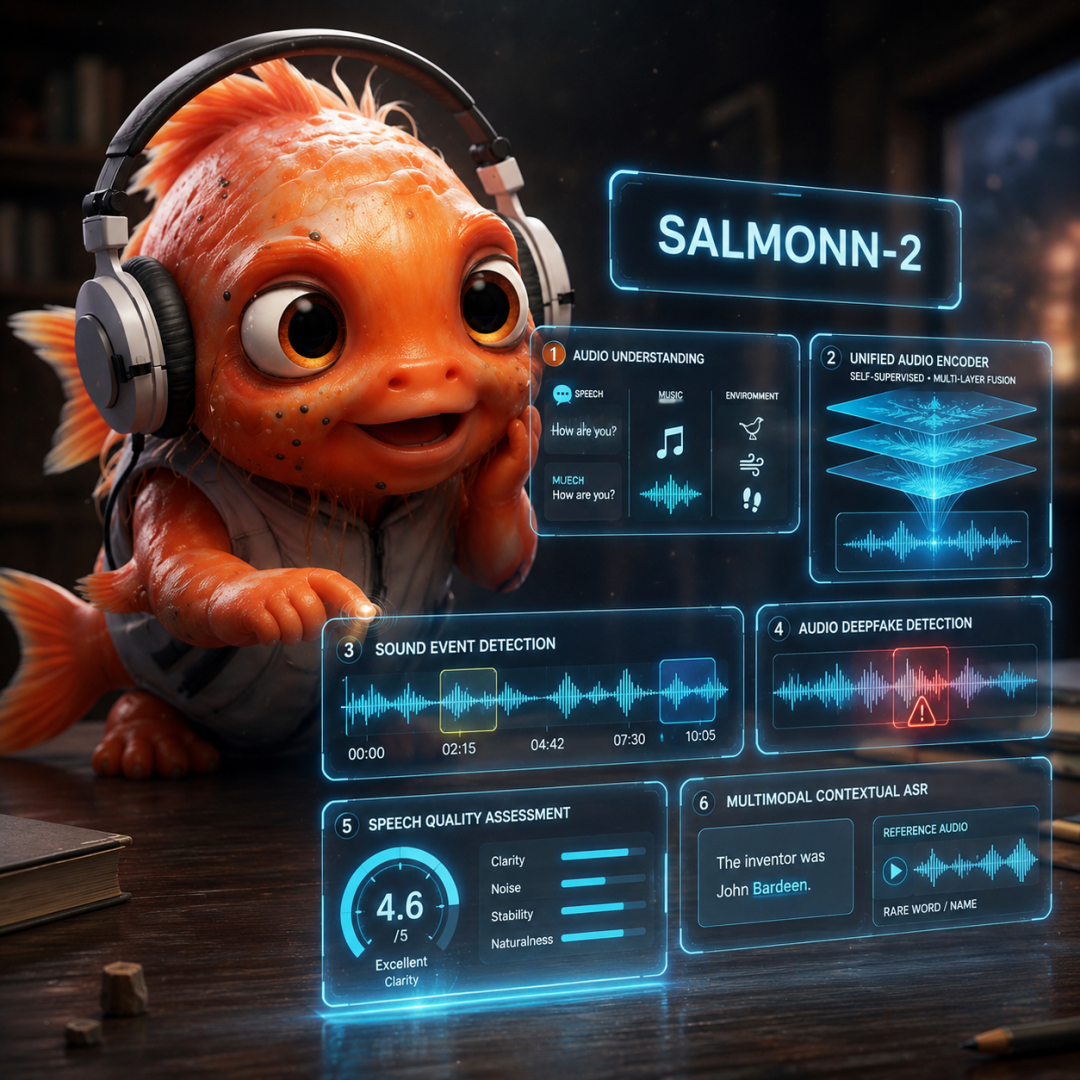
SALMONN-2 以通用自监督音频表征为基础,只依靠不到 2 万小时的音频—文本配对的指令数据完成训练。在 MMAU-Pro、MMAR、MMSU 三个综合音频理解基准上,SALMONN-2 均取得了同规模开源音频大模型中的最佳表现。除此之外,它还解锁了一批过去在通用音频大模型里少见的能力:声音事件检测(Sound Event Detection,SED)、音频深度伪造检测(Audio Deepfake Detection)、语音质量评估(Speech Quality Assessment,SQA),以及多模态上下文语音识别(Multimodal Contextual ASR)。
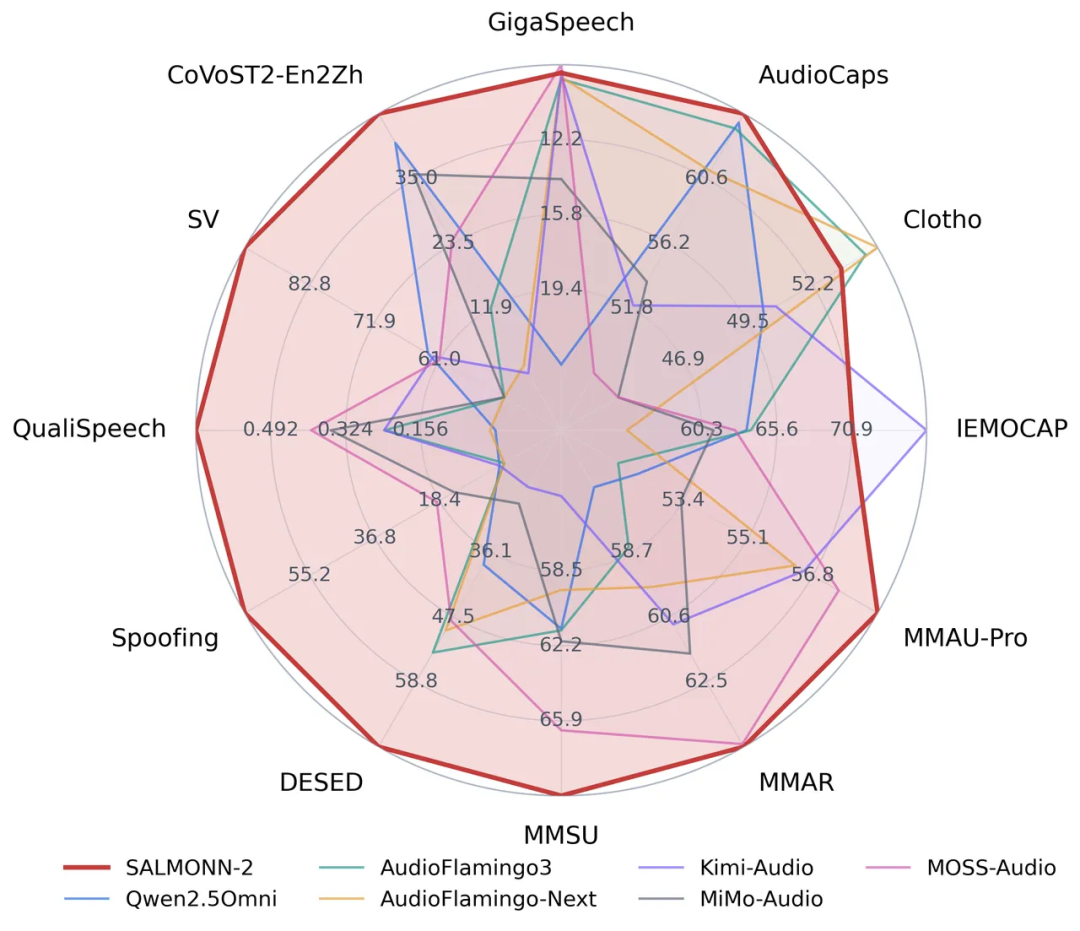
SALMONN-2 在多项基准测试中均取得了显著的领先
👂 从"两只耳朵"到一套统一的声音前端
声音包含的信息维度相当复杂,既有语音内容,也有环境声、音乐、音色、说话人、情绪……。第一代 SALMONN 的做法是采用两个编码器:Whisper 负责语音,BEATs 侧重一般声音事件,各司其职。
两个编码器确实能覆盖更多样的音频,但也同样带来诸多麻烦:它们的特征空间和输出格式各不相同,模型还需要额外设计一个模块,把两边的特征融合到一起,结构和计算都更复杂。
于是后来的不少音频大模型转向了单个统一编码器。常见做法是先用大规模的语音—文本或音频—文本标注数据把编码器训练好,再接到语言模型上。结构确实简化了,但这条路对数据的需求很大——而且编码器最终能学到什么,也受训练任务和标注范围的限制。
这不禁让我们想到:
给音频大模型做一个通用编码器,一定要依赖大量监督数据吗?一个完全不用标注、纯自监督训练出来的编码器,能不能同时把语义、音色、说话人、环境声、音乐都捕捉到?
SALMONN-2 给出的答案是:Yes。 我们发现,通用的音频自监督模型在 ALLM 中有着巨大的潜力。它们通过在大量的无标注数据中进行学习,反而更容易把语义、发音、音色、说话人、声学环境这些信息一并保留下来。SALMONN-2 采用 SPEAR 这个通用的音频自监督模型,仅仅使用不到 2 万小时的音频—文本配对数据,就实现了对语音、声音、音乐等各种声音类型的全面理解。
🔊光有好耳朵还不够,还得听见声音的"不同层次"
换上通用的自监督编码器只是第一步。接下来的问题是:怎么把它学到的信息,尽量完整地交给语言模型。
像 SPEAR 这样的编码器采用的是多层结构,不同层关注的信息并不一样:浅层更多记录局部的声学和发音细节,中间层带着音色、说话人这类信息,深层则积累了更丰富的语义。
传统 ALLM 的做法通常只取编码器最后一层的输出。对 SALMONN-2 来说,最后一层的语义信息的确很丰富,但浅层、中间层里那些声学、发音、音色、说话人的特征,就这样被舍弃了,无法被语言模型所利用——而这些往往正是很多精细任务的关键。
为此,SALMONN-2 设计了 MLF(Multi-Layer Feature Fusion,多层特征融合)。它把 SPEAR 所有层的特征都收集起来,融合之后再映射到语言模型的输入空间。这样一来,编码器学到的各个层次的信息都摆到了语言模型面前,模型处理不同任务时,就能各取所需:
做语音识别,靠的是发音和语言内容;
判断说话人或情绪,需要留住音色和表达方式;
理解环境声音,既要抓住局部的声学事件,也要顾及整体语义;
评估录音质量或识别伪造,那些细微的低层声学特征就格外重要。
在 SALMONN-2 中通用自监督编码器和 MLF 相辅相成:SPEAR 编码器负责获得丰富、通用的多层声音特征,MLF 负责把这些散落在各层的信息高效地送进语言模型。前者让信息足够全面,后者让信息真正被用上。
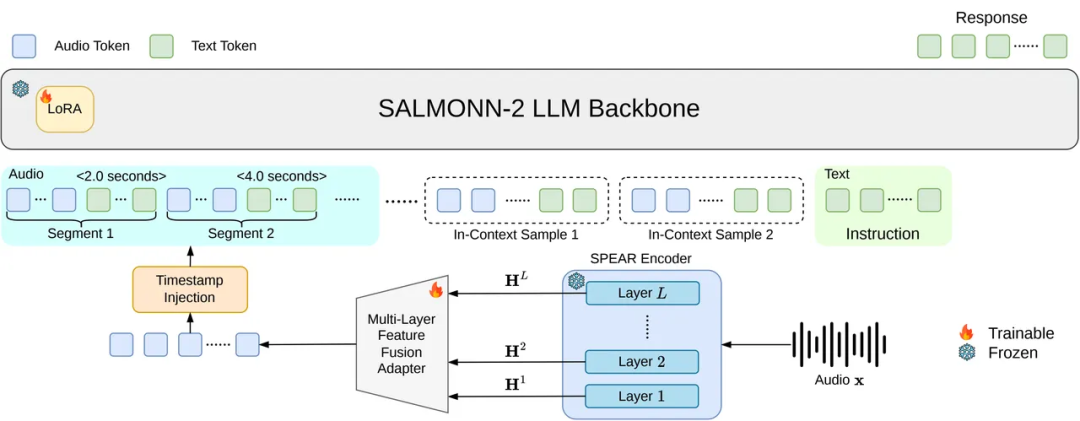
SALMONN-2 由统一 SPEAR 音频编码器、MLF 适配器和语言模型组成,并支持时间戳信息与多模态上下文输入。
🧪 一套通用前端,真能覆盖这么多声音任务吗?
为了回答这个问题,我们在相同的训练条件下,把双编码器、监督式单编码器、通用自监督编码器摆到一起进行对比,所有的模型使用同样的标注数据进行训练;又进一步比较了使用 SPEAR 特征的三种方式:只取最后一层、对各层加权求和、用 MLF 融合所有层。结果如下表所示:
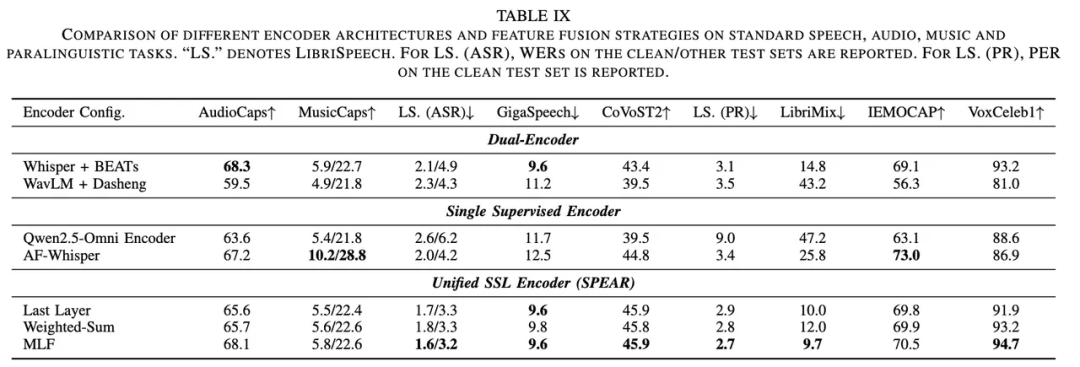
论文 Table IX——ALLM 在不同编码器配置下的表现(所有模型均使用相同的文本基座和训练数据,并且保持编码器冻结)
我们可以得到如下两个比较清晰的结论。
第一,一个通用自监督编码器,足以替代更复杂的双编码器。只用 SPEAR 的 SALMONN-2,整体表现和 Whisper + BEATs 双编码器相当,还在 LibriSpeech 语音识别、音素识别、LibriMix 重叠语音识别这些任务上更好。跟 Qwen2.5-Omni Encoder、AF-Whisper 这类监督式单编码器相比,SPEAR 在语音、一般声音、音乐、副语言之间也更均衡,不会顾此失彼。
第二,拥有多层特征,并不等于就能用好多层特征。同样是 SPEAR,MLF 整体上既好过只取最后一层,也好过简单的加权求和。道理其实不难理解:不同任务需要的信息本就不同,加权求和只学了一组"通用"权重,很难同时照顾好各类任务;而 MLF 把各层信息先保留下来再融合,模型就能根据任务来选择和组合。
也就是说,SALMONN-2 的提升,不只是"更换了一个更强的编码器"这么简单,而是通用自监督表示和多层融合这两者配合出来的结果。
🏆 不到 2 万小时监督数据,做到同规模领先
这几年音频大模型进步很快,但背后的监督数据规模也越来越大——几十万、上百万,甚至千万小时级别的音频—文本配对数据都不少见。
SALMONN-2 用到的监督音频—文本及指令数据,总共约 1.8 万小时(准确说是 18,183 小时),覆盖语音识别、声音描述、音乐理解、情绪识别、说话人、声音事件检测、语音质量评估、伪造检测等多种任务。以 Qwen3-8B 为文本基座的 SALMONN-2,在三个综合音频理解与推理基准上都取得了同规模 ALLM 的 SOTA:
论文 Table VI——SALMONN-2 与其他 ALLM 在 MMAU-pro, MMAR 和 MMSU 上的表现
在相近模型规模的开源音频大模型中,SALMONN-2 三项基准全部第一:MMAU-Pro 58.5、MMAR 64.5、MMSU 69.5。相比此前最强的 MOSS-Audio,分别高出 1.0、0.1、3.1 分;其中更看重语音语义和副语言理解的 MMSU,提升最为明显。SALMONN-2 用明显更少的监督数据,却取得了更强、更均衡的综合表现。
音频大模型要往前走,未必只能依靠不断增加人工标注。"更通用的自监督表示 + 更会用特征的架构"提供了另一条值得探索的路径:它不必取代大规模监督训练,却能成为一种更省数据的新思路。
另外值得一提的是,SALMONN-2 的技术路线展示出优秀的 scale up 潜力:把文本基座从 8B 换成 30B-A3B 后,这三个通用的理解与推理的基准上的表现都能有显著提升。
🔍 从听懂内容,到分析声音本身
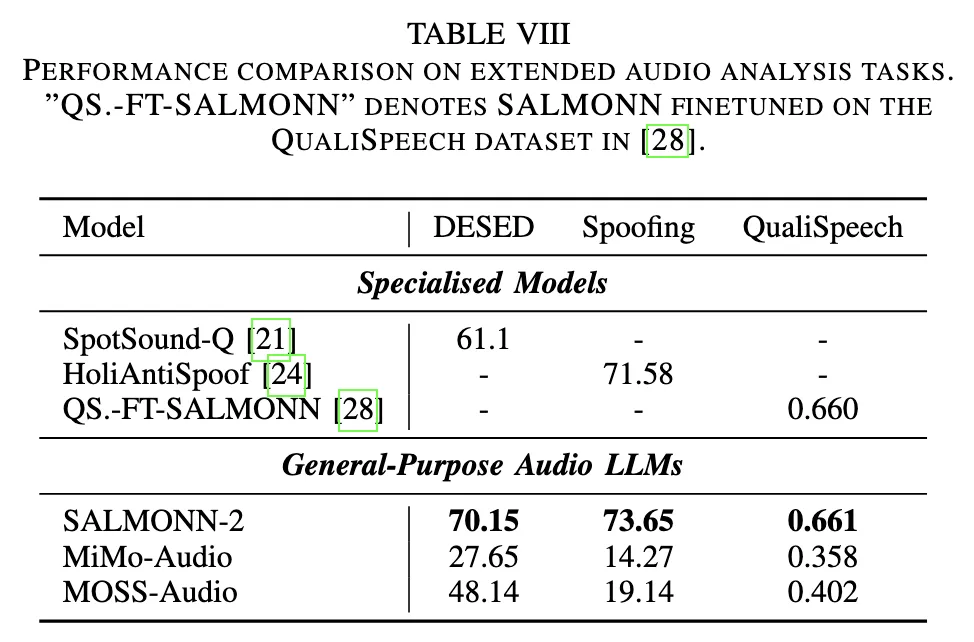
除了常见的语音识别和声音描述,SALMONN-2 还加入了几项过去在通用音频大模型里很少被系统研究的能力:
声音事件检测:不仅判断某种声音是否出现,还能给出它发生的时间段。比如一段家庭环境的录音,狗叫、脚步、关门声分别是什么时候开始、持续了多久。
音频深度伪造检测:不只判断整段语音是否可信,还能定位其中疑似被合成或编辑过的局部片段。
语音质量评估:感知噪声、失真、清晰度这些低层声学特征,给录音质量打分并给出解释。
为了增强模型对时间戳的感知能力,SALMONN-2 直接把时间戳当作自然语言文本插入音频序列,将时间戳信息和音频特征无缝融合模型就学会了在合适的位置给出时间。
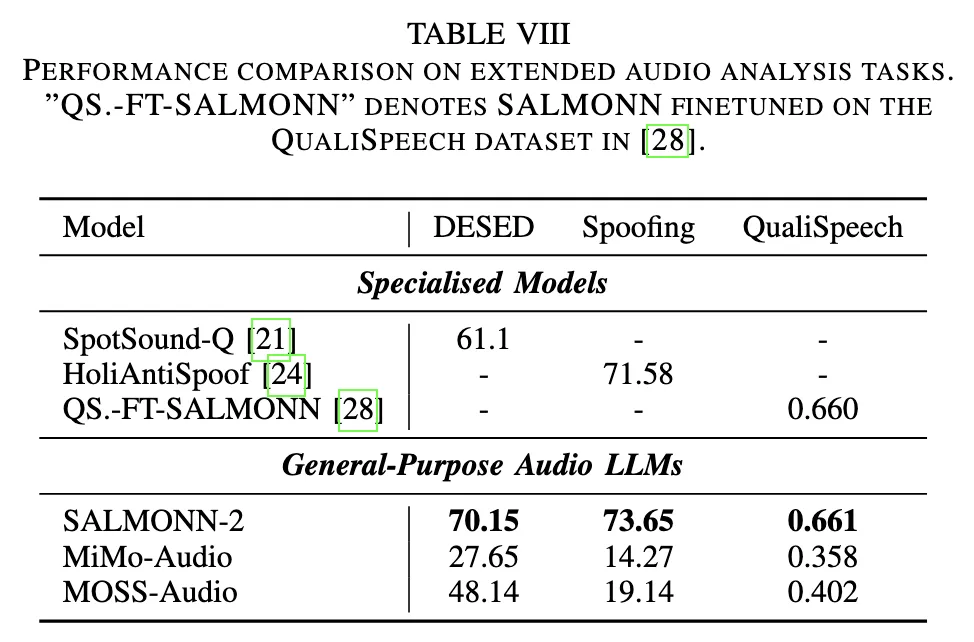
论文 Table VIII——SALMONN-2 与单领域专家模型的效果对比
这张表中的结果表明,在这三项任务上,SALMONN-2 都达到了与各任务对应的专用模型(同样是音频大模型)相近甚至更好的性能。这说明一个统一的通用模型,不只能理解声音的语义内容,也能保留时间位置、真实性、录音质量这些更细的声学信息。
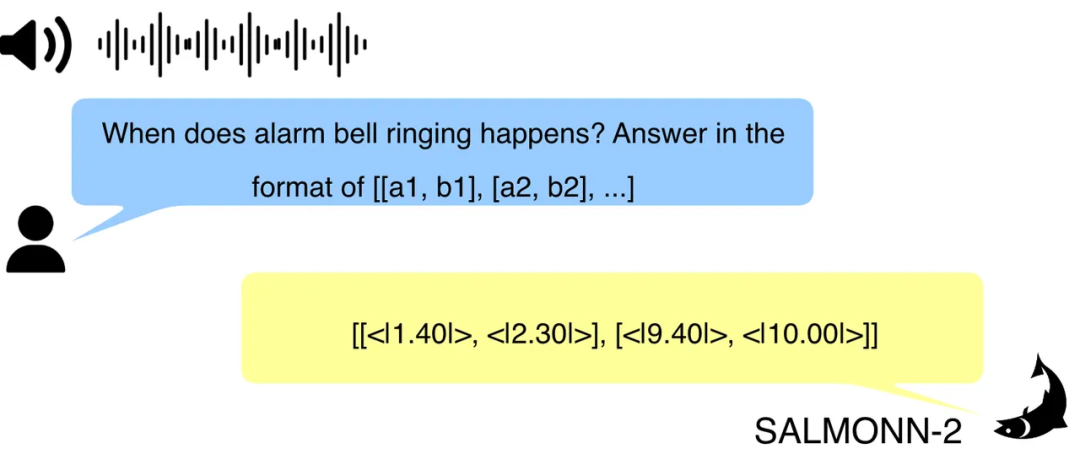
示例:声音事件检测
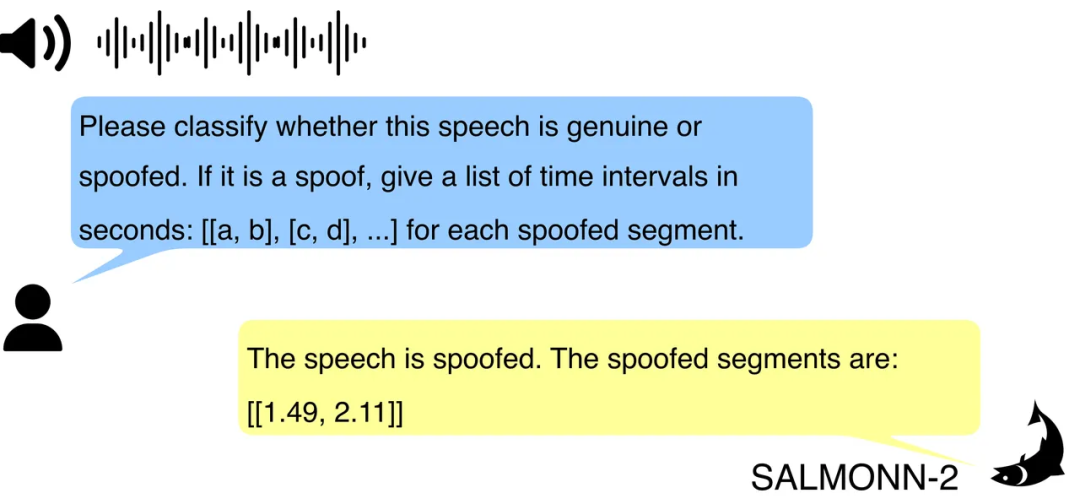
示例:音频伪造检测
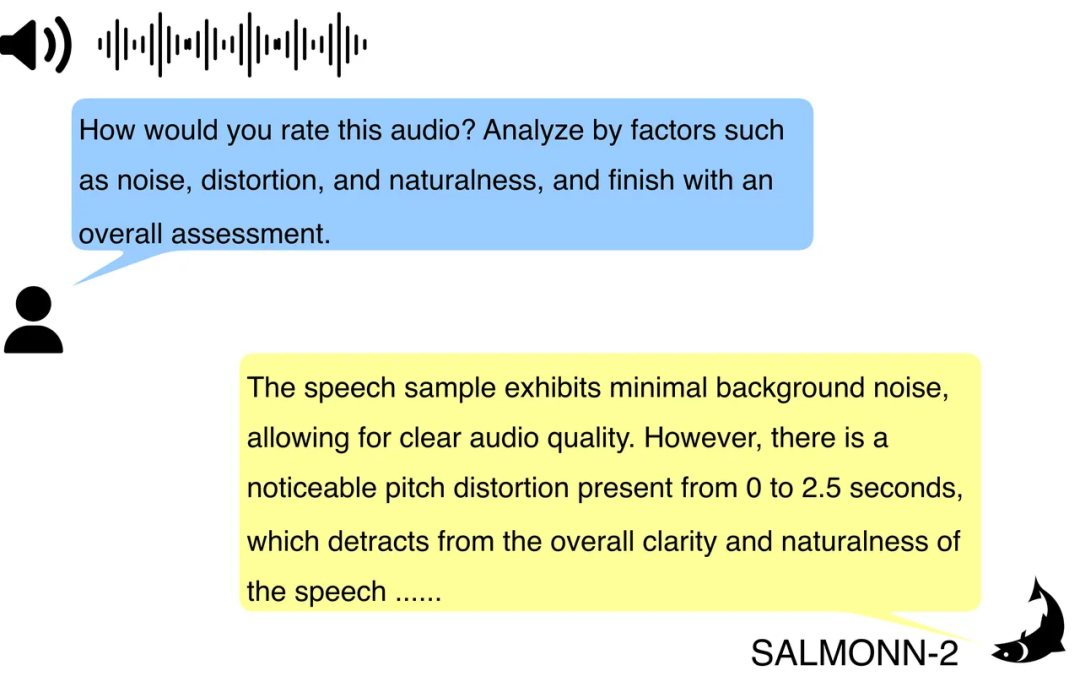
示例:语音质量评估
🗣️ 生僻名字,不只能"写"给模型看,还能"念"给模型听
SALMONN-2 另一个值得说的新能力,是多模态上下文语音识别。
设想一个场景:一段会议录音里出现了一个不常见的英文人名、品牌名或专业术语。我们当然可以提前把这个词的拼写提供给识别系统,但仅有文字往往不够——外语名字拼写不规则,同一个词可能有好几种读法,口音一变,声音听起来又不一样。
人是怎么解决的?很自然:不光把名字写下来,还会跟着念一遍。
SALMONN-2 也可以这样做。在进行语音识别之前,我们可以给模型一组上下文词,并同时附上这些词的参考发音。模型得到的就不再只是一张文字词表,而是一组"发音示例 + 文字拼写"的多模态上下文。
在下面的例子中,语音对应的转录文本里有个生僻词 Howes;输入里除了原始语音,还带上了"howes","wszelaki"的文字拼写和对应的参考发音。SALMONN-2 就能借这些线索,把主录音里的罕见词识别得更准。
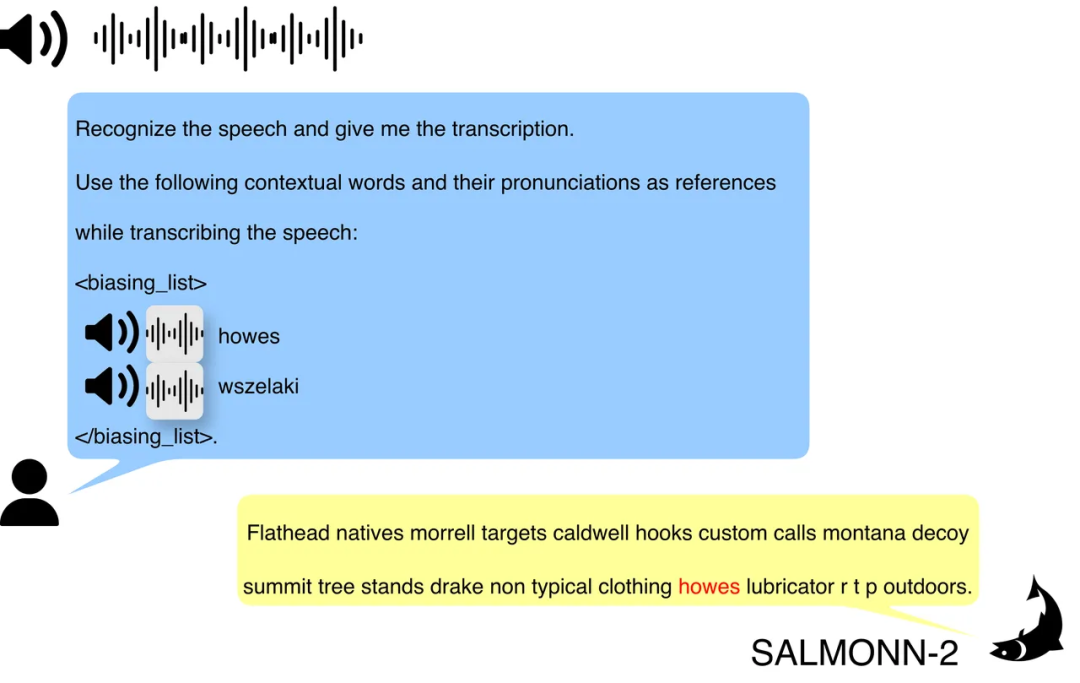
示例:多模态上下文语音识别
不过,SALMONN-2 能用好这种"文字 + 发音"的上下文,其实并非理所当然。文本大模型擅长上下文学习(In-Context Learning,ICL),给几个示例就能总结出规律;顺着这个直觉,很容易以为音频大模型天然也会。但事实并非如此——多模态上下文学习在 ALLM 中并不会自动涌现。
未经专门训练的模型,往往分不清几段音频之间的关系:上下文里干扰项一多,识别性能不升反降。以词表长度 100 为例,MOSS-Audio 的词错误率飙到 65.5%,未经 MICL 训练的 SALMONN-2 也升到 57.3%。
为此,SALMONN-2 专门做了一轮多模态上下文学习(MICL)训练:训练时混入大量干扰词、随机移除部分正确条目,避免模型照搬词表,并同时覆盖"纯文字"和"文字 + 发音"两种上下文。
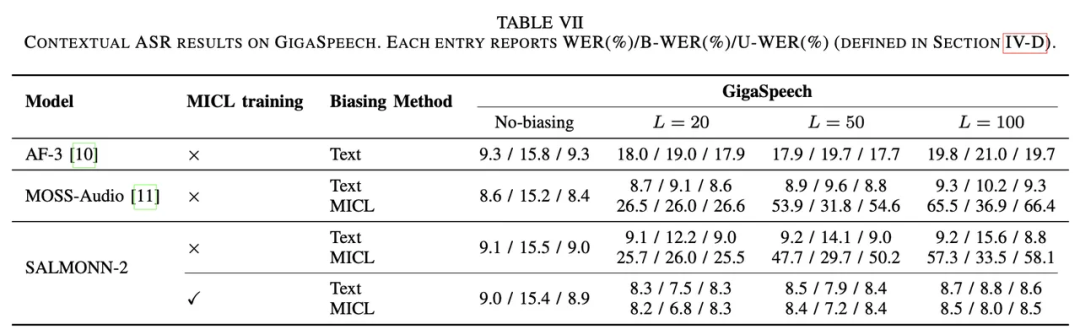
论文 Table VII——Contextual ASR 完整结果,包括 No-biasing、Text Biasing 和 MICL,以及 20、50、100 三个候选词表长度
训练之后,情况明显改观:即便词表里塞进 100 个候选词,SALMONN-2 的整体词错误率仍稳定在 8.5% 左右,没有被干扰项带偏;而且比起只给文字,额外的参考发音还能把生僻词认得更准。(表中 WER 为整体词错误率,B-WER 专门衡量需要上下文帮助的关键词。)
🌱 不止于上下文语音识别:MICL 的零样本迁移
那么,SALMONN-2 学到的究竟是"上下文语音识别"这一个具体任务,还是一种更通用的"从音频上下文中学习"的能力?我们发现是后者:这种多模态上下文学习(MICL)能力,可以零样本(zero-shot)泛化到训练时从未见过的音频分类任务上。无需任何针对性训练,只要在推理时给模型每个类别几个"音频示例 + 对应标签",它就能据此对一段新的音频完成分类。
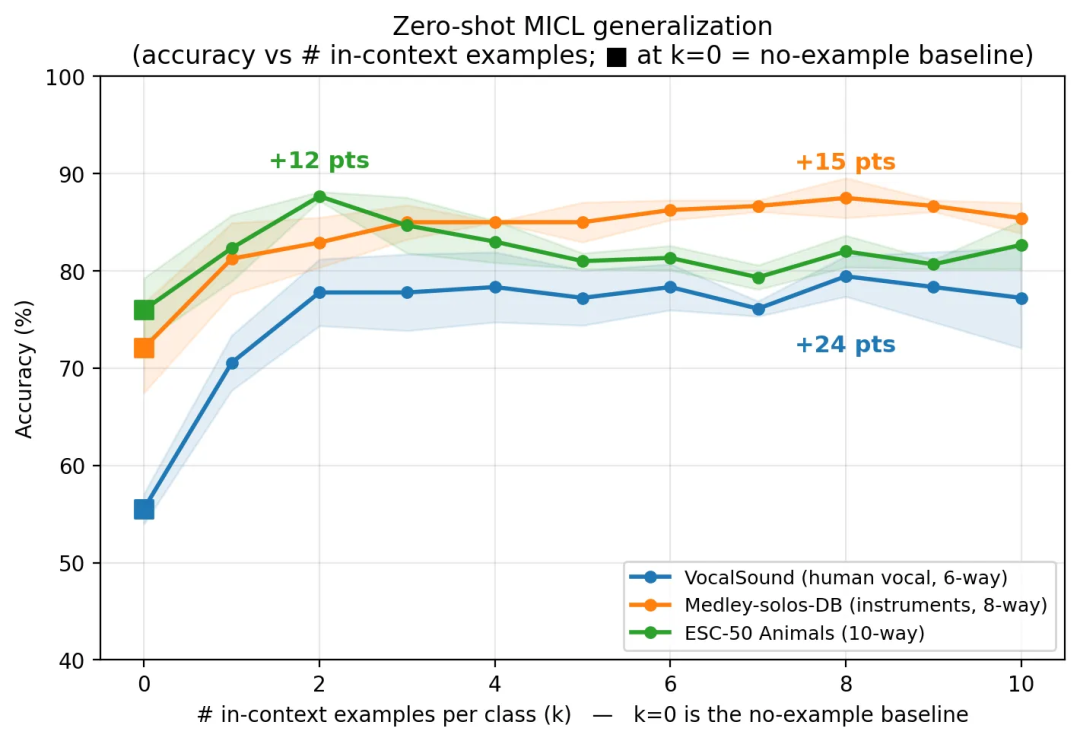
SALMONN-2 的 MICL 能力可零样本迁移到全新的音频分类任务:随上下文示例数量 k 增加,VocalSound、Medley-solos-DB、ESC-50 Animals 的准确率均较无示例基线明显提升
我们在三个差异很大的任务上进行了验证——VocalSound(咳嗽、笑声、喷嚏等人声非言语声音,6 类)、Medley-solos-DB(真实乐器演奏识别,8 类)、以及 ESC-50 Animals(动物叫声,10 类)。如下图所示,随着上下文中示例数量 k 的增加,三个任务的准确率都快速上升并保持稳定;值得注意的是,即便模型对这些任务本就有不错的零样本表现,额外的音频示例依然能带来明显提升,分别约 +24/+15/+12 个百分点。这表明,MICL 训练赋予 SALMONN-2 的是一种可迁移的、通用的上下文学习能力,而不只是"上下文语音识别"这一个任务本身。
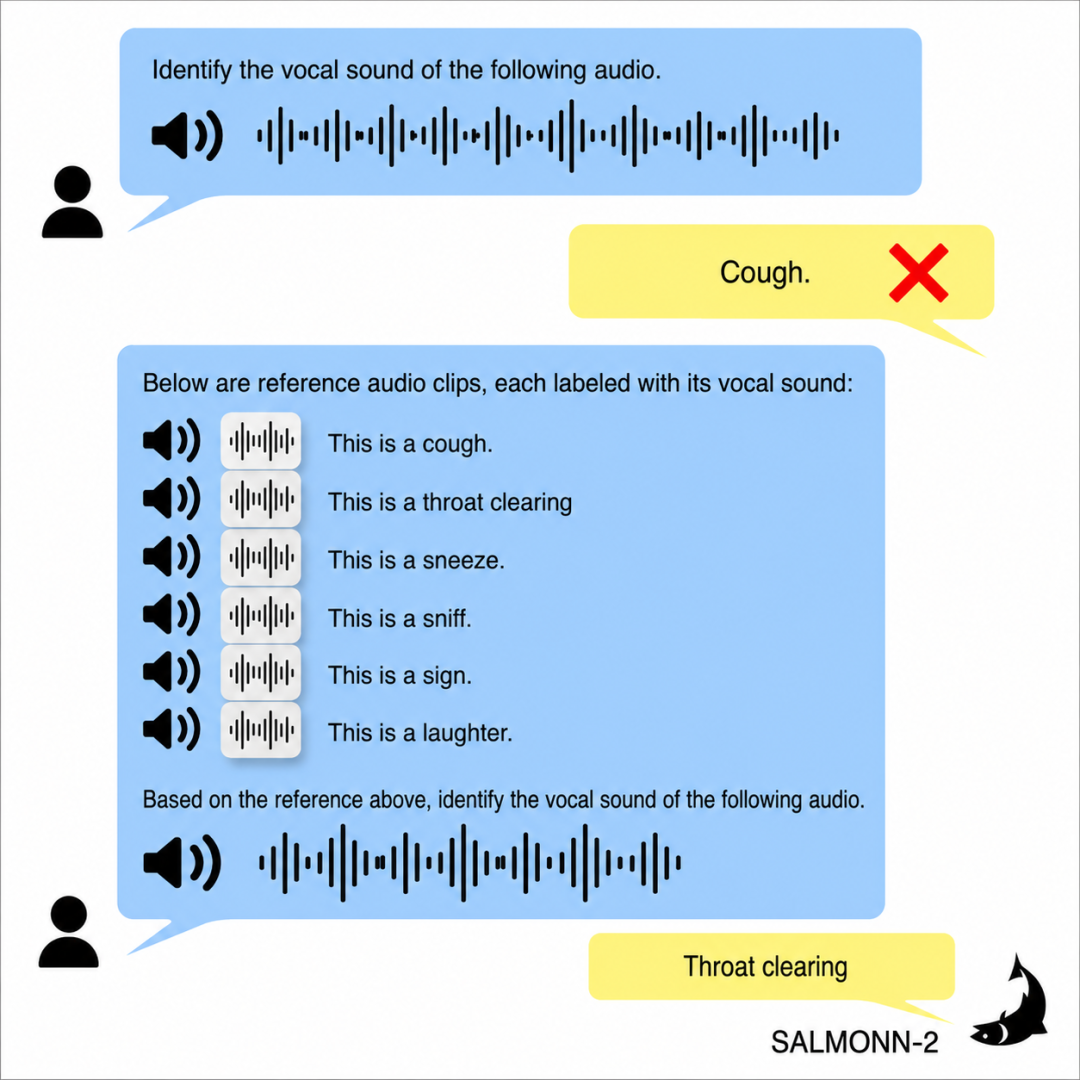
示例:MICL 的零样本迁移。若不提供任何示例,模型会把这段音频误判为"cough(咳嗽)";而在给出每类声音各一个"音频示例 + 标签"之后,模型便能正确识别出它其实是与咳嗽十分相近的"throat clearing(清嗓)
🚀 总结与展望:从 SALMONN 到 SALMONN-2
SALMONN-2 关注的并不是在现有基准上取得最高的分数,而是想回答几个关于搭建 ALLM 的根本问题:
一个通用的自监督音频编码器,能不能替代更复杂的多编码器架构?
编码器不同层次的表示,怎么才能被文本语言模型真正用起来?
能不能少依赖一点超大规模的监督音频—文本数据?
音频大模型能不能读懂时间、录音质量、局部伪造这些更细的信息?
文本大模型里的上下文学习,怎么才能真正延伸到"声音 + 文字"共同构成的多模态上下文?
SALMONN-2 证明了:一个统一的通用自监督编码器加上 MLF,就能组成一套简单又有效的声音感知方案;再配上有针对性的训练,还能把时间定位、精细声音分析、多模态上下文学习这些能力一并拓展开。
从 SALMONN 到 SALMONN-2,我们想推动音频大模型,从"能接收声音",走向真正通用、细致、又善于利用上下文的机器听觉。
🔗 开源地址
论文(arXiv):https://arxiv.org/abs/2607.17079
GitHub 代码及使用说明:https://github.com/bytedance/SALMONN/tree/salmonn2
Hugging Face 模型:https://huggingface.co/marcoyang/SALMONN-2-8B
Hugging Face 在线 Demo:https://huggingface.co/spaces/wsntxxn/SALMONN-2
我们提供了模型的推理与微调示例,模型也已在 Hugging Face 上开源,欢迎试用。也欢迎大家一起探索更通用、更高效的音频大模型。
