
 语音小管家
传统的自动语音识别系统主要遵循"单次通行(Single-pass)"的转录范式,将识别过程视为从音频到文字的开环映射任务。这种范式在交互逻辑上缺乏"反馈-修复"机制,在评价维度上无法区分关键语义错误与无关紧要的字面偏差。本文解读的论文 Towards Human-Like Interactive Speech Recognition With Agentic Correction and Semantic Evaluation 将 ASR 从"静态转录工具"重塑为"动态交互智能体",提出 Agentic ASR 闭环框架与句级语义错误率 S²ER 指标,在多语种、命名实体密集与语码转换等多类基准上实现了持续的语义修复增益。
▎核心动机
传统的自动语音识别系统主要遵循“单次通行(Single-pass)”的转录范式。在这种模式下,系统将语音输入视为独立的声学信号,通过单个语音识别模型直接将其映射为文本序列。其核心设计目标是在单一的解码过程中实现最高的字面还原度,将识别过程视为一个从音频到文字的开环映射任务。
传统范式存在两个显著的缺陷:交互逻辑的断裂与评价维度的偏离。首先,在交互逻辑上,它是一个开环系统,缺乏像人类沟通那样的“反馈-修复”机制。一旦系统在识别关键信息时出现错误,后续用户的纠正性语音往往会被系统识别为一段孤立的新指令,而无法追溯并修正之前的错误状态。其次,在评价维度上,传统的词错误率(WER)或字错误率(CER)给予所有词汇相同的权重,无法区分无关痛痒的语气词丢失与足以导致任务失败的关键语义错误(如专有名词、指令意图的误植)。
这篇论文的核心动机在于将 ASR 从“静态转录工具”重塑为“动态交互智能体”。
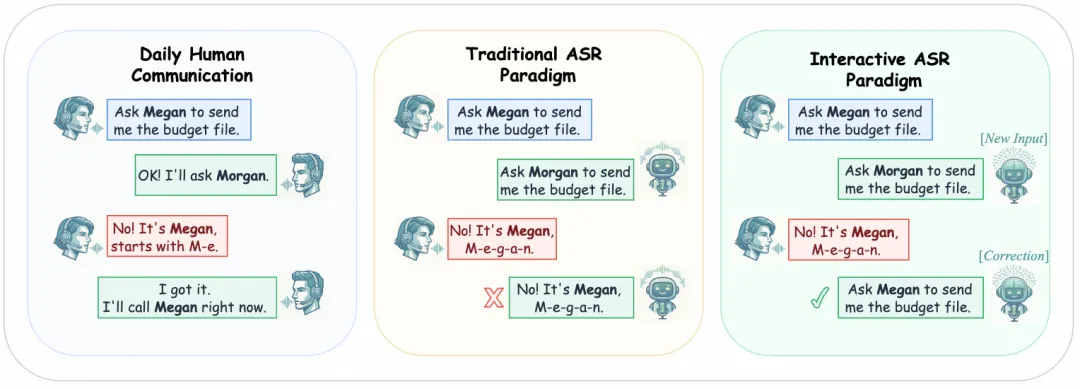
(图1:日常人类沟通、传统 ASR 范式与 Interactive ASR 范式三种语音识别范式的对比)
(图1:日常人类沟通、传统 ASR 范式与 Interactive ASR 范式三种语音识别范式的对比)
图 1 展示了三种范式的直观对比。左侧为日常人类沟通场景:当对方将"Megan"误听为"Morgan"时,说话人通过纠正("No! It's Megan, starts with M-e.")即可让对方理解并修正。传统 ASR 范式实现的是“静态映射”关系,即输入一段音频,输出一段文本,每一段都是孤立的。当用户进行纠错时,系统只是机械地识别出这句话,并将其视为“新输入”,而无法修改之前的错误。
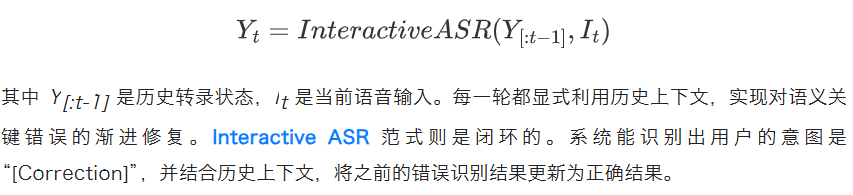
将传统 ASR 重新定义为有状态的多轮修正过程,将“静态映射”转变为“动态过程”:Interactive Speech Recognition (交互式语音识别,Interactive ASR)的系统映射关系定义为:
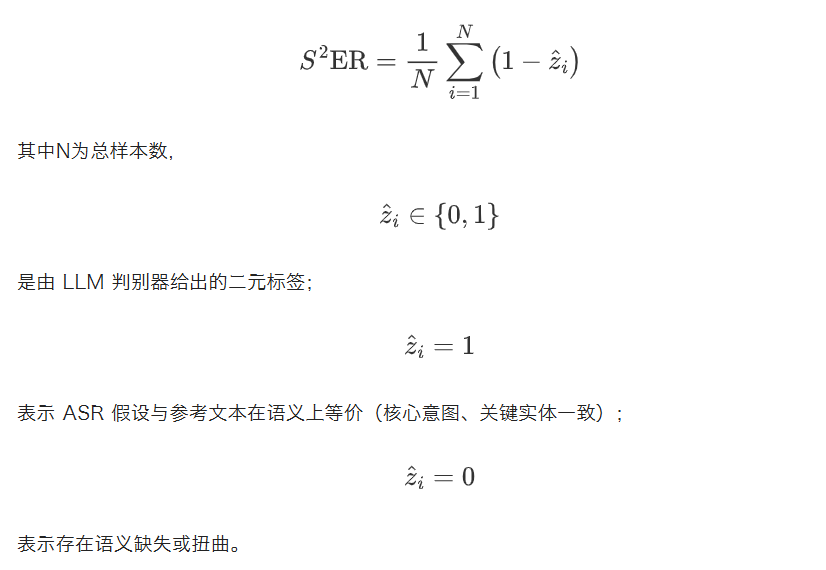
评价指标定义
传统语音识别系统一般采用词错误率(Word Error Rate, WER)或字错误率(Character Error Rate, CER)作为评价指标。它给予所有词汇相同的权重。该指标存在以下两类问题:
非关键错误受罚过重: 丢掉一个不影响意思的语气词(如“嗯”、“那个”)会导致 WER 升高。
语义错误受罚过轻: 识别错一个关键实体(如“王经理”识别成“黄经理”)在 WER 中仅占 1 个词的错误,但在实际交互中会导致任务彻底失败。
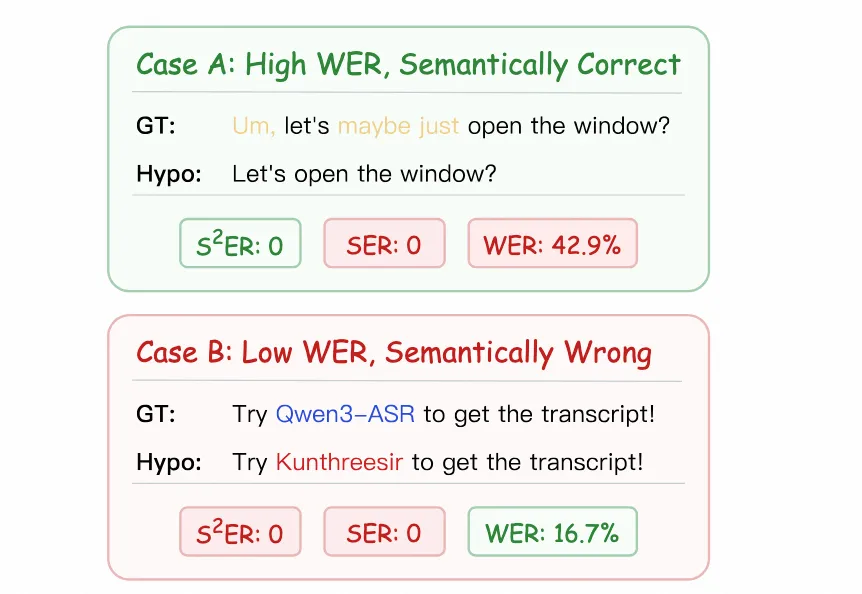
(图2:传统 WER 指标与语义级指标的对比案例)
(图2:传统 WER 指标与语义级指标的对比案例)
以图中的两个案例为例,尽管两者都涉及语义信息的变动,但其 WER 指标却呈现出显著差异。这种现象深刻揭示了传统词错误率(WER)指标在评估 ASR 性能时的核心局限性:即它仅能反映字面序列的重合度,却无法精准衡量语音转写在功能性与语义完整性上的真实质量。
针对上述 Interactive ASR 问题,该篇论文提出了 Agentic ASR 框架;该框架通过引入 LLM 智能体来实现上述交互任务,是一个包含“语义纠错、意图路由、基于推理的编辑”的闭环系统。
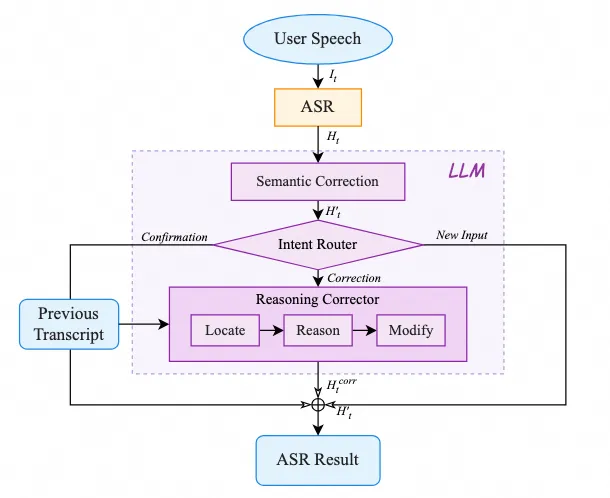
(图3:Agentic ASR 框架流程图)
(图3:Agentic ASR 框架流程图)
为了完成交互式识别任务,Agentic ASR是一种闭环架构,它将传统 ASR 的声学转录能力与大语言模型(LLM)的推理和编辑能力相结合。其核心思路是将 ASR 视为一个有状态的、可迭代更新的智能体任务,而不是一次性的转换。
整体框架设计了三个特定阶段,每个阶段都在解决交互中的核心问题。
语义纠错 (Semantic Correction):解决交互中“用户纠错的话本身也可能被识别错”的问题,利用上下文还原用户的纠错指令。
意图路由 (Intent Routing): 解决交互中的“身份识别”问题,判断用户是在说新内容(New Input)、确认结果(Confirmation)还是在纠错(Correction)。
推理编辑 (Reasoning-based Editing): 解决“如何改”的问题,通过 定位 (Locate) -> 推理 (Reason) -> 修改 (Modify) 的过程,精准更新转写状态。
1. 语义纠错阶段 (Semantic Correction)
预处理环节,旨在解决“纠错语音本身可能被识别错”的问题。
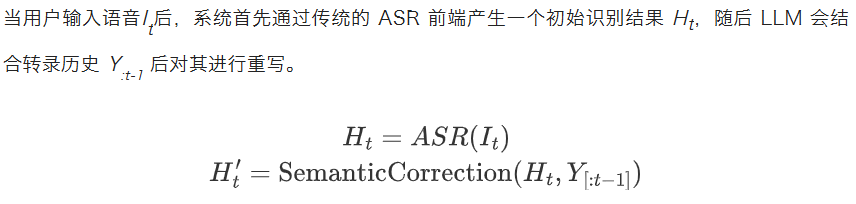
用户在纠错时往往口语化严重或带有背景噪音,导致 ASR 识别出的指令可能语义不通。此阶段利用 LLM 的语言模型能力,将模糊的识别结果转化为显式且可执行的指令,重写为一段语义清晰、逻辑自洽的文本,确保后续步骤处理的是准确的意图。
2. 意图路由阶段 (Intent Router)
框架的决策中心,负责判断用户的交互类型。LLM 将纠错后的用户指令 H't 分类为三种意图之一:
Confirmation(确认): 用户表示认可(如“对的”),系统维持原状态。
New Input(新输入): 用户在说新的话,系统直接采用新识别的内容。
Correction(纠错): 用户要求修改之前的错误,系统进入下一阶段。
3. 基于推理的纠错阶段 (Reasoning-based Correction)
这是 Agentic ASR 最具特色的部分。当判定为纠错意图时,调用大模型采用如下公式进行纠错操作:
LLM 不会盲目地重写整个句子,Pcorr 遵循一个结构化的 Locate–Reason–Modify(定位-推理-修改)流水线:
定位 (Locate): 在历史转写文本中精准锁定需要修改的词。
推理 (Reason): 结合用户的纠错指令(如拼写提示“M-e-g-a-n”)和上下文,推断出正确的表达方式。
修改 (Modify): 执行局部的文本替换,生成更新后的转写状态 Htcorr。
▎实验结果
实验库构建
为系统评估 Agentic ASR 在交互过程中的语义修复能力,该论文围绕多语开放域、命名实体密集与中英语码转换三类场景组织基准,并配套构建自动生成多轮纠错对话的交互模拟系统;评估以句级语义错误率为主指标,并辅以传统 token 级指标作对照。
数据与基准。基准覆盖三类能力维度:多语开放域(英文 GigaSpeech Test、中文 WenetSpeech Test_Net)、命名实体密集(AISHELL-NER Dev† 与 Test†,由 AISHELL-1 根据 NER 标注筛选出含命名实体的语句而成)、中英语码转换(ASRU2019 Test、CS-Dialogue Test†,由 CS-Dialogue 语料中挑选语码转换语句而成)。其中带†的子集为作者自建。
交互模拟系统。鲜有可规模采集的真实多轮纠错语音,作者构建交互模拟系统自动生成多轮纠错对话;其中纠错语音由 Index-TTS-1.5 合成,并以每条样本自身的参考音频作为声学提示,以保证说话人一致。
评价指标。主指标为句级语义错误率 S²ER;同时报告 token 级指标作对照:英文用 WER、中文用 CER、命名实体子集用 NER、语码转换基准用 MER。S²ER 由 LLM 判别器判定语义是否等价,采用三轮双向投票协议(每轮以正、反两种输入顺序各判一次,两次一致方计为该轮正例,最终按三轮多数表决)以降低判别偏置。
人机对齐验证集。为验证 S²ER 判别器的可信度,作者从 GigaSpeech、WenetSpeech、ASRU2019 各取 40 句,共计 120 句,由 25 名非专家与 5 名专家依据二元协议(1 表示语义一致、0 表示不一致)标注,作为判别器与人类判断一致性的参照。
实现细节。ASR 前端默认采用 Qwen3-ASR-1.7B;推理、纠错生成与语义判别统一由 Qwen3-32B 承担;消融实验中另用 FireRedASR2-LLM-8.3B、Whisper 作为替换骨干,并用 Qwen3-8B 替换推理器以考察规模影响。
实验结果展示
下面依次从主实验(各基准 S²ER 随交互轮次的变化)、语义指标与传统指标的对照、语义判别器与人类判断的一致性,以及 ASR 前端与 LLM 推理器的消融四个角度呈现结果。表中 S²ER 、WER、CER、NER、MER 均为百分数,数值越低越好。
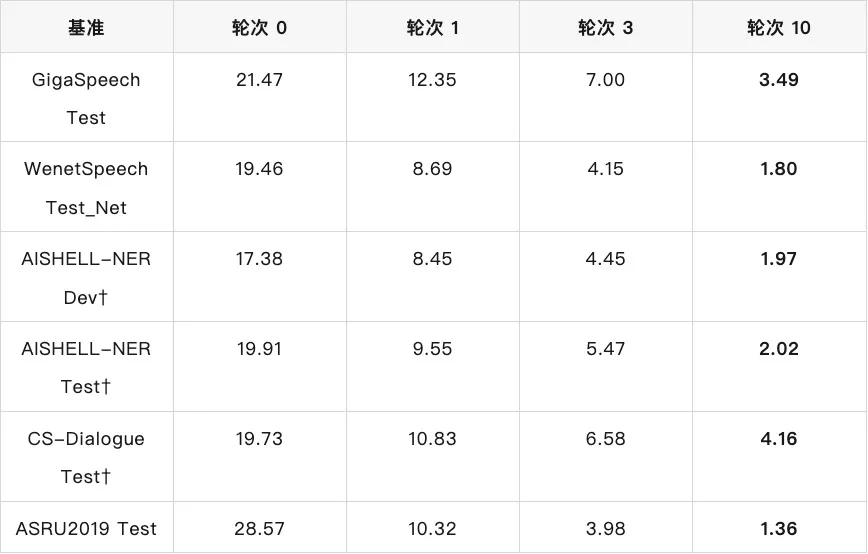
(表 1:主实验:各基准句级语义错误率 S²ER 随交互轮次的变化(%,越低越好;轮次 10 为收敛后结果))
(表 1:主实验:各基准句级语义错误率 S²ER 随交互轮次的变化(%,越低越好;轮次 10 为收敛后结果))
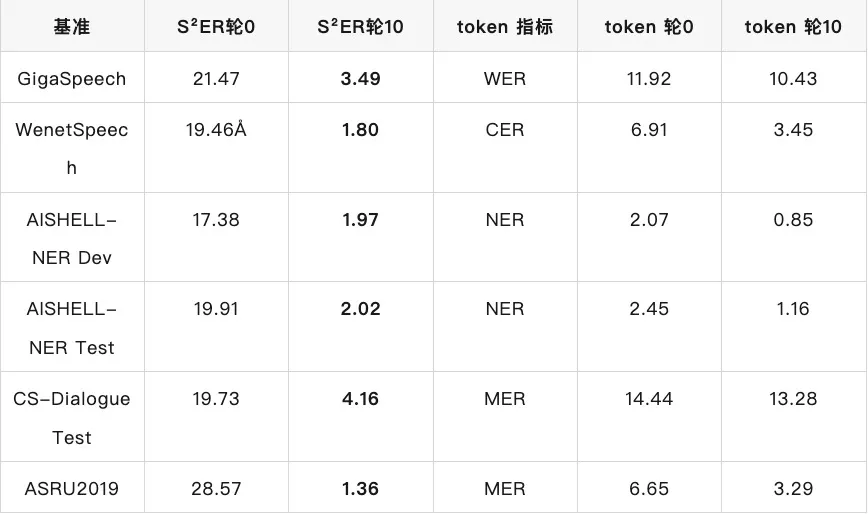
(表 2:语义指标与传统 token 级指标对照(轮次 0 → 轮次 10,%;token 指标英文为 WER、中文为 CER、实体子集为 NER、语码转换为 MER)
(表3:语义判别器与人类判断的一致性(与人工参照的,值越高越一致;最后一列为判别器相对专家的提升))
(表 2:语义指标与传统 token 级指标对照(轮次 0 → 轮次 10,%;token 指标英文为 WER、中文为 CER、实体子集为 NER、语码转换为 MER)
(表3:语义判别器与人类判断的一致性(与人工参照的,值越高越一致;最后一列为判别器相对专家的提升))
(表4:ASR 前端骨干消融(AISHELL-NER Test† 上收敛后 S²ER %,越低越好))
(表4:ASR 前端骨干消融(AISHELL-NER Test† 上收敛后 S²ER %,越低越好))
(表5:LLM 推理器规模消融(收敛后 S²ER,%,越低越好;末列为 Qwen3-8B 相对 Qwen3-32B 的差值))
(表5:LLM 推理器规模消融(收敛后 S²ER,%,越低越好;末列为 Qwen3-8B 相对 Qwen3-32B 的差值))
实验结果分析
主实验(对应表 1)。交互修复带来单调且显著的语义增益:随交互轮次增加,各基准 S²ER 持续下降,如 GigaSpeech 由 21.47% 降至 3.49%、ASRU2019 由 28.57% 降至 1.36%、WenetSpeech 由 19.46% 降至 1.80%。增益主要集中在前若干轮(轮次 0→3 降幅最大),此后趋于收敛,表明少数几轮交互即可修复绝大多数语义关键错误。
语义与传统指标对比(对应表 2)。S²ER的降幅远大于 token 级指标:以 GigaSpeech 为例,WER 仅由 11.92% 微降至 10.43%,而S²ER由 21.47% 降至 3.49%;WenetSpeech、ASRU2019 亦呈现同样规律。这表明交互修复主要作用于影响语义的关键错误(专有名词、意图),而这类错误恰是 token 级指标难以充分刻画的,印证了S²ER作为面向智能体场景评价指标的必要性。
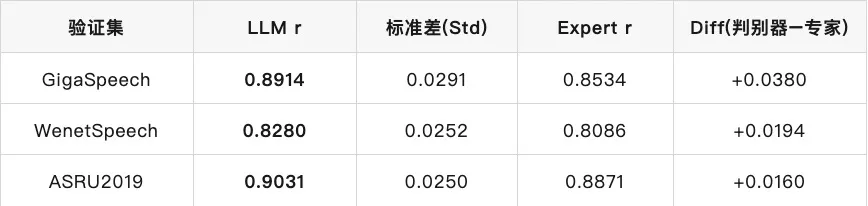
人机对齐(对应表 3)。LLM 判别器与人类参照的 Pearson 相关系数在三个验证集上均处于高位(0.8280–0.9031),且一致性稳定超过专家标注(提升 +0.0160~+0.0380),标准差均在 0.03 以内。这说明基于三轮双向投票的语义判别器可靠且稳定,足以作为S²ER的自动裁判。
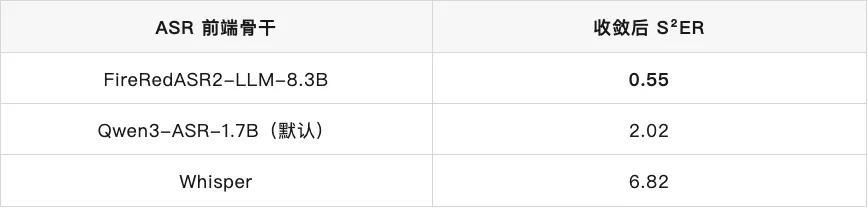
ASR 前端骨干消融(对应表 4)。更强的前端带来更低的收敛S²ER:FireRedASR2-LLM-8.3B(0.55%)优于默认的 Qwen3-ASR-1.7B(2.02%),再优于 Whisper(6.82%)。但即便以最弱的 Whisper 为前端,交互仍能将 AISHELL-NER Test† 的S²ER由 47.77% 大幅降至 6.82%,显示该框架对前端质量具有较强鲁棒性——弱前端可经由多轮交互获得可观补偿。
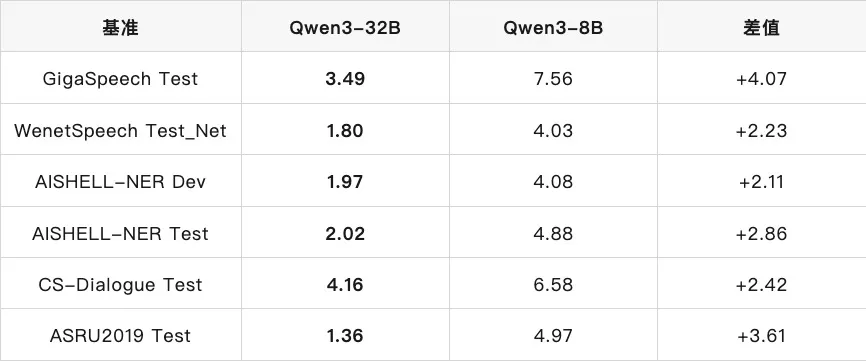
推理器规模消融(对应表 5)。更大的推理器全面占优:Qwen3-32B 在全部六个基准上的收敛S²ER 均显著低于 Qwen3-8B,差距在 +2.11% 至 +4.07% 之间;且在较小的 Qwen3-8B 下,部分基准的 token 级指标会随交互轮次不降反升,说明推理与编辑能力是闭环修复奏效的关键。
判别策略。在人机对齐验证集上,多数表决优于单次判别(majority-3 的 Pearson相关系数 约 0.8628,高于 single 的约 0.8543),而继续增大投票轮数(majority-5/7)收益递减;因此该论文将 majority-3 作为兼顾稳健性与效率的默认协议。
▎结 语
方法贡献。该论文将交互式 ASR 建模为多轮语义精修问题,提出 Agentic ASR 框架:在单遍 ASR 之上叠加基于 LLM 的语义纠错、意图路由与推理式编辑(Locate–Reason–Modify);同时提出句级语义等价度量S²ER,并构建可复现的交互模拟系统,在无需大量真人反馈的前提下实现规模化、可复现的多轮评测。
主要发现。在多语种、命名实体密集与语码转换等多类基准上,迭代交互均能持续降低语义错误且收益主要集中于前几轮;S²ER相比 WER、CER 等 token 级指标更能刻画这种“语义而非字面”的改善;消融实验表明较小的 LLM 仍具备基础纠错能力,而更强的推理器则带来更稳定的编辑与更优的最终表现。
未来方向。作者指出两条后续方向:一是将更丰富的交互监督(如真实用户纠错轨迹或自动构造的交互数据)纳入训练,以提升部署环境下的鲁棒性;二是后训练一个更小的任务专用精修模型,因为紧凑模型虽具备基本纠错能力,但在稳定性与精度上仍落后于大模型。
相关文献参考:
[1] Tomanek, K., et al. 2024. Large Language Models as a Proxy for Human Evaluation in Automatic Speech Recognition: Application to Disordered Speech Transcription (LATTEScore). ICASSP 2024.
[2] Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., Cao, Y. 2023. ReAct: Synergizing Reasoning and Acting in Language Models. ICLR 2023.
[3] Zhou, J., et al. 2023. The Gift of Feedback: Improving ASR Model Quality by Learning from User Corrections through Federated Learning.
[4] Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., Sutskever, I. 2023. Robust Speech Recognition via Large-Scale Weak Supervision (Whisper). ICML 2023.
[5] Yang, A., et al. 2025. Qwen3 Technical Report.
