
 语音小管家
近年来,大规模语音识别模型在普通话识别上取得了显著进展,但中文方言识别仍然面临数据稀缺、地域差异大、声学与词汇分布复杂等挑战。一个常见做法是在预训练 ASR 模型上继续使用方言数据进行微调,虽然能够有效提升方言识别性能,却往往会导致模型原有的普通话能力退化。为解决这一问题,我们提出 On-Policy Self-Distillation(OPSD),并构建了一套 CPT → Dialect SFT → OPSD 的三阶段中文多方言 ASR 训练框架。该方法通过让模型在自身实际解码轨迹上接受教师模型的细粒度软监督,在进一步提升方言识别性能的同时,更好地保留模型原有的普通话识别能力。
基于 Qwen3-ASR-1.7B 的实验表明,完整训练流程能够将普通话平均 CER 从 3.46% 降至 3.27%,公开方言平均 CER 从 15.37% 降至 12.79%,18 类内部方言平均 CER 从 21.01% 降至 12.42%。相比继续采用传统 SFT,OPSD 在提升方言性能的同时显著缓解了普通话能力退化问题。
相关技术报告 “On-Policy Self-Distillation for Multi-Dialect ASR: Mastering Dialects, Retaining Mandarin” 已公开发布,同时开源了相关代码(GitHub - CN-MultiDialect-ASR)、模型权重(Hugging Face - CN-MultiDialect-ASR),欢迎大家关注、使用和交流。
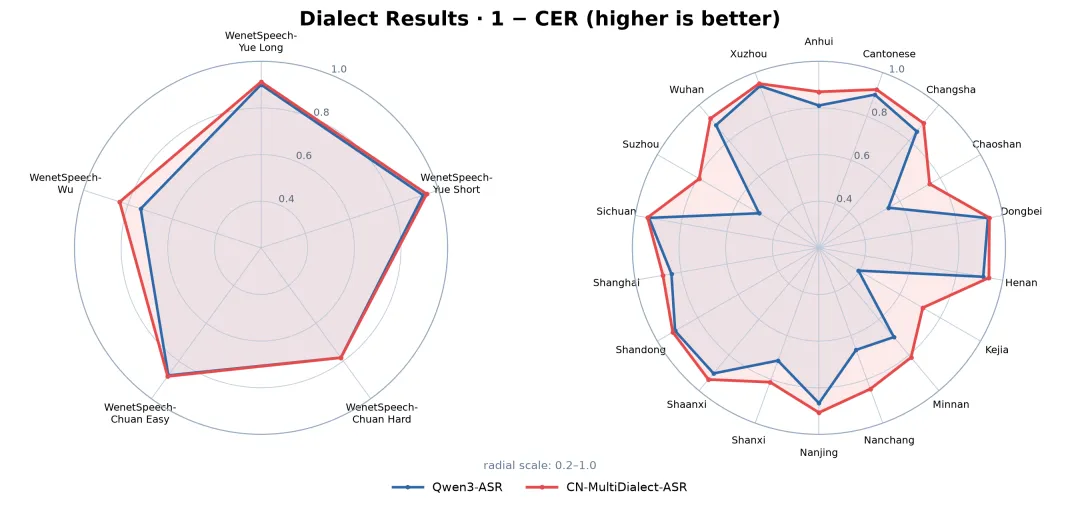
论文题目: On-Policy Self-Distillation for Multi-Dialect ASR: Mastering Dialects, Retaining Mandarin
作者列表: 王水源,穆秉甡,张鹏燊,王成有,廖育杰,梁成栋,张彬彬,丰强泽,谢磊
合作单位: 西北工业大学 ASLP 实验室、Wenet社区、数据堂
技术报告预印版:https://arxiv.org/abs/2608.11898
Github 项目: https://github.com/ASLP-lab/CN-MultiDialect-ASR
Hugging Face:https://huggingface.co/ASLP-lab/CN-MultiDialect-ASR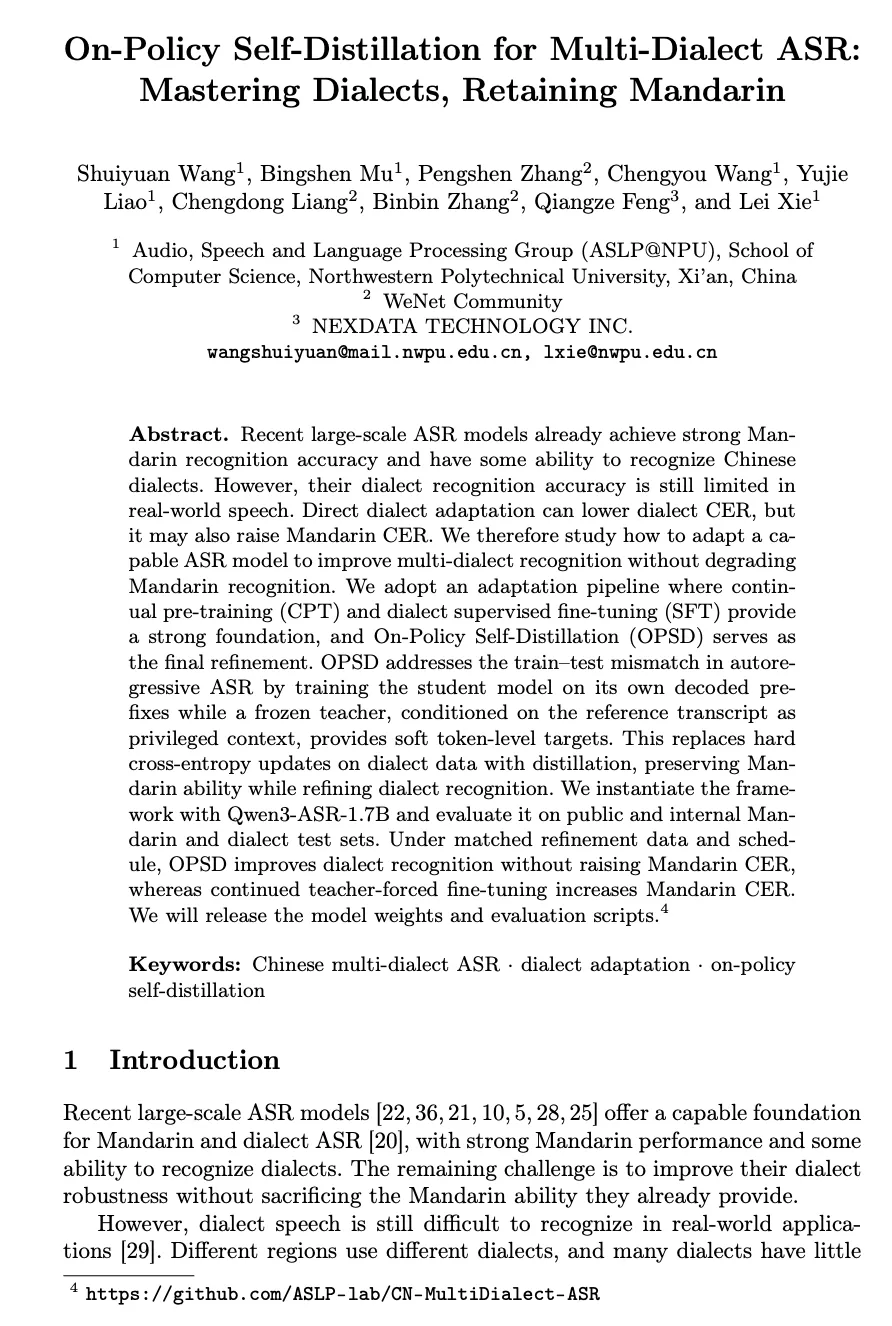 背景动机
中文方言种类丰富,不同地区在发音、词汇和表达习惯上存在明显差异。尽管近年来粤语、四川话、吴语等大规模方言数据集不断出现,但相较于普通话,很多方言仍然属于低资源场景,因此大规模 ASR 模型在方言语音上的表现仍有较大提升空间。
中文方言种类丰富,不同地区之间在发音方式、词汇使用和语言表达上存在明显差异。随着大规模语音预训练的发展,当前通用 ASR 模型已经能够较好地识别普通话,也具备一定程度的方言理解能力,但这种能力在不同方言之间并不均衡[2]。
近年来,WenetSpeech-Yue [3]、WenetSpeech-Chuan [4]、WenetSpeech-Wu [5] 等大规模方言数据集的发布,为粤语、四川话、吴语等方言识别提供了更丰富的数据基础。但与普通话相比,大量长尾方言的标注语音资源仍然有限,不同方言之间的数据规模差异也十分明显。因此,如何利用现有大模型进行高效的多方言适配,仍然具有重要研究价值。
最直接的方法是在预训练 ASR 模型基础上使用大量方言数据继续进行监督微调。
这种方法虽然有效,但存在一个明显的问题:模型越向方言数据分布适配,越容易牺牲原有普通话能力。
也就是说,简单增加方言训练并不能真正解决“通用普通话 + 多方言”统一识别的问题,而是在两种能力之间进行取舍。
此外,传统 SFT 通常采用 teacher forcing:训练阶段模型始终基于正确的参考文本前缀进行下一个 token 的预测,而真正推理时,模型只能基于自己此前生成的 token 继续解码。一旦前面出现识别错误,后续模型便需要面对训练阶段很少见到的错误 prefix,容易进一步累积错误 [7]。
这一问题对于本身声学和语言差异更大的方言语音更加突出。
围绕上述问题,本文提出 CPT + Dialect SFT + OPSD 三阶段训练方案。
本文主要贡献总结如下:
构建面向中文多方言 ASR 的三阶段适配框架。通过 CPT、Dialect SFT 与 OPSD 逐步完成通用能力扩展、方言专项适配和最终性能 refinement。
将 On-Policy Self-Distillation 引入自回归 ASR 后训练。在最终 refinement 阶段,我们进一步将近期的 On-Policy Distillation 思路 [1,6] 引入自回归 ASR 后训练,并针对语音识别场景设计了 OPSD refinement 方法。
实现方言能力提升与普通话能力保持之间更好的平衡。在普通话、公开方言以及覆盖 18 类方言的内部测试集上进行系统评测,并通过严格控制数据和训练预算的消融实验验证 OPSD 的有效性。
方案
本文整体框架基于 Qwen3-ASR-1.7B,训练过程包含三个阶段:
Qwen3-ASR → Continual Pre-training → Dialect SFT → OPSD
前两个阶段主要解决“如何让模型学会更多方言”,而第三阶段重点解决“如何在进一步学习方言时减少普通话能力退化”。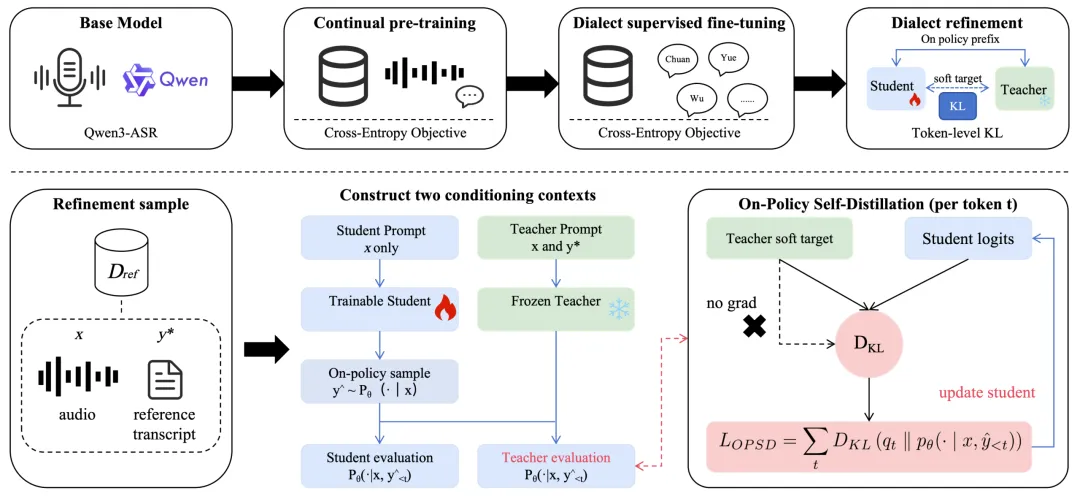 图 1 三阶段多方言 ASR 训练流程
第一阶段:Continual Pre-training
我们首先构建大规模普通话与方言混合训练数据,在原始 Qwen3-ASR-1.7B 基础上进行持续预训练。训练数据同时包含大量普通话语音以及粤语、四川话、吴语和其他内部方言数据。
与直接进行方言专项训练不同,CPT 的目的在于首先构建更加稳健的中文语音基础,使模型在保留已有普通话能力的同时,扩大对不同方言声学与语言分布的覆盖范围。
这一阶段可以理解为后续 Dialect SFT 的“缓冲层”:如果模型直接从原始 checkpoint 向大量方言数据适配,参数容易快速偏向方言数据分布;而经过普通话—方言混合 CPT 后,模型首先建立更加统一的中文多方言表示,为后续专项适配提供更稳定的初始化。
第二阶段:Dialect Supervised Fine-tuning
在 CPT checkpoint 基础上,我们进一步提高方言样本在训练过程中的采样比例,使模型更加充分地学习不同方言中的发音、词汇与表达特点,同时保留一定规模的普通话数据作为 anchor。
经过这一阶段后,模型在公开方言和内部方言测试集上的识别性能均得到进一步提升。
但 Dialect SFT 仍然使用传统 teacher-forcing cross-entropy 目标,因此如果继续延长传统 SFT,模型仍然容易向方言训练分布过度偏移。
这也是为什么我们在最终 refinement 阶段没有简单选择“再继续一轮 SFT”,而是引入 OPSD。
第三阶段:On-Policy Self-Distillation
传统 SFT 中,Student 在每一步预测时看到的是 ground-truth prefix;而 OPSD 中,Student 首先根据输入语音自行进行自回归采样,得到自己的预测序列。
也就是说,Student 后续训练时所处的状态,来自模型自己真实生成的解码轨迹,而不是始终来自标准答案。
随后,我们引入一个参数冻结的 Teacher。Teacher 与 Student 使用相同的 ASR checkpoint 初始化,但 Teacher 在训练过程中额外获得 reference transcript 作为 privileged context,并在 Student 当前的解码 prefix 上预测下一个 token 的概率分布。
Student 则通过 token-level KL divergence 学习 Teacher 提供的 soft target。
与标准 SFT 相比,这种设计具有两个特点。
首先,Student 所训练的状态更加接近模型真正部署时可能遇到的状态,因此能够一定程度缓解训练和推理之间的分布差异。
其次,相比 one-hot hard label,Teacher 输出的概率分布能够提供更加丰富、细粒度的软监督信息 [8];在本文的 refinement 场景中,我们希望借此减少继续使用方言 hard-label CE 更新对已有普通话能力造成的覆盖。
推理阶段仅使用 Student,因此 OPSD 不会增加实际部署时的推理开销,也不需要 reference transcript。
实 验
我们从 普通话、公开方言以及内部多方言三个维度,对提出的方法进行了系统评测。
公开测试部分包括 8 个普通话测试集以及 5 个公开方言测试集;此外,我们还构建了覆盖 18 类地域方言/口音的内部测试集,包括粤语、客家、潮汕、闽南、上海、苏州、四川、武汉、河南、东北等不同地域语音。
所有实验统一采用 Character Error Rate(CER) 作为主要评测指标。
我们主要报告以下四组平均结果:
Mandarin Avg.:8 个普通话测试集平均 CER;
Dialect Avg.:5 个公开方言测试集平均 CER;
Internal Avg.:18 个内部方言测试集平均 CER;
Overall Avg.:全部测试集的宏平均 CER。
整体性能
如表 1 所示,原始 Qwen3-ASR-1.7B 已经具备较强的普通话识别能力,普通话平均 CER 为 3.46%,但公开方言平均 CER 和内部方言平均 CER 分别达到 15.37% 和 21.01%,说明模型在长尾方言上的识别能力仍有明显提升空间。经过 Continual Pre-training 后,模型首先获得了更加稳健的普通话—方言联合建模能力;进一步进行 Dialect SFT 后,公开方言和内部方言性能继续提升;最终引入 OPSD 后,普通话平均 CER 进一步降低至 3.27%,公开方言平均 CER 降至 12.79%,18 类内部方言平均 CER 从原始模型的 21.01% 大幅下降至 12.42%,Overall Avg. 也由 15.57% 降至 10.12%。值得注意的是,最终模型在大幅提升方言识别能力的同时,并没有以牺牲普通话性能为代价,相反,其普通话平均 CER 甚至进一步优于原始 Qwen3-ASR-1.7B,体现了本文训练框架在“方言增强”和“普通话保持”之间更加平衡的优化效果。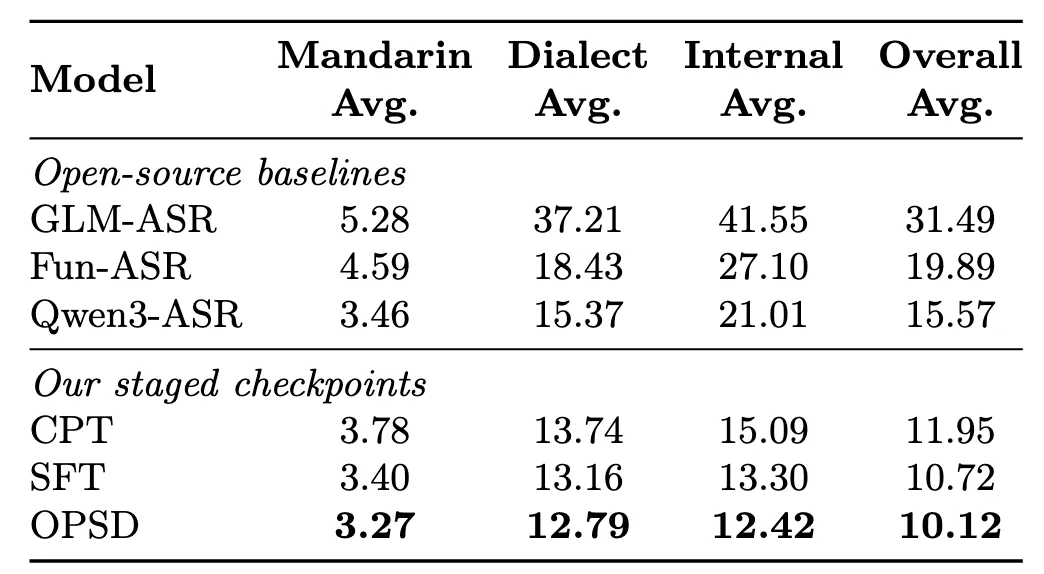 表 1 不同训练阶段的整体 CER 对比
公开普通话与方言测试结果
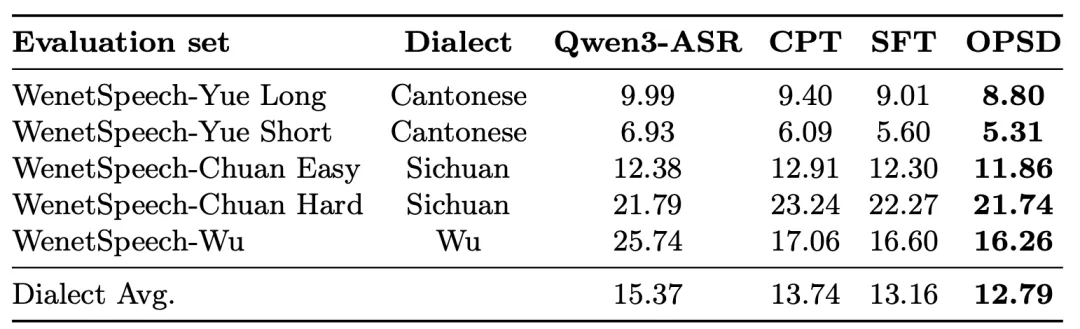
进一步观察表 2、表3 中不同公开测试集的结果可以发现,OPSD 带来的提升并不局限于某一类方言或某一个测试集。在 WenetSpeech-Yue、WenetSpeech-Chuan 和 WenetSpeech-Wu 等公开方言测试集上,模型经过 CPT 和 Dialect SFT 后已经取得了明显改善,而 OPSD 可以在此基础上继续稳定降低 CER;与此同时,在 AISHELL、KeSpeech、SpeechIO 以及 WenetSpeech 等普通话测试集上,最终模型也整体保持了稳定甚至更优的识别效果。这一点对于多方言 ASR 尤为重要,因为传统方言适配往往存在比较明显的性能转移现象,即方言能力越强,普通话性能越容易受到影响,而本文结果说明 OPSD 并不是简单将模型能力从普通话“转移”到方言,而是在保持原有通用能力的基础上进一步扩展方言识别能力。
表 2 普通话测试集详细 CER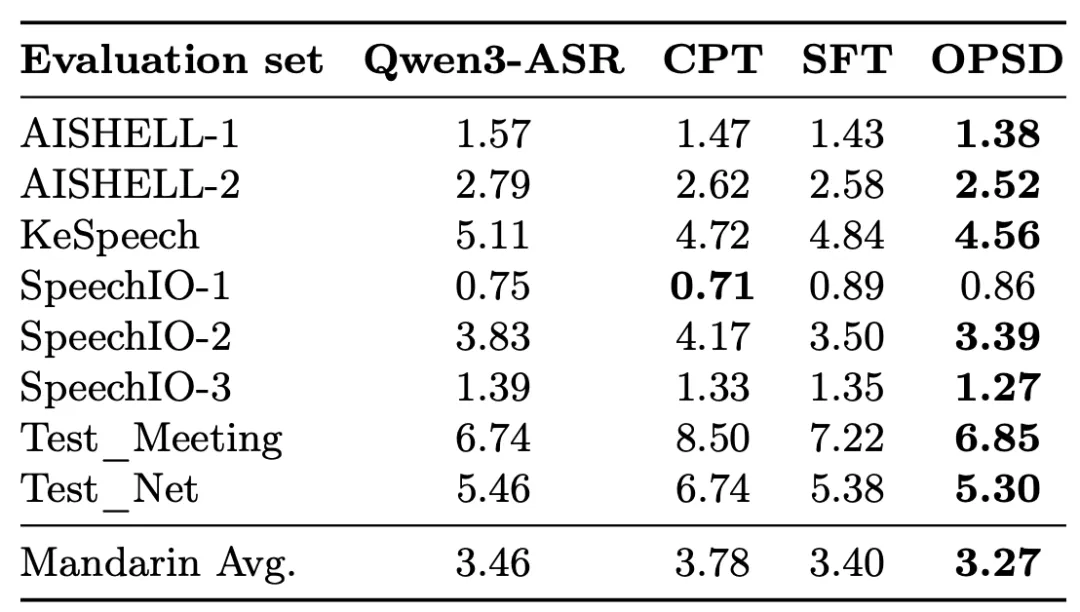 表 3 公开方言测试集详细 CER
 内部多方言测试结
在更加丰富的内部方言测试集上,这一趋势更加明显。如表 4 所示,最终模型在 18 类内部方言上的平均 CER 从原始 Qwen3-ASR-1.7B 的 21.01% 降低至 12.42%,其中一些原始模型识别难度较高的长尾方言获得了尤为显著的改善。例如,客家话 CER 从 60.47% 降至 28.60%,潮汕话从 45.59% 降至 25.21%,苏州话从 50.35% 降至 20.73%,南昌话从 33.41% 降至 15.58%,闽南语则从 30.03% 降至 18.59%。这些结果表明,大规模普通话—方言 CPT 能够显著扩展模型对于不同中文方言声学与语言分布的覆盖范围,而 Dialect SFT 可以进一步强化方言专项建模能力,最终通过 OPSD 对模型进行 refinement 后,在不同方言之间获得更加稳定的综合性能。与此同时,不同方言之间依然表现出明显的识别难度差异,与普通话较为接近、训练资源相对丰富的部分地域语音通常能够获得更低 CER,而客家、潮汕、闽南及部分吴语地方变体由于声学和词汇差异更大、可用数据更有限,依然属于更具挑战性的识别场景。
表 4 内部方言测试集 CER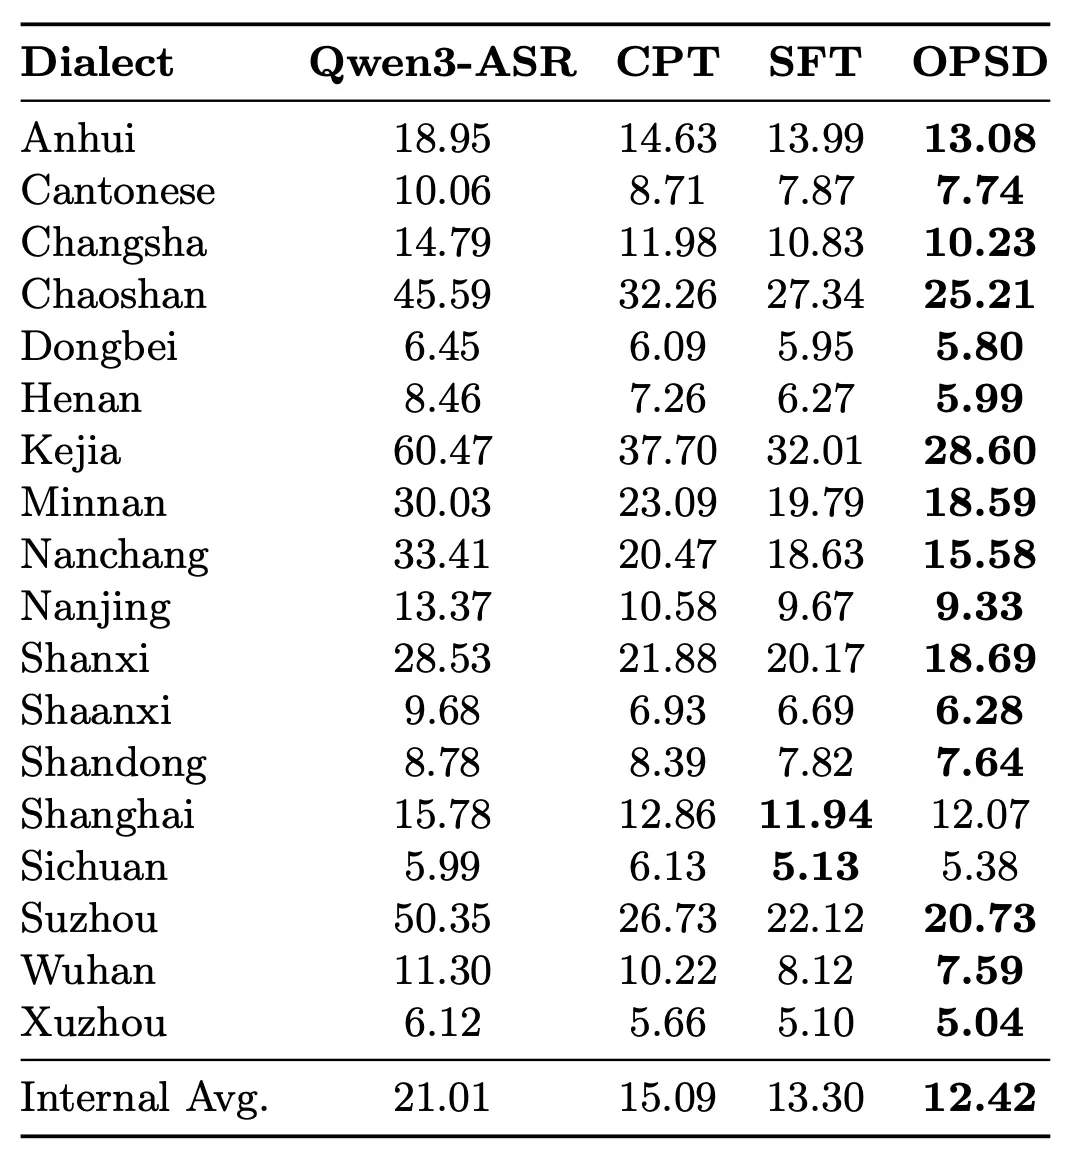 参考文献
[1] S. Zhao, Z. Xie, M. Liu, J. Huang, G. Pang, et al., “Self-Distilled Reasoner: On-Policy Self-Distillation for Large Language Models,” arXiv preprint arXiv:2601.18734, 2026.
[2] Qwen Team, “Qwen3-ASR Technical Report,” arXiv preprint arXiv:2601.21337, 2026.
[3] L. Li, Z. Guo, H. Chen, Y. Dai, Z. Zhang, et al., “WenetSpeech-Yue: A Large-Scale Cantonese Speech Corpus with Multi-Dimensional Annotation,” in Proceedings of AAAI, pp. 31627–31635, 2026.
[4] Y. Dai, Z. Zhang, S. Wang, L. Li, Z. Guo, et al., “WenetSpeech-Chuan: A Large-Scale Sichuanese Corpus with Rich Annotation for Dialectal Speech Processing,” arXiv preprint arXiv:2509.18004, 2025.
[5] C. Wang, M. Shao, J. Hu, Z. Zhu, H. Xue, et al., “WenetSpeech-Wu: Datasets, Benchmarks, and Models for a Unified Chinese Wu Dialect Speech Processing Ecosystem,” in Findings of ACL, pp. 27999–28011, 2026.
[6] R. Agarwal, N. Vieillard, Y. Zhou, P. Stanczyk, S. Ramos Garea, et al., “On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes,” in Proceedings of ICLR, 2024.
[7] S. Bengio, O. Vinyals, N. Jaitly, and N. Shazeer, “Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks,” in Proceedings of NeurIPS, 2015.
[8] X. Yang, Q. Li, C. Zhang, and P. C. Woodland, “Knowledge Distillation from Multiple Foundation Models for End-to-End Speech Recognition,” arXiv preprint arXiv:2303.10917, 2023.
方法、代码、模型已公开|OPSD 中文多方言 ASR:学会方言,不忘普通话
评论 0

文明发言,友善讨论
还没有评论,发表你的看法,来抢沙发~