语音小管家
你有没有过这种体验:跟语音助手说话,刚停半秒,它就抢着回——其实你只是喘了口气; 或者你已经说完了,它还在干等,场面一度很尴尬。
这些「接话时机」问题,本质不是 ASR 认不清字,而是系统不会判断:
用户是说完了,还是话还没说完?
这句「嗯嗯」是附和,还是真的要打断?
机器正在播报时,用户插嘴,该不该立刻停下来?
自变量机器人提出 X2-Turn:在同一个流式模型里,一边做实时语音识别,一边以80 毫秒一帧的节奏预测话轮状态——让对话系统真正「听得懂节奏」。
⏩一句话看懂 X2-Turn
一个模型,两个同步输出:
流式 ASR:持续识别用户在说什么
话轮状态:每 80 ms 给出当前是静音、在说、说完、附和,还是语义未完成
它建立在 Mistral 的Voxtral Realtime流式架构上,用「双头并行」把识别与话轮控制解耦:话轮判断不再依赖「先切段 → 再 ASR → 再分类」的长链路,也不需要推理时再挂一个额外 ASR。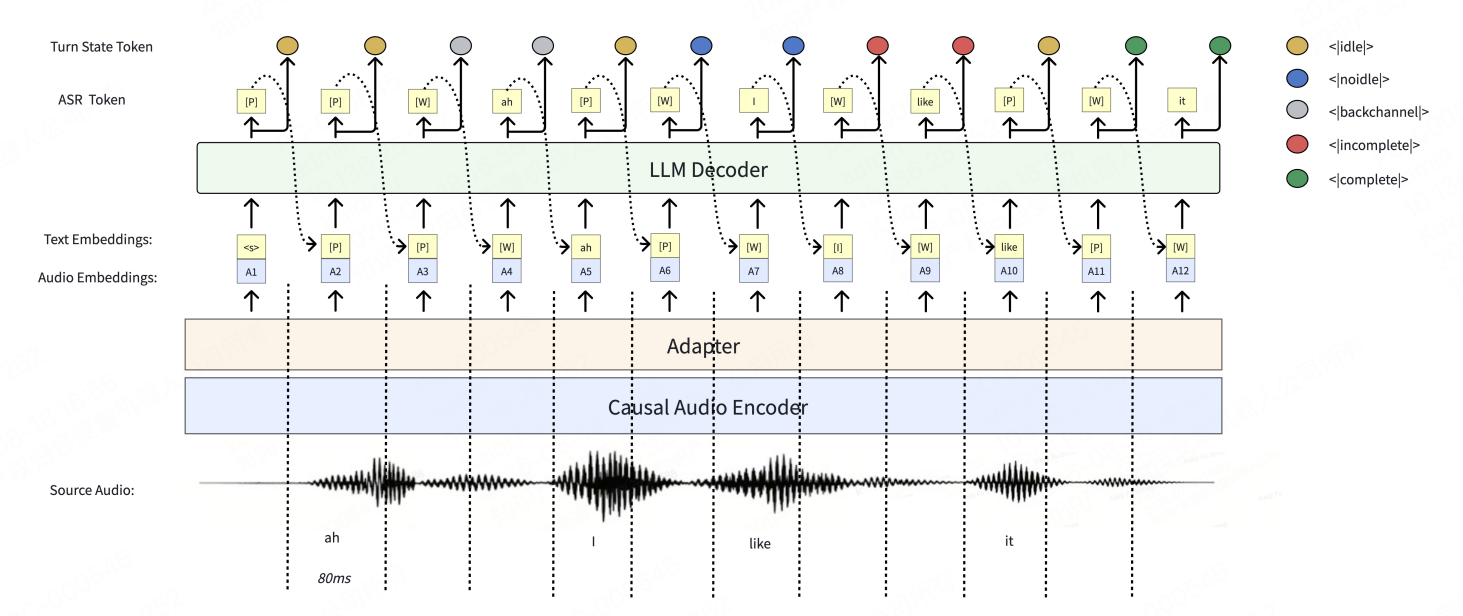 ⏩为什么这件事重要?
现有方案大致分两类:
端到端全双工大模型
理解、时机、生成绑在一起,能力强,但数据与训练成本高,落地灵活度受限。
级联方案(VAD → ASR → 话轮检测)
模块清晰,但环环相扣:前端 VAD 一等,整条链路延迟就上去;错误也会层层传递。
X2-Turn 的路线
保留级联系统的可插拔性,同时把 ASR 与话轮预测做到帧同步、单模型一次前向。
对产品来说,这意味着:可以继续用自己的 LLM / TTS,只把「该不该接话」这块换成更准、更快的 X2-Turn。
⏩Turn & 对话Demo 视频
展示不依赖 LLM / TTS 的实时 ASR、六分类话轮时间轴,以及帧级预测结果。适合先看「模型本身在做什么」。
展示完整会话中的流式 ASR、话轮状态跟踪、回复生成、语音播放,以及用户打断效果。适合看「接到真实对话链路之后长什么样」。
⏩技术要点
1. 帧同步双头结构
在共享的流式表征上,并行挂载:
ASR 头:吐识别 token
Turn 头:吐话轮状态
同一趟前向里同时完成,不增加额外串行推理阶段。
2. ASR 锚定监督(ASR-Anchored Supervision)
把词级话轮标注,对齐到模型原生的 80 ms ASR token 时间轴上。识别与话轮在同一条时间线上联合训练,避免「按句 / 按块」和「连续交互」之间的粒度错位。
3. 可控延迟 τ
通过目标延迟 τ(如 320 / 400 / 480 ms),在准确率 ↔ 响应速度之间做产品级权衡:
要更稳:可略增延迟
要更跟手:可收紧 τ,准确率下降有限
4. 面向真实对话的状态设计
覆盖静音、早期发声、语义未完成、语义完成、附和等状态,支撑:
自然接话
忽略「嗯 / 啊」类附和
播报中的用户打断
⏩效果怎么样?
在中英 EasyTurn 评测上(论文 Table 1,τ = 480 ms):
相对同为流式的 SoulX-Duplug,准确率整体更优;相对依赖 VAD 的级联系统,避免「前端切段」带来的额外不可控延迟,准确率–时延权衡更干净。
另:中文 Backchannel Acc. 达到 96%——「嗯嗯」别乱接话,这件事模型真的在学。
τ 从 480 ms 收到 320 ms 时,延迟可显著下降,准确率仅温和回落(见论文 Table 2),方便按业务场景调参。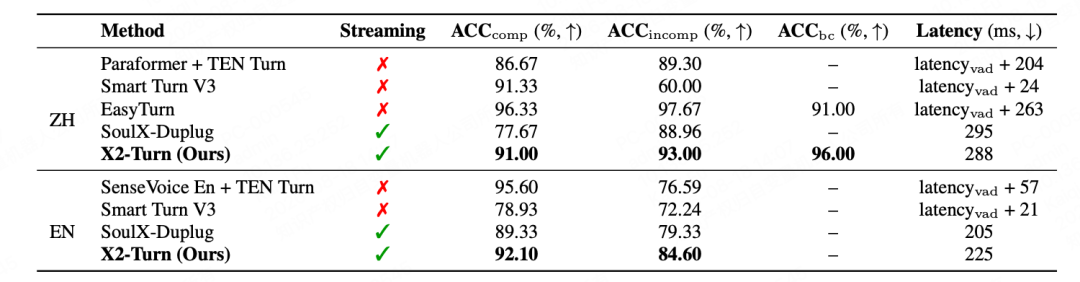
⏩已经开源什么?
论文:X2-Turn: Frame-Synchronous Dual-Head Modeling for Joint Streaming ASR and Turn State Prediction
作者:Kaiqi Fu, Rime Wen, Altman Lin, Shawn Qin, Roy Gan, Hao Wang, Qian Wang
arXiv:https://arxiv.org/abs/2608.10878
PDF:https://arxiv.org/pdf/2608.10878
代码仓库:https://github.com/X-Square-Robot/X2-Turn
仓库内含:
Turn Demo:流式 ASR + 80 ms 话轮时间轴(不依赖 LLM / TTS)
全双工对话 Demo:可接 LLM + TTS,体验接话、附和、打断
Transformers / vLLM 集成与环境配置说明
模型权重
https://huggingface.co/x-square-robot/X2-Turn-4B-0812
⏩给谁用?
做 语音 Agent / 客服机器人 / 车载语音:想把「接话时机」做成可插拔模块
做 流式 ASR / 全双工对话:想要帧级、可复现的 baseline
做 产品体验:想少一点抢话,少一点尬等
一句话:
让机器不只听清「说了什么」,还听懂「说到哪了」。
⏩写在最后
自然对话里,沉默半秒和说完一句,往往差的不是音量,而是语义节奏。
X2-Turn 把这件事从「后处理规则」推进到「与 ASR 同频的帧级预测」,并完整开源了论文、代码、模型与 Demo。
欢迎 Star、试用、提 Issue;也欢迎把在线 Demo 丢给同事一起点开看一眼。
你们最怕的,是机器抢话,还是机器装死?评论区聊聊。
⏩相关链接
论文:
https://arxiv.org/pdf/2608.10878
GitHub:
https://github.com/X-Square-Robot/X2-Turn
Hugging Face:
https://huggingface.co/x-square-robot/X2-Turn-4B-0812