
 语音小管家
本文介绍由香港城市大学与华为香港研究所联合完成的工作SpeechEditBench。该工作构建了一个覆盖中英文、七类原子任务与多属性组合编辑的指令语音编辑综合评测基准,已被EMNLP 2026 Main Conference接收。 论文题目:SpeechEditBench: A Bilingual Multi-Attribute Benchmark for Instruction-Guided Speech Editing
收录会议:EMNLP 2026 Main Conference
论文作者:Hanlin Zhang*、Daxin Tan*、Dehua Tao、Xiao Chen、Haochen Tan 和 Linqi Song(其中 * 表示共同第一作者)。
论文地址:https://arxiv.org/abs/2606.01804
代码及评测工具:https://github.com/daxintan-cuhk/SpeechEditBench
Hugging Face 数据集:https://huggingface.co/datasets/DiscreteSpeech/SpeechEditBench
⏩现存问题
近年来,语音大模型在语音识别、合成、翻译和问答等任务上取得了快速进展。随着语音理解与生成逐渐走向统一,一个更细粒度的问题开始受到关注:模型能否根据自然语言指令,只修改一段语音中的指定属性?
例如,用户可能希望把一句话中的某个词替换掉,但保留原说话人的音色和语气;也可能希望文本完全不变,只把情绪改成开心、提高音调、加入笑声,或去除背景噪声。
这类任务的难点不只是“生成修改后的语音”,而是同时满足两个要求:该改的必须改,不该改的必须保留。模型即使成功改变了情绪,如果同时说错了词,也不能算一次可靠的编辑。
然而,现有评测通常只关注内容编辑、音色转换或语音增强中的某一个方向,不同工作采用的数据和指标也难以直接比较。更重要的是,合理的语音编辑结果往往不止一种波形,用单一参考音频进行逐点匹配并不合适。
为此,团队提出 SpeechEditBench:一个覆盖中英文、七类原子任务和多属性组合任务的指令语音编辑基准,并设计了基于 Anchor(锚点)的统一评测方法。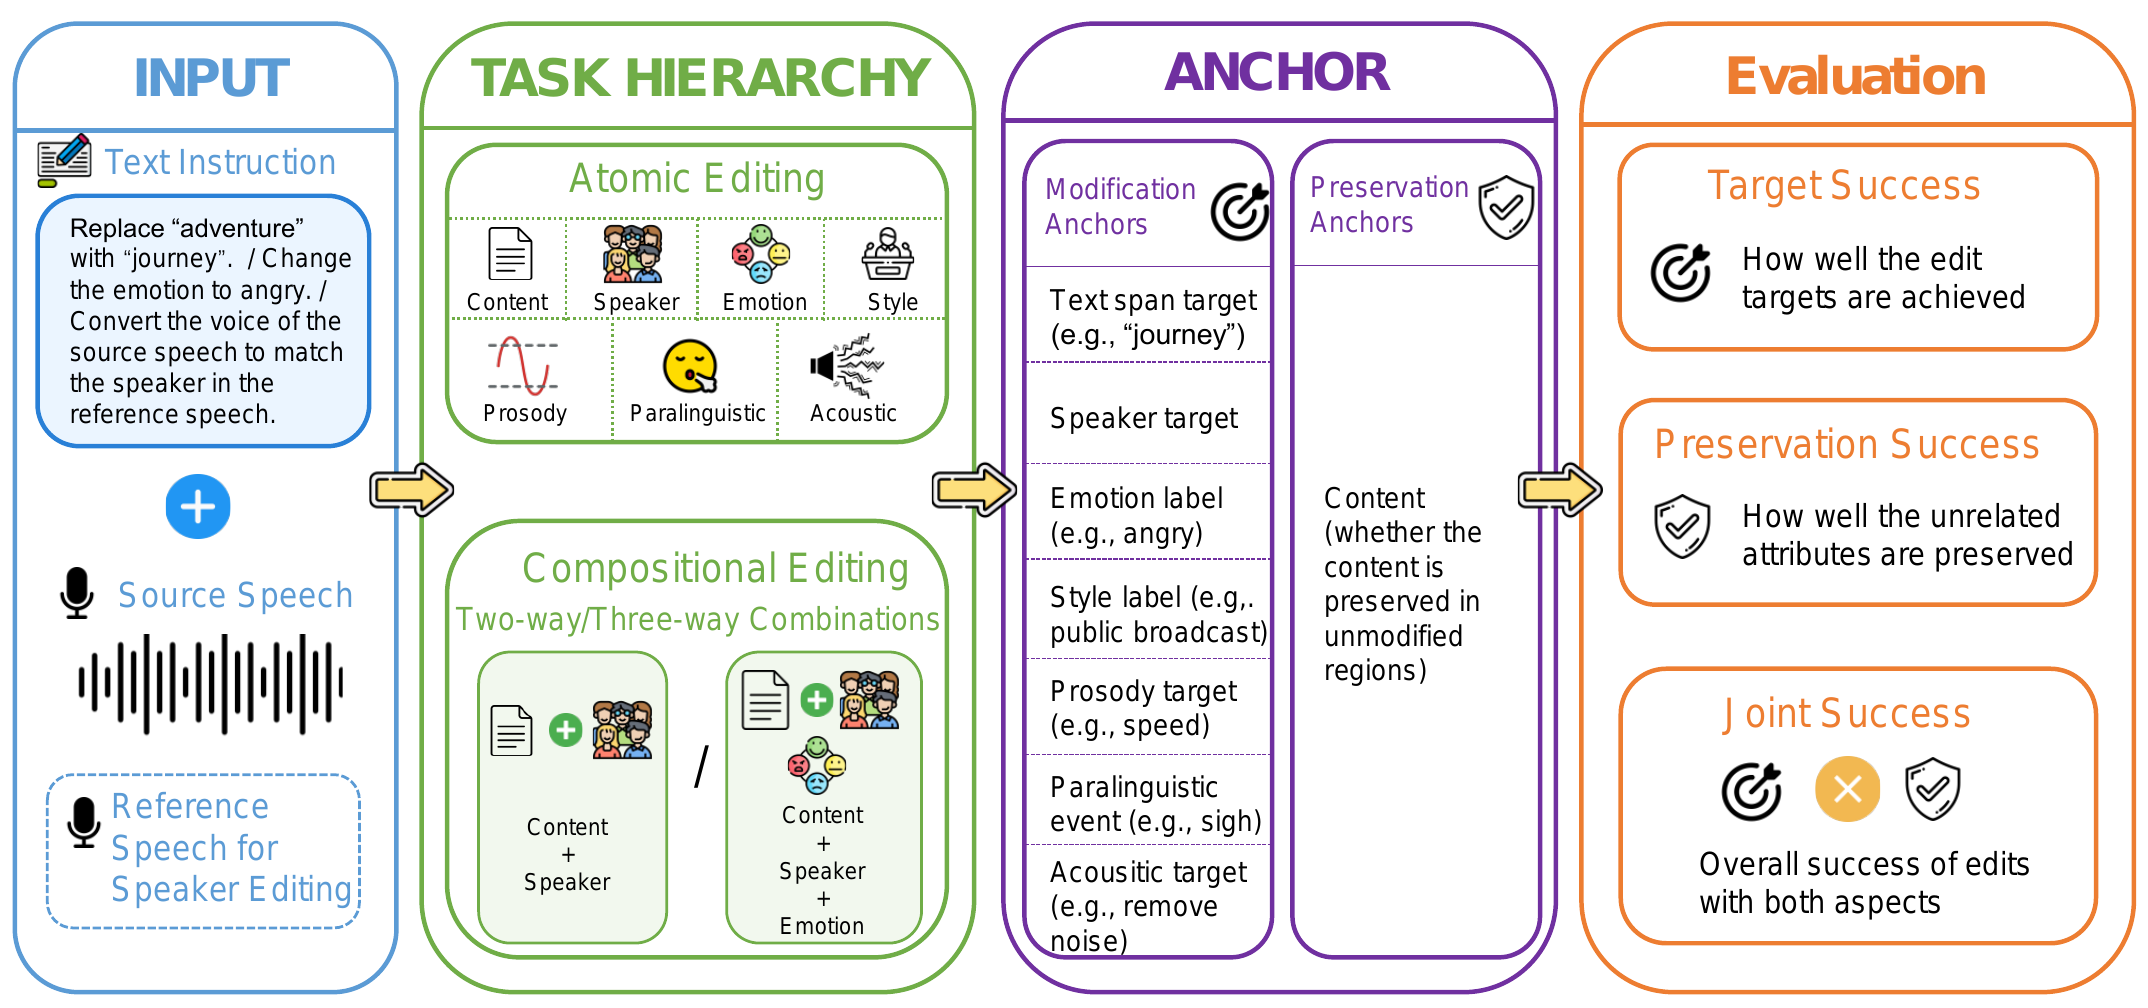 ▲ 图1:SpeechEditBench 整体框架。模型接收源语音和自然语言编辑指令,基准分别检查目标属性是否修改成功,以及非目标内容是否得到保留。
⏩01 从单项能力到完整的语音编辑版图
七类原子编辑任务
SpeechEditBench 包含4700 个中英文源语音—编辑指令样本,共涉及5400 个音频文件(部分任务还需要参考音频)。其中,原子任务覆盖语音编辑中的七个维度:
1、内容编辑:替换、插入或删除语音中的词语;
2、说话人编辑:将源语音转换为参考说话人的音色;
3、情感编辑:改变开心、悲伤、愤怒、恐惧、惊讶等情绪表达;
4、风格编辑:在播音、亲密、戏剧化、克制平淡、讲故事和对话等风格间转换;
5、韵律编辑:调整语速、整体音高或特定词语的重音;
6、副语言编辑:添加或移除呼吸、笑声、咳嗽和叹气;
7、声学编辑:完成去噪、去混响或背景声与混响环境转换。
这些任务不仅涉及“说了什么”,还覆盖“谁在说”“怎么说”以及“在什么环境中说”。因此,模型需要在同一套自然语言指令接口下处理语义、身份、表达和声学环境等不同层面的修改。
双属性与三属性组合编辑
真实需求通常不会只包含一项操作。例如,“把超市改成公园,并升高音调”同时涉及内容和韵律;“把 delivered 改成 rescued,模仿参考音频中的说话人,并用沮丧的语气表达”则要求模型同时控制内容、音色和情绪。
因此,除 4,300 个原子任务样本外,SpeechEditBench 还构建了320 个双属性组合样本和80 个三属性组合样本,中英文数量保持平衡。组合任务跨越语义内容、说话人身份、表达方式与声学环境四个类别,用于检查模型究竟完成了整条指令,还是只执行了其中最容易的一部分。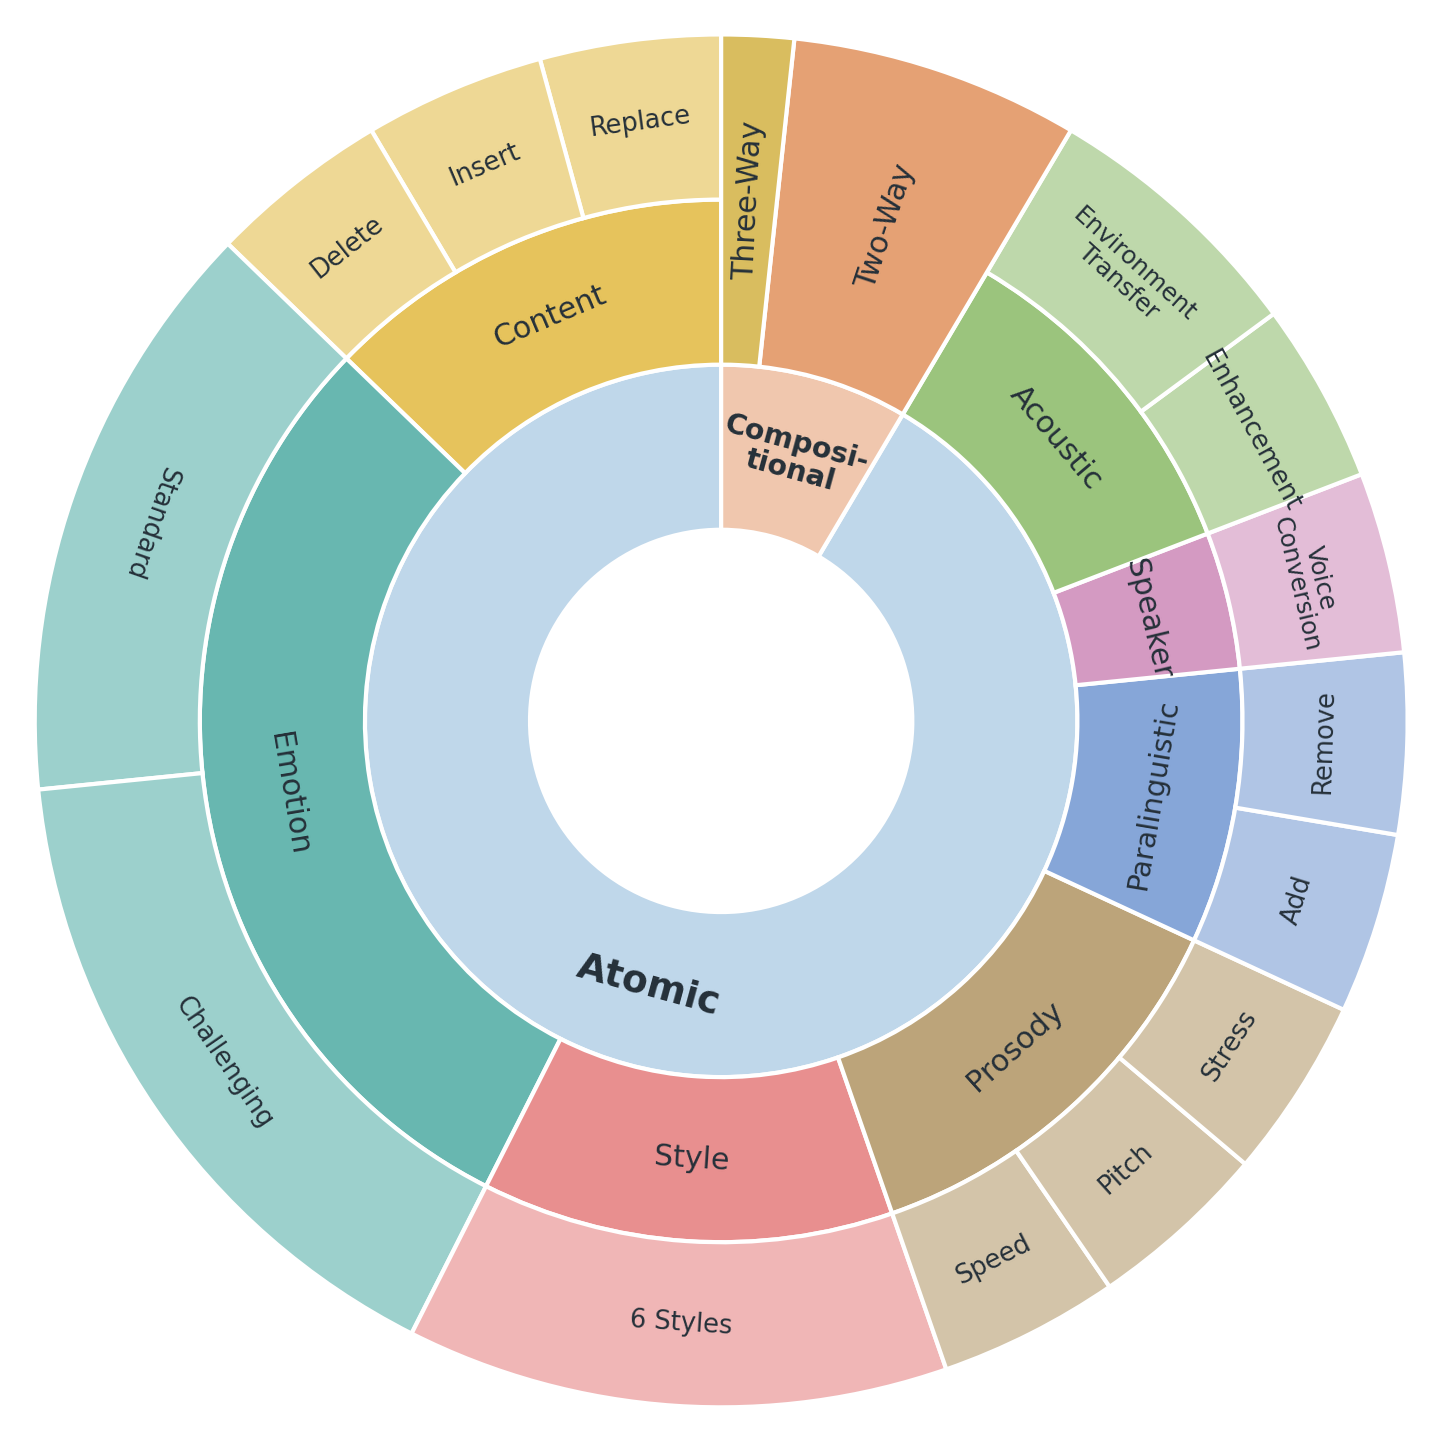
▲ 图2:SpeechEditBench 的任务层次与样本分布。完整基准包含 4,300 个原子任务样本和 400 个组合编辑样本。
数据与指令如何构造
基准音频来自 LibriTTS、AISHELL-3、VCTK、IEMOCAP、CSEMOTIONS 等公开中英文语料;声学编辑还使用 MUSAN 和 RIRS_NOISES 构造噪声与混响条件。
每条样本包含源语音、自然语言指令、任务标签和用于验证结果的 Anchor。GPT-4o 用于提出语义编辑候选、过滤文本并生成自由形式指令,Gemini-2.5-Pro 辅助风格与副语言任务的音频标注和候选筛选;目标明确的操作则使用模板化指令。
⏩02 不寻找“唯一答案”,而是验证编辑目标
为什么不能只比较参考音频
同一句“请把语速加快”,可以对应许多停顿、音高和局部时长各不相同的正确输出。因此,语音编辑不适合要求模型复现唯一的参考波形。
SpeechEditBench 为每个样本设置可验证的目标Anchor。内容编辑的 Anchor 是目标文本片段;说话人编辑使用参考音频;情感和风格编辑使用目标标签;韵律编辑使用语速、音高的变化方向或需要重读的目标词;副语言与声学编辑则分别使用目标事件和声学条件。
三个核心指标
基准分别报告:
Target Success:指令要求的目标属性是否修改成功;
Preservation Success:不应改变的语言内容是否得到保留;
Joint Success:目标编辑与内容保持是否同时成功。
对于内容以外的原子任务,系统先用 ASR 转写输出语音。只有输出与原文本之间的 WER/CER 不超过10%,才记为内容保持成功。Joint Success 则进一步要求目标与保持两项同时成立。
这套设计可以区分几种本质不同的失败:模型可能完全忽略指令,可能完成目标却改坏文本,也可能只完成组合指令中的一部分。若只报告目标属性是否变化,就容易高估模型的实际编辑能力。
不同任务采用不同判据
各任务的 Target Success 根据编辑目标自适应计算:内容编辑检查目标片段的插入、替换或删除;说话人编辑计算输出与参考音频的说话人相似度;情感、风格和副语言编辑使用基于 Gemini 的多模态评测器;韵律编辑测量时长比例、基频变化与重音增益;声学编辑则使用 DNSMOS、RT60 和声学场景匹配等指标。
为验证多模态 LLM 评测器的可靠性,团队从情感、风格和副语言任务中分层抽取240 个模型输出,由10 位标注者盲标;每个样本由三人判断,共获得720 条人工标注。在 Joint Success 上,标注者之间的一致率为80.3%,LLM 与多数投票人工标签的一致率为68.8%;按“模型—任务”聚合后,Pearson 和 Spearman 相关系数分别为0.69和0.70(均为 p < 0.001)。自动评测能够较好保留模型间的相对表现趋势,但不能完全替代人工听评。
组合任务会先检查每个分量是否成功,再报告全部分量同时成功的比例,并在此基础上加入非目标内容的保持约束。
⏩03 基准里的测试用例是什么样的?
用例一:中文内容删除
原始文本:我们今年是第一次来到科纳目睹这项体育盛事。
编辑指令:删除“今年”。
目标文本:我们是第一次来到科纳目睹这项体育盛事。
该用例重点检查目标词是否被正确删除、输出是否达到目标文本;完整转写匹配和 WER/CER 则作为辅助诊断指标。
用例二:文本情感与目标情感冲突
情感编辑的挑战集还会制造文本含义、源语音情感与目标情感之间的冲突。例如,源语音以愤怒语气说出 “I am so angry”,指令却要求改为开心。模型必须克服文本本身的情感倾向,在保留原句内容的同时改变声音中的情绪。
用例三:多属性组合指令
编辑指令:将 “delivered” 替换为 “rescued”,把声音转换为参考音频中的说话人,并用沮丧的语气说出修改后的句子。
这里包含内容、说话人和情感三个分量。只替换单词、只模仿音色,或因为改情绪而破坏文本,都不能获得 Joint Success。
⏩04 八个语音大模型,表现如何?
团队评测了六个开源 Speech LLM:Ming-UniAudio、Step-Audio-EditX、Qwen3-Omni、Kimi-Audio、Mimo-Audio-Base、Mimo-Audio-Instruction,以及两个闭源系统:Gemini-Live、GPT-Realtime。
基准还加入 VoiceCraft-X、Seed-VC、VoxCPM2、Chatterbox + AudioSep、DeepFilterNet + DSP 等任务专用系统,以反映成熟单任务方案的水平。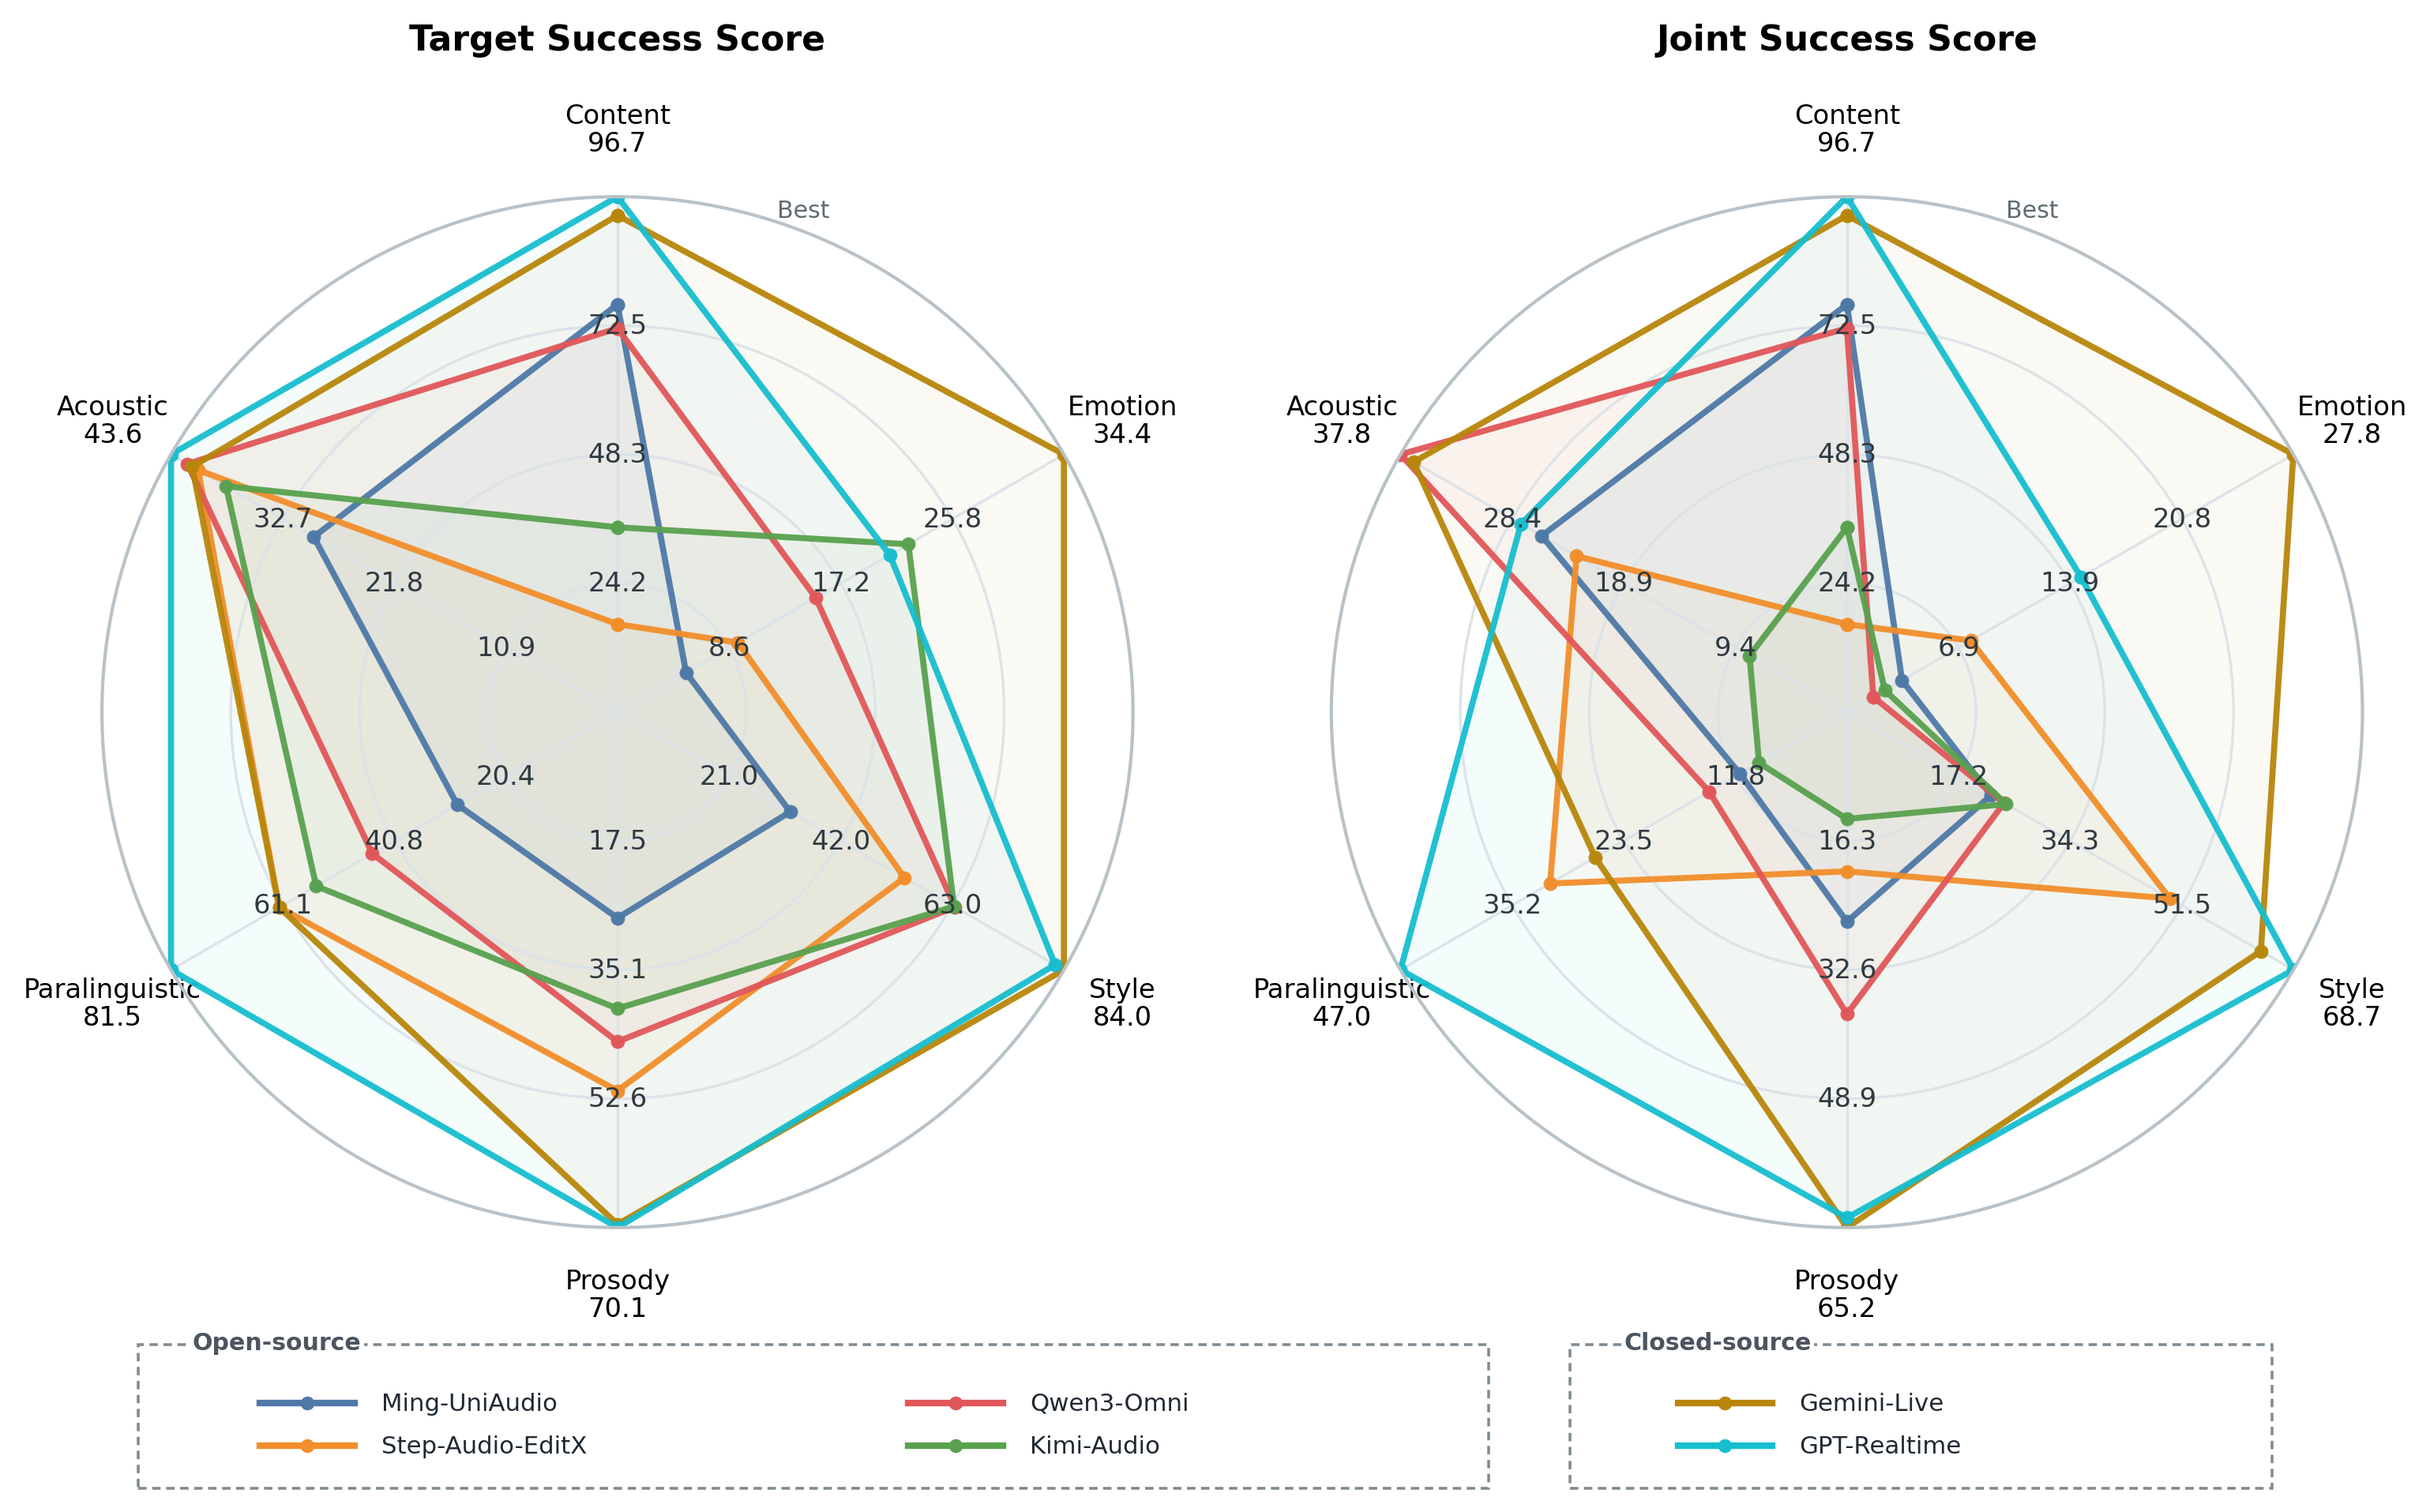 ▲ 图3:六个代表性 Speech LLM 在不同原子任务上的 Target Success(左)与 Joint Success(右)。加入内容保持约束后,模型的能力雷达明显收缩。
结果一:没有模型能够包揽所有任务
现有模型的能力高度分化。Ming-UniAudio 在开源模型中拥有较强的内容编辑能力,Joint Success 为76.46%;Step-Audio-EditX 更擅长风格与副语言编辑,分别达到49.67%和31.25%;Qwen3-Omni 则在韵律和声学编辑上领先其他开源模型,分别达到38.17%和37.80%。
结果二:闭源模型总体领先,但优势并不均匀
GPT-Realtime 在内容和风格编辑上取得被测 Speech LLM 中最高的 Joint Success,分别为96.67%和68.67%;它在副语言编辑上也以47.00%位居被测模型首位。Gemini-Live 则在情感和韵律编辑上领先,分别达到27.79%和65.17%。
不过,闭源模型并非全面占优:Qwen3-Omni 的声学编辑 Joint Success 为37.80%,略高于 Gemini-Live 的36.69%和 GPT-Realtime 的27.60%。
结果三:核心难点是“改对了,还要保得住”
Target Success 和 Joint Success 之间经常存在明显落差。Step-Audio-EditX 在副语言编辑上的 Target Success 为61.75%,但内容保持率只有44.75%,最终 Joint Success 降至31.25%。在韵律编辑上,其 Target Success 为51.51%、内容保持率为39.60%,Joint Success 只有20.13%。
Ming-UniAudio 呈现相反倾向:其韵律编辑内容保持率达到84.50%,Target Success 却只有28.00%。前者是改对目标却损坏内容,后者是保住内容却没有充分完成编辑;三指标设计正是为了区分这两类失效。
结果四:任务专用系统仍然是重要参照
在需要参考音频的说话人编辑中,Seed-VC 达到80.50%Joint Success;在声学编辑中,DeepFilterNet + DSP 达到68.20%,明显高于所有被测 Speech LLM。VoiceCraft-X 的内容编辑还表现出明显的语言差异:英文为84.00%,中文为47.00%。
任务专用系统在部分维度上仍有明显优势,如何将这些能力统一到通用指令模型中仍是挑战。
⏩05 组合指令:能完成一部分,却很难全部完成
组合编辑要求模型在同一条指令中处理多项要求。模型的逐分量成功率明显高于整条指令的 Joint Success:在双属性编辑中,Gemini-Live 和 GPT-Realtime 的逐分量成功率约为50%,Joint Success 却分别只有21.50%和20.00%;开源模型最高的 Mimo-Audio-Instruction 也只有14.50%。
在现有 Speech LLM 能够直接执行的三属性组合中,几乎所有被测模型的 Joint Success 都为0。当前模型容易遗漏某项操作,或在同时修改多个属性时破坏原有内容;协调多个编辑目标并保持其他内容稳定,仍是关键挑战。
⏩06 总结与展望
SpeechEditBench 将七类原子编辑和多属性组合编辑纳入同一套中英文评测框架,通过任务专属 Anchor 分别判断目标是否完成、内容是否保留,并报告两者同时成立的 Joint Success。
对八个 Speech LLM 和多类任务专用系统的评测表明,当前模型的优势仍高度分散,内容保持和多属性协同是构建可靠语音编辑系统的主要瓶颈。团队希望 SpeechEditBench 为不同模型提供统一、可复现的比较基础,推动研究从“能否改变某个属性”走向“能否精确地只改变用户要求的属性”。
